註
Azure AI 搜尋服務 可透過 Azure 入口網站、REST API 及 Azure SDK 取得。 它同時也是 Foundry IQ 的基礎,這是一個管理式知識層,能將企業內容轉化為可重複使用、權限感知的知識庫,供 Microsoft Foundry 入口網站中的代理使用。
如果你在Azure AI 搜尋服務有向量索引,這篇文章會解釋如何:
本文使用 REST 作為說明。 了解基本工作流程後,請繼續在azure-search-vector-samples倉庫中使用Azure SDK範例程式碼,該倉庫提供包含向量查詢的完整端對端解決方案。
你也可以在Azure入口中使用 Search Explorer。
先決條件
任何地區、任何層級的Azure AI 搜尋服務 服務。
向量索引。 請在索引中確認
vectorSearch是否有相關章節。可選擇性 地在索引中加入向量器 ,方便查詢時內建文字轉向量或圖片轉向量。
在 Visual Studio Code 中使用 REST 客戶端 和範例資料,方便您自行運行這些範例。 要開始使用 REST 用戶端,請參見 快速入門:使用 REST 進行全文搜尋。
將查詢字串輸入轉換成向量
要查詢向量場,該查詢本身必須是向量。
將使用者的文字查詢字串轉換為向量表示的一種方法是在您的應用程式碼中呼叫嵌入函式庫或 API。 最佳實務是始終使用相同的嵌入模型,該模型用於在源文件中生成嵌入。 你可以在 azure search-vector-samples 倉庫中找到示範 如何產生嵌入的程式碼範例。
第二種方法是使用整合向量化,這已經普遍可用,讓Azure AI 搜尋服務處理你的查詢向量化輸入與輸出。
這裡有一個提交給 Azure OpenAI 嵌入模型的 REST API 查詢字串範例:
POST https://{{openai-service-name}}.openai.azure.com/openai/deployments/{{openai-deployment-name}}/embeddings?api-version={{openai-api-version}}
Content-Type: application/json
api-key: {{admin-api-key}}
{
    "input": "what azure services support generative AI'"
}
預期的回應碼為202,表示成功呼叫已部署的模型。
embedding回應正文中的欄位是查詢字串input的向量表示。 為了測試目的,你會在查詢請求中將 embedding 陣列的值複製到 vectorQueries.vector ,並使用在接下來幾個章節中所示的語法。
對部署模型的 POST 呼叫實際回應包含 1,536 次嵌入。 為了方便閱讀,這個範例只展示了前幾個向量。
{
    "object": "list",
    "data": [
        {
            "object": "embedding",
            "index": 0,
            "embedding": [
                -0.009171937,
                0.018715322,
                ...
                -0.0016804502
            ]
        }
    ],
    "model": "ada",
    "usage": {
        "prompt_tokens": 7,
        "total_tokens": 7
    }
}
在此方法中,應用程式代碼負責連接模型、產生嵌入並處理回應。
向量查詢請求
本節會展示向量查詢的基本結構。 你可以使用 Azure portal、REST API 或 Azure SDK 來建立向量查詢。
如果您從 2023-07-01-preview 移轉,會有重大變更。 欲了解更多資訊,請參閱 升級至最新 REST API。
穩定版支援:
-
vectorQueries是向量搜尋的構造。 - 對於向量陣列,將
vectorQueries.kind設為vector;如果輸入是字串且您text,則設為 。 -
vectorQueries.vector是查詢(文字或影像的向量表示)。 -
vectorQueries.exhaustive(選擇性) 會在查詢時調用詳盡 KNN,即使欄位已針對 HNSW 編製索引也是如此。 -
vectorQueries.fields(可選)針對特定欄位進行查詢執行(每次查詢最多 10 個)。 -
vectorQueries.weight(可選)指定搜尋操作中每個向量查詢的相對權重。 更多資訊請參見 向量加權。 -
vectorQueries.k是要回傳的配對數量。
在以下範例中,向量是這個字串的表示:"what Azure services support full text search"。 查詢會針對該 contentVector 欄位並回傳 k 結果。 實際向量有 1,536 個嵌入,在此範例中為可讀性而裁剪。
POST https://{{search-service-name}}.search.windows.net/indexes/{{index-name}}/docs/search?api-version=2026-04-01
Content-Type: application/json
api-key: {{admin-api-key}}
{
    "count": true,
    "select": "title, content, category",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . .
                -0.02178128,
                -0.00086512347
            ],
            "exhaustive": true,
            "fields": "contentVector",
            "weight": 0.5,
            "k": 5
        }
    ]
}
向量查詢回應
在Azure AI 搜尋服務中,查詢回應預設包含所有 retrievable 欄位。 然而,通常會將搜尋結果限制在 retrievable 字段的子集,並在 select 語句中列出它們。
在向量查詢中,請仔細考慮是否需要在回應中使用向量場。 向量場不是人類能讀的,所以如果你要推送回應給網頁,應該選擇代表結果的非向量場。 例如,如果查詢針對 contentVector 執行,您可以改為傳回 content。
如果你想在結果中加入向量場,這裡有一個響應結構的範例。
contentVector 是一個嵌入的字串陣列,在此範例中為便於閱讀而裁剪。 搜尋分數顯示相關性。 還包含其他非向量場以供參考。
{
    "@odata.count": 3,
    "value": [
        {
            "@search.score": 0.80025613,
            "title": "Azure Search",
            "category": "AI + Machine Learning",
            "contentVector": [
                -0.0018343845,
                0.017952163,
                0.0025753193,
                ...
            ]
        },
        {
            "@search.score": 0.78856903,
            "title": "Azure Application Insights",
            "category": "Management + Governance",
            "contentVector": [
                -0.016821077,
                0.0037742127,
                0.016136652,
                ...
            ]
        },
        {
            "@search.score": 0.78650564,
            "title": "Azure Media Services",
            "category": "Media",
            "contentVector": [
                -0.025449317,
                0.0038463024,
                -0.02488436,
                ...
            ]
        }
    ]
}
重點:
k決定回傳的最近鄰居結果的數量,在此例中為三個。 向量查詢總是會回傳k結果,前提是至少k有文件存在,即使有些文件相似度不高。 這是因為演算法會找到查詢向量的所有k最近鄰。向量搜尋演算法決定了
@search.score。搜尋結果中的欄位會是所有
retrievable欄位,或select子句中的欄位。 在向量查詢執行時,僅對向量資料進行匹配。 然而,回應可以包含索引中的任何retrievable欄位。 由於無法解碼向量場結果,非向量文字欄位的加入有助於其可讀的數值。
多重向量場
你可以將這個屬性設 vectorQueries.fields 為多個向量場。 向量查詢會針對你在清單中 fields 提供的每個向量欄位執行。 你可以指定最多 10 個欄位。
查詢多個向量場時,請確保每個向量場都包含來自相同嵌入模型的嵌入。 查詢也應該從相同的嵌入模型產生。
POST https://{{search-service-name}}.search.windows.net/indexes/{{index-name}}/docs/search?api-version=2026-04-01
Content-Type: application/json
api-key: {{admin-api-key}}
{
    "count": true,
    "select": "title, content, category",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . .
                -0.02178128,
                -0.00086512347
            ],
            "exhaustive": true,
            "fields": "contentVector, titleVector",
            "k": 5
        }
    ]
}
多重向量查詢
多查詢向量搜尋會跨越搜尋索引中的多個向量欄位傳送多個查詢。 這種查詢方式常用於多模態搜尋的模型,例如 CLIP ,同一模型可以同時向量化文字與影像。
以下查詢範例會同時在 myImageVector 和 myTextVector 中尋找相似性,但會傳送兩個查詢嵌入,各自並行執行。 此查詢結果會利用 倒易秩融合 (RRF)進行評分。
-
vectorQueries提供向量查詢陣列。 -
vector包含搜尋索引中的影像向量與文字向量。 每個實例都是獨立的查詢。 -
fields指定要鎖定的向量場。 -
k是結果中包含的最近鄰匹配數量。
{
    "count": true,
    "select": "title, content, category",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . .
                -0.02178128,
                -0.00086512347
            ],
            "fields": "myimagevector",
            "k": 5
        },
        {
            "kind": "vector"
            "vector": [
                -0.002222222,
                0.018708462,
                -0.013770515,
            . . .
            ],
            "fields": "mytextvector",
            "k": 5
        }
    ]
}
搜尋索引無法儲存圖片。 假設你的索引包含圖片檔案欄位,搜尋結果會包含文字與圖片的組合。
帶有整合向量化的查詢
本節展示一種向量查詢,該向量查詢可調用 整合向量化 ,將文字或 影像查詢 轉換為向量。 我們建議使用此功能使用穩定的 2026-04-01 REST API、搜尋檔案總管或更新的 Azure SDK 套件。
必要條件是搜尋索引中必須具有已設定並指派給向量欄位的向量化工具。 向量器提供連接資訊給查詢時使用的嵌入模型。
搜尋總管在查詢時支援整合向量化。 如果你的索引包含向量場且有向量器,你可以使用內建的文字轉向量轉換功能。
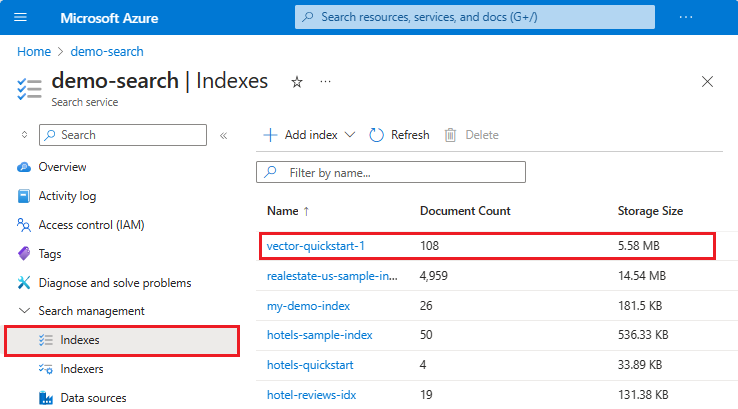
在Azure 入口網站中,進入您的搜尋服務。
從左側選單中,選擇 搜尋管理>索引,然後選擇你的索引。
選擇 向量設定檔 標籤以確認你有向量化器。
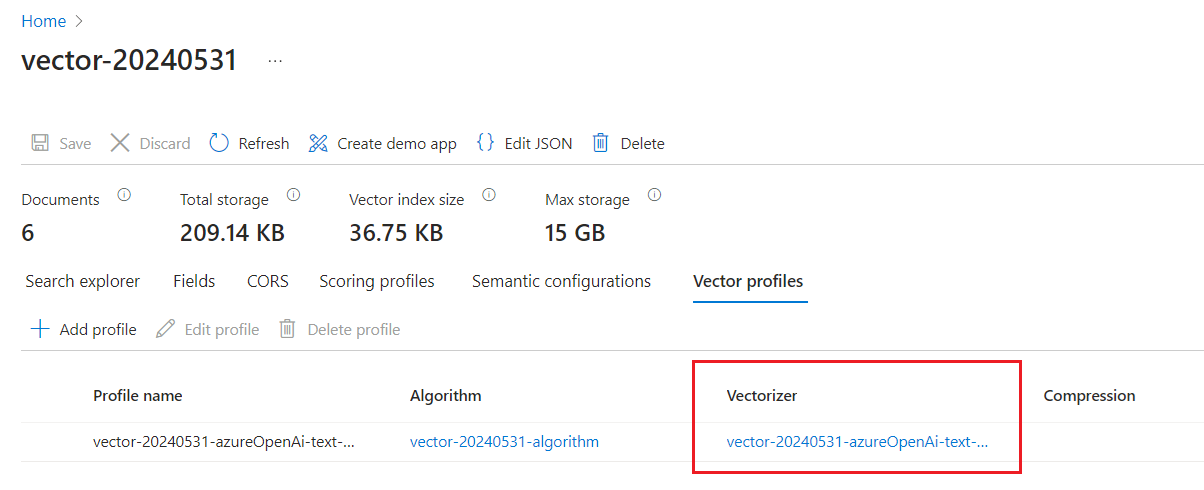
選擇 搜尋總管 標籤。你可以在預設的查詢檢視中輸入文字字串到搜尋欄。 內建的向量器會將你的字串轉換成向量,執行搜尋並回傳結果。
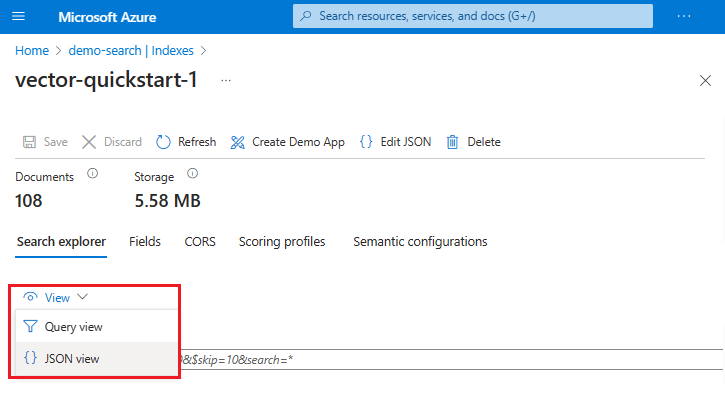
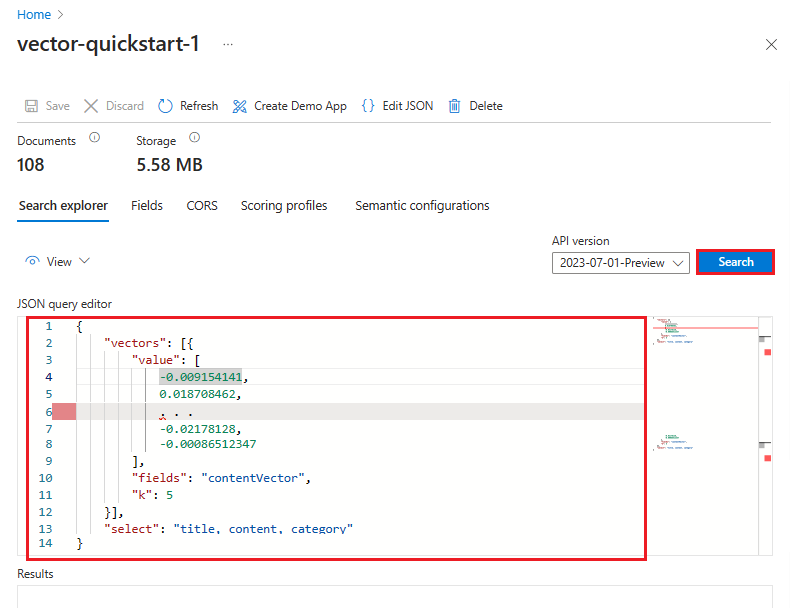
或者,您也可以選擇 「檢視>JSON 視圖 」來檢視或修改查詢。 如果有向量,搜尋總管會自動設定向量查詢。 你可以使用 JSON 視圖選擇用於搜尋和回應的欄位,新增篩選器,並構建更進階的查詢,例如 混合式查詢。 若要查看 JSON 範例,請在本節選擇 REST API 標籤。
向量查詢回應中排名結果的數量
向量查詢指定 k 參數,決定結果中回傳的匹配數量。 搜尋引擎總是會回傳 k 配對數量。 若 k 大於索引中文件數量,文件數量決定可回傳的上限。
如果你熟悉全文搜尋,你就知道如果索引中沒有包含某個詞彙或片語,通常會得到零結果。 然而,在向量搜尋中,搜尋操作會識別最近鄰,並且即使最近鄰並不完全相似,也會一直回傳 k 結果。 對於無意義或離題的查詢,尤其是當你沒有用提示來設定界線時,還是有可能得到結果。 相關性較低的結果相似度較低,但如果沒有更接近的結果,它們仍然是「最近」的向量。 因此,即使沒有有意義的結果,回應仍可回傳 k 結果,但每個結果的相似度分數都會很低。
包含全文搜尋的 混合方法 可以減輕此問題。 另一種解決方案是設定搜尋分數的最小門檻,但前提是查詢是純單向量查詢。 混合查詢不適合設定最小門檻,因為 RRF 範圍較小且波動較大。
影響結果計數的查詢參數包括:
-
"k": n僅向量查詢的結果。 - 對於包含
"top": n參數的混合式查詢,傳回search結果。
兩者都是ktop可選的。 若未指定,預設回應結果數為50。 你可以設定 top 和 skip 來翻閱更多結果,或更改預設值。
向量查詢中使用的排名演算法
結果排名可由以下方式計算:
- 相似度指標。
- 如果有多組搜尋結果,則使用 RRF。
相似度指標
僅向量查詢的索引 vectorSearch 部分所指定的相似度指標。 有效值為 cosine、 euclidean、 dotProduct和 。
Azure OpenAI 嵌入模型使用餘弦相似度,所以如果你用Azure OpenAI 嵌入模型,建議的指標是cosine。 其他支援的排名指標包括 euclidean 和 dotProduct。
RRF
若查詢針對多個向量場、同時執行多個向量查詢,或是向量與全文搜尋的混合,且有無 語意排序,則會建立多個集合。
在查詢執行過程中,向量查詢只能針對一個內部向量索引。 對於 多個向量場 和 多個向量查詢,搜尋引擎會產生多個查詢,針對每個欄位的向量索引。 輸出是每個查詢的排名結果集合,並以 RRF 進行融合。 欲了解更多資訊,請參閱 使用倒數秩融合的相關性評分。
向量加權
新增 weight 查詢參數,指定搜尋操作中每個向量查詢的相對權重。 此值用於將同一請求中兩個或以上向量查詢產生的多個排名列表結果,或混合查詢中向量部分的結果合併。
預設值為 1.0,且該值必須是大於零的正數。
計算每份文件的 RRF分數 時會使用權重。 計算方式是將 weight 該值乘以該文件在相應結果集中的排名分數。
以下範例是一個混合式查詢,包含兩個向量查詢字串和一個文字字串。 向量查詢會被賦予權重。 第一個查詢權重為 0.5 或一半,降低其在請求中的重要性。 第二個向量查詢的重要性是兩倍。
POST https://[service-name].search.windows.net/indexes/[index-name]/docs/search?api-version=2026-04-01

    {
      "vectorQueries": [
        {
          "kind": "vector",
          "vector": [1.0, 2.0, 3.0],
          "fields": "my_first_vector_field",
          "k": 10,
          "weight": 0.5
        },
        {
          "kind": "vector",
          "vector": [4.0, 5.0, 6.0],
          "fields": "my_second_vector_field",
          "k": 10,
          "weight": 2.0
        }
      ],
      "search": "hello world"
    }
向量加權只適用於向量。 本範例 "hello world"中的文字查詢 ,隱含中性權重為 1.0。 然而,在混合式查詢中,你可以透過設定 maxTextRecallSize 來增加或降低文字欄位的重要性。
設定門檻以排除低分結果(預覽)
由於最近鄰搜尋一律會傳回要求的 k 個鄰近項目,因此為了符合搜尋結果的 k 數量需求,可能會取得多個低分相符項目。 為了排除低分搜尋結果,你可以新增 threshold 一個查詢參數,根據最低分數過濾結果。 過濾會在不同召回集的 結果融合 前進行。
這個參數目前還在預覽階段。 我們推薦使用最新預覽版本的 Documents - Search Post(REST API)。
在此範例中,所有分數低於 0.8 的匹配都會被排除在向量搜尋結果之外,即使結果數低於 k。
POST https://[service-name].search.windows.net/indexes/[index-name]/docs/search?api-version=2026-08-01-preview
    Content-Type: application/json
    api-key: [admin key]

    {
      "vectorQueries": [
        {
          "kind": "vector",
          "vector": [1.0, 2.0, 3.0],
          "fields": "my-cosine-field",
          "threshold": {
            "kind": "vectorSimilarity",
            "value": 0.8
          }
        }
      ]
    }
下一步
下一步,複習向量查詢程式碼範例,格式為 Python、C# 或 JavaScript。