註
Azure AI 搜尋服務 可透過 Azure 入口網站、REST API 及 Azure SDK 取得。 它同時也是 Foundry IQ 的基礎,這是一個管理式知識層,能將企業內容轉化為可重複使用、權限感知的知識庫,供 Microsoft Foundry 入口網站中的代理使用。
在Azure AI 搜尋服務中,語意排名器是一項功能,透過利用Microsoft的語言理解模型重新排序搜尋結果,顯著提升搜尋相關性。 語意排序器也內建於 代理檢索中。 本文是高層次的介紹,幫助你理解語意排序器的行為與好處。
Semantic Ranker 是按使用量計費的高級功能,但你可以在免費方案的 服務限制 下免費使用。 我們推薦這篇文章作為背景參考,但如果你想先開始,請 依照以下步驟操作。
什麼是語意排名?
語意排序器是一系列查詢端功能,旨在提升初始 BM25 排名 或 RRF 排名 搜尋結果的品質,適用於文字查詢、向量查詢的文字部分,以及混合查詢。 語意排序以三種方式擴展查詢執行管線:
首先,它一律會針對初始結果集新增次要排名,而該初始結果集是使用 BM25 或 Reciprocal Rank Fusion (RRF) 評分。 此次次級排名運用從 Microsoft Bing 所調整過來的多語言深度學習模型,以推廣最具語意相關性的結果。
其次,它會回傳說明,並可選擇性地擷取回應中的答案,你可以在搜尋頁面上呈現,以提升使用者的搜尋體驗。
第三,如果你啟用查詢重寫,它會將初始查詢字串擴展成多個語意相似的查詢字串。
次要排名和「答案」則適用於查詢回應。 查詢重寫是查詢請求的一部分。
語意排序器具備以下功能:
| 能力 | 描述 |
|---|---|
| L2排名 | 利用查詢的語境或語意意義,計算預先排名結果的新相關性分數。 |
| 語意說明與重點 | 從最能總結內容的欄位中逐字擷取句子與片語,並在關鍵段落標示,方便掃描。 當個別內容欄位過於密集,無法顯示搜尋結果頁面時,摘要結果的說明很有用。 標示文字提升最相關的詞彙與片語,讓使用者能快速判斷為何配對被視為相關。 |
| 語意答案 | 從語意查詢傳回的選用額外子結構。 它會為看似問題的查詢提供直接答案。 它要求文件中包含具有答案特徵的文字。 |
| 查詢重寫(預覽) | 利用文字查詢或向量查詢的文字部分,語意排序器可建立多達 10 種查詢變體,可能用來修正錯字或拼字錯誤,或用產生的同義詞重新表述查詢。 重寫的查詢會運行在搜尋引擎上。 結果以 BM25 或 RRF 評分方式評分,然後再依語意排序器重新評分。 |
語意排序器的運作方式
語意排名器會接收查詢和結果,然後將它們傳送到 Microsoft 所承載的語言理解模型。 它會掃描以尋找更合適的匹配。
以下圖解說明了這個概念。 請考慮「資本」這個詞。 根據語境是金融、法律、地理還是文法,它的意義也各不相同。 透過語言理解,語意排序器能偵測上下文並促進符合查詢意圖的結果。
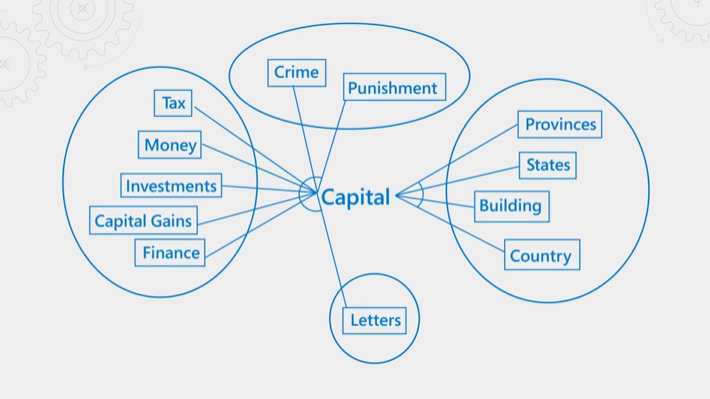
語意排序會耗費大量資源和時間。 為了在查詢操作預期的延遲內完成處理,系統會整合並簡化輸入到語意排序器。 此方法有助於盡快完成重新排序步驟。
語意排名包含三個步驟:
- 收集並總結輸入
- 使用語意排名器來評分
- 輸出重新評分的結果、說明文字與答案
系統如何收集與總結輸入
在語意排序中,查詢子系統將搜尋結果作為摘要與排名模型的輸入。 由於排名模型受輸入大小限制且處理密集,搜尋結果必須進行大小與結構化(摘要),以達到有效處理。
語意排名器從文字查詢的 BM25 排名結果 或向量或混合查詢的 RRF 排名 結果開始。 重新排序練習僅使用文字。 即使結果包含超過 50 個結果,只有前 50 個結果會進入語意排名。 語意排序通常使用資訊與描述欄位。
對於搜尋結果中的每份文件,摘要模型最多可接受 2,000 個標記,其中每個標記約為 10 個字元。 模型會從 語意配置中列出的「標題」、「關鍵字」和「內容」欄位組合輸入。
系統會修剪過長的字串,以確保整體長度符合摘要步驟的輸入需求。 這個修剪練習說明了為什麼要依優先順序在語意設定中加入欄位非常重要。 如果你有非常大的文件,且欄位非常多,系統會忽略超過最大限制的部分。
語意場 代幣限制 「標題」 128 代幣 「關鍵字」 128 代幣 「內容」 剩餘代幣 摘要輸出為每份文件的摘要字串,由每個欄位中最相關的資訊組成。 系統會將摘要字串傳送給排名器以作評分,並傳送給機器閱讀理解模型以取得說明文字和答案。
截至 2024 年 11 月,每個產生的摘要字串傳遞給語意排名器的最大長度為 2,048 個標記。 之前是256個代幣。
結果如何計分
系統會根據標題以及摘要字串中填滿 2,048 個權杖長度的其他內容對結果進行評分。
系統會根據你所提供的查詢,評估說明的概念與語意相關性。
系統會根據該文件在該查詢中的語意相關性,為每份文件分配一個 @search.rerankerScore 。 分數範圍從4到0(高到低),分數越高代表相關性越高。
評分 意義 4.0 該文件高度相關,完整回答了問題,儘管段落可能包含與問題無關的額外文字。 3.0 該文件相關,但缺乏能使其完整的細節。 2.0 該文件具有一定相關性;它回答問題的部分或僅涵蓋部分面向。 1.0 這份文件與問題相關,並且回答了其中一小部分。 0.0 這份文件無關緊要。 系統依分數依序排列匹配,並將其納入查詢回應有效載荷中。 承載包含答案、純文字和醒目提示的字幕,以及您標記為可擷取或在 select 子句中指定的任何欄位。
註
對於任何查詢, @search.rerankerScore 的分布可能因基礎設施層級條件而略有變化。 排名模型的更新也會影響分布。 基於這些原因,如果你寫自訂的最小閾值程式碼,或是為向量與混合查詢 設定閾值屬性 ,不要把限制設得太細緻。
語意排序器的輸出
從每個摘要字串中,機器閱讀理解模型會找出最具代表性的段落。
輸出如下:
文件的 語意說明 。 每個說明文字版本有純文字版本和重點版本,且每份文件通常少於200字。
一個可選的 語意答案,假設你指定
answers了參數,查詢是以問題形式提出,且在長字串中找到一段文字,提供問題的可能答案。
字幕和答案總是逐字來自你的索引。 這個工作流程中沒有生成式 AI 模型來創造或創作新內容。
語意能力與限制
語意排序功能能做的事情:
推廣語義上更接近原始查詢意圖的匹配。
找一些字串當作說明和答案。 回應會回傳說明和答案,你可以在搜尋結果頁面上呈現。
語意排名器無法重新對整個語料庫執行查詢以尋找語意相關的結果。 語意排名會重新排序現有的結果集,包含預設排名演算法所評分的前 50 個結果。 此外,語意排序器無法產生新的資訊或字串。 語言模型會逐字擷取內容的說明文字和答案,所以如果結果沒有類似答案的文字,他們就不會產生答案。
雖然語意排名並非在所有情況下都有利,但某些內容能從其功能中獲得顯著益處。 語意排序中的語言模型最適合用於資訊豐富且結構化為散文的可搜尋內容。 知識庫、線上文件或包含描述性內容的文件,最能從語意排序功能中獲得最大效益。
底層技術來自 Bing 與 Microsoft Research,並整合進 Azure AI 搜尋服務 基礎架構,作為附加功能。 欲了解更多關於支持語意排序的研究與 AI 投資的資訊,請參見 必應 AI 如何驅動 Azure AI 搜尋服務(Microsoft 研究部落格)。
以下影片概述了這些功能。
語意排序器如何使用同義映射
如果你啟用了 對搜尋索引欄位相關聯的同義詞映射 支援,並將該欄位納入 語意排序器設定中,語意排序器會在重新排序過程中自動套用已設定的同義詞。
可用性與價格
語意排名器在 特定地區提供。 它可以作為獨立功能使用,或作為 代理檢索的內建元件。 每個單元都是獨立收費的。
Semantic Ranker 提供免費方案(預設方案),包含每月免費請求津貼,以及用完免費津貼後可按需付費的標準方案。 欲了解更多資訊,請參閱 啟用或停用語意排序計費。
當查詢請求包含 queryType=semantic 且搜尋字串不為空 (例如 search=pet friendly hotels in New York) 時,將會產生語意排序器費用。 如果你的搜尋字串是空的(search=*),即使 queryType 設為語意型,你也不會被收費。
如何開始
(可選)若使用超出免費月限額,請切換到標準計費方案。
(可選) 回傳語意上的回答。