注意
Foundry IQ(Azure AI 搜尋服務)提供直接的索引與查詢 API,並搭配高階知識來源與知識庫 API 用於受控檢索。 使用 Azure 入口網站、REST API 或 Azure SDK 來設定這些功能,或將代理連線到 Microsoft Foundry 入口網站 中的知識庫。
有時候,索引器會遇到沒有產生錯誤的問題,或是發生在 Azure 其他服務上的問題,例如在驗證或連線時。 本文著重於在沒有任何訊息可作為指引的情況下,疑難排解索引程式的問題。 也會針對索引編製期間使用非搜尋資源遇到的錯誤進行疑難解答。
注意
如果您有需要調查的 Foundry IQ(Azure AI 搜尋服務)錯誤,請改參「常見索引器錯誤與警告疑難排解」。
最佳做法
以下是使用索引子時的一些最佳做法和建議:
索引子的設計目的是依排程執行
- 若要取得可靠的索引,請將索引子設定為 定期執行。 排程執行會自動檢索並處理因暫時性錯誤、網絡中斷或臨時服務問題而在之前執行中遺漏的任何文件。 這種方法有助於保持資料一致性並最大限度地減少人工幹預的需要。
- 對於 大型資料來源,初始列舉和索引可能需要數小時甚至數天的時間。 依排程執行索引子可讓進度繼續進行,並自動重試錯誤。 避免僅依賴手動或按需索引器執行,因為這些選項無法提供相同的可靠性或短暫錯誤恢復。
索引器隨時間提供盡力而為的索引
- 內建索引器可處理文件而不會出現永久性錯誤,並會在後續排程執行中重試。 它們提供一種方便的低程式碼或無程式碼方式,為常見情境索引資料,促進更快的開發與更輕鬆的維護。 當索引器執行技能集時,每次執行有固定的執行時間限制。 在 多租戶執行環境中 執行的索引器,執行時間最多為兩小時。 這個限制是最常見的情況,當技能組不需要共享私有連結時使用。 設定為使用 共享私有連結 的索引器,會在私有執行環境中運行,最高可達 24 小時。 完整表格請參見 索引器限制。 若按文件進行技能組處理,索引器無法在時間限制內完成,則會停止並留下剩餘文件未處理。 當文件量、檔案大小、技能複雜度或執行環境阻礙索引器在最大執行時間內完成時,無法保證完整處理。 分割資料來源可以降低這種風險,但無法完全消除,尤其是當你之後加入大量檔案到分割區時。 此行為是預期的。 關於管理大型資料集及支援增量恢復的策略,請參見 大型資料集索引 與 排程索引器。 如果你的解決方案需要嚴格控制索引器何時處理文件,請使用本文中的推送 API 替代方案。
- 如果您的解決方案需要嚴格控制索引時間表,請改用推送 API,例如文件索引 REST API 或 IndexDocuments 方法 (適用於 .NET 的 Azure SDK)。 這些選項可讓您完全控制索引管線。
- 索引器偶爾可能會偏離排程。 雖然此病罕見且有自動康復機制,但恢復可能需要時間。 此行為是預期的。
管理身份令牌在執行期間過期
長期執行的索引器即使其管理身份設定與角色指派正確,仍可能回報無效或過期的認證。 快取的令牌在索引器下載或解壓縮來源內容時可能會過期。
在索引器執行開始前,Foundry IQ 會檢查為資料來源快取的管理身份令牌。 如果距離到期時間少於 60 分鐘,Foundry IQ 會請求新的令牌。 否則,它會重複使用快取的代幣。 此主動式刷新檢查通常在執行前執行,而非在內容下載或擷取過程中持續進行。
例如,快取的令牌在執行開始時還有 90 分鐘剩餘時間,因此 Foundry IQ 會重複使用該令牌。 如果索引作業在 90 分鐘後仍在下載或解壓內容,該令牌可能會過期。 下一個對來源提出的已驗證請求可能會因「憑證無效或已過期」訊息而失敗。
將此暫態狀況與設定或授權問題區分開來:
| 條件 | 要檢查的事項 |
|---|---|
| 長期執行成功啟動,但在後續已驗證身分的來源要求時失敗。 | 請將令牌到期與網路及來源服務錯誤一併考量。 僅僅收到通用的憑證訊息無法確定原因。 |
| 存取經常失敗,包括在執行開始時。 | 檢查遺失或撤銷的角色、所選身份、來源資源 ID、身份是否啟用,以及資料來源設定。 |
確認暫時代幣到期後,請考慮以下暫時緩解措施:
這些緩解措施並不會改變 token 刷新行為,也無法保證長期執行的工作會完成。 不要僅因為中途錯誤提到過期憑證,就擴大角色指派或替換有效憑證。 關於身份與角色設定,請參閱 「設定受管理身份」。
執行時間結束後,匯入不會完成
當內容處理執行達到執行時間配額且仍有合格工作時,搜尋會自動將延續作業排入佇列。 佇列延遲本身並不代表失敗的延續,而知識來源的 24 小時輪詢間隔也不需要等待下一次每日輪詢而產生未完成的工作。
使用 取得索引器狀態與執行歷史 來區分配額停止後仍持續推進的情況,以及重複的處理失敗。 檢查每次執行的錯誤訊息以及已處理/失敗項目數。 僅僅在後續執行時,並不能證明所有剩餘內容都已被索引。
如果重複執行都沒有進展:
- 檢查持續性的來源驗證錯誤、網路、解析或技能錯誤。 取消與設定失敗不會僅靠等待配額恢復就能恢復。
- 檢查大型文件或昂貴技能是否會反覆佔用執行時間範圍。 在可行的情況下減少工作負載或分割 來源 。
- 對於 S3 HD 和 Serverless,請檢查各自的 累積執行時配額。 延續並不會取代它。
- 如果在修正來源與設定後仍持續出現無法解釋的失敗,請 提出支援請求。
保持未來來源變更所需的定期排程。 不要重設索引器,也不要只是為了加快繼續處理而反覆提交隨選流程。
對受限制資源的連線進行疑難排解
針對 Azure 網路安全性下的資料來源,索引子建立連線的方式會受到限制。 目前,索引子可以透過使用共用私人連結的私人端點存取 IP 防火牆後方或虛擬網路上的受限資料來源。
在私人連線上連接 Microsoft Foundry 資源時出現錯誤
如果你收到錯誤代碼 403,並附有以下訊息,可能是你在技能集中資源端點的指定方式有問題:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
如果你設定了連接 Azure Foundry 資源的共用私有連結,且端點缺少自訂子網域,就會發生這個錯誤。 自訂子域是端點的第一個部分(例如 , http://my-custom-subdomain.services.ai.azure.com)。 如果你是在 Foundry 入口網站建立資源,而不是在 Azure 入口建立,可能會缺少自訂網域。
如果 Foundry 資源不與 Foundry IQ 位於同一區域,請 使用無金鑰連線 來附加該資源。
使用共用私人連結時發生錯誤
如果你出現錯誤代碼 403,並出現以下訊息,索引器可能透過公共端點連接,而非經核准的共享私有連結:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
此錯誤可能發生在索引器未設定為使用私有執行環境時。 確認共享私有連結已核准,將索引器 executionEnvironment 設為 private,並確認連線使用正確的資源端點和 群組 ID。
防火牆規則
Azure 儲存體、Azure Cosmos DB 和 Azure SQL 提供可配置的防火牆。 防火牆封鎖要求時,不會有特定錯誤訊息。 一般而言,防火牆錯誤為泛型。 常見錯誤包括:
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
要讓索引器存取這些資源,請使用以下選項之一:
為您的 Foundry IQ 服務的 IP 位址及
AzureCognitiveSearch的 IP 位址範圍設定入站規則。 關於如何為每種資料來源類型設定 IP 位址範圍限制的詳細資訊,請參閱以下連結:作為最後手段或暫時措施,可停用防火牆以允許所有網路的存取。
限制:IP 位址範圍限制僅在您的 Foundry IQ 服務與儲存帳戶位於不同區域時有效。
除了資料擷取之外,索引子也會透過技能集和自訂技能傳送輸出要求。 如需以 Azure 函式為基礎的自訂技能,請注意 Azure 函式也有 IP 位址限制。 允許用於自訂技能執行的 IP 位址清單包括您的 Foundry IQ 服務的 IP 位址以及服務標籤的 AzureCognitiveSearch IP 位址範圍。
網路安全性群組 (NSG) 規則
當索引子存取 SQL 受控執行個體上的資料,或當 Azure VM 被用作自訂技能的 Web 服務 URI 時,網路安全性群組會決定是否允許這些請求。
對於位於虛擬網路上的外部資源,請為 服務標記AzureCognitiveSearch。
如需連線至虛擬機器的詳細資訊,請參閱在 Azure VM 上設定到 SQL Server 的連線。
網路錯誤
通常,網路錯誤為泛型。 常見錯誤包括:
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
當您收到以下任何錯誤時:
- 請確保你能透過直接連線存取來源,而非透過 Foundry IQ 服務。
- 請在 Azure 入口網站查看你的資源,看看是否有目前的錯誤或中斷。
- 檢查 Azure 狀態中是否有網路中斷。
- 確認你使用的是公開 DNS 來解析名稱,而不是 Azure 私用 DNS。
S3 HD 服務更新在舊有共用私有連結下失敗
如果服務更新因共用私有連結而驗證失敗,請同時檢查 SKU 與託管模式。 S3 HD(standard3 帶 hostingMode: HighDensity)不支援外寄搜尋共享私人連結,即使先前的作業已接受這些資源。 不相關的縮放、身分識別、標籤、ARM 或 Terraform 更新可能會暴露此無效的舊有狀態。
在進行變更前,先盤點搜尋端連結及相關工作負載。 找出支援的替代方案、評估中斷情況,並遵循 修復舊版 S3 HD 共用私人連結。 僅刪除目標端私有端端點連線是不夠的。 不要盲目刪除資源或更改主機模式。
Azure SQL Database 無伺服器編製索引 (錯誤碼 40613)
如果 SQL 資料庫位於無伺服器計算層,請確保索引子連線至資料庫時資料庫正在執行 (而不是暫停)。
如果資料庫被暫停,Foundry IQ 服務的首次登入會自動恢復資料庫,但會傳回錯誤,表示資料庫不可用,錯誤代碼 40613。 執行資料庫之後,請重試登入以建立連線能力。
Microsoft Entra 條件式存取原則
當你建立 SharePoint 索引器時,必須在提供裝置代碼後登入你的 Microsoft Entra 應用程式。 如果你收到顯示 "Your sign-in was successful but your admin requires the device requesting access to be managed" 的訊息,條件式存取原則很可能封鎖了索引器對 SharePoint 文件庫的存取。
若要更新原則並允許索引子存取文件庫:
開啟 Azure 入口網站並搜尋 Microsoft Entra 條件式存取。
在左側功能表中,選取 [原則]。 如果您沒有檢視此頁面的存取權,則必須尋求具有存取權或取得存取權的人員協助。
判斷哪個原則會封鎖 SharePoint 索引子存取文件庫。 可能封鎖索引器的原則包含您在 使用者與群組 區段中建立索引器時用來進行驗證的使用者帳戶。 原則也可能具有下列 [條件]:
- 限制 [Windows] 平台。
- 限制 [行動應用程式與桌面用戶端]。
- 裝置狀態設為「是」。
一旦確認是哪個政策阻擋了索引器,就為該索引器申請豁免。 首先,擷取 Foundry IQ 服務的 IP 位址。
首先,取得您 Foundry IQ 服務的完整合格網域名稱(FQDN)。 FQDN 格式如下:
<your-search-service-name>.search.windows.net。 您可以在 Azure 入口網站中找到 FQDN。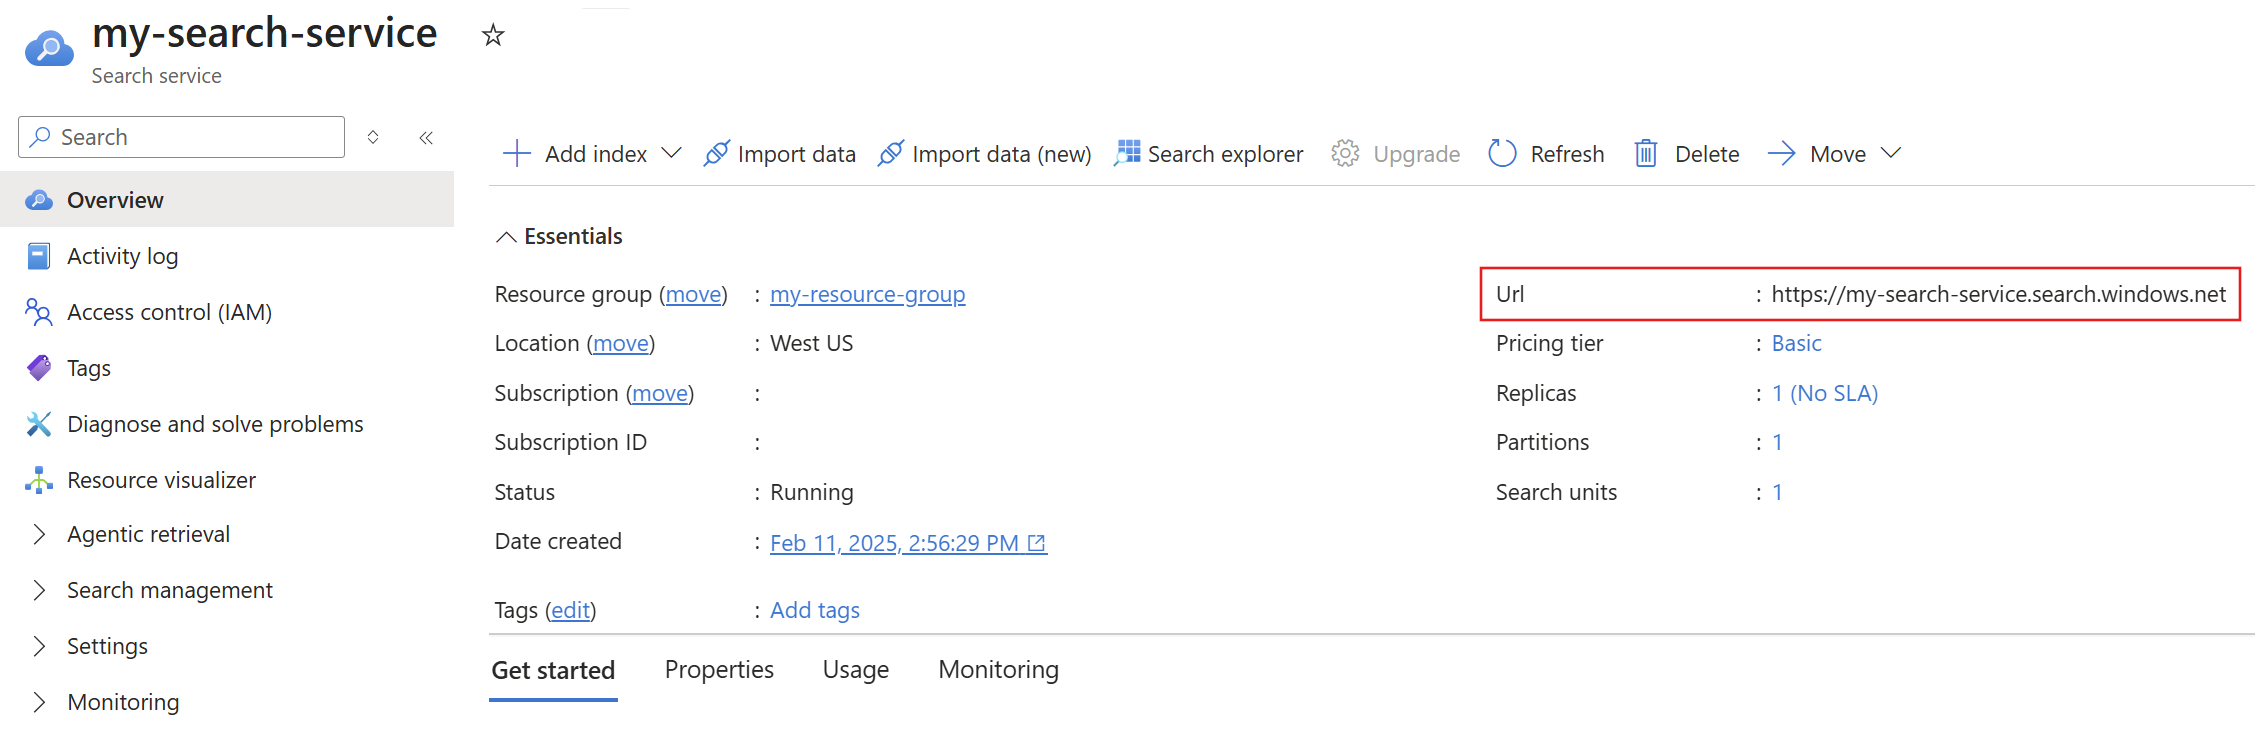
現在你已經有了 FQDN,透過執行 FQDN 的一個
nslookup(或一個ping)來取得 Foundry IQ 服務的 IP 位址。 在以下範例中,你在 Azure 儲存體 防火牆的一個入站規則中新增150.0.0.1了內容。 Foundry IQ 服務索引器更新防火牆設定後,可能需要長達 15 分鐘才能存取 Azure 儲存體 帳戶。nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.net取得您所在區域的索引子執行環境的 IP 位址範圍。
其他 IP 位址用於源自索引器的多租用戶執行環境的請求。 您可以從服務標籤取得此 IP 位址範圍。
你可以透過
AzureCognitiveSearch或可下載的 JSON 檔案取得服務標籤的 IP 位址範圍。在此練習中,假設 Foundry IQ 服務位於 Azure 公共雲端,請下載 Azure 公共 JSON 檔案。
假設 Foundry IQ 服務位於美國中西部,則從 JSON 檔案中列出多租戶索引器執行環境的 IP 位址清單。
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
回到 Azure 入口網站的 [條件式存取] 頁面,從左側功能表中選取 [具名位置],然後選取 [+ IP 範圍位置]。 為您的新命名位置命名,並新增您在前兩個步驟收集的 Foundry IQ 服務與索引器執行環境的 IP 範圍。 1
- 對於你的 Foundry IQ 服務 IP 位址,你可能需要在 IP 位址末加上「/32」,因為它只接受有效的 IP 範圍。
- 請記住,對於索引器執行環境的 IP 範圍,您只需新增 Foundry IQ 服務所在區域的 IP 範圍即可。
將新的具名位置排除在原則之外:
- 在左側功能表中,選取 [原則]。
- 請選擇阻擋索引程式的政策。
- 選取 [條件]。
- 選取 [位置]。
- 選取 排除,然後新增新的具名位置。
- 儲存 變更。
請稍候幾分鐘,讓政策更新,並執行新的政策規則。
再次嘗試建立索引子:
- 傳送您所建立資料來源物件的更新要求。
- 重新傳送索引器建立請求。 使用新的程式碼登入,然後傳送另一個索引子建立要求。
不支援的文件類型索引
如果你是從 Azure Blob 儲存體 索引內容,而容器包含不支援的內容類型 blob,索引器會跳過該文件。 在其他情況下,個別文件可能會發生問題。
在此情況下,您可以 設定組態選項 ,以便在個別文件發生問題時,允許索引器處理繼續。
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Content Understanding 分析逾時
如果 Content Understanding 管線缺少區塊,請檢查索引器的技能等級錯誤與警告。 其預設的八分鐘文件分析輪詢視窗與索引器的執行時限是分開的。 輪詢過期不會回傳文件的分析輸出;剩餘的管線、預測值及失敗閾值決定文件或執行是否失敗。
有關回報的技能逾時,請參閱 內容理解分析輪詢。 使用 「疑難排解內容理解」分析 ,在重試可能產生額外費用的工作前,區分輪詢過期與分析器建立、請求失敗及其他原因。
遺漏文件
索引器會從外部 資料來源 擷取文件或資料列並建立 搜尋文件,Foundry IQ 服務會對這些文件進行索引。 偶爾,存在於資料來源中的某份文件未能出現在搜尋索引中。 由於以下原因,可能會出現此非預期的結果:
- 您在索引器執行之後更新了文件。 如果您的索引子有排程,它最終會重新執行,並擷取該文件。
- 索引子在文件擷取前就已逾時。 存在處理時間限制上限,超過後便不會處理任何文件。 您可以在 Azure 入口網站 或呼叫取得索引器狀態 (REST API) 來檢查索引器狀態。
- 欄位映射 或 AI 擴充 改變了文件,其在搜尋索引中的表達方式與你預期不同。
- 變更追蹤值錯誤,或遺漏必要條件。 如果你的高水印值是設定在未來時間的日期,索引者會跳過任何日期較早的文件。 你可以使用
initialTrackingState中的finalTrackingState和 欄位,判斷索引器的變更追蹤狀態。 Azure SQL 和 MySQL 的索引子,必須在來源資料表的高水位標記資料行上建立索引,否則索引子使用的查詢可能會逾時。
提示
如果遺漏檔,請檢查 您所使用的查詢 ,以確定它並未排除有問題的檔。 若要查詢特定文件,請使用查閱文件 REST API。
Blob 儲存體中遺失的內容
Blob 索引子會從容器的 Blob 中尋找並擷取文字。 擷取文字的某些問題包括:
文件僅包含掃描的影像。 具有非文字內容的 PDF Blob (例如掃描的影像 (JPG)) 不會在標準 Blob 編製索引管線中產生結果。 若您具有包含文字元素的影像內容,您可以使用 OCR 或影像分析來尋找及擷取文字。
Blob 索引程式已配置為僅索引中繼資料。 要擷取內容,您必須設定 blob 索引器同時 擷取內容與元資料:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Azure Cosmos DB 遺漏內容
Foundry IQ 對 Azure Cosmos DB 索引有隱式依賴。 如果您在 Azure Cosmos DB 中關閉自動索引,Foundry IQ 會回傳成功的狀態,但無法索引容器內容。 如需如何檢查設定及開啟編製索引的指示,請參閱管理 Azure Cosmos DB 中的編製索引。
資料來源與索引之間的文件計數差異
索引子顯示的文件計數可能會與資料來源、索引本身或程式碼中的計數不同。 以下是發生此行為的一些可能原因:
- 索引在顯示實際檔計數時可能會延遲,特別是在 Azure 入口網站。
- 索引器有已刪除文件的政策。 如果文件在遭刪除之前已編製索引,則索引子端會將這些文件列入計數。
- 如果資料來源中的識別碼欄位不具唯一性。 此條件適用於包含欄位概念的資料來源,例如 Azure Cosmos DB。
- 如果資料來源定義中的查詢,與您用來估算記錄數的查詢不同。 舉例來說,在你的資料庫中,你查詢的是資料庫的記錄數量,而在資料來源定義查詢中,你可能只選擇部分紀錄來索引。
- 系統會以不同的時間間隔,檢查管線中各個元件的計數:資料來源、索引器和索引。
- 資料來源中有一個檔案被對應成多個文件。 當編製索引 Blob 及「parsingMode」設定為
jsonArray和jsonLines時,可能會發生此狀況。
文件已處理多次
索引器採用保守的緩衝策略,以確保在編製索引時,資料來源中的每個新的和已變更的文件被收錄。 在某些情況下,這些緩衝區可能會重疊,導致索引器同時索引文件兩次或更多次。 因此,處理完的文件數量超過資料來源中實際文件數量。 這種行為不會影響索引中儲存的資料,例如重複文件,只是可能花更長時間才能達到最終一致性。 當下列任一條件成立時,特別容易發生這種情況:
- 隨選索引子要求會快速連續發出。
- 資料來源的拓撲包含多個副本與分割區,例如Azure Cosmos DB中一致性等級中描述的拓撲。
- 資料來源為 Azure SQL 資料庫,所選為「高水位標記」的欄位為
datetime2類型 。
索引子不應在短時間內頻繁叫用。 如果您需要快速更新,支援的方法是將更新推送至索引,同時更新資料來源。 按需處理時,請以五分鐘或更久的間隔來調整請求,並依照時間表運行索引器。
具有 30 秒緩衝區的重複文件處理範例
以下時間軸說明文件處理兩次的條件。 它記錄了每個行動和反制行動。 下列時間軸說明這個問題:
| 時間軸 (hh:mm:ss) | 事件 | 索引子高水位標記 | 註解 |
|---|---|---|---|
| 00:01:00 | 將 doc1 寫入具有最終一致性的資料來源 |
null |
文件時間戳記為 00:01:00。 |
| 00:01:05 | 將 doc2 寫入具有最終一致性的資料來源 |
null |
文件時間戳記為 00:01:05。 |
| 00:01:10 | 索引器啟動 | null |
|
| 00:01:11 | 索引子會查詢 00:01:10 之前的所有變更;而索引子查詢的複本,剛好只知道 doc2;因此只會擷取 doc2 |
null |
索引器在開始時間戳之前要求所有變更,但實際上僅收到了一部分。 這種行為使得回看緩衝期間成為必要。 |
| 00:01:12 | 索引子第一次處理 doc2 |
null |
|
| 00:01:13 | 索引器結束 | 00:01:10 | 高水位標記會更新為目前索引子執行的開始時間戳記。 |
| 00:01:20 | 索引器啟動 | 00:01:10 | |
| 00:01:21 | 索引子會查詢 00:00:40 與 00:01:20 之間的所有變更;索引子查詢的複本會同時注意 doc1 和 doc2;擷取 doc1 和 doc2 |
00:01:10 | 索引子會要求目前高水位標記減去 30 秒緩衝區,到目前索引子執行開始時間戳記之間的所有變更。 |
| 00:01:22 | 索引子第一次處理 doc1 |
00:01:10 | |
| 00:01:23 | 索引子第二次處理 doc2 |
00:01:10 | |
| 00:01:24 | 索引器結束 | 00:01:20 | 高水位標記會更新為目前索引子執行的開始時間戳記。 |
| 00:01:32 | 索引器啟動 | 00:01:20 | |
| 00:01:33 | 索引子會查詢 00:00:50 與 00:01:32 之間的所有變更;擷取 doc1 和 doc2 |
00:01:20 | 索引子會要求目前高水位標記減去 30 秒緩衝區,到目前索引子執行開始時間戳記之間的所有變更。 |
| 00:01:34 | 索引子第二次處理 doc1 |
00:01:20 | |
| 00:01:35 | 索引子第三次處理 doc2 |
00:01:20 | |
| 00:01:36 | 索引器結束 | 00:01:32 | 高水位標記會更新為目前索引子執行的開始時間戳記。 |
| 00:01:40 | 索引器啟動 | 00:01:32 | |
| 00:01:41 | 索引程序查找 00:01:02 與 00:01:40 之間的所有變更,擷取 doc2 |
00:01:32 | 索引子會要求目前高水位標記減去 30 秒緩衝區,到目前索引子執行開始時間戳記之間的所有變更。 |
| 00:01:42 | 索引器第四次處理 doc2 |
00:01:32 | |
| 00:01:43 | 索引器結束 | 00:01:40 | 請注意,此索引子執行是在距離上次寫入資料來源超過 30 秒後啟動的,並且也已處理了doc2。 這是預期的行為,因為如果排除 00:01:35 之前的所有索引子執行,這會成為處理 doc1 和 doc2 的第一個且唯一的執行。 |
實務上,這種情況只會發生在你手動在幾分鐘內連續呼叫按需索引器時,針對特定資料來源。 這可能會導致數字不相符 (例如,索引子會根據索引子執行統計資料處理總計 345 份文件,但是資料來源和索引中有 340 份文件),或者如果您對相同文件多次執行相同技能,則可能會增加帳單。 使用排程執行索引子是慣用的建議。
平行索引
當多個索引器同時運行時,有些索引器通常會進入佇列,等待可用資源後才開始。 有幾個因素決定了能同時執行多少索引器。 如果索引器不連結到 技能集,Foundry IQ 服務中的 複本與分割 區數量決定了能平行執行的索引器數量。
如果你將索引器與技能組關聯,它會在 Foundry IQ 內部叢集中運行。 技能組的複雜度以及其他技能組是否同時執行,決定了能同時執行多少索引器。 內建索引器能可靠地從來源擷取資料,因此若依照排程執行,不會遺漏資料。 然而,索引器進行平行化與擴展的程序需要一些時間來完成。
使用敏感度標籤編製索引文件
如果你 在文件上設定敏感度標籤,可能無法索引它們。 如果出現錯誤,先移除標籤再索引。