Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Not
Azure Yapay Zeka Arama Azure portalı, REST API'leri ve Azure SDK’ları aracılığıyla kullanılabilir. Ayrıca kuruluş içeriğini Microsoft Foundry portalındaki aracılar için yeniden kullanılabilir, izin kullanan bilgi bankalarına dönüştüren yönetilen bilgi katmanı Foundry IQ'yu temel alır.
Önemli
(önizleme) olarak işaretlenen özellikler, özellikler veya özellikler hizmet düzeyi sözleşmesi kapsamında değildir, üretim iş yükleri için önerilmez ve genel kullanıma sunulmadan önce değişebilir veya kısıtlanabilir. Azure Yapay Zeka Arama önizleme terimleri, tek başına veya genel kullanıma sunulan bir özelliğin parçası olsun, tüm önizleme işlevleri için geçerlidir.
Azure Yapay Zeka Arama vector sorgusuna ekleme veya dışlama ölçütleri eklemek için filter ifadesi kullanabilirsiniz. Ayrıca, filtreyi uygulayan bir filtreleme modu da belirtebilirsiniz:
- Ön filtreleme olarak bilinen sorgu yürütmeden önce.
- Sorgu yürütüldükten sonra postfiltering olarak bilinir.
- Genel en üst sıradaki
ksonuçlar belirlendikten sonra, katı son filtreleme (önizleme) olarak bilinir.
Bu makalede çizim için REST kullanılır. Vektör sorguları içeren diğer dillerdeki kod örnekleri ve uçtan uca çözümler için azure-search-vector-samples GitHub deposuna bakın.
Vektör içeriğini sorgulamak için Azure portalında Search Explorer da kullanabilirsiniz. JSON görünümünde filtreler ekleyebilir ve filtre modunu belirtebilirsiniz.
Vektör sorgularında filtreleme nasıl çalışır?
Azure Yapay Zeka Arama, HNSW grafiklerini birden çok parça arasında depolayan Yaklaşık En Yakın Komşu (ANN) araması için Hiyerarşik Gezinilebilir Küçük Dünya (HNSW) algoritmasını kullanır. Her bir parça, tüm indeksin bir bölümünü içerir.
Filtreler, filtre ölçütlerine göre filterable dize veya sayısal olmayan alanlara uygulanarak arama belgelerini dahil etmek veya hariç tutmak için kullanılır. Vektör alanlarının kendileri filtrelenebilir değildir, ancak aynı dizindeki diğer alanlardaki filtreleri kullanarak vektör araması için göz önünde bulundurulan belgeleri daraltabilirsiniz. Dizininizde uygun metin veya sayısal alanlar yoksa, filtrelemeye yardımcı olabilecek LastModified veya CreatedBy gibi özellikler içeren belge meta verilerini denetleyin.
vectorFilterMode parametresi, arama aşamaları sırasında filtre işlemlerinin nereye uygulanacağını denetler. Bu, sonuçların öğelerin bir alt kümesine (kategori, etiket veya diğer özniteliklere göre) nasıl filtrelendiğini etkiler ve gecikme süresini, geri çekmeyi ve aktarım hızını etkiler. Üç mod vardır:
preFilterfiltreyi HNSW geçişi sırasında her bir parçaya uygular. Bu mod geri çekmeyi en üst düzeye çıkarır ancak grafikte daha fazla geçiş yapabilir ve yüksek oranda seçmeli filtreler için CPU ve gecikme süresini artırır.postFilterHNSW taramasını ve filtrelemesini her parçayı bağımsız bir şekilde işleyerek yürütür, sonuçları parça düzeyinde kesiştirir ve her parçadan en iyiksonuçları genel bir en iyikiçine toplar. Bu mod, yüksek oranda seçmeli filtreler veya küçükkdeğerler için hatalı negatifler oluşturabilir.strictPostFilter(önizleme) filtreyikfiltrelenmemiş genel üst öğeyi bulur. Bu mod, yüksek oranda seçmeli filtreler ve küçükkdeğerler için hatalı negatifler döndürme riski en yüksektir.
Bu modlar hakkında daha fazla bilgi için bkz. Filtre modunu ayarlama.
Filtre tanımlama
Filtreler vektör sorgularının kapsamını belirler ve Belgeler - Arama Gönderisi (REST API) kullanılarak tanımlanır. Önizleme özelliğini kullanmak istemiyorsanız, isteği formüle etmek için Arama Hizmeti REST API'lerinin en son kararlı sürümünü kullanın.
Bu REST API şunları sağlar:
-
filterölçütler için. -
vectorFilterModevektör sorgusu sırasında filtrenin ne zaman uygulanacağını belirtmek için. Desteklenen modlar için bkz. Filtre modunu ayarlama.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
Bu örnekte vektör gömme contentVector alanını hedefler ve filtre ölçütleri category filtrelenebilir bir metin alanına uygulanır. Mod kullanıldığından preFilter , arama altyapısı sorguyu çalıştırmadan önce filtre uygulanır, bu nedenle vektör araması sırasında yalnızca kategorideki Databases belgeler dikkate alınır.
Filtre modunu ayarlama
parametresi, vectorFilterMode vektör sorgu yürütmesine göre filtrenin ne zaman ve nasıl uygulanacağını belirler. Aşağıdaki modları kullanabilirsiniz:
-
preFilter(önerilir) postFilter-
strictPostFilter(önizleme)
Not
preFilter , yaklaşık 15 Ekim 2023'e kadar oluşturulan dizinler için varsayılan değerdir. Bu tarihten postFilter önce oluşturulan dizinler için varsayılan değerdir. Ve vektör sıkıştırma gibi diğer gelişmiş vektör özelliklerini kullanmak preFilter için dizininizi yeniden oluşturmanız gerekir.
REST API sürümünde veya daha sonraki bir sürümde "vectorFilterMode": "preFilter" ile 2023-10-01-preview bir vektör sorgusu göndererek uyumluluğu test edebilirsiniz. Sorgu başarısız olursa dizininiz preFilter öğesini desteklemiyor.
Ön filtreleme, sorgu yürütmeden önce filtre uygular ve bu da vektör arama algoritması için aday kümesini azaltır. Bu filtrelenmiş kümeden en üsttekik sonuçlar seçilir.
Bir vektör sorgusunda, preFilter gecikme süresine göre geri çekme ve kaliteyi tercih ettiğinden varsayılan moddur.
Bu mod nasıl çalışır?
Her bir parçaya, HNSW geçişi sırasında filtre koşulunu uygulayın ve adaylar bulunana kadar grafiği genişletin.
Parça başına önceden filtrelenmiş yerel üst
ksonuçları üretin.Filtrelenen sonuçları genel bir üst
ksonuç kümesinde toplama.
Bu modun etkisi
Traversal, özellikle filtre seçmeliyse daha fazla filtrelenmiş aday bulmak için arama yüzeyini genişletir. Bu, tüm parçalar arasında en benzer en üst düzeyk sonuçları üretir. Her parça, filtre koşulunu k karşılayan sonuçları tanımlar.
Ön filtreleme, sonuçların k dizinde varsa döndürüldüğünü garanti eder. Yüksek oranda seçmeli filtreler için bu, grafın önemli bir kısmının çapraz geçişine neden olarak işlem maliyetini ve gecikme süresini artırırken aktarım hızını düşürebilir. Filtreniz yüksek oranda seçmeliyse (çok az eşleşmesi varsa), kapsamlı arama yapmak için kullanmayı exhaustive: true göz önünde bulundurun.
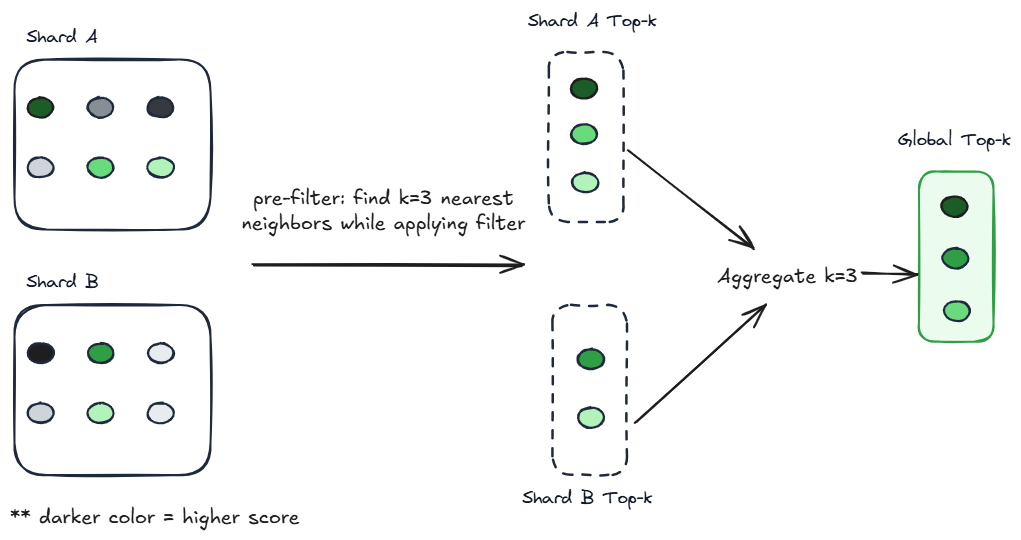
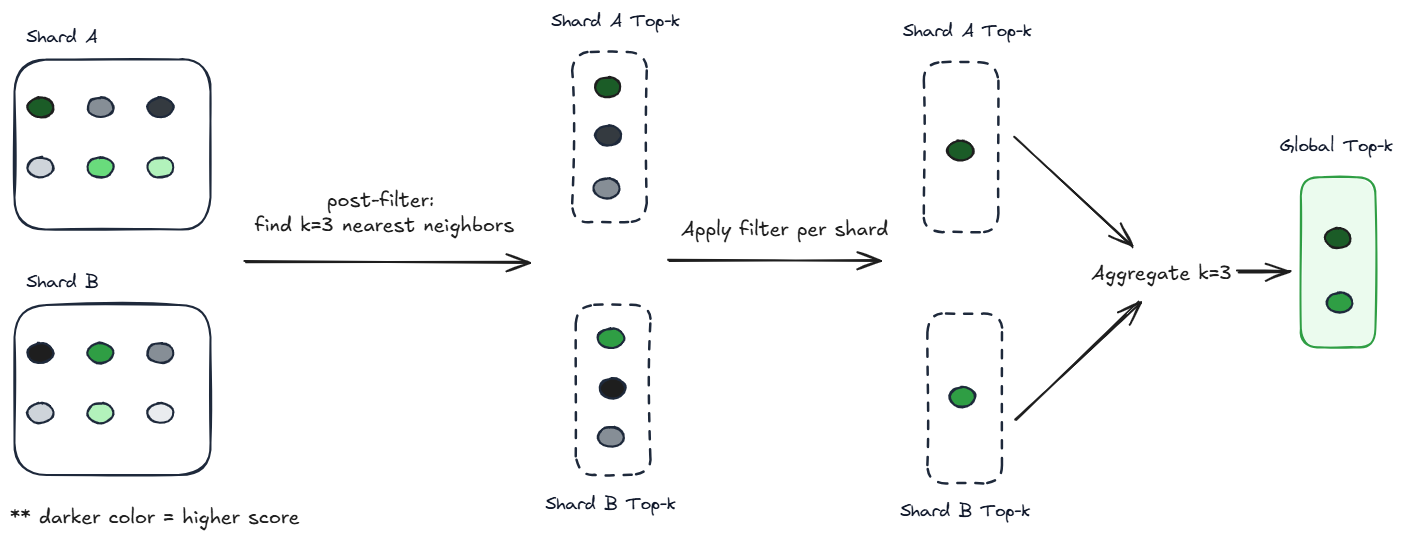
Karşılaştırma tablosu
| Modu | Geri çekme (filtrelenmiş sonuçlar) | Hesaplama maliyeti | Hatalı negatif sonuç riski | Ne zaman kullanılır? |
|---|---|---|---|---|
preFilter |
Çok yüksek | Daha yüksek (filtre seçiciliği ve karmaşıklığı ile artar) | Risk yok |
Tüm senaryolar için varsayılan olarak önerilir, özellikle hatırlamanın kritik olduğu durumlarda (hassas arama etki alanları), seçici filtreler kullanılırken veya küçük k kullanılırken. |
postFilter |
Orta ve yüksek (filtre seçiciliği ile azalır) | Filtrelenmemişe benzer, ancak filtre karmaşıklığı arttıkça yükselir. | Orta (shard başına eşleşmeleri kaçırabilir) | Çok seçici olmayan filtreler ve daha yüksekk sorgular için bir seçenek. |
strictPostFilter |
En düşük (filtre seçiciliği ile en hızlı şekilde azalır) | Filtrelenmemişe benzer | En yüksek (seçmeli filtreler veya küçük kiçin sıfır sonuç döndürebilir) |
Filtre uygulamasından sonra daha fazla sonucu göstermek, yanlış negatifler riskinden daha fazla kullanıcı deneyimini etkiliyorsa, fasetli arama uygulamaları için bir seçenek. küçük kile kullanmayın. |
Ön filtreleme ve son filtreleme karşılaştırma testi
Önemli
Bu bölüm, sıkı postfiltreleme için değil, ön filtreleme ve postfiltreleme için geçerlidir.
Bir filtre modunun diğerinden daha iyi performans gösterme koşullarını anlamak için küçük, orta ve büyük dizinler üzerinden sorgu sonuçlarını değerlendirmek için bir dizi test çalıştırdık.
- Küçük (100.000 belge, 2,5 GB dizin, 1.536 boyut)
- Orta (1 milyon belge, 25 GB dizin, 1.536 boyut)
- Büyük (1 milyar belge, 1,9 TB endeks, 96 boyut)
Küçük ve orta ölçekli iş yükleri için bir bölüm ve bir kopya içeren Standart 2 (S2) hizmeti kullandık. Büyük iş yükü için, 12 bölüm ve bir replik ile Standart 3 (S3) hizmeti kullandık.
Dizinler aynı yapıya sahipti: bir anahtar alanı, bir vektör alanı, bir metin alanı ve bir sayısal filtrelenebilir alan. Aşağıdaki dizin söz dizimi kullanılarak 2023-11-01 tanımlanır.
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
Sorgularda hem ön filtre hem de postfilter işlemleri için aynı filtreyi kullandık. Performanstaki değişimlerin filtre karmaşıklığı değil filtreleme modundan kaynaklanmasını sağlamak için basit bir filtre kullandık.
Sonuçlar saniyedeki sorgularda (QPS) ölçüldü.
Çıkarımlar
Performansın yaklaşık olarak eşit olduğu küçük dizinler dışında, ön filtreleme neredeyse her zaman postfiltering'den daha yavaştır.
Daha büyük veri kümelerinde ön filtreleme, birkaç kat daha yavaştır.
Neredeyse her zaman daha yavaşsa ön filtre neden varsayılandır? Ön filtreleme, dizinde mevcutsa
ksonuçların döndürüleceğini garanti eder ve bu durumda öncelik hız yerine geri çekme ve duyarlık üzerinde olur.Postfiltrelemeyi şu durumlarda kullanın:
Hızın seçime göre değerini önemseyin (postfiltering
kkadar az sonuç döndürebilir).Aşırı seçici olmayan filtreler kullanın.
Ön filtreleme performansının kabul edilemez olması için yeterli boyutta dizinlere sahip olun.
Detaylar
1.536 boyutta 100.000 vektöre sahip bir veri kümesi göz önünde bulundurulduğunda:
Veri kümesinin 30'dan fazla% filtrelendiğinde ön filtreleme ve son filtreleme karşılaştırılabilirdi.
Veri kümesinin 0,1%'den azını filtrelerken, ön filtreleme işlemi postfiltering'den yaklaşık 50% daha yavaştı.
1.536 boyutta 1 milyon vektöre sahip bir veri kümesi göz önünde bulundurulduğunda:
Veri kümesinin 30'dan fazla% filtrelendiğinde, ön filtreleme yaklaşık 30% daha yavaştı.
Veri kümesinin 2% daha az filtrelendiğinde, ön filtreleme yaklaşık yedi kat daha yavaştı.
96 boyutta 1 milyar vektöre sahip bir veri kümesi göz önünde bulundurulduğunda:
Veri kümesinin %5'inden fazlası filtrelendiğinde, ön eleme yaklaşık %50 daha yavaştı.
Veri kümesinin 10%'den azını filtrelerken, ön filtreleme yaklaşık yedi kat daha yavaştı.
Aşağıdaki grafikte, filtre öncesi göreli QPS, yani filtre öncesi QPS'nin filtre sonrası QPS'ye bölünmesiyle hesaplanan değer gösterilmektedir.

Dikey eksen, QPS oranı (saniye başına sorgu) olarak ifade edilen, ön filtrelemenin postfiltering ile karşılaştırıldığında göreli performansını temsil eder. Örneğin:
- Ön filtrelemenin
0.0değeri, ön filtrelemenin son filtrelemeden yüzde 100 daha yavaş olduğu anlamına gelir. - Ön filtrelemenin
0.5değeri 50% daha yavaştır. -
1.0değerinde, ön filtreleme ve son filtreleme eşdeğerdir.
Yatay eksen, filtre uygulandıktan sonra filtreleme oranını veya aday belgelerin yüzdesini temsil eder. Örneğin, 1.00% oranı, filtre ölçütlerinin arama kümesinin yüzde birini seçtiği anlamına gelir.