Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Observera
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
I Azure AI-sökning är semantic ranker en funktion som mätbart förbättrar sökrelevansen med hjälp av Microsoft språkförstålliga modeller för att rangordna sökresultaten igen. En semantisk ranker är också inbyggd i agentisk hämtning. Den här artikeln är en introduktion på hög nivå som hjälper dig att förstå beteendet och fördelarna med semantisk ranker.
Semantisk ranker är en premiumfunktion som debiteras av användning, men du kan använda den kostnadsfritt enligt tjänstgränser för den kostnadsfria nivån. Vi rekommenderar den här artikeln för bakgrund, men om du hellre vill komma igång följer du de här stegen.
Vad är semantisk rankning?
Semantisk ranker är en samling funktioner på frågesidan som förbättrar kvaliteten på ett första BM25-rankat eller RRF-rankat sökresultat för textbaserade frågor, textdelen av vektorfrågor och hybridfrågor. Semantisk rangordning förlänger frågeutförandepipelinen på tre sätt.
Först lägger den alltid till sekundär rangordning över en första resultatuppsättning som poängsatts med BM25 eller Reciprocal Rank Fusion (RRF). Den här sekundära rankningen använder flerspråkiga djupinlärningsmodeller som är anpassade från Bing för att främja de mest semantiskt relevanta resultaten.
För det andra returnerar den undertexter och extraherar eventuellt svar i svaret, som du kan återge på en söksida för att förbättra användarens sökupplevelse.
För det tredje, om du aktiverar omskrivning av frågor, expanderas en inledande frågesträng till flera semantiskt liknande frågesträngar.
Sekundär rangordning och "svar" gäller för frågesvaret. Frågeomskrivning är en del av frågebegäran.
Semantisk ranker har följande funktioner:
| Kapacitet | Beskrivning |
|---|---|
| L2-rangordning | Använder kontexten eller den semantiska innebörden av en fråga för att beräkna en ny relevanspoäng över förrankade resultat. |
| Semantiska bildtexter och markeringar | Extraherar ordagranna meningar och fraser från fält som bäst sammanfattar innehållet, med markeringar över viktiga passager för enkel genomsökning. Bildtexter som sammanfattar ett resultat är användbara när enskilda innehållsfält är för kompakta för sökresultatsidan. Markerad text höjer de mest relevanta termerna och fraserna så att användarna snabbt kan avgöra varför en matchning ansågs relevant. |
| Semantiska svar | En valfri och extra understruktur som returneras från en semantisk fråga. Det ger ett direkt svar på en fråga som ser ut som en fråga. Det kräver att ett dokument har text med egenskaperna för ett svar. |
| Frågeomskrivning (förhandsversion) | Med hjälp av textfrågor eller textdelen av en vektorfråga skapar en semantisk rangordnare upp till 10 varianter av frågan, kanske korrigerar stavfel eller felstavningar, eller omformulerar en fråga med hjälp av genererade synonymer. Den omskrivna sökfrågan körs på sökmotorn. Resultaten poängsätts med BM25- eller RRF-poäng och bedöms sedan på nytt av en semantisk rangordnare. |
Hur den semantiska rangordnaren fungerar
Semantisk ranker tar en fråga och resultat och skickar dem sedan till modeller för språktolkning som hanteras av Microsoft. Den söker efter bättre matchningar.
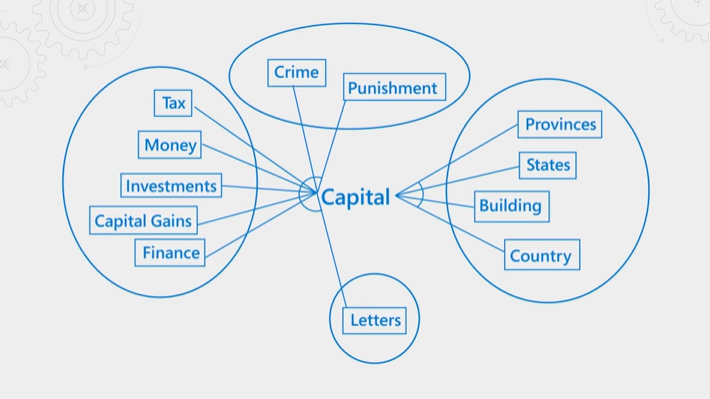
Följande bild förklarar begreppet. Överväg termen "kapital". Den har olika betydelser beroende på om kontexten är ekonomi, lag, geografi eller grammatik. Genom språktolkning identifierar den semantiska rankaren kontexten och höjer upp resultat som passar fråge avsikten.
Semantisk rangordning använder mycket resurser och tid. För att slutföra bearbetningen inom den förväntade svarstiden för en frågeåtgärd konsoliderar och minskar systemet indata till den semantiska rankningen. Den här metoden hjälper dig att slutföra omrankningssteget så snabbt som möjligt.
Semantisk rankning har tre steg:
- Samla in och sammanfatta indata
- Poängsätta resultat med hjälp av semantisk rankning
- Utdata ominspelade resultat, undertexter och svar
Hur systemet samlar in och sammanfattar indata
I semantisk rangordning skickar frågeundersystemet sökresultat som indata till sammanfattnings- och rangordningsmodeller. Eftersom rangordningsmodellerna har begränsningar för indatastorlek och bearbetar intensivt måste sökresultaten vara storleksanpassade och strukturerade (sammanfattade) för effektiv hantering.
Den semantiska rankningen börjar med ett BM25-rankat resultat från en textfråga eller ett RRF-rankat resultat från en vektor- eller hybridfråga. Omrankningsövningen använder endast text. Även om resultaten innehåller mer än 50 resultat går endast de 50 bästa resultaten vidare till semantisk rankning. Vanligtvis använder semantisk rangordning informationsfält och beskrivande fält.
För varje dokument i sökresultatet accepterar sammanfattningsmodellen upp till 2 000 token, där en token är cirka 10 tecken. Modellen monterar indata från fälten "title", "keywords" och "content" som anges i den semantiska konfigurationen.
Systemet trimmar alltför långa strängar för att säkerställa att den totala längden uppfyller indatakraven i sammanfattningssteget. Den här trimningsövningen är därför det är viktigt att lägga till fält i din semantiska konfiguration i prioritetsordning. Om du har mycket stora dokument med textintensiva fält ignorerar systemet allt efter maxgränsen.
Semantiskt fält Tokengräns titel 128 tokens "nyckelord" 128 tokens "innehåll" återstående tokens Sammanfattningsutdata är en sammanfattningssträng för varje dokument, som består av den mest relevanta informationen från varje fält. Systemet skickar sammanfattningar till rankaren för bedömning och till modeller för maskininläsningsförståelse för bildtexter och svar.
Från och med november 2024 är den maximala längden för varje genererad sammanfattningssträng som skickas till den semantiska rankern 2 048 token. Tidigare var det 256 tokens.
Hur resultaten poängsätts
Systemet poängsätter resultat baserat på beskrivningen och annat innehåll från sammanfattningssträngen som fyller ut en längd på 2 048 token.
Systemet utvärderar undertexter för konceptuell och semantisk relevans i förhållande till den fråga som du anger.
Systemet tilldelar ett @search.rerankerScore till varje dokument baserat på dokumentets semantiska relevans för den angivna frågan. Poängen varierar från 4 till 0 (hög till låg), där en högre poäng indikerar högre relevans.
Poäng Menande 4.0 Dokumentet är mycket relevant och besvarar frågan helt, även om passagen kan innehålla extra text som inte är relaterad till frågan. 3.0 Dokumentet är relevant men saknar information som skulle göra det komplett. 2.0 Dokumentet är något relevant. den besvarar frågan antingen delvis eller bara tar upp vissa aspekter av frågan. 1.0 Dokumentet är relaterat till frågan och besvarar en liten del av den. 0.0 Dokumentet är irrelevant. Systemet visar matchningar i fallande ordning efter poäng och innehåller dem i nyttolasten för frågesvar. Nyttolasten innehåller svar, oformaterad text och markerade bildtexter samt eventuella fält som du har markerat som hämtningsbara eller angivna i en select-sats.
Observera
För en viss fråga kan distributionerna av @search.rerankerScore uppvisa små variationer på grund av förhållanden på infrastrukturnivå. Uppdateringar av rangordningsmodeller kan också påverka fördelningen. Om du skriver anpassad kod för minsta tröskelvärden eller anger tröskelvärdesegenskapen för vektor- och hybridfrågor ska du därför inte göra gränserna för detaljerade.
Utdata från semantisk rangordnare
Från varje sammanfattningssträng hittar maskinläsningsförståelsemodellerna de passager som är mest representativa.
Utdata är:
En semantisk bildtext för dokumentet. Varje bildtext är tillgänglig i en oformaterad textversion och en markeringsversion och är ofta färre än 200 ord per dokument.
Ett valfritt semantiskt svar, förutsatt att du angav parametern
answers, frågan ställdes som en fråga och en passage hittas i den långa strängen som ger ett troligt svar på frågan.
Undertexter och svar är alltid ordagrant text från ditt index. Det finns ingen generativ AI-modell i det här arbetsflödet som skapar eller komponerar nytt material.
Semantiska funktioner och begränsningar
Vad semantisk rangordnare kan göra:
Främja matchningar som semantiskt ligger närmare avsikten med den ursprungliga sökfrågan.
Hitta strängar som ska användas som undertexter och svar. Svaret returnerar bildtexter och svar, som du kan återge på en sökresultatsida.
Vad semantisk ranker inte kan göra är att köra frågan igen över hela corpus för att hitta semantiskt relevanta resultat. Semantisk rangordning rangordnar om den befintliga resultatuppsättningen, som består av de 50 bästa resultaten enligt standardrankningsalgoritmen. Dessutom kan semantisk ranker inte skapa ny information eller strängar. Språkmodellerna extraherar bildtexter och svar ordagrant från ditt innehåll, så om resultaten inte innehåller svarsliknande text kommer de inte att producera någon.
Även om semantisk rangordning inte är fördelaktig i varje scenario kan visst innehåll dra stor nytta av dess funktioner. Språkmodellerna i semantisk ranker fungerar bäst på sökbart innehåll som är informationsrikt och strukturerat som prosa. En kunskapsbas, onlinedokumentation eller dokument som innehåller beskrivande innehåll ser de största vinsterna från semantiska rankerfunktioner.
Den underliggande tekniken kommer från Bing och Microsoft Research och är integrerad i Azure AI-sökning infrastruktur som en tilläggsfunktion. Mer information om forsknings- och AI-investeringar som stöder semantisk rankning finns i How AI från Bing driver Azure AI-sökning (Microsoft Research Blog).
Följande video ger en översikt över funktionerna.
Hur semantisk ranker använder synonymkartor
Om du aktiverar stöd för synonymkartor som är associerade med ett fält i ditt sökindex och inkluderar det fältet i konfigurationen för semantisk rankning tillämpar den semantiska rankningen automatiskt de konfigurerade synonymerna under omrankningsprocessen.
Tillgänglighet och priser
Semantisk rankning är tillgänglig i utvalda regioner. Den kan användas som en fristående funktion eller som en inbyggd komponent i agentisk hämtning. Varje funktion faktureras separat.
Semantic ranker erbjuder en kostnadsfri plan (standard) med en månatlig kostnadsfri begäran och en standardplan med en prissättning per användning efter att den kostnadsfria kvoten har förbrukats. Mer information finns i Aktivera eller inaktivera semantisk rankningsfakturering.
Avgifter för semantisk rangordning uppstår när frågebegäranden inkluderar queryType=semantic och söksträngen inte är tom (till exempel search=pet friendly hotels in New York). Om söksträngen är tom (search=*) debiteras du inte, även om queryType är inställd på semantisk.
Så här kommer du igång
(Valfritt) Växla till standardfaktureringsplanen för användning utöver den kostnadsfria månadskvoten.
Konfigurera frågor för att returnera semantiska bildtexter och markeringar.
(Valfritt) Returnera semantiska svar.