Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Observera
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Important
Funktioner, funktioner eller egenskaper som har markerats (förhandsversion) omfattas inte av ett serviceavtal, rekommenderas inte för produktionsarbetsbelastningar och kan ändras eller begränsas innan de blir allmänt tillgängliga. Villkoren för Azure AI-sökning förhandsgranskning gäller för alla förhandsgranskningsfunktioner, oavsett om de är fristående eller en del av en allmänt tillgänglig funktion.
I Azure AI-sökning är agentic retrieval en pipeline med flera frågor som utformats för komplexa frågor som ställs av användare eller agenter i chatt- och copilot-appar. Den är avsedd för retrieval-augmented generation (RAG)-mönster och agent-till-agent-arbetsflöden.
Så här fungerar agentbaserad informationshämtning:
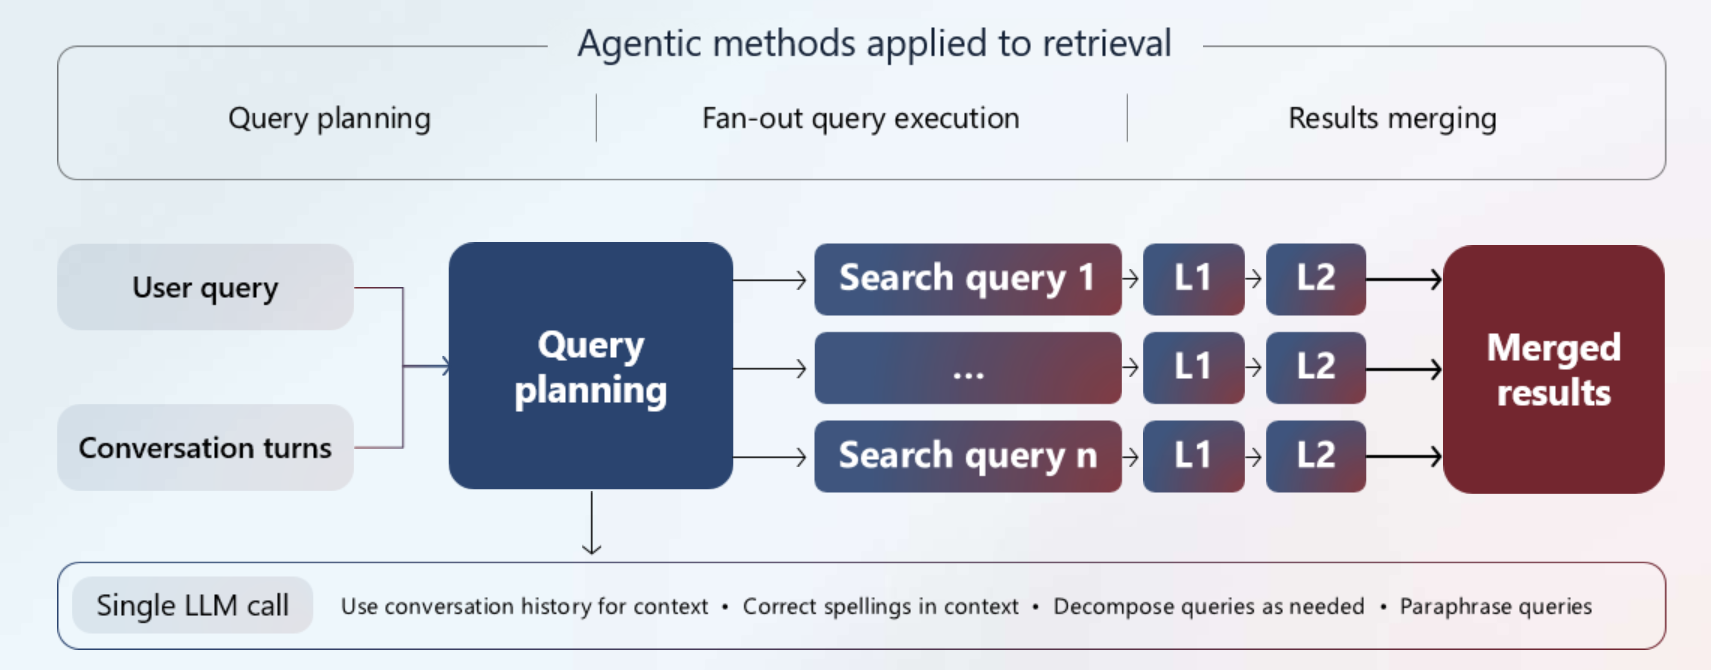
Kan använda LLM-baserad frågeplanering (förhandsversion) för att dela upp en komplex fråga i mindre, fokuserade underfrågor för bättre täckning över upphovsrättsskyddat och externt innehåll. Frågeplanering kan använda chatthistorik för ytterligare kontext.
Kör underfrågor parallellt. Varje underfråga rangordnas semantiskt om för att höja upp de mest relevanta matchningarna.
Kombinerar de bästa resultaten till ett enhetligt svar som en LLM kan använda för att generera grundsvar.
Kan returnera källreferenser och en aktivitetslogg tillsammans med det sammanfogade innehållet, så att du bara kan använda grunddata eller skicka dem till en LLM för ett fullständigt svar.
Den här högpresterande pipelinen hjälper dig att generera högkvalitativa jordningsdata eller svar för chattprogrammet, med möjlighet att snabbt besvara komplexa frågor.
Varför ska du använda agentbaserad hämtning?
Agentbaserad hämtning stöder både hanterade och anpassade lösningar för agenter och appar. I Microsoft Foundry-portalen driver den Foundry IQ som ett hanterat kunskapslager för agenter. Du kan också skapa anpassade lösningar för agentisk hämtning med hjälp av Azure-portalen, REST-API:et för söktjänsten eller en Azure SDKs som stöds.
Använd agentisk hämtning när du vill ge agenter och appar det mest relevanta innehållet för att besvara svårare frågor, dra nytta av chattkontext, ditt upphovsrättsskyddade innehåll och externa källor.
Agentisk hämtning lägger till svarstid jämfört med en pipeline med en enda fråga, men den hanterar frågekomplexitet som en enskild fråga inte kan. Den kan till exempel hantera:
Frågor med flera frågor, till exempel "hitta mig ett hotell nära stranden, med flygplatstransport, och det är inom gångavstånd från vegetariska restauranger."
Frågor som är beroende av tidigare kontext i konversationen.
Frågor som drar nytta av att skriva om med hjälp av synonymkartor och LLM-genererade omfraser för att utöka täckningen i innehållet.
Stavfel.
Arkitektur och arbetsflöde
Den agentiska hämtningsprocessen fungerar på följande sätt:
Arbetsflödesinitiering: Ditt program anropar en kunskapsbas med en hämtningsåtgärd som tillhandahåller en fråge- och konversationshistorik.
Frågeplanering: Vid
lowochmediumhämtning av resonemang skickar kunskapsbasen din fråge- och konversationshistorik till en LLM, som genererar fokuserade underfrågor. Detminimalhär steget hoppas över och frågor utfärdas direkt till kunskapskällor. Resonemangsinsats har standardvärdetlowoch konfigureras i kunskapsbasen.Frågekörning: Kunskapsbasen skickar underfrågorna till dina kunskapskällor. Alla underfrågor körs samtidigt och kan vara nyckelord, vektor eller hybridsökning. Varje underfråga genomgår semantisk reranking för att hitta de mest relevanta matchningarna. Referenser extraheras och behålls i källhänvisningssyfte.
Resultatsyntes: Systemet kombinerar alla resultat till ett enhetligt svar. Sammanslaget innehåll returneras alltid. Källhänvisningar och en aktivitetslogg för körning är valfria.
Components
För alla scenarier för agentisk hämtning krävs en kunskapsbas och minst en kunskapskälla. Andra komponenter är valfria och beror på din konfiguration.
| Komponent | Tjänst | Roll |
|---|---|---|
| Kunskapsbas | Azure AI-sökning | Samordnar pipelinen, hanterar kunskapskällor och frågeparametrar. |
| Kunskapskälla | Azure AI-sökning | Definierar innehållet som används i pipelinen. Kan indexeras (backas upp av ett sökindex på din tjänst) eller fjärranslutet (innehåll som hämtas vid frågetillfället från en extern plattform). |
| Sökindex | Azure AI-sökning | Lagrar sökbart innehåll (text och vektorer) med en semantisk konfiguration. Avgör vilka frågetyper som körs och vilka optimeringar som gäller. Krävs endast för indexerade kunskapskällor. |
| Semantisk rangordnare | Azure AI-sökning | Används internt av den agentbaserade hämtningspipelinen för att omrangordna resultat efter relevans (L2-omrangordning). |
| LLM | Azure OpenAI | Kan driva flera faser av agentisk hämtning: planera frågor och välja kunskapskällor (förhandsversion), sammanfatta webbresultat och generera källhänvisningar via svarssyntes (förhandsversion). |
Integreringskrav
Ditt program driver pipelinen genom att anropa kunskapsbasen och hantera svaret. Pipelinen returnerar grunddata som du kan skicka till en LLM för svarsgenerering eller använda direkt i konversationsgränssnittet. Mer information om implementering finns i Självstudie: Skapa en lösning för agentisk hämtning från slutpunkt till slutpunkt.
Tillgänglighet av funktioner
Agentisk hämtning stöder både allmänt tillgängliga funktioner och förhandsgranskningsfunktioner. Välj rest-API-versionen för söktjänsten som matchar din agentiska hämtningsupplevelse:
Använd REST-API:et
2026-04-01för produktionsarbetsbelastningar som använder allmänt tillgängliga typer av kunskapskällor med minimal, extraktiv hämtning.Använd REST-API:et
2026-08-01-previewför kunskapskälltyper och funktioner i förhandsversion, till exempel LLM-baserad frågeplanering, svarssyntes, icke-minimal resonemangsinsats vid hämtning och meddelanden i flera omgångar. Se Azure AI-sökning förhandsversionsvillkor.
Portalen Azure och Microsoft Foundry ger endast förhandsversionsåtkomst till alla funktioner för agentisk hämtning. Objekt som skapats i någon av portalerna kan använda förhandsversionsscheman och kräva migrering när du flyttar till den allmänt tillgängliga REST API-versionen. En versionsvis genomgång och migreringsvägledning finns i Migrera kod för agentbaserad hämtning till den senaste versionen.
Regiontillgänglighet, gränser och fakturering
Innan du använder agentisk hämtning bör du granska dess regionala tillgänglighet, tjänstgränser och faktureringsmodell.
Tillgänglighet i regionen
Agentisk hämtning är tillgänglig i utvalda regioner.
Limits
Kunskapskällor och kunskapsbaser har maximala gränser som varierar beroende på prisnivå och hämtningsskäl.
Fakturering
Agentisk hämtning medför avgifter från två tjänster:
Azure AI-sökning debiterar för hämtningstokens som förbrukas under underfrågors körning och semantisk rangordning. Den kostnadsfria planen (standard) ger en månatlig tokenersättning. Standardplanen möjliggör prissättning baserad på användning efter att den kostnadsfria tilldelningen har förbrukats. Mer information finns i Aktivera eller inaktivera agentbaserad hämtningsfakturering.
Azure OpenAI-fakturor för in- och utdatatoken som används i LLM-baserad frågeplanering och svarssyntes (förhandsversion). Prissättningen är alltid betala per användning och baseras på den modell som du tilldelar kunskapsbasen. Avgifter visas på din Azure OpenAI-faktura. Priser finns i Azure OpenAI-priser.
I följande tabell jämförs faktureringen mellan den klassiska pipelinen med en fråga och pipelinen för agentisk hämtning av flera frågor. I den klassiska pipelinen är den fakturerbara komponenten semantisk ranker.
| Aspekt | Klassisk pipeline | Agentbaserad hämtning |
|---|---|---|
| Enhet | Frågebaserad | Tokenbaserad |
| Kostnad per enhet | Enhetlig kostnad per fråga | Variabel kostnad per token (beror på resonemangsinsats) |
| Kostnadsuppskattning | Beräkna antalet frågor | Uppskatta tokenanvändning |
| Kostnadsfri ersättning | Månatlig kostnadsfri frågeersättning | Månatlig kostnadsfri token-ersättning |
Exempel: Beräkna kostnader
Det här exemplet hjälper till att illustrera kostnadsuppskattningsprocessen för frågeplanering och frågekörning, men inte för svarssyntes. Dina kostnader kan vara lägre. För aktuella priser, se prissättningen för Azure AI-sökning och Azure OpenAI.
För att uppskatta kostnaderna för frågeprocessplanen som pay-as-you-go i Azure OpenAI, antag gpt-4o-mini:
- 15 cent för 1 miljon indatatoken.
- 60 cent för 1 miljon utdatatoken.
- 2 000 indatatoken för genomsnittlig chattkonversationsstorlek.
- 350 tokens för genomsnittlig storlek på utdataplan.
Uppskattade faktureringskostnader för queryutförande
Om du vill beräkna antalet agentiska hämtningstoken börjar du med en uppfattning om hur ett genomsnittligt dokument i ditt index ser ut. Du kan till exempel approximera:
- 10 000 segment, där varje segment är ett till två stycken i en PDF.
- 500 token per segment.
- Varje del-fråga berankas om upp till 50 klossar.
- I genomsnitt finns det tre underfrågor per frågeplan.
Beräkning av körningskostnad
Anta att vi gör 2 000 agentiska hämtningar med tre underfrågor per plan. Detta ger oss cirka 6 000 totala frågor.
Reranka 50 databitar per delfråga, vilket är totalt 300 000 databitar.
Genomsnittligt chunk är 500 tokens, så det totala antalet tokens för omrankning är 150 miljoner.
Med tanke på ett hypotetiskt pris på 0,022 per token är den totala kostnaden för omrankning 3,30 USD i amerikanska dollar.
Gå vidare till frågeplanskostnader: 2 000 indatotokener multiplicerat med 2 000 agenthämtningar motsvarar 4 miljoner indatotokener för totalt 60 cent.
Beräkna utdatakostnaderna baserat på ett genomsnittligt antal av 350 token. Om vi multiplicerar 350 med 2 000 agentiska hämtningar får vi totalt 700 000 utdatatoken för totalt 42 cent.
Om du sätter ihop allt skulle du betala cirka $ 3.30 för agentisk hämtning i Azure AI-sökning, 60 cent för indatatoken i Azure OpenAI och 42 cent för utdatatoken i Azure OpenAI, för $ 1.02 för frågeplanering totalt. Den sammanlagda kostnaden för den fullständiga körningen är 4,32 USD.
Tips för att kontrollera kostnader
Granska aktivitetsloggen i svaret för att ta reda på vilka frågor som har utfärdats till vilka källor och parametrar som används. Du kan skicka dessa frågor på nytt mot dina index och använda en offentlig tokeniserare för att uppskatta token och jämföra med API-rapporterad användning. Exakt rekonstruktion av en fråga eller ett svar är dock inte garanterat. Faktorer inkluderar typen av kunskapskälla, till exempel offentliga webbdata eller en fjärransluten SharePoint kunskapskälla som bygger på en användaridentitet, vilket kan påverka frågereproduktion.
Minska antalet kunskapskällor (index); konsolidering av innehåll kan minska förgrenings- och tokenvolymen.
Minska resonemanget för att minska LLM-användningen vid frågeplanering och frågeexpansion (iterativ sökning).
Ordna innehåll så att den mest relevanta informationen kan hittas med färre källor och dokument (till exempel kuraterade sammanfattningar eller tabeller).
Så här kommer du igång
Om du vill skapa en lösning för agentisk hämtning kan du använda portalen Azure, Microsoft Foundry (ny), REST-API:er eller ett motsvarande Azure SDKs paket.
- Quickstart: Agentisk hämtning i Azure-portalen
- Snabbstart: Agentisk hämtning (C#, Java, JavaScript, Python, TypeScript, REST)