Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Kommentar
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Ibland stöter indexerare på problem som inte ger upphov till fel eller som inträffar på andra Azure-tjänster, till exempel under autentisering eller vid anslutning. Den här artikeln fokuserar på felsökning av indexeringsproblem när det inte finns några meddelanden som hjälper dig. Det ger också felsökning för fel som kommer från icke-sökresurser som används under indexering.
Kommentar
Om du har ett Azure AI-sökning-fel att undersöka kan du läsa Felsöka vanliga indexeringsfel och varningar i stället.
Metodtips
Det här är några metodtips och rekommendationer när du arbetar med indexerare:
Indexerare är utformade för att köras enligt ett schema
- Konfigurera indexerarna så att de körs enligt ett regelbundet schema för tillförlitlig indexering. Schemalagda körningar hämtar automatiskt alla dokument som missats i tidigare körningar på grund av tillfälliga fel, nätverksavbrott eller tillfälliga tjänstproblem. Den här metoden hjälper till att upprätthålla datakonsekvens och minimerar behovet av manuella åtgärder.
- För stora datakällor kan den inledande uppräkningen och indexeringen ta timmar eller till och med dagar. Om du kör indexeraren enligt ett schema kan förloppet fortsätta och felen görs automatiskt igen. Undvik att enbart förlita dig på manuella indexeringskörningar eller indexeringskörningar på begäran, eftersom dessa alternativ inte ger samma tillförlitlighet eller återhämtning efter tillfälliga fel.
Indexerare ger bästa möjliga indexering över tid
- Inbyggda indexerare bearbetar dokument utan bestående fel och försöker igen vid schemalagda körningar. De erbjuder ett bekvämt sätt med låg kod eller ingen kod för att indexera data för vanliga scenarier, vilket möjliggör snabbare utveckling och enklare underhåll. När ett indexeringsverktyg kör en kunskapsuppsättning har varje körning en fast tidsgräns. Indexerare som körs i körningsmiljön för flera klientorganisationer har en maximal körningstid på två timmar. Den här gränsen är det vanligaste fallet, som används när kompetensuppsättningar inte kräver delade privata länkar. Indexerare som har konfigurerats för att använda delade privata länkar körs i en privat körmiljö med en maximal körtid på 24 timmar. Den fullständiga tabellen finns i Indexer-gränser. Om bearbetning av kunskapsuppsättningar per dokument hindrar indexeraren från att slutföras före tidsgränsen stoppas och återstående dokument lämnas obearbetade. Det är inte säkert att bearbetningen slutförs när dokumentvolym, filstorlek, komplexiteten i kompetensuppsättningen eller körningsmiljön hindrar indexeraren från att slutföra körningen inom sin maximala körtid. Partitionering av datakällan kan minska den här risken men eliminerar den inte, särskilt om du senare lägger till stora mängder filer i en partition. Detta är ett förväntat beteende. Information om strategier för att hantera stora datamängder och stödja inkrementell återställning finns i Indexera stora datauppsättningar och Schemalägga indexerare. Om din lösning kräver strikt kontroll över när indexeraren bearbetar dokument använder du push-API-alternativet i den här artikeln.
- Om din lösning kräver strikt kontroll över indexeringstidslinjen använder du push-API:erna i stället, till exempel REST API för dokumentindex eller metoden IndexDocuments (Azure SDKs för .NET). De här alternativen ger dig fullständig kontroll över indexeringspipelinen.
- Indexerare kan ibland hamna utanför tidsplanen. Även om det här villkoret är ovanligt och det finns mekanismer för automatisk återställning kan återställningen ta tid. Detta är ett förväntat beteende.
Felsöka anslutningar till begränsade resurser
För datakällor under Azure-nätverkssäkerhet är indexerare begränsade i hur de ansluter. För närvarande kan indexerare komma åt begränsade datakällor bakom en IP-brandvägg eller i ett virtuellt nätverk via en privat slutpunkt med hjälp av en delad privat länk.
Det gick inte att ansluta till en Microsoft Foundry-resurs på en privat anslutning
Om du får felkod 403 med följande meddelande kan du ha problem med hur resursslutpunkten anges i en kompetensuppsättning:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
Det här felet uppstår om du har konfigurerat en delad privat länk för anslutningar till en Azure Foundry-resurs och slutpunkten saknar en anpassad underdomän. En anpassad underdomän är den första delen av slutpunkten (till exempel http://my-custom-subdomain.services.ai.azure.com). En anpassad domän kanske saknas om du har skapat resursen i Foundry-portalen i stället för Azure-portalen.
Om Foundry-resursen inte finns i samma region som Azure AI-sökning använder du en nyckellös anslutning för att koppla resursen.
Fel vid användning av en delad privat länk
Om du får felkod 403 med följande meddelande kan indexeraren ansluta via den offentliga slutpunkten i stället för en godkänd delad privat länk:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
Det här felet kan inträffa när indexeraren inte har konfigurerats för att använda den privata körningsmiljön. Bekräfta att den delade privata länken är godkänd, ange indexerarens executionEnvironment till privateoch kontrollera att anslutningen använder rätt resursslutpunkt och grupp-ID.
Brandväggsregler
Azure Storage, Azure Cosmos DB och Azure SQL tillhandahåller en konfigurerbar brandvägg. Det finns inget specifikt felmeddelande när brandväggen blockerar begäran. Vanligtvis är brandväggsfel allmänna. Några vanliga fel är:
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
Om du vill tillåta indexerare att komma åt dessa resurser använder du något av följande alternativ:
Konfigurera en inkommande regel för IP-adressen för söktjänsten och IP-adressintervallet
AzureCognitiveSearchför tjänsttaggen. Mer information om hur du konfigurerar BEGRÄNSNINGAR för IP-adressintervall för varje datakälla finns i följande länkar:Som en sista utväg eller som ett tillfälligt mått inaktiverar du brandväggen genom att tillåta åtkomst från Alla nätverk.
Begränsning: Begränsningar för IP-adressintervall fungerar bara om din söktjänst och ditt lagringskonto finns i olika regioner.
Utöver datahämtning skickar indexerare även utgående begäranden via färdighetsuppsättningar och anpassade färdigheter. För anpassade kunskaper baserat på en Azure-funktion bör du vara medveten om att Azure-funktioner också har IP-adressbegränsningar. Listan över IP-adresser som ska tillåtas för anpassad kompetenskörning inkluderar IP-adressen för din söktjänst och IP-adressintervallet AzureCognitiveSearch för tjänsttaggen.
Regler för nätverkssäkerhetsgrupper (NSG)
När en indexerare kommer åt data på en SQL-hanterad instans, eller när en virtuell Azure-dator används som webbtjänst-URI för en anpassad färdighet, avgör nätverkssäkerhetsgruppen om begäranden tillåts i.
För externa resurser som finns i ett virtuellt nätverk konfigurerar du inkommande NSG-regler för AzureCognitiveSearch tjänsttaggen.
Mer information om hur du ansluter till en virtuell dator finns i Konfigurera en anslutning till SQL Server på en virtuell Azure-dator.
Nätverksfel
Vanligtvis är nätverksfel allmänna. Några vanliga fel är:
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
När du får något av följande fel:
- Kontrollera att du kan komma åt din källa genom att försöka ansluta till den direkt och inte via söktjänsten.
- Kontrollera om det finns aktuella fel eller avbrott i resursen i Azure portalen.
- Sök efter nätverksfel i Azure Status.
- Kontrollera att du använder en offentlig DNS för namnmatchning och inte en Azure Private DNS.
Serverlös indexering i Azure SQL Database (felkod 40613)
Om SQL-databasen finns på en serverlös beräkningsnivå kontrollerar du att databasen körs (och inte pausas) när indexeraren ansluter till den.
Om databasen har pausats återupptar den första inloggningen från söktjänsten databasen automatiskt, men returnerar i stället ett fel som anger att databasen inte är tillgänglig, vilket ger felkoden 40613. När databasen har körts försöker du logga in igen för att upprätta anslutningen.
Principer för villkorsstyrd åtkomst i Microsoft Entra ID
När du skapar en SharePoint-indexerare måste du logga in på din Microsoft Entra app när du har angett en enhetskod. Om du får ett meddelande om att "Your sign-in was successful but your admin requires the device requesting access to be managed"en princip för villkorsstyrd åtkomst förmodligen blockerar indexeraren från SharePoint dokumentbiblioteket.
Så här uppdaterar du principen och ger indexeraren åtkomst till dokumentbiblioteket:
Öppna Azure Portal och sök efter villkorsstyrd åtkomst i Microsoft Entra.
Välj Principer på den vänstra menyn. Om du inte har åtkomst att visa den här sidan måste du antingen hitta någon som har åtkomst eller få åtkomst.
Ta reda på vilken princip som hindrar SharePoint-indexeraren från att komma åt dokumentbiblioteket. Principen som kan blockera indexeraren innehåller det användarkonto som du använde för att autentisera när indexeraren skapades i avsnittet Användare och grupper . Principen kan också ha villkor som:
- Begränsa Windows-plattformar .
- Begränsa mobilappar och skrivbordsklienter.
- Ange Enhetstillstånd till Ja.
När du har bekräftat vilken princip som blockerar indexeraren gör du ett undantag för indexeraren. Börja med att hämta söktjänstens IP-adress.
Hämta först det fullständigt kvalificerade domännamnet (FQDN) för söktjänsten. FQDN ser ut som
<your-search-service-name>.search.windows.net. Du hittar FQDN i Azure Portal.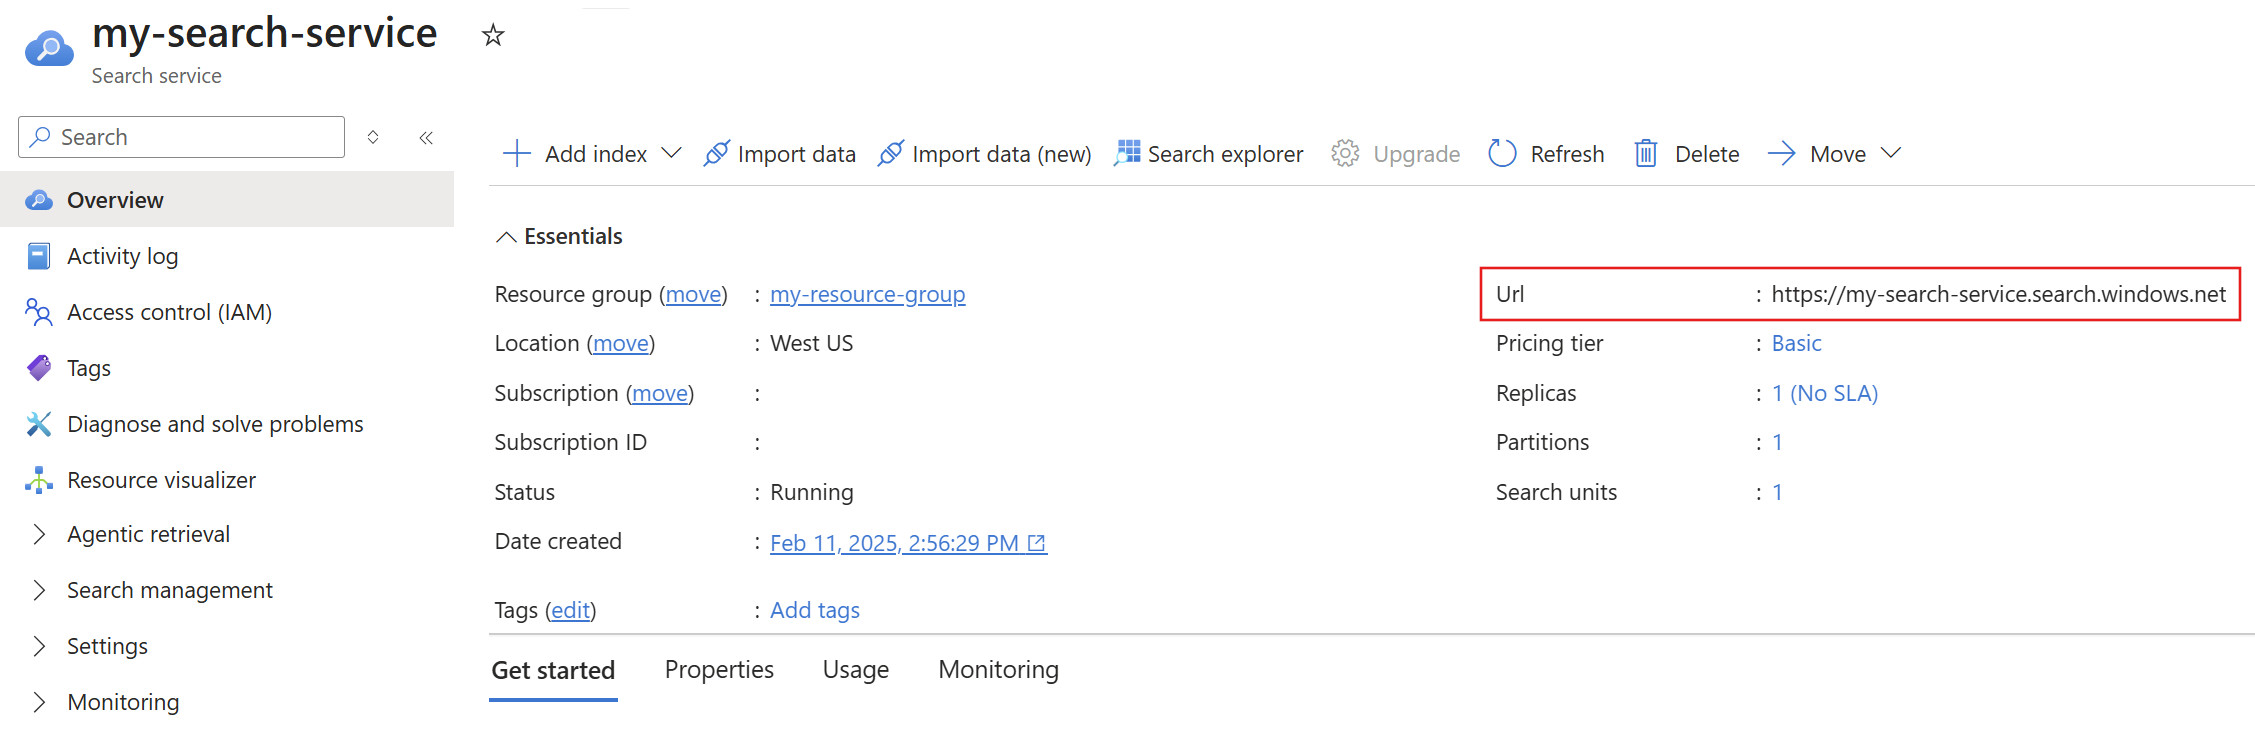
Nu när du har det fullständiga domännamnet, hämtar du IP-adressen för söktjänsten genom att utföra en
nslookup(eller enping) av det fullständiga domännamnet. I följande exempel lägger du till150.0.0.1i en inkommande regel i Azure Storage-brandväggen. Det kan ta upp till 15 minuter efter att brandväggsinställningarna har uppdaterats för söktjänstindexeraren att komma åt Azure Storage-kontot.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netHämta IP-adressintervallen för indexerarens körningsmiljö för din region.
Extra IP-adresser används för begäranden som kommer från indexerarens körningsmiljö för flera klienter. Du kan hämta det här IP-adressintervallet från tjänsttaggen.
Du kan hämta IP-adressintervallen för
AzureCognitiveSearchtjänsttaggen via Discovery API eller den nedladdningsbara JSON-filen.I den här övningen, om söktjänsten finns i Azure Public-molnet, laddar du ned JSON-filen för Azure Public.
I JSON-filen listas IP-adresserna för multitenant-indexerarens körningsmiljö, förutsatt att söktjänsten finns i West Central US.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
På sidan Villkorlig åtkomst i Azure Portal väljer du Namngivna platser på menyn till vänster och väljer sedan + IP-intervallplats. Ge den nya namngivna platsen ett namn och lägg till IP-intervallen för söktjänsten och indexerarens körningsmiljöer som du har samlat in i de två senaste stegen. 1
- För din IP-adress för söktjänsten kan du behöva lägga till "/32" i slutet av IP-adressen eftersom den endast accepterar giltiga IP-intervall.
- Kom ihåg att för IP-intervallen för indexerarens körningsmiljö behöver du bara lägga till IP-intervallen för den region som söktjänsten finns i.
Undanta den nya namngivna platsen från principen:
- Välj Principer på den vänstra menyn.
- Välj den princip som blockerar indexeraren.
- Välj Villkor.
- Välj Platser.
- Välj Exkludera och lägg sedan till den nya namngivna platsen.
- Spara ändringarna.
Vänta några minuter tills policyn uppdateras så verkställs de nya policyreglerna.
Försök att skapa indexeraren igen:
- Skicka en uppdateringsbegäran för datakällans objekt som du skapade.
- Skicka om begäran om att skapa indexeraren igen. Använd den nya koden för att logga in och skicka sedan en annan begäran om att skapa indexeraren.
Indexering av dokumenttyper som inte stöds
Om du indexerar innehåll från Azure Blob Storage och containern innehåller blobar av en innehållstyp som inte stöds hoppar indexeraren över dokumentet. I andra fall kan det finnas problem med enskilda dokument.
I den här situationen kan du ange konfigurationsalternativ så att indexerarens bearbetning kan fortsätta om det finns problem med enskilda dokument.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Dokument som saknas
Indexerare extraherar dokument eller rader från en extern datakälla och skapar sökdokument som söktjänsten indexerar. Ibland visas inte ett dokument som finns i datakällan i ett sökindex. Det här oväntade resultatet kan inträffa på grund av följande orsaker:
- Du uppdaterade dokumentet efter att indexeraren körts. Om indexeraren följer ett schema, körs den så småningom igen och hämtar dokumentet.
- Indexeraren gick ut innan dokumentet kunde bearbetas. Det finns maximala tidsgränser för bearbetning varefter inga dokument bearbetas. Du kan kontrollera indexerarens status i Azure Portal eller genom att anropa REST API (Get Indexer Status).
- Fältmappningar eller AI-berikning ändrade dokumentet och dess artikulation i sökindexet skiljer sig från vad du förväntar dig.
- Ändringsspårningsvärden är felaktiga eller krav saknas. Om ditt värde för högvattenstämpel är ett datum som har angetts till en framtida tid hoppar indexeraren över alla dokument som har ett tidigare datum. Du kan fastställa indexerarens ändringsspårningstillstånd med hjälp av fälten
initialTrackingStateochfinalTrackingStatei indexerarens status. Indexerare för Azure SQL och MySQL måste ha ett index på högvattenmärkeskolumnen i källtabellen, eller så kan frågor som används av indexeraren överskrida tidsgränsen.
Tips
Om dokument saknas kontrollerar du den fråga som du använder för att se till att det inte utesluter dokumentet i fråga. Om du vill fråga efter ett visst dokument använder du REST-API:et för uppslagsdokument.
Innehåll saknas från Blob Storage
Blobindexeraren hittar och extraherar text från blobar i en container. Några problem med att extrahera text är:
Dokumentet innehåller endast skannade bilder. PDF-blobar som har icke-textinnehåll, till exempel skannade bilder (JPG:er), ger inte resultat i en standardpipeline för blobindexering. Om du har bildinnehåll med textelement kan du använda OCR eller bildanalys för att hitta och extrahera texten.
Blob-indexeraren är konfigurerad att endast indexera metadata. Om du vill extrahera innehåll måste du konfigurera blobindexeraren för att extrahera både innehåll och metadata:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Innehåll saknas från Azure Cosmos DB
Azure AI-sökning har ett implicit beroende av Azure Cosmos DB-indexering. Om du inaktiverar automatisk indexering i Azure Cosmos DB returnerar Azure AI-sökning ett lyckat tillstånd, men kan inte indexera containerinnehållet. Anvisningar om hur du kontrollerar inställningar och aktiverar indexering finns i Hantera indexering i Azure Cosmos DB.
Dokumentantalsavvikelse mellan datakällan och indexet
En indexerare kan visa ett annat dokumentantal än antingen datakällan, själva indexet eller antalet i koden. Här följer några möjliga orsaker till varför det här beteendet kan inträffa:
- Indexet kan visa det faktiska antalet dokument med fördröjning, särskilt i Azure-portalen.
- Indexeraren har en princip för borttaget dokument. De borttagna dokumenten räknas av indexeraren om dokumenten indexeras innan de tas bort.
- Om ID-kolumnen i datakällan inte är unik. Det här villkoret gäller för datakällor som har begreppet kolumner, till exempel Azure Cosmos DB.
- Om datakällans definition har en annan fråga än den du använder för att estimera antalet poster. I din databas kör du till exempel frågor mot antalet databasposter, medan du i definitionsfrågan för datakällan bara väljer en delmängd av poster som ska indexeras.
- Antalet kontrolleras med olika intervall för varje komponent i pipelinen: datakälla, indexerare och index.
- Datakällan har en fil som är mappad till många dokument. Det här villkoret kan inträffa när indexering av blobar och "parsingMode" är inställt på
jsonArrayochjsonLines.
Dokument som bearbetas flera gånger
Indexerare använder en konservativ buffringsstrategi för att säkerställa att varje nytt och ändrat dokument i datakällan hämtas under indexeringen. I vissa situationer kan dessa buffertar överlappa varandra, vilket gör att indexeraren indexerar ett dokument två eller flera gånger. Därför är antalet bearbetade dokument mer än det faktiska antalet dokument i datakällan. Det här beteendet påverkar inte de data som lagras i indexet, till exempel genom att dokument dupliceras, utan innebär bara att det kan ta längre tid att uppnå eventuell konsistens. Det här villkoret är särskilt vanligt om något av följande villkor är sant:
- Begäranden om indexerare på begäran utfärdas i snabb följd.
- Datakällans topologi innehåller flera repliker och partitioner, till exempel topologin som beskrivs i Konsekvensnivåer i Azure Cosmos DB.
- Datakällan är en Azure SQL databas och kolumnen som valts som "högvattenmärke" är av typen
datetime2.
Indexerare är inte avsedda att anropas flera gånger i snabb följd. Om du behöver uppdateringar snabbt är den metod som stöds att skicka uppdateringar till indexet samtidigt som datakällan uppdateras. För bearbetning på begäran kan du öka takten för dina begäranden i femminutersintervall eller mer och köra indexeraren enligt ett schema.
Exempel på duplicerad dokumentbearbetning med 30 sekunders buffert
Följande tidslinje förklarar de villkor under vilka ett dokument bearbetas två gånger. Den noterar varje åtgärd och motåtgärd. Följande tidslinje illustrerar problemet:
| Tidslinje (hh:mm:ss) | Evenemang | Indexerarens högvattenmärke | Kommentar |
|---|---|---|---|
| 00:01:00 | Skriv doc1 till datakälla med eventuell konsistens |
null |
Tidsstämpeln för dokument är 00:01:00. |
| 00:01:05 | Skriv doc2 till datakälla med eventuell konsistens |
null |
Tidsstämpeln för dokument är 00:01:05. |
| 00:01:10 | Indexeraren startar | null |
|
| 00:01:11 | Indexern frågar efter alla ändringar före 00:01:10; replikan som indexern frågar från råkar bara vara medveten om doc2; endast doc2 hämtas |
null |
Indexeraren begär alla ändringar innan tidsstämpeln startas, men tar faktiskt emot en delmängd. Det här beteendet kräver tillbakablicksbuffertperioden. |
| 00:01:12 | Indexeraren bearbetar doc2 för första gången |
null |
|
| 00:01:13 | Indexeraren slutar | 00:01:10 | Gränsvärdet uppdateras till starttiden för den aktuella indexerarens körning. |
| 00:01:20 | Indexeraren startar | 00:01:10 | |
| 00:01:21 | Indexerare frågar efter alla ändringar mellan 00:00:40 och 00:01:20; repliken som indexeraren frågar råkar känna till både doc1 och doc2; hämtar doc1 och doc2 |
00:01:10 | Indexern begär alla ändringar mellan det aktuella högvattenmärket minus en buffert på 30 sekunder och den nuvarande indexeringskörningens starttidsstämpel. |
| 00:01:22 | Indexeraren bearbetar doc1 för första gången |
00:01:10 | |
| 00:01:23 | Indexeraren bearbetar doc2 för andra gången |
00:01:10 | |
| 00:01:24 | Indexeraren slutar | 00:01:20 | Gränsvärdet uppdateras till starttiden för den aktuella indexerarens körning. |
| 00:01:32 | Indexeraren startar | 00:01:20 | |
| 00:01:33 | Indexerare frågar efter alla ändringar mellan 00:00:50 och 00:01:32; hämtar doc1 och doc2 |
00:01:20 | Indexern begär alla ändringar mellan det aktuella högvattenmärket minus en buffert på 30 sekunder och den nuvarande indexeringskörningens starttidsstämpel. |
| 00:01:34 | Indexeraren bearbetar doc1 för andra gången |
00:01:20 | |
| 00:01:35 | Indexeraren bearbetar doc2 för tredje gången |
00:01:20 | |
| 00:01:36 | Indexeraren slutar | 00:01:32 | Gränsvärdet uppdateras till starttiden för den aktuella indexerarens körning. |
| 00:01:40 | Indexeraren startar | 00:01:32 | |
| 00:01:41 | Indexerare frågar efter alla ändringar mellan 00:01:02 och 00:01:40; Hämtar doc2 |
00:01:32 | Indexern begär alla ändringar mellan det aktuella högvattenmärket minus en buffert på 30 sekunder och den nuvarande indexeringskörningens starttidsstämpel. |
| 00:01:42 | Indexeraren bearbetar doc2 för fjärde gången |
00:01:32 | |
| 00:01:43 | Indexeraren slutar | 00:01:40 | Observera att indexerarens körning startade mer än 30 sekunder efter den senaste skrivningen till datakällan och bearbetade också doc2. Detta är det förväntade beteendet eftersom om alla indexerarekörningar före 00:01:35 elimineras blir detta den första och enda körningen för att bearbeta doc1 och doc2. |
I praktiken sker det här scenariot bara när du manuellt anropar indexerare på begäran inom några minuter från varandra, för vissa datakällor. Det kan resultera i inkonsekventa siffror (som att indexeraren bearbetade totalt 345 dokument enligt indexerarens körningsstatistik, men det finns 340 dokument i datakällan och indexet) eller potentiellt ökad fakturering om du kör samma tjänster för samma dokument flera gånger. Att köra en indexerare med ett schema är den rekommenderade rekommendationen.
Parallell indexering
När flera indexerare körs samtidigt anger vissa indexerare vanligtvis en kö och väntar på tillgängliga resurser innan de börjar. Flera faktorer avgör hur många indexerare som kan köras samtidigt. Om indexerarna inte länkar till kunskapsuppsättningar avgör antalet repliker och partitioner i AI Search-tjänsten hur många indexerare som kan köras parallellt.
Om du associerar en indexerare med en kompetensuppsättning, körs den i AI Searchs interna kluster. Komplexiteten i kompetensuppsättningen och om andra kompetensuppsättningar körs samtidigt avgör hur många indexerare som kan köras samtidigt. Inbyggda indexerare extraherar data från källan på ett tillförlitligt sätt, så inga data missas om de körs enligt ett schema. Indexerarens processer för parallellisering och utskalning behöver dock lite tid att slutföra.
Indexera dokument med känslighetsetiketter
Om du anger känslighetsetiketter för dokument kanske du inte kan indexera dem. Om du får fel tar du bort etiketterna innan du indexerar.