Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Примечание.
Поиск с использованием ИИ Azure доступна через портал Azure, REST API и Azure SDKs. Он также лежит в основе Foundry IQ — управляемого слоя знаний, который преобразует корпоративный контент в многократно используемые базы знаний с учетом разрешений доступа для агентов на портале Microsoft Foundry.
Иногда индексаторы могут столкнуться с проблемами, которые не создают ошибок или возникают в других службах Azure, например во время проверки подлинности или при подключении. В этой статье рассматривается устранение неполадок индексатора, когда нет сообщений, которые помогут вам. Он также предоставляет возможности для устранения неполадок, возникающих из-за ресурсов, не связанных с поиском, которые используются во время индексирования.
Примечание.
Если вам нужно исследовать ошибку Поиск с использованием ИИ Azure, см. статью "Устранение распространенных ошибок и предупреждений индексатора".
Лучшие практики
Ниже приведены некоторые основные практики и рекомендации при работе с индексаторами.
Индексаторы предназначены для запуска по расписанию
- Для надежного индексирования настройте индексаторы для выполнения в обычном расписании. Запланированные запуски автоматически собирают все документы, пропущенные в предыдущих запусках из-за временных ошибок, прерываний сети или временных проблем со службой. Этот подход помогает поддерживать согласованность данных и сводит к минимуму потребность в ручном вмешательстве.
- Для больших источников данных начальное перечисление и индексирование может занять несколько часов или даже дней. Запуск индексатора по расписанию позволяет обеспечить непрерывную работу, а ошибки будут автоматически обработаны повторно. Избегайте использования только ручных запусков индексатора или запусков по запросу, так как эти варианты не обеспечивают такой же надежности и восстановления после временных ошибок.
Индексаторы обеспечивают наилучшее возможное индексирование на протяжении времени.
- Встроенные индексаторы обрабатывают документы без постоянных ошибок и повторных попыток в запланированных запусках. Они предлагают удобный, низкокодовый или безкодовый способ индексировать данные для распространенных сценариев, что позволяет ускорить разработку и упростить обслуживание. Когда индексатор запускает набор навыков, каждый запуск имеет фиксированный предел времени выполнения. Индексаторы, выполняемые в мультитенантной среде выполнения , имеют двухчасовое максимальное время выполнения. Это ограничение является наиболее распространенным случаем, используемым, если наборы навыков не требуют общих закрытых ссылок. Индексаторы, настроенные для использования общих приватных ссылок, выполняются в приватной среде с максимальной продолжительностью 24 часа. Сведения о полной таблице см. в разделе "Ограничения индексатора". Если обработка набора навыков на уровне отдельных документов не позволяет индексатору завершить работу до истечения ограничения по времени, он останавливается, оставляя оставшиеся документы необработанными. Полная обработка не гарантируется, если объем документа, размер файла, сложность набора навыков или среда выполнения не позволяют индексатору завершить работу в течение максимального времени выполнения. Секционирование источника данных может снизить этот риск, но не устраняет его, особенно если в секцию добавляются большие объемы файлов. Это поведение является ожидаемым. Сведения о стратегиях управления большими наборами данных и поддержки инкрементного восстановления см. в разделах Индексирование больших наборов данных и Планирование индексаторов. Если для решения требуется строгий контроль над процессом индексатора документов, используйте альтернативу API push-отправки в этой статье.
- Если для решения требуется строгий контроль над временными шкалами индексирования, используйте API push-уведомлений вместо этого, например REST API индекса документов или метод IndexDocuments (Azure SDK для .NET). Эти параметры обеспечивают полный контроль над конвейером индексирования.
- Индексаторы иногда могут выпадать из расписания. Хотя это условие является редким и существуют механизмы автоматического восстановления, восстановление может занять некоторое время. Это поведение является ожидаемым.
Устранение проблем с подключением к ограниченным ресурсам
Для источников данных в рамках сетевой безопасности Azure индексаторы ограничены в способах подключения. В настоящее время индексаторы могут получить доступ к ограниченным источникам данных за брандмауэром IP-адресов или виртуальной сетью через частную конечную точку с помощью общей приватной связи.
Ошибка при подключении к ресурсу Microsoft Foundry в частном подключении
Если вы получаете код ошибки 403 со следующим сообщением, может возникнуть проблема с тем, как конечная точка ресурса указана в наборе навыков:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
Эта ошибка возникает, если вы настроили общую приватную ссылку для подключений к ресурсу Azure Foundry, а конечная точка отсутствует настраиваемый поддомен. Настраиваемый поддомен является первой частью конечной точки (например, http://my-custom-subdomain.services.ai.azure.com). Если вы создали ресурс на портале Foundry, а не на портале Azure, может быть отсутствует личный домен.
Если ресурс Foundry не находится в том же регионе, что и поиск ИИ Azure, используйте бессерверное подключение для подключения ресурса.
Ошибка при использовании общей приватной ссылки
Если вы получаете код ошибки 403 со следующим сообщением, индексатор может подключаться через общедоступную конечную точку вместо утвержденной общей приватной ссылки:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
Эта ошибка может возникать, если индексатор не настроен для использования частной среды выполнения. Убедитесь, что общая приватная ссылка одобрена, установите для индексатора executionEnvironment значение private и убедитесь, что подключение использует правильную конечную точку ресурса и идентификатор группы.
Правила брандмауэра
Служба хранилища Azure, Azure Cosmos DB и SQL Azure предоставляют настраиваемый брандмауэр. Если брандмауэр блокирует запрос, нет определенного сообщения об ошибке. Как правило, ошибки брандмауэра являются универсальными. Ниже перечислены некоторые распространенные ошибки.
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
Чтобы разрешить индексаторам доступ к этим ресурсам, используйте один из следующих вариантов:
Настройте входящее правило для IP-адреса службы поиска и диапазона IP-адресов тега
AzureCognitiveSearchслужбы. Дополнительные сведения о настройке ограничений диапазона IP-адресов для каждого типа источника данных см. в следующих ссылках:В качестве последней меры или в качестве временной меры отключите брандмауэр, разрешая доступ из всех сетей.
Ограничение. Ограничения диапазона IP-адресов работают только в том случае, если служба поиска и учетная запись хранения находятся в разных регионах.
Помимо получения данных индексаторы также отправляют исходящие запросы с использованием наборов навыков и пользовательских навыков. Для пользовательских навыков на основе функции Azure следует учитывать, что функции Azure также имеют ограничения IP-адресов. Список IP-адресов, которые доступны для выполнения пользовательских навыков, включает IP-адрес вашей службы поиска и диапазон IP-адресов сервисного тега AzureCognitiveSearch.
Правила группы безопасности сети (NSG)
Когда индексатор обращается к данным управляемого экземпляра SQL или когда виртуальная машина Azure используется в качестве URI веб-службы для пользовательского навыка, группа безопасности сети определяет, разрешены ли запросы.
Для внешних ресурсов, размещённых в виртуальной сети, настройте входящие правила NSG для тега AzureCognitiveSearch службы.
Дополнительные сведения о подключении к виртуальной машине см. в статье "Настройка подключения к SQL Server" на виртуальной машине Azure.
Ошибки сети.
Как правило, сетевые ошибки являются универсальными. Ниже перечислены некоторые распространенные ошибки.
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
При получении любой из этих ошибок:
- Убедитесь, что вы можете получить доступ к источнику, пытаясь подключиться к нему напрямую, а не через службу поиска.
- Проверьте ресурс на портале Azure для любых текущих ошибок или сбоев.
- Проверьте наличие сбоев сети в состоянии Azure.
- Убедитесь, что вы используете общедоступный DNS для разрешения имен, а не Azure Частная зона DNS.
Бессерверное индексирование в базе данных Azure SQL (код ошибки 40613)
Если база данных SQL находится на бессерверном уровне вычислений, убедитесь, что база данных запущена (и не приостановлена), когда индексатор подключается к нему.
Если база данных приостановлена, первый вход из службы поиска автоматически возобновляет базу данных, но вместо этого возвращает ошибку, указывающую, что база данных недоступна, давая код ошибки 40613. После запуска базы данных повторите вход, чтобы установить подключение.
Политики условного доступа Microsoft Entra
При создании индексатора SharePoint необходимо войти в приложение Microsoft Entra после предоставления кода устройства. Если вы получаете сообщение, которое говорится"Your sign-in was successful but your admin requires the device requesting access to be managed", политика условного доступа, вероятно, блокирует индексатор из библиотеки документов SharePoint.
Чтобы обновить политику и разрешить индексатору доступ к библиотеке документов:
Откройте портал Azure и найдите Условный доступ Microsoft Entra.
В меню слева выберите Политики. Если у вас нет доступа к просмотру этой страницы, необходимо либо найти кого-то, кто имеет доступ, либо получить доступ.
Определите, какая политика блокирует индексатор SharePoint для доступа к библиотеке документов. Политика, которая может блокировать индексатор, включает учетную запись пользователя, используемую для проверки подлинности во время этапа создания индексатора в разделе "Пользователи и группы ". Политика также может иметь Условия, которые:
- Ограничить платформы Windows
- Ограничьте мобильные приложения и настольные клиенты.
- Установите состояние устройства на Да.
После подтверждения того, какая политика блокирует индексатор, сделайте исключение для индексатора. Начните с получения IP-адреса службы поиска.
Сначала получите полностью квалифицированное доменное имя службы поиска. Полное доменное имя выглядит следующим образом
<your-search-service-name>.search.windows.net. Полное доменное имя (FQDN) можно найти в портале Azure.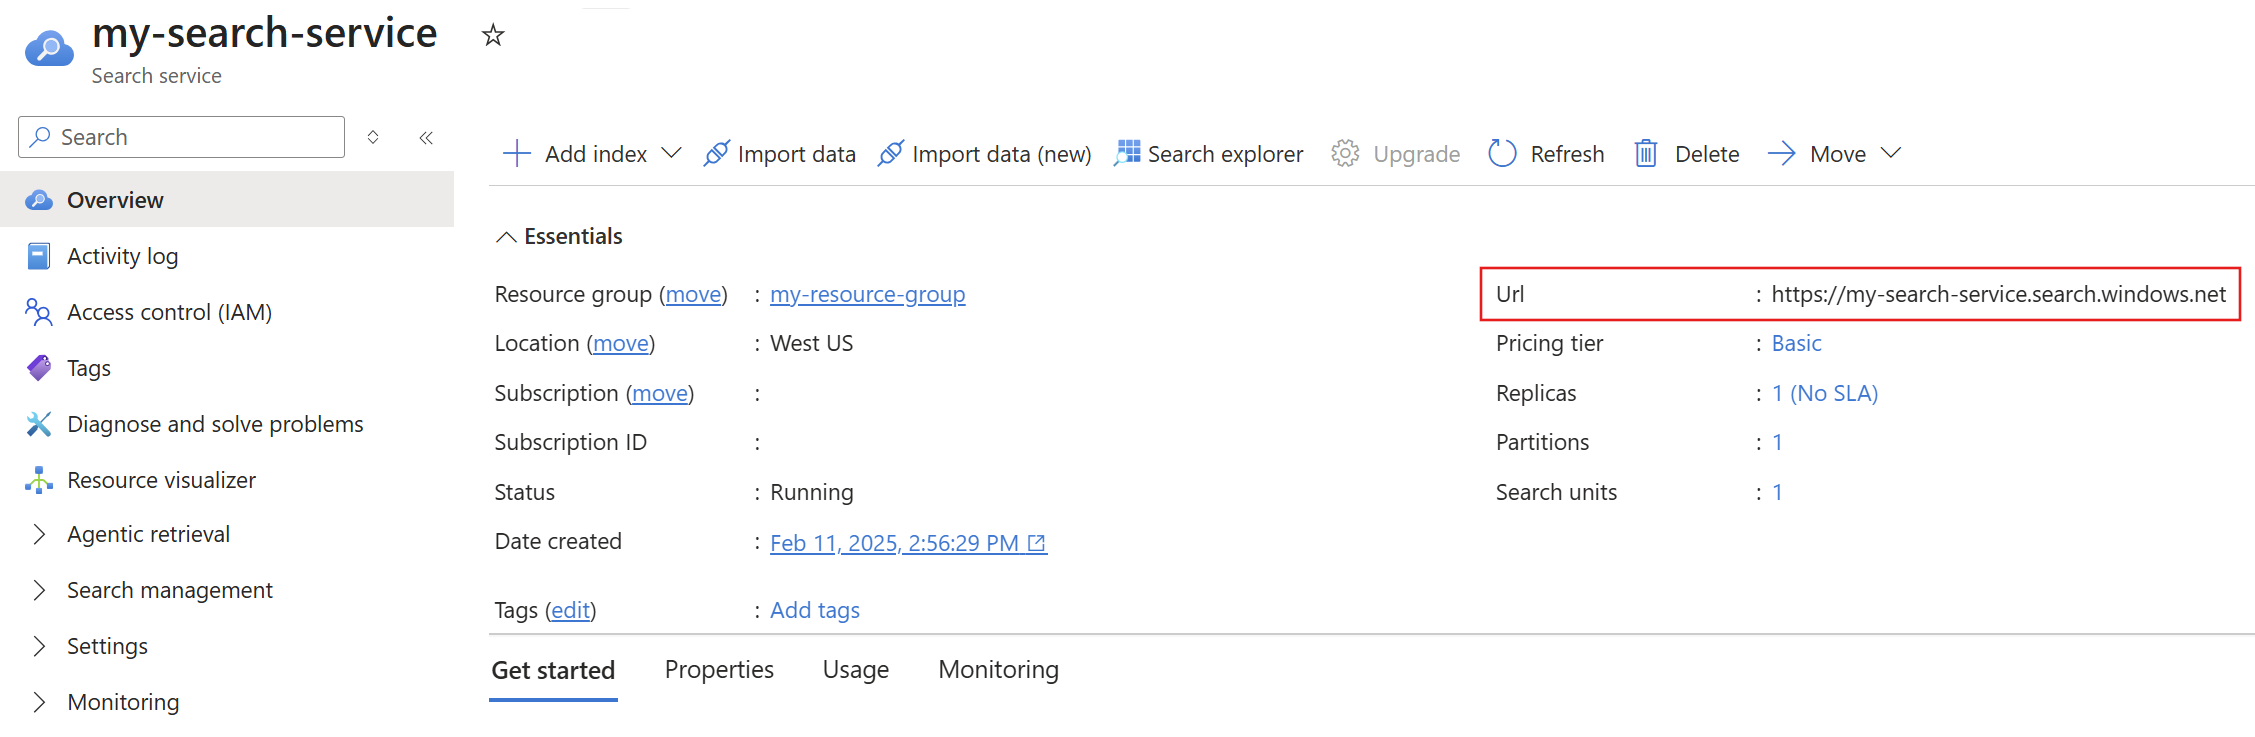
Теперь, когда у вас есть полное доменное имя (FQDN), получите IP-адрес службы поиска, выполнив
nslookup(илиping) с использованием этого полного доменного имени. В следующем примере вы добавляете150.0.0.1в правило входящего трафика в брандмауэре служба хранилища Azure. После обновления параметров брандмауэра может пройти до 15 минут, прежде чем индексатор службы поиска сможет получить доступ к учетной записи служба хранилища Azure.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netПолучите диапазоны IP-адресов для среды выполнения индексатора в вашем регионе.
Дополнительные IP-адреса используются для запросов, поступающих из мультитенантной среды выполнения индексатора. Этот диапазон IP-адресов можно получить из тега службы.
Диапазоны IP-адресов для тега
AzureCognitiveSearchслужбы можно получить с помощью API обнаружения или скачиваемого JSON-файла.В этом упражнении, если служба поиска использует общедоступное облако Azure, скачайте JSON-файл Azure Public.
Из JSON-файла, если предположить, что служба поиска находится в регионе West Central US, приведён список IP-адресов для среды выполнения мультитенантного индексатора.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
Вернитесь на страницу условного доступа на портале Azure, выберите Именованные расположения в меню слева, затем нажмите + расположение диапазона IP-адресов. Присвойте новому именованному расположению имя и добавьте диапазоны IP-адресов для сред выполнения индексатора и службы поиска, собранные в последних двух шагах. 1
- Для IP-адреса службы поиска может потребоваться добавить "/32" в конец IP-адреса, так как он принимает только допустимые диапазоны IP-адресов.
- Помните, что для диапазонов IP-адресов среды выполнения индексатора нужно добавить только диапазоны IP-адресов для региона, в котором находится служба поиска.
Исключите новое именованное местоположение из политики:
- В меню слева выберите Политики.
- Выберите политику, блокирующую индексатор.
- Выберите Условия.
- Выберите Расположения.
- Выберите Исключить, затем добавьте новое именованное расположение.
- Выберите Сохранить для сохранения изменений.
Подождите несколько минут, чтобы политика обновилась и применила новые правила политики.
Повторите попытку создать индексатор:
- Отправьте запрос изменения для созданного объекта источника данных.
- Повторно отправьте запрос на создание индексатора. Используйте новый код для входа, а затем отправьте другой запрос на создание индексатора.
Индексирование неподдерживаемых типов документов
Если вы индексируете содержимое из хранилища Хранилище BLOB-объектов Azure и контейнер содержит BLOB-объекты неподдерживаемого типа содержимого, индексатор пропускает этот документ. В других случаях могут возникнуть проблемы с отдельными документами.
В этой ситуации можно задать параметры конфигурации, чтобы разрешить обработку индексатора продолжаться, если возникают проблемы с отдельными документами.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Отсутствие документов
Индексаторы извлекают документы или строки из внешнего источника данных и создают документы поиска, индексы которых индексирует служба поиска. Иногда документ, который существует в источнике данных, не отображается в индексе поиска. Этот неожиданный результат может произойти по указанным ниже причинам.
- Вы обновили документ после запуска индексатора. Если ваш индексатор работает по настройке, он в конечном итоге повторно запускается и подымает документ.
- Время ожидания индексатора истекло до того, как документ был обработан. Существует максимальное время обработки, после которого документы не обрабатываются. Вы можете проверить состояние индексатора на портале Azure или вызвать Получить состояние индексатора (REST API).
- Сопоставления полей или обогащение с помощью ИИ изменили документ, и его представление в поисковом индексе отличается от ожидаемого.
- Значения отслеживания изменений являются ошибочными или отсутствуют необходимые условия. Если значение высокого водяного знака — это дата, установленная на будущий момент времени, индексатор пропускает все документы с более ранней датой. Вы можете определить состояние отслеживания изменений индексатора с помощью
initialTrackingStatefinalTrackingStateполей в состоянии индексатора. Индексаторы для Azure SQL и MySQL должны иметь индекс в столбце высокой отметки исходной таблицы, или запросы, используемые индексатором, могут истечь.
Совет
Если документы отсутствуют, проверьте запрос , который вы используете, чтобы убедиться, что документ не исключается. Чтобы запросить конкретный документ, используйте REST API поиска по документу.
Отсутствует содержимое хранилища блоб-объектов
Индексатор больших двоичных объектов находит и извлекает текст из больших двоичных объектов в контейнере. При извлечении текста могут встречаться следующие проблемы.
Документ содержит только отсканированные изображения. Двоичные объекты PDF, которые содержат нетекстовое содержимое, например, отсканированные изображения (JPG), не дают результатов в стандартном конвейере индексирования двоичных объектов. Если у вас есть содержимое изображения с текстовыми элементами, вы можете использовать анализ изображений или OCR для поиска и извлечения текста.
Индексатор объектов настроен для индексирования только метаданных. Чтобы извлечь содержимое, необходимо настроить индексатор BLOB-объектов для извлечения содержимого и метаданных:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Отсутствует содержимое из Azure Cosmos DB
Поиск ИИ Azure имеет неявную зависимость от индексирования Azure Cosmos DB. Если вы отключите автоматическое индексирование в Azure Cosmos DB, поиск ИИ Azure возвращает успешное состояние, но не сможет индексировать содержимое контейнера. Процессы проверки параметров и включения индексирования описаны в статье Управление индексированием в Azure Cosmos DB.
Несоответствие количества документов между источником данных и индексом
Индексатор может отображать другое число документов, отличное от источника данных, самого индекса или подсчета в коде. Ниже приведены некоторые возможные причины, по которым это поведение может произойти:
- Индекс может отставать от фактического количества документов, особенно в портале Azure.
- Индексатор имеет политику для удаленных документов. Удаленные документы учитываются индексатором, если документы индексируются до их удаления.
- Если столбец идентификатора в источнике данных не является уникальным. Это условие относится к источникам данных, имеющим концепцию столбцов, таких как Azure Cosmos DB.
- Если определение источника данных имеет другой запрос, отличный от используемого для оценки количества записей. Например, в базе данных вы запрашиваете количество записей базы данных, а в запросе определения источника данных вы можете выбрать только подмножество записей для индексирования.
- Счетчики проверяются по разным интервалам для каждого компонента конвейера: источник данных, индексатор и индекс.
- Источник данных содержит файл, связанный со многими документами. Это условие может возникать при индексировании больших двоичных объектов, когда параметр "parsingMode" установлен на
jsonArrayиjsonLines.
Документы обрабатываются несколько раз
Индексаторы используют консервативную стратегию буферизации, чтобы обеспечить получение каждого нового и измененного документа в источнике данных во время индексирования. В некоторых ситуациях эти буферы могут перекрываться, из-за чего индексатор может индексировать документ два или более раз. В результате количество обработанных документов превышает фактическое количество документов в источнике данных. Это поведение не влияет на данные, хранящиеся в индексе, например не приводит к дублированию документов; просто для достижения согласованности в конечном итоге может потребоваться больше времени. Это условие особенно распространено, если какой-либо из следующих критериев является истиной:
- Запросы к индексатору по требованию отправляются один за другим с небольшим интервалом.
- Топология источника данных включает несколько реплик и секций, таких как топология, описанная на уровнях согласованности в Azure Cosmos DB.
- Источник данных — база данных Azure SQL, а столбец, выбранный в качестве "верхней границы", имеет тип
datetime2.
Индексаторы не предназначены для многократного вызова в короткий период времени. Если вам нужны обновления быстро, поддерживаемый подход заключается в том, чтобы отправлять обновления в индекс, одновременно обновляя источник данных. При обработке по запросу отправляйте запросы с интервалом не менее пяти минут и настройте запуск индексатора по расписанию.
Пример повторяющейся обработки документов с 30-секундным буфером
Следующая временная шкала объясняет условия, при которых документ обрабатывается дважды. Он отмечает каждое действие и ответное действие. На следующей временной шкале показана проблема:
| Временная шкала (чч:мм:сс) | Мероприятие | Индексатор максимальной отметки | Комментарий |
|---|---|---|---|
| 00:01:00 | Запишите doc1 в источник данных с конечной согласованностью |
null |
Метка времени документа — 00:01:00. |
| 00:01:05 | Запишите doc2 в источник данных с конечной согласованностью |
null |
Метка времени документа — 00:01:05. |
| 00:01:10 | Запуск индексатора | null |
|
| 00:01:11 | Индексатор запрашивает все изменения до 00:01:10; реплика, которую индексатор запрашивает, в курсе только doc2; извлекается только doc2. |
null |
Индексатор запрашивает все изменения перед запуском метки времени, но фактически получает подмножество. Это поведение требует периода ретроспективного анализа. |
| 00:01:12 | Индексатор обрабатывает doc2 впервые. |
null |
|
| 00:01:13 | Индексатор завершается | 00:01:10 | Высокий водяной уровень обновляется до метки времени начала выполнения текущего индексатора. |
| 00:01:20 | Запуск индексатора | 00:01:10 | |
| 00:01:21 | Индексатор запрашивает все изменения в диапазоне от 00:00:40 до 00:01:20; реплика, к которой обращается индексатор, знает как о doc1, так и о doc2; извлекает doc1 и doc2. |
00:01:10 | Индексатор запрашивает все изменения между текущей контрольной отметкой, уменьшенной на 30-секундный буфер, и начальной меткой времени текущего выполнения индексатора. |
| 00:01:22 | Индексатор обрабатывает doc1 впервые. |
00:01:10 | |
| 00:01:23 | Индексатор обрабатывает doc2 во второй раз |
00:01:10 | |
| 00:01:24 | Индексатор завершается | 00:01:20 | Высокий водяной уровень обновляется до метки времени начала выполнения текущего индексатора. |
| 00:01:32 | Запуск индексатора | 00:01:20 | |
| 00:01:33 | Индексатор запрашивает все изменения в диапазоне от 00:00:50 до 00:01:32; извлекает doc1 и doc2 |
00:01:20 | Индексатор запрашивает все изменения между текущей контрольной отметкой, уменьшенной на 30-секундный буфер, и начальной меткой времени текущего выполнения индексатора. |
| 00:01:34 | Индексатор обрабатывает doc1 во второй раз |
00:01:20 | |
| 00:01:35 | Индексатор обрабатывает doc2 в третий раз |
00:01:20 | |
| 00:01:36 | Индексатор завершается | 00:01:32 | Высокий водяной уровень обновляется до метки времени начала выполнения текущего индексатора. |
| 00:01:40 | Запуск индексатора | 00:01:32 | |
| 00:01:41 | Индексатор запрашивает все изменения в диапазоне от 00:01:02 до 00:01:40; Извлекает doc2 |
00:01:32 | Индексатор запрашивает все изменения между текущей контрольной отметкой, уменьшенной на 30-секундный буфер, и начальной меткой времени текущего выполнения индексатора. |
| 00:01:42 | Индексатор обрабатывает doc2 в четвертый раз |
00:01:32 | |
| 00:01:43 | Индексатор завершается | 00:01:40 | Обратите внимание, что выполнение индексатора началось через более чем 30 секунд после последней записи в источник данных и также включало обработку doc2. Это ожидаемое поведение, так как если все выполнение индексатора до 00:01:35 устранено, это становится первым и единственным выполнением для обработки doc1 и doc2. |
На практике этот сценарий происходит только при ручном вызове индексаторов по запросу в течение нескольких минут друг от друга для определенных источников данных. Это может привести к несоответствию чисел (например, индексатор обработал всего 345 документов в соответствии со статистикой выполнения индексатора, но в источнике данных и индексе всего 340 документов) или потенциально увеличить затраты, если вы выполняете те же самые навыки для одного и того же документа несколько раз. Запуск индексатора с помощью расписания является предпочтительной рекомендацией.
Параллельное индексирование
Когда несколько индексаторов выполняются одновременно, некоторые из них обычно попадают в очередь и ждут доступных ресурсов, прежде чем запуститься. Несколько факторов определяют, сколько индексаторов может выполняться одновременно. Если индексаторы не ссылаются на наборы навыков, количество реплик и секций в службе поиска ИИ определяет, сколько индексаторов может выполняться параллельно.
Если связать индексатор с набором навыков, он будет выполняться во внутренних кластерах AI Search. Сложность набора навыков, а также то, выполняются ли одновременно другие наборы навыков, определяют, сколько индексаторов могут выполняться параллельно. Встроенные индексаторы надежно извлекают данные из источника, поэтому при их запуске по расписанию никакие данные не будут пропущены. Однако процессам индексирования, обеспечивающим распараллеливание и горизонтальное масштабирование, требуется некоторое время для завершения.
Индексирование документов с метками конфиденциальности
Если вы устанавливаете метки конфиденциальности в документах, возможно, их не удастся индексировать. При возникновении ошибок удалите метки перед индексированием.