Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Примечание
Поиск с использованием ИИ Azure доступна через портал Azure, REST API и Azure SDKs. Он также лежит в основе Foundry IQ — управляемого слоя знаний, который преобразует корпоративный контент в многократно используемые базы знаний с учетом разрешений доступа для агентов на портале Microsoft Foundry.
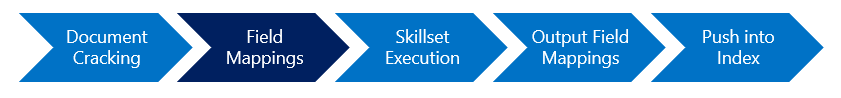
В этой статье объясняется, как задать явные сопоставления полей, которые устанавливают путь к данным между исходными полями в поддерживаемом источнике данных и целевых полях в индексе поиска.
Когда необходимо задать сопоставление полей
Если индексатор Поиск с использованием ИИ Azure загружает индекс поиска, он определяет путь к данным с помощью сопоставлений полей источника и назначения. Неявные сопоставления полей являются внутренними и происходят, когда имена полей и типы данных совместимы между источником и назначением. Если входные и выходные данные не совпадают, можно определить явные сопоставления полей для настройки пути к данным, как описано в этой статье.
Сопоставления полей также можно использовать для простых преобразований данных, например, кодирования или декодирования, через функции сопоставления. Если требуется дополнительная обработка, рассмотрите возможность Фабрика данных Azure для преодоления разрыва.
Сопоставления полей применяются к:
Физические структуры данных на обеих сторонах пути к данным. Логические структуры данных, созданные навыками, находятся только в памяти. Используйте outputFieldMappings для сопоставления узлов в памяти с полями вывода в индексе поиска.
Основной ИИ индексирует только поисковые данные. Для вторичных индексов с дочерними документами или блоками используйте сценарии расширенного сопоставления полей.
Только поля поиска верхнего уровня, где
targetFieldNameэто простое поле или коллекция. Целевое поле не может быть сложным типом.
Поддерживаемые сценарии
Убедитесь, что вы используете поддерживаемый источник данных для индексирования с использованием индексатора.
| Вариант использования | Описание |
|---|---|
| Несоответствие имен | Предположим, что источник данных имеет поле с именем _city. Учитывая, что Поиск с использованием ИИ Azure не разрешает имена полей, начинающиеся с подчеркивания, сопоставление полей позволяет эффективно сопоставлять "_city" с "city". Если требования к индексированию включают получение содержимого из нескольких источников данных, где имена полей зависят от источников, можно использовать сопоставление полей для уточнения пути. |
| Несоответствие типов | Предположим, что нужно, чтобы исходное целочисленное поле было типом Edm.String , чтобы он был доступен для поиска в индексе поиска. Поскольку типы различаются, вам необходимо определить сопоставление полей, чтобы обеспечить успех пути данных. Обратите внимание, что Поиск с использованием ИИ Azure имеет меньший набор типов данных поддерживаемых типов данных чем многие источники данных. При импорте данных SQL сопоставление полей позволяет сопоставить нужный тип данных SQL в индексе поиска. |
| Пути данных "один ко многим" | Вы можете заполнить несколько полей в индексе содержимым из одного исходного поля. Например, может потребоваться применить различные анализаторы к каждому полю для поддержки различных вариантов использования в клиентском приложении. |
| Кодировка и декодирование | Функции сопоставления можно применить для поддержки кодировки Base64 или декодирования данных во время индексирования. |
| Разделение строк или преобразование массивов в коллекции | Можно применить функции сопоставления для разделения строки, включающей разделитель, или отправить массив JSON в поле поиска типа Collection(Edm.String). |
Примечание
Если сопоставления полей отсутствуют, индексаторы предполагают, что поля источника данных должны быть сопоставлены с полями индекса с тем же именем. Добавление сопоставления полей переопределяет сопоставления полей по умолчанию для исходного и целевого полей. Некоторые индексаторы, такие как индексатор хранилища BLOB-объектов, автоматически добавляют сопоставления полей по умолчанию для поля ключа индекса.
Сложные поля не поддерживаются в сопоставлении полей. Исходная структура (вложенные или иерархические структуры) должна точно соответствовать сложному типу в индексе, чтобы сопоставления по умолчанию работали. Дополнительные сведения см. в руководстве по индексу вложенных BLOB-объектов JSON , например. Если вы получите ошибку, аналогичную "Field mapping specifies target field 'Address/city' that doesn't exist in the index", это связано с тем, что параметры сопоставления целевых полей не могут быть сложным типом.
При необходимости может потребоваться всего несколько узлов в сложной структуре. ** Чтобы получить отдельные узлы, можно преобразовать входящие данные в коллекцию строк (см. outputFieldMappings для этого обходного пути).
Определите сопоставление полей
В этом разделе описаны действия по настройке сопоставлений полей.
Используйте Create Indexer или Create или Update Indexer или эквивалентный метод в Azure SDK. Ниже приведен пример определения индексатора.
{
   "name": "myindexer",
   "description": null,
   "dataSourceName": "mydatasource",
   "targetIndexName": "myindex",
   "schedule": { },
   "parameters": { },
   "fieldMappings": [],
   "disabled": false,
   "encryptionKey": { }
 }
Заполните массив
fieldMappings, чтобы задать сопоставления. Сопоставление полей состоит из трех частей."fieldMappings": [ { "sourceFieldName": "_city", "targetFieldName": "city", "mappingFunction": null } ]Свойство Описание sourceFieldName Обязательно. Представляет поле в источнике данных. targetFieldName Необязательно. Представляет поле в индексе поиска. Если опущено, sourceFieldNameзначение предполагается для целевого объекта. Целевые поля должны быть простыми полями верхнего уровня или коллекциями. Это не может быть сложный тип или коллекция. При обработке проблемы с типом данных в определении индекса указывается тип данных поля. Сопоставление полей должно содержать только имя поля.Функция сопоставления Необязательно. Состоит из предопределенных функций , которые преобразуют данные.
Пример: несоответствие имен или типов
Явное сопоставление полей устанавливает путь к данным для случаев, когда имя и тип не совпадают.
Поиск с использованием ИИ Azure использует сравнение без учета регистра для определения имен полей и функций в сопоставлениях полей. Это удобно (вам не нужно беспокоиться о правильности регистра), но это означает, что источник данных или индекс не может содержать поля, которые различаются только по регистру.
PUT https://[service name].search.windows.net/indexers/myindexer?api-version=[api-version]
Content-Type: application/json
api-key: [admin key]
{
    "dataSourceName" : "mydatasource",
    "targetIndexName" : "myindex",
    "fieldMappings" : [ { "sourceFieldName" : "_city", "targetFieldName" : "city" } ]
}
Пример: Дорожки данных один-ко-многим или разветвляющиеся пути данных.
В этом примере сопоставляется одно исходное поле с несколькими целевыми полями (сопоставления "один ко многим"). Поле можно "форкать", копируя одно и то же содержимое исходного поля в два разных поля индекса, которые будут анализироваться или обозначаться по-разному в индексе.
"fieldMappings" : [
    { "sourceFieldName" : "text", "targetFieldName" : "textStandardEnglishAnalyzer" },
    { "sourceFieldName" : "text", "targetFieldName" : "textSoundexAnalyzer" }
]
Вы можете использовать аналогичный подход для содержимого, созданного навыками.
Сопоставление функций и примеров
Функция сопоставления полей преобразует содержимое поля перед сохранением в индексе. В настоящее время поддерживаются следующие функции сопоставления:
- base64Encode
- base64Decode
- extractTokenAtPosition
- fixedLengthEncode
- jsonArrayToStringCollection
- Tojson
- urlEncode
- urlDecode
Обратите внимание, что эти функции поддерживаются исключительно для родительских индексов в настоящее время. Они несовместимы с сопоставлением фрагментированных индексов, поэтому эти функции нельзя использовать для проекций индексов.
Функция base64Encode
Выполняет кодирование входной строки в формате Base64, безопасном для URL. Предполагается, что входные данные закодированы в кодировке UTF-8.
Пример: базовая кодировка ключа документа
В ключе документа Поиск с использованием ИИ Azure могут отображаться только безопасные URL-адреса (чтобы можно было обратиться к документу с помощью API Lookup API). Если исходное поле для ключа содержит небезопасные символы URL-адреса, например - и \используйте base64Encode функцию для преобразования его во время индексирования.
В следующем примере указывается функция base64Encode для metadata_storage_name обработки неподдерживаемых символов.
PUT /indexers?api-version=2026-04-01
{
  "dataSourceName" : "my-blob-datasource ",
  "targetIndexName" : "my-search-index",
  "fieldMappings" : [
    {
        "sourceFieldName" : "metadata_storage_name",
        "targetFieldName" : "key",
        "mappingFunction" : {
            "name" : "base64Encode",
            "parameters" : { "useHttpServerUtilityUrlTokenEncode" : false }
        }
    }
  ]
}
Ключ документа (как до, так и после преобразования) не может превышать 1024 символов. При получении закодированного ключа во время поиска используйте base64Decode функцию, чтобы получить исходное значение ключа и использовать ее для извлечения исходного документа.
Пример: Сделать поле, закодированное с использованием base64, доступным для поиска.
Иногда требуется использовать закодированную версию поля, например metadata_storage_path ключа, но также требуется незакодированная версия для полнотекстового поиска. Для поддержки обоих сценариев можно сопоставить metadata_storage_path два поля: одно для ключа (закодированного), а второе для поля пути, которое можно предположить, является атрибутом searchable в схеме индекса.
PUT /indexers/blob-indexer?api-version=2026-04-01
{
    "dataSourceName" : " blob-datasource ",
    "targetIndexName" : "my-target-index",
    "schedule" : { "interval" : "PT2H" },
    "fieldMappings" : [
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "key", "mappingFunction" : { "name" : "base64Encode" } },
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "path" }
      ]
}
Пример. Сохранение исходных значений
Индексатор хранилища BLOB-объектов автоматически добавляет сопоставление полей из metadata_storage_pathURI блоба в поле ключа индекса, если сопоставление полей не указано. Это значение закодировано в кодировке Base64, поэтому оно безопасно использовать в качестве ключа документа Поиск с использованием ИИ Azure. В следующем примере показано, как одновременно сопоставить URL-безопасную версию, закодированную в формате Base64, с полем , и сохранить исходное значение в поле metadata_storage_path.
"fieldMappings": [
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "metadata_storage_path"
  },
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "index_key",
    "mappingFunction": {
       "name": "base64Encode"
    }
  }
]
Если вы не включаете свойство параметров для функции сопоставления, оно по умолчанию имеет значение {"useHttpServerUtilityUrlTokenEncode" : true}.
Поиск с использованием ИИ Azure поддерживает два разных кодировки Base64. При кодировании и декодировании одного поля следует использовать те же параметры. Дополнительные сведения см. в параметрах кодировки Base64 , чтобы решить, какие параметры следует использовать.
Функция base64Decode
Выполняет декодирование base64 входной строки. Предполагается, что входные данные являются URL-безопасной строкой, кодированной в Base64.
Пример. Декодирование метаданных blob-объектов или URL-адресов
Исходные данные могут содержать строки в кодировке Base64, такие как строки метаданных blob или веб-адреса URL, чтобы их можно было сделать доступными для поиска в виде обычного текста. Вы можете использовать функцию base64Decode для возврата закодированных данных в обычные строки при заполнении индекса поиска.
"fieldMappings" : [
  {
    "sourceFieldName" : "Base64EncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "base64Decode",
      "parameters" : { "useHttpServerUtilityUrlTokenDecode" : false }
    }
  }
]
Если вы не включаете свойство параметров, по умолчанию используется значение {"useHttpServerUtilityUrlTokenEncode" : true}.
Поиск с использованием ИИ Azure поддерживает два разных кодировки Base64. При кодировании и декодировании одного поля следует использовать те же параметры. Дополнительные сведения см. в параметрах кодировки Base64 , чтобы решить, какие параметры следует использовать.
Параметры кодирования base64
Поиск с использованием ИИ Azure поддерживает URL-безопасную кодировку base64 и обычную кодировку base64. Строка, закодированная во время индексирования, должна быть декодирована позже с теми же параметрами кодирования или в противном случае результат не будет соответствовать исходному.
Если параметры useHttpServerUtilityUrlTokenEncode или useHttpServerUtilityUrlTokenDecode для кодирования и декодирования соответственно заданы в true, то base64Encode работает как HttpServerUtility.UrlTokenEncode, а base64Decode функционирует как HttpServerUtility.UrlTokenDecode.
Предупреждение
Если base64Encode используется для создания значений ключей, useHttpServerUtilityUrlTokenEncode необходимо задать значение true. Для значений ключей можно использовать только кодировку base64 с безопасным URL-адресом. См. правила именования для полного набора ограничений на символы в ключевых значениях.
Библиотеки .NET в Поиск с использованием ИИ Azure предполагают полную .NET Framework, которая обеспечивает встроенную кодировку.
useHttpServerUtilityUrlTokenEncode и useHttpServerUtilityUrlTokenDecode параметры применяют эту встроенную функциональность. Если вы используете .NET Core или другую платформу, рекомендуем задать эти параметры для false и напрямую вызывать функции кодирования и декодирования платформы.
В следующей таблице сравниваются различные кодировки base64 строки 00>00?00. Чтобы определить необходимую обработку (если есть) для функций base64, примените функцию кодирования библиотеки к строке 00>00?00 и сравните выходные данные с ожидаемыми выходными данными MDA-MDA_MDA.
| Кодирование | Результат кодировки Base64 | Дополнительная обработка после кодирования библиотеки | Дополнительная обработка перед декодированием библиотеки |
|---|---|---|---|
| Base64 с заполнением | MDA+MDA/MDA= |
Используйте символы, безопасные для URL, и удалите заполнение | Пользуйтесь стандартными символами base64 и добавляйте заполнители |
| Base64 без добавления заполнителя | MDA+MDA/MDA |
Используйте символы, безопасные для URL | Использование стандартных символов base64 |
| URL-безопасный base64 с паддингом | MDA-MDA_MDA= |
Удаление заполнений | Добавление заполнений |
| Беззаполнительный base64 для URL-безопасности | MDA-MDA_MDA |
Ни один | Ни один |
Функция extractTokenAtPosition
Разбивает строковое поле с помощью указанного разделителя и выбирает маркер в указанной позиции в результирующем разделении.
Эта функция использует следующие параметры:
-
delimiter: строка, используемая в качестве разделителя при разбинии входной строки. -
position: целочисленная отсчитываемая от нуля позиция маркера для выбора после разделения входной строки.
Например, если входные данные Jane Doe — это delimiter(пробел), а " " равно 0, то результатом будет position; если Jane равно 1, то результат равен position. Если позиция ссылается на токен, который не существует, возвращается ошибка.
Пример — извлечение имени
Источник данных содержит PersonName поле, и вы хотите индексировать его как два отдельных FirstName и LastName поля. Эту функцию можно использовать для разделения входных данных с помощью символа пробела в качестве разделителя.
"fieldMappings" : [
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "FirstName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 0 } }
  },
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "LastName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 1 } }
  }]
функция jsonArrayToStringCollection
Преобразует строку, отформатированную как массив строк JSON, в массив строк, который можно использовать для заполнения Collection(Edm.String) поля в индексе.
Например, если входная строка имеет ["red", "white", "blue"]значение, целевое поле типа Collection(Edm.String) будет заполнено тремя значениями red, whiteа также blue. Для входных значений, которые не могут быть проанализированы как массивы строк JSON, возвращается ошибка.
Пример. Заполнение коллекции из реляционных данных
База данных SQL Azure не имеет встроенный тип данных, который естественно сопоставляется с полями Collection(Edm.String) в Поиск с использованием ИИ Azure. Чтобы заполнить поля сбора строк, можно предварительно обработать исходные данные в виде массива строк JSON, а затем использовать функцию jsonArrayToStringCollection сопоставления.
"fieldMappings" : [
  {
    "sourceFieldName" : "tags",
    "mappingFunction" : { "name" : "jsonArrayToStringCollection" }
  }]
Функция urlEncode
Эту функцию можно использовать для кодирования строки, чтобы она была безопасной для URL-адреса. Когда используется со строкой, содержащей символы, которые недопустимы в URL, эта функция преобразует эти "небезопасные" символы в эквиваленты сущностей символов. Эта функция использует формат кодирования UTF-8.
Пример — поиск ключа документа
urlEncode функцию можно использовать в качестве альтернативы base64Encode функции, если преобразуются только небезопасные символы URL-адреса, сохраняя другие символы as-is.
Предположим, входная строка — <hello> целевое поле типа (Edm.String) будет заполнено значением. %3chello%3e
При получении закодированного ключа во время поиска можно использовать urlDecode функцию, чтобы получить исходное значение ключа и использовать ее для получения исходного документа.
"fieldMappings" : [
  {
    "sourceFieldName" : "SourceKey",
    "targetFieldName" : "IndexKey",
    "mappingFunction" : {
      "name" : "urlEncode"
    }
  }
]
Функция urlDecode
Эта функция преобразует строку, закодированную URL-адресом, в декодированную строку с помощью формата кодирования UTF-8.
Пример— декодирование метаданных BLOB-объектов
Некоторые клиенты хранилища Azure автоматически URL-кодируют метаданные BLOB-объектов, если они содержат не-ASCII символы. Однако если вы хотите сделать такие метаданные доступными для поиска (как обычный текст), вы можете использовать функцию urlDecode, чтобы преобразовать закодированные данные обратно в обычные строки при заполнении индекса поиска.
"fieldMappings" : [
  {
    "sourceFieldName" : "UrlEncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "urlDecode"
    }
  }
]
функция fixedLengthEncode
Эта функция преобразует строку любой длины в строку фиксированной длины.
Пример — сопоставление слишком длинных ключей документов.
При возникновении ошибок, связанных с длиной ключа документа, превышающей 1024 символов, эта функция может применяться для уменьшения длины ключа документа.
"fieldMappings" : [
 {
   "sourceFieldName" : "metadata_storage_path",
   "targetFieldName" : "your key field",
   "mappingFunction" : {
     "name" : "fixedLengthEncode"
   }
 }
]
Функция toJson
Эта функция преобразует строку в форматированный объект JSON. Это можно использовать для сценариев, когда источник данных, например Azure SQL, не поддерживает составные или иерархические типы данных, а затем сопоставляет его с сложными полями.
Пример. Сопоставление текстового содержимого со сложным полем
Предположим, что в индексе есть строка SQL со строкой JSON, которую необходимо сопоставить со сложным полем (соответствующим образом определенным) в индексе, toJson эту функцию можно использовать для этого. Например, если сложное поле в индексе должно быть заполнено следующими данными:
{
    "id": "5",
    "info": {
        "name": "Jane",
        "surname": "Smith",
        "skills": [
            "SQL",
            "C#",
            "Azure"
        ],
        "dob": "2005-11-04T12:00:00"
    }
}
Его можно достичь с помощью функции сопоставления toJson в столбце строки JSON в строке SQL, которая выглядит следующим образом: {"id": 5, "info": {"name": "Jane", "surname": "Smith", "skills": ["SQL", "C#", "Azure"]}, "dob": "2005-11-04T12:00:00"}.
Сопоставление полей должно быть задано, как показано ниже.
"fieldMappings" : [
  {
    "sourceFieldName" : "content",
    "targetFieldName" : "complexField",
    "mappingFunction" : {
      "name" : "toJson"
    }
  }
]
Сценарии расширенного сопоставления полей
В сценариях, где у вас существуют отношения "один ко многим", например, при фрагментировании или разделении данных, следуйте этим рекомендациям для сопоставления полей из родительских документов с дочерними документами (фрагментами):
1. Пропуск индексирования родительского документа
Если вы пропускаете индексацию родительских документов (установив значение projectionMode на skipIndexingParentDocuments в конфигурации набора навыков indexProjections), используйте проекции индексации для сопоставления полей из родительских документов с "дочерними" документами.
2. Индексирование родительских и дочерних документов
Если вы индексируете как родительские, так и дочерние документы:
- Используйте сопоставления полей для сопоставления полей с родительскими документами.
- Используйте проекции индекса для сопоставления полей с дочерними документами.
3. Сопоставление значений, преобразованных функцией, с родительскими и/или дочерними документами
Если поле в родительском документе требует преобразования (с помощью функций сопоставления , таких как кодировка) и должно быть сопоставлено с родительскими и/или дочерними документами:
- Примените преобразование с помощью функций сопоставления полей в индексаторе.
- Используйте проекции индексов в наборе навыков, чтобы сопоставить преобразованное поле с дочерними документами.
См. также
- Поддерживаемые типы данных в Поиск с использованием ИИ Azure
- Карта типов данных SQL