Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Nota
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
Ocasionalmente, os indexadores se deparam com problemas que não produzem erros ou que ocorrem em outros serviços do Azure, como durante a autenticação ou ao conectar. Este artigo se concentra na solução de problemas do indexador quando não há mensagens para guiá-lo. Ele também fornece solução de problemas para erros provenientes de recursos que não são de pesquisa usados durante a indexação.
Nota
Se você tiver um erro do Pesquisa de IA do Azure para investigar, consulte Solução de problemas de erros e avisos comuns do indexador.
Melhores práticas
Estas são algumas práticas recomendadas e recomendações ao trabalhar com indexadores:
Os indexadores são projetados para serem executados em um cronograma
- Para uma indexação confiável, configure seus indexadores para serem executados em uma programação regular. As execuções agendadas recolhem automaticamente todos os documentos perdidos em execuções anteriores devido a erros transitórios, interrupções de rede ou problemas de serviço temporários. Essa abordagem ajuda a manter a consistência dos dados e minimiza a necessidade de intervenção manual.
- Para fontes de dados grandes, a enumeração e indexação iniciais podem levar horas ou até dias. Executar o indexador em um cronograma permite que o progresso continue e os erros sejam repetidos automaticamente. Evite depender apenas de execuções manuais ou de indexadores a pedido, pois estas opções não oferecem a mesma fiabilidade nem recuperação de erros transitórios.
Os indexadores fornecem indexação de esforço máximo ao longo do tempo
- Os indexadores incorporados processam documentos sem erros permanentes e tentam novamente entre execuções agendadas. Oferecem uma forma prática de indexar dados para cenários comuns, com recurso a low-code ou no-code, permitindo um desenvolvimento mais rápido e uma manutenção mais simples. Quando um indexador executa um conjunto de competências, cada execução tem um limite fixo de tempo de execução. Os indexadores que correm no ambiente de execução multitenant têm um tempo máximo de execução de duas horas. Este limite é o caso mais comum, usado quando as competências não exigem ligações privadas partilhadas. Indexadores configurados para usar ligações privadas partilhadas funcionam num ambiente de execução privada com um máximo de 24 horas. Para a tabela completa, veja Limites do indexador. Se o processamento do conjunto de competências por documento impedir que o indexador termine antes de atingir o limite de tempo, este para e deixa os documentos restantes por processar. O processamento completo não é garantido quando o volume do documento, o tamanho do ficheiro, a complexidade do conjunto de competências ou o ambiente de execução impedem o indexador de terminar dentro do seu tempo máximo de execução. Particionar a sua fonte de dados pode reduzir este risco, mas não o elimina, especialmente se mais tarde adicionar grandes volumes de ficheiros a uma partição. Esse comportamento é esperado. Para estratégias para gerir grandes conjuntos de dados e apoiar a recuperação incremental, consulte Indexar grandes conjuntos de dados e Indexadores de agendamento. Se a sua solução exigir controlo rigoroso sobre quando o indexador processa documentos, use a alternativa Push API neste artigo.
- Se sua solução exigir controle estrito sobre cronogramas de indexação, use as APIs de envio, como a API REST de índice de documentos ou o método IndexDocuments (SDK do Azure para .NET). Estas opções conferem controlo total sobre o fluxo de trabalho de indexação.
- Os indexadores podem, ocasionalmente, ficar fora do cronograma. Embora esta condição seja incomum e existam mecanismos de recuperação automática, a recuperação pode demorar tempo. Esse comportamento é esperado.
Solucionar problemas de conexões com recursos restritos
Para fontes de dados sob a segurança de rede do Azure, os indexadores são limitados na forma como fazem a conexão. Atualmente, os indexadores podem acessar fontes de dados restritas por trás de um firewall IP ou em uma rede virtual por meio de um ponto de extremidade privado usando um link privado compartilhado.
Erro ao ligar-se a um recurso Microsoft Foundry numa ligação privada
Se receber o código de erro 403 com a seguinte mensagem, poderá haver um problema na forma como o endpoint do recurso está especificado num conjunto de competências:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
Este erro ocorre se configurou um link privado partilhado para ligações a um recurso do Azure Foundry e o endpoint estiver em falta de um subdomínio personalizado. Um subdomínio personalizado é a primeira parte do ponto de extremidade (por exemplo, http://my-custom-subdomain.services.ai.azure.com). Pode faltar um domínio personalizado se criaste o recurso no portal Foundry em vez do portal Azure.
Se o recurso Foundry não estiver na mesma região do Pesquisa de IA do Azure, usa uma ligação sem chave para anexar o recurso.
Erro usando uma ligação privada partilhada
Se receber o código de erro 403 com a seguinte mensagem, o indexador pode estar a ligar-se através do endpoint público em vez de um link privado partilhado aprovado:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
Este erro pode ocorrer quando o indexador não está configurado para usar o ambiente de execução privada. Confirme que a ligação privada partilhada está aprovada, defina a do indexador executionEnvironment para private, e verifique se a ligação utiliza o endpoint de recurso correto e o ID do grupo.
Regras da firewall
Armazenamento do Azure, Azure Cosmos DB e SQL do Azure fornecem um firewall configurável. Não há nenhuma mensagem de erro específica quando o firewall bloqueia a solicitação. Normalmente, os erros de firewall são genéricos. Alguns erros comuns:
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
Para permitir que os indexadores acedam a estes recursos, use uma das seguintes opções:
Configure uma regra de entrada para o endereço IP do seu serviço de pesquisa e o intervalo de endereços IP da etiqueta de serviço
AzureCognitiveSearch. Para detalhes sobre a configuração de restrições de intervalo de endereços IP para cada tipo de fonte de dados, consulte os seguintes links:Como último recurso ou como medida temporária, desative o firewall permitindo o acesso a partir de Todas as Redes.
Limitação: as restrições de intervalo de endereços IP só funcionam se o seu serviço de pesquisa e a sua conta de armazenamento estiverem em regiões diferentes.
Além da recuperação de dados, os indexadores também enviam solicitações de saída por meio de conjuntos de habilidades e habilidades personalizadas. Para habilidades personalizadas baseadas em uma função do Azure, esteja ciente de que as funções do Azure também têm restrições de endereço IP. A lista de endereços IP permitidos para executar habilidades personalizadas inclui o endereço IP do seu serviço de pesquisa e o intervalo de endereços IP da tag de serviço AzureCognitiveSearch.
Regras do grupo de segurança de rede (NSG)
Quando um indexador acessa dados em uma instância gerenciada pelo SQL ou quando uma VM do Azure é usada como o URI do serviço Web para uma habilidade personalizada, o grupo de segurança de rede determina se as solicitações são permitidas.
Para recursos externos que residem numa rede virtual, configure regras de entrada NSG para a etiqueta de serviço.
Para obter mais informações sobre como se conectar a uma máquina virtual, consulte Configurar uma conexão com o SQL Server em uma VM do Azure.
Erros de rede
Normalmente, os erros de rede são genéricos. Alguns erros comuns:
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
Quando receber algum destes erros:
- Certifica-te de que consegues aceder à tua fonte tentando ligar-te diretamente a ela e não através do serviço de pesquisa.
- Verifique o seu recurso no portal do Azure para quaisquer erros ou interrupções atuais.
- Verifique se há falhas de rede no Estado do Azure.
- Verifica se estás a usar um DNS público para resolução de nomes e não um Azure DNS Privado.
Indexação sem servidor do Banco de Dados SQL do Azure (código de erro 40613)
Se o banco de dados SQL estiver em uma camada de computação sem servidor, verifique se o banco de dados está em execução (e não pausado) quando o indexador se conectar a ele.
Se a base de dados estiver pausada, o primeiro início de sessão do seu serviço de pesquisa retoma automaticamente a base de dados, mas devolve um erro indicando que a base de dados está indisponível, dando o código de erro 40613. Depois que o banco de dados estiver em execução, tente entrar novamente para estabelecer conectividade.
Políticas de Acesso Condicional do Microsoft Entra
Quando cria um indexador SharePoint, precisa de iniciar sessão na sua aplicação Microsoft Entra depois de fornecer o código do dispositivo. Se receber uma mensagem a dizer "Your sign-in was successful but your admin requires the device requesting access to be managed", uma política de Acesso Condicional provavelmente está a bloquear o indexador da biblioteca de documentos do SharePoint.
Para atualizar a política e permitir o acesso do indexador à biblioteca de documentos:
Abra o portal do Azure e procure Microsoft Entra Acesso Condicional.
Selecione Políticas no menu à esquerda. Se você não tiver acesso para visualizar esta página, precisará encontrar alguém que tenha acesso ou obter acesso.
Determine qual política está bloqueando o acesso do indexador do SharePoint à biblioteca de documentos. A política que pode bloquear o indexador inclui a conta de utilizador que usou para autenticar durante a etapa de criação do indexador na secção Utilizadores e grupos . A política também pode ter condições que:
- Restrinja plataformas Windows.
- Restrinja aplicativos móveis e clientes de desktop.
- Definir o estado do dispositivo para Sim.
Depois de confirmar qual a política que está a bloquear o indexador, faça uma isenção para ele. Comece por recuperar o endereço IP do serviço de pesquisa.
Primeiro, obtenha o nome de domínio totalmente qualificado (FQDN) do seu serviço de pesquisa. O FQDN se parece com
<your-search-service-name>.search.windows.net. Você pode encontrar o FQDN no portal do Azure.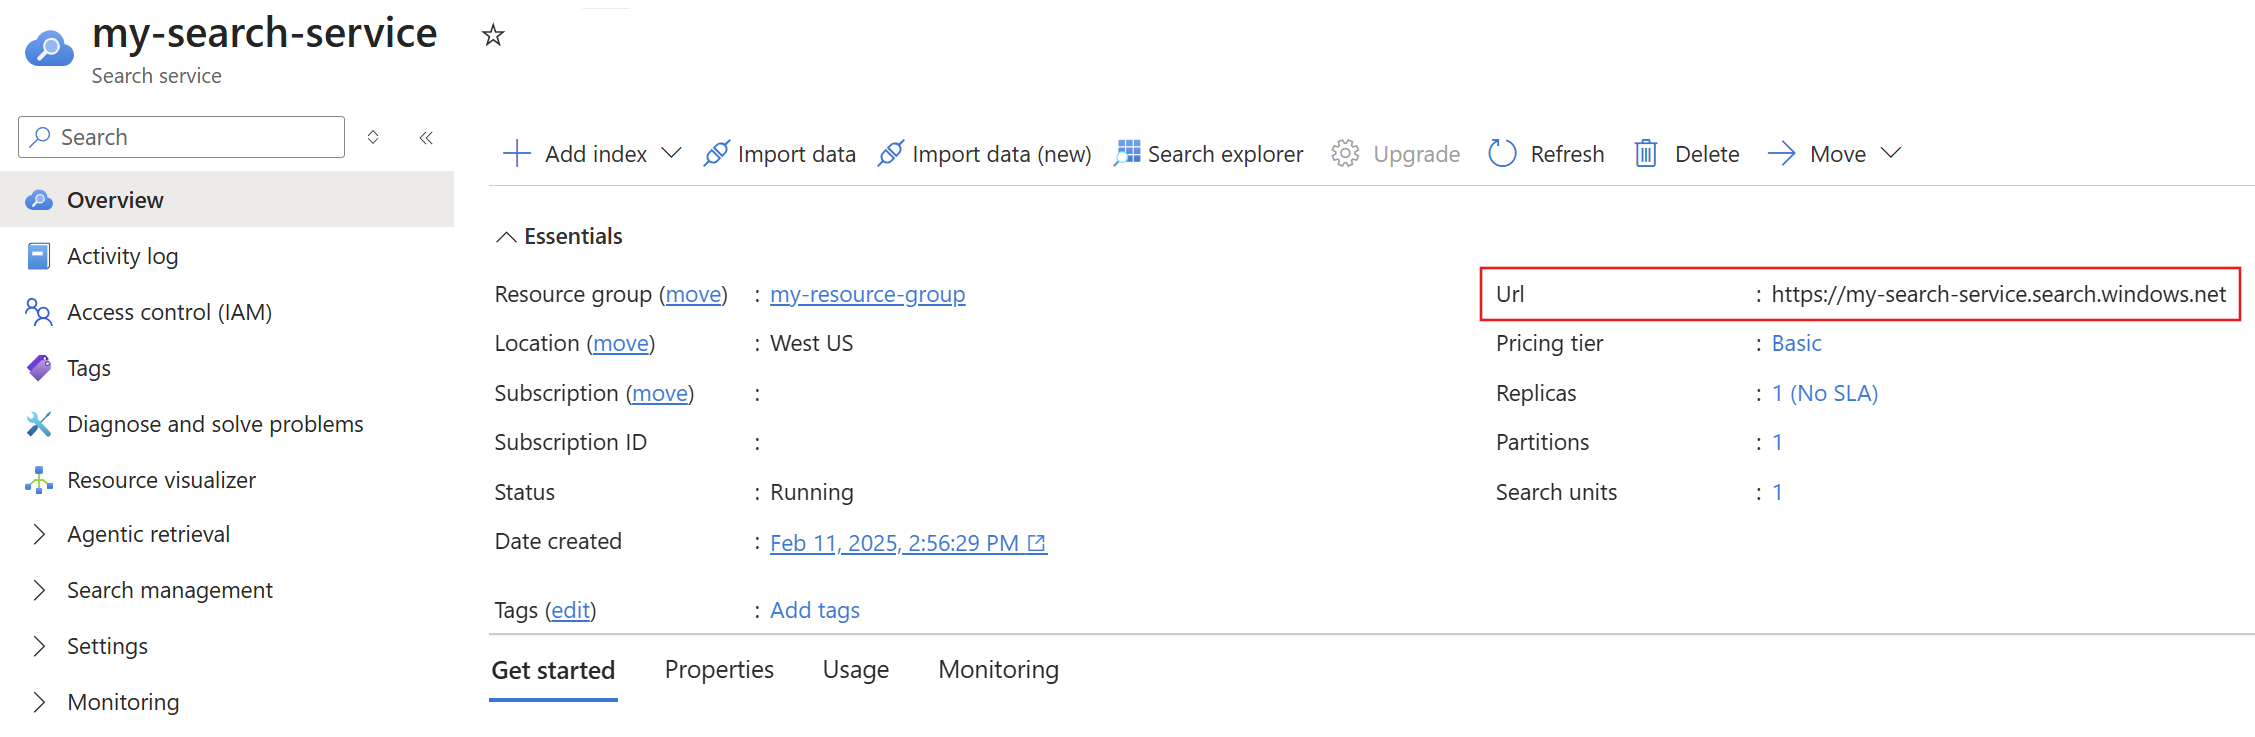
Agora que você tem o FQDN, obtenha o endereço IP do serviço de pesquisa executando um
nslookup(ou umping) do FQDN. No exemplo seguinte, adiciona150.0.0.1a uma regra de entrada no firewall do Armazenamento do Azure. Pode demorar até 15 minutos após as definições do firewall serem atualizadas para o indexador do serviço de pesquisa aceder à conta do Armazenamento do Azure.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netObtenha os intervalos de endereços IP para o ambiente de execução do indexador para sua região.
Endereços IP extras são usados para solicitações originadas do ambiente de execução multilocatário do indexador. Você pode obter esse intervalo de endereços IP a partir da etiqueta de serviço.
Pode obter os intervalos de endereços IP da
AzureCognitiveSearchtag de serviço através da API de descoberta ou do ficheiro JSON descarregável.Para este exercício, assumindo que o serviço de pesquisa é a cloud pública do Azure, descarregue o ficheiro JSON Público do Azure.

A partir do ficheiro JSON, assumindo que o serviço de pesquisa está no Centro Oeste dos EUA, está listada a lista de endereços IP para o ambiente de execução do indexador multiinquilino.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
De volta à página Acesso Condicional no portal do Azure, selecione Locais nomeados no menu à esquerda e, em seguida, selecione + Localização de intervalos IP. Dê um nome ao seu novo local nomeado e adicione os intervalos de IP para o serviço de pesquisa e os ambientes de execução do indexador que você coletou nas duas últimas etapas. 1
- Para o endereço IP do seu serviço de pesquisa, talvez seja necessário adicionar "/32" ao final do endereço IP, uma vez que ele só aceita intervalos de IP válidos.
- Lembre-se de que, para os intervalos IP do ambiente de execução do indexador, você só precisa adicionar os intervalos de IP para a região em que o serviço de pesquisa está.
Exclua o novo local nomeado da política:
- Selecione Políticas no menu à esquerda.
- Selecione a política que está bloqueando o indexador.
- Selecione Condições.
- Selecione Locais.
- Selecione Excluir e adicione o novo local nomeado.
- Salve as alterações.
Aguarde alguns minutos até que a política atualize e aplique as novas regras de política.
Tente criar o indexador novamente:
- Envie uma solicitação de atualização para o objeto de fonte de dados que você criou.
- Reenvie a solicitação de criação do indexador. Use o novo código para entrar e enviar outra solicitação de criação de indexador.
Indexação de tipos de documentos não suportados
Se estiver a indexar conteúdo do Armazenamento de Blobs do Azure e o contentor incluir blobs de um tipo de conteúdo não suportado, o indexador ignora esse documento. Noutros casos, poderá haver problemas com documentos individuais.
Nessa situação, você pode definir opções de configuração para permitir que o processamento do indexador continue se houver problemas com documentos individuais.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Documentos em falta
Os indexadores extraem documentos ou linhas de uma fonte de dados externa e criam documentos de pesquisa, que o serviço de pesquisa indexa. Por vezes, um documento que existe na fonte de dados não aparece num índice de pesquisa. Este resultado inesperado pode ocorrer devido às seguintes razões:
- Atualizaste o documento depois de o indexador ser executado. Se o indexador estiver em um cronograma, ele eventualmente será executado novamente e pegará o documento.
- O indexador atingiu o tempo limite antes que o documento pudesse ser ingerido. Existem prazos máximos de processamento após os quais nenhum documento é processado. Você pode verificar o status do indexador no portal do Azure ou chamando Get Indexer Status (REST API).
- Mapeamentos de campos ou enriquecimento por IA alteraram o documento e a sua articulação no índice de pesquisa é diferente do que espera.
- Os valores de controle de alterações estão errados ou os pré-requisitos estão faltando. Se o seu valor máximo for uma data definida para uma data futura, o indexador ignora todos os documentos com uma data anterior. Pode determinar o estado do controlo de alterações do seu indexador utilizando os campos
initialTrackingStateefinalTrackingStateem estado do indexador. Os indexadores para SQL do Azure e MySQL devem ter um índice na coluna de nível alto da tabela de origem, caso contrário, as consultas usadas pelo indexador podem atingir o tempo limite.
Gorjeta
Se faltarem documentos, verifique a consulta que está a utilizar para se certificar de que não está a excluir o documento em questão. Para consultar um documento específico, use a API REST de pesquisa de documento.
Conteúdo ausente do armazenamento de Blob
O indexador de blob localiza e extrai texto de blobs em um contêiner. Alguns problemas com a extração de texto incluem:
O documento contém apenas imagens digitalizadas. Blobs de PDF com conteúdo não textual, como imagens digitalizadas (JPGs), não produzem resultados em um pipeline de indexação de blob padrão. Se você tiver conteúdo de imagem com elementos de texto, poderá usar OCR ou análise de imagem para localizar e extrair o texto.
O indexador de blob é configurado apenas para indexar metadados. Para extrair conteúdo, deve configurar o blob indexer para extrair tanto conteúdo como metadados:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Conteúdo ausente do Azure Cosmos DB
O Pesquisa de IA do Azure tem uma dependência implícita na indexação do Azure Cosmos DB. Se você desativar a indexação automática no Azure Cosmos DB, o Pesquisa de IA do Azure retornará um estado bem-sucedido, mas não conseguirá indexar o conteúdo do contêiner. Para obter instruções sobre como verificar as configurações e ativar a indexação, consulte Gerenciar indexação no Azure Cosmos DB.
Discrepância na contagem de documentos entre a fonte de dados e o índice
Um indexador pode mostrar uma contagem de documentos diferente da fonte de dados, do próprio índice ou da contagem em seu código. Aqui estão algumas razões possíveis pelas quais esse comportamento pode ocorrer:
- O índice pode demorar a mostrar a contagem real de documentos, especialmente no portal do Azure.
- O indexador tem uma Política de Documentos Excluídos. Os documentos excluídos são contados pelo indexador se os documentos forem indexados antes de serem excluídos.
- Se a coluna ID da fonte de dados não for exclusiva. Esta condição aplica-se a fontes de dados que têm o conceito de colunas, como o Azure Cosmos DB.
- Se a definição da fonte de dados tiver uma consulta diferente daquela que você está usando para estimar o número de registros. Por exemplo, na sua base de dados, está a consultar a contagem de registos da base de dados, enquanto na consulta de definição da fonte de dados pode estar a selecionar apenas um subconjunto de registos para indexar.
- As contagens são verificadas em intervalos diferentes para cada componente do pipeline: fonte de dados, indexador e índice.
- A fonte de dados tem um ficheiro mapeado a muitos documentos. Essa condição pode ocorrer durante a indexação de blobs, quando "parsingMode" é definido como e
jsonArray.
Documentos processados várias vezes
Os indexadores usam uma estratégia conservadora de buffer para garantir que cada documento novo e alterado na fonte de dados seja coletado durante a indexação. Em certas situações, estes buffers podem sobrepor-se, levando um indexador a indexar um documento duas ou mais vezes. Como resultado, a contagem de documentos processados é superior ao número real de documentos na fonte de dados. Este comportamento não afeta os dados armazenados no índice, como a duplicação de documentos, apenas que pode demorar mais tempo a atingir a consistência eventual. Esta condição é especialmente prevalente se qualquer um dos seguintes critérios for verdadeiro:
- Os pedidos de indexadores sob demanda são emitidos em rápida sucessão.
- A topologia da fonte de dados inclui múltiplas réplicas e partições, como a topologia descrita em Níveis de Consistência no Azure Cosmos DB.
- A fonte de dados é uma base de dados SQL do Azure e a coluna escolhida como "marca máxima" é do tipo
datetime2.
Os indexadores não se destinam a ser invocados várias vezes em rápida sucessão. Se você precisar de atualizações rapidamente, a abordagem suportada é enviar atualizações por push para o índice e, ao mesmo tempo, atualizar a fonte de dados. Para processamento sob demanda, ajuste o ritmo dos seus pedidos em intervalos de cinco minutos ou mais e execute o indexador num calendário.
Exemplo de processamento de documentos duplicados com buffer de 30 segundos
A linha temporal seguinte explica as condições em que um documento é processado duas vezes. Regista cada ação e contra-ação. A seguinte cronologia ilustra o problema:
| Linha do tempo (hh:mm:ss) | Evento | Limite Superior do Indexador | Comentário |
|---|---|---|---|
| 00:01:00 | Gravar doc1 na fonte de dados com consistência eventual |
null |
O carimbo de data/hora do documento é 00:01:00. |
| 00:01:05 | Gravar doc2 na fonte de dados com consistência eventual |
null |
O carimbo de data/hora do documento é 00:01:05. |
| 00:01:10 | Início do indexador | null |
|
| 00:01:11 | O indexador consulta todas as alterações antes de 00:01:10; a réplica que o indexador consulta está ciente apenas de doc2; apenas doc2 é recuperado. |
null |
O indexador requisita todas as alterações que ocorreram antes do momento indicado pelo carimbo de data/hora, mas na verdade recebe apenas um subconjunto. Este comportamento requer o período de buffer de análise retrospetiva. |
| 00:01:12 | Indexador processa doc2 pela primeira vez |
null |
|
| 00:01:13 | Termina o indexador | 00:01:10 | A marca d'água alta é atualizada para o carimbo de data/hora inicial da execução atual do indexador. |
| 00:01:20 | Início do indexador | 00:01:10 | |
| 00:01:21 | O indexador consulta todas as alterações entre 00:00:40 e 00:01:20; a réplica que o indexador consulta está ciente de doc1 e doc2; em seguida, recupera doc1 e doc2. |
00:01:10 | O indexador solicita todas as alterações entre a marca d'água máxima atual menos o intervalo de 30 segundos e o timestamp inicial da execução do indexador no momento atual. |
| 00:01:22 | Indexador processa doc1 pela primeira vez |
00:01:10 | |
| 00:01:23 | O indexador processa doc2 pela segunda vez |
00:01:10 | |
| 00:01:24 | Termina o indexador | 00:01:20 | A marca d'água alta é atualizada para o carimbo de data/hora inicial da execução atual do indexador. |
| 00:01:32 | Início do indexador | 00:01:20 | |
| 00:01:33 | O indexador consulta todas as alterações entre 00:00:50 e 00:01:32; recupera doc1 e doc2 |
00:01:20 | O indexador solicita todas as alterações entre a marca d'água máxima atual menos o intervalo de 30 segundos e o timestamp inicial da execução do indexador no momento atual. |
| 00:01:34 | O indexador processa doc1 pela segunda vez |
00:01:20 | |
| 00:01:35 | O indexador processa doc2 pela terceira vez |
00:01:20 | |
| 00:01:36 | Termina o indexador | 00:01:32 | A marca d'água alta é atualizada para o carimbo de data/hora inicial da execução atual do indexador. |
| 00:01:40 | Início do indexador | 00:01:32 | |
| 00:01:41 | O indexador consulta todas as alterações entre 00:01:02 e 00:01:40; recupera doc2 |
00:01:32 | O indexador solicita todas as alterações entre a marca d'água máxima atual menos o intervalo de 30 segundos e o timestamp inicial da execução do indexador no momento atual. |
| 00:01:42 | O indexador processa doc2 pela quarta vez |
00:01:32 | |
| 00:01:43 | Termina o indexador | 00:01:40 | Observe que essa execução do indexador foi iniciada mais de 30 segundos após a última gravação na fonte de dados e também processada doc2. Este é o comportamento esperado porque se todas as execuções do indexador antes de 00:01:35 forem eliminadas, esta se tornará a primeira e única execução a processar doc1 e doc2. |
Na prática, este cenário só acontece quando se invocam manualmente indexadores on-demand com poucos minutos de diferença, para certas fontes de dados. Isso pode resultar em números não correspondentes (como o indexador processou 345 documentos no total de acordo com as estatísticas de execução do indexador, mas há 340 documentos na fonte de dados e no índice) ou potencialmente um aumento no faturamento caso esteja a executar as mesmas competências para o mesmo documento várias vezes. Executar um indexador usando uma agenda é a recomendação preferida.
Indexação paralela
Quando vários indexadores funcionam ao mesmo tempo, alguns normalmente entram numa fila e aguardam pelos recursos disponíveis antes de começarem. Vários fatores determinam quantos indexadores podem funcionar simultaneamente. Se os indexadores não estiverem ligados a conjuntos de competências, o número de réplicas e partições no serviço de AI Search determina quantos indexadores podem ser executados em paralelo.
Se associar um indexador a um conjunto de competências, ele corre dentro dos clusters internos de AI Search. A complexidade do conjunto de competências e se outros conjuntos de competências correm ao mesmo tempo determinam quantos indexadores podem correr em simultâneo. Os indexadores integrados extraem os dados da origem de forma fiável, pelo que não se perdem dados se forem executados de acordo com uma agenda. No entanto, os processos indexadores para paralelização e escalabilidade demoram algum tempo a ser concluídos.
Indexação de documentos com rótulos de sensibilidade
Se definir etiquetas de sensibilidade nos documentos, pode não conseguir indexá-las. Se aparecer erros, remova as etiquetas antes de indexar.