Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Nota
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
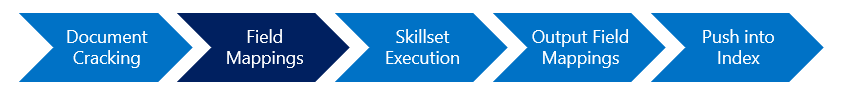
Este artigo explica como definir mapeamentos explícitos de campos que estabelecem o caminho de dados entre os campos de origem numa fonte de dados suportada e os campos-alvo num índice de pesquisa.
Quando definir um mapeamento de campo
Quando um indexador Pesquisa de IA do Azure carrega um índice de pesquisa, determina o caminho dos dados usando mapeamentos de campo de origem para destino. Os mapeamentos implícitos de campos são internos e ocorrem quando os nomes dos campos e os tipos de dados são compatíveis entre a origem e o destino. Se entradas e saídas não coincidirem, pode definir mapeamentos explícitos de campo para configurar o caminho dos dados, conforme descrito neste artigo.
Os mapeamentos de campos também podem ser usados para conversões de dados leves, como codificação ou descodificação, através de funções de mapeamento. Se for necessário mais processamento, considere Azure Data Factory para colmatar a lacuna.
Os mapeamentos de campos aplicam-se a:
Estruturas físicas de dados em ambos os lados do percurso de dados. Estruturas de dados lógicas criadas por competências residem apenas na memória. Use outputFieldMappings para mapear nós em memória para campos de saída num índice de pesquisa.
Apenas índices de pesquisa por IA dos pais. Para índices "secundários" com documentos "filhos" ou "chunks", consulte os cenários avançados de mapeamento de campos.
Apenas campos de pesquisa de topo, onde o
targetFieldNameé ou um campo simples ou uma coleção. Um campo alvo não pode ser um tipo complexo.
Cenários suportados
Certifica-te de que usas uma fonte de dados suportada para indexação orientada pelo indexador.
| Caso de uso | Descrição |
|---|---|
| Discrepância de nomes | Suponha que a sua fonte de dados tem um campo chamado _city. Dado que Pesquisa de IA do Azure não permite nomes de campos que comecem por sublinhado, um mapeamento de campos permite, na prática, mapear "_city" para "cidade". Se os seus requisitos de indexação incluem recuperar conteúdo de múltiplas fontes de dados, onde os nomes dos campos variam entre as fontes, pode usar um mapeamento de campos para clarificar o caminho. |
| Discrepância de tipos | Suponha que quer que um campo inteiro de origem seja do tipo Edm.String , de modo a ser pesquisável no índice de pesquisa. Como os tipos são diferentes, é necessário definir um mapeamento de campo para que o caminho dos dados tenha sucesso. Note que Pesquisa de IA do Azure tem um conjunto menor de tipos de dados suportados do que muitas fontes de dados. Se estiveres a importar dados SQL, um mapeamento de campos permite-te mapear o tipo de dado SQL que queres num índice de pesquisa. |
| Caminhos de dados um-para-muitos | Podes preencher vários campos no índice com conteúdo do mesmo campo de origem. Por exemplo, pode querer aplicar analisadores diferentes a cada campo para suportar diferentes casos de uso na sua aplicação cliente. |
| Codificação e decodificação | Pode aplicar funções de mapeamento para suportar a codificação ou descodificação de dados em Base64 durante a indexação. |
| Dividir strings ou converter arrays em coleções | Pode aplicar funções de mapeamento para dividir uma cadeia que inclua um delimitador, ou para enviar um array JSON para um campo de pesquisa do tipo Collection(Edm.String). |
Nota
Se não houver mapeamentos de campos, os indexadores assumem que os campos de origem de dados devem ser mapeados para campos de índice com o mesmo nome. Adicionar um mapeamento de campo sobrepõe-se aos mapeamentos de campo padrão para o campo de origem e alvo. Alguns indexadores, como o indexador de armazenamento de blobs, adicionam automaticamente mapeamentos de campos predefinidos para o campo da chave de índice.
Campos complexos não são suportados num mapeamento de campos. A sua estrutura de origem (estruturas aninhadas ou hierárquicas) deve corresponder exatamente ao tipo complexo no índice para que os mapeamentos padrão funcionem. Para mais informações, veja o Tutorial: Indexar blobs de JSON aninhados como exemplo. Se aparecer um erro semelhante a "Field mapping specifies target field 'Address/city' that doesn't exist in the index", é porque os mapeamentos de campo de destino não podem ser de um tipo complexo.
Opcionalmente, pode querer apenas alguns nós na estrutura complexa. Para obter nós individuais, pode achatar dados recebidos numa coleção de strings (veja outputFieldMappings para esta solução alternativa).
Defina um mapeamento de campo
Esta secção explica os passos para configurar mapeamentos de campos.
Use Create Indexer ou Create or Update Indexer ou um método equivalente numa SDK do Azure. Aqui está um exemplo de definição de indexador.
{
   "name": "myindexer",
   "description": null,
   "dataSourceName": "mydatasource",
   "targetIndexName": "myindex",
   "schedule": { },
   "parameters": { },
   "fieldMappings": [],
   "disabled": false,
   "encryptionKey": { }
 }
Preenche o
fieldMappingsarray para especificar os mapeamentos. Um mapeamento de campo consiste em três partes."fieldMappings": [ { "sourceFieldName": "_city", "targetFieldName": "city", "mappingFunction": null } ]Propriedade Descrição sourceFieldName Obrigatório. Representa um campo na sua fonte de dados. alvoNomeDeCampo Opcional. Representa um campo no seu índice de pesquisa. Se for omitido, assume-se o valor de sourceFieldNamepara o alvo. Os campos-alvo devem ser campos simples de topo ou coleções. Não pode ser um tipo ou coleção complexa. Se estiver a tratar de um problema de tipo de dado, o tipo de dado de um campo é especificado na definição do índice. O mapeamento do campo só precisa de ter o nome do campo.Função de mapeamento Opcional. Consiste em funções pré-definidas que transformam dados.
Exemplo: Discrepância de nome ou tipo
Um mapeamento explícito de campos estabelece um caminho de dados para casos em que nome e tipo não são idênticos.
O Pesquisa de IA do Azure utiliza comparação insensível a maiúsculas e minúsculas para resolver os nomes dos campos e funções em mapeamentos de campos. Isto é conveniente (não precisas de acertar todas as maiúsculas), mas significa que a tua fonte de dados ou índice não pode ter campos que diferem apenas por caso.
PUT https://[service name].search.windows.net/indexers/myindexer?api-version=[api-version]
Content-Type: application/json
api-key: [admin key]
{
    "dataSourceName" : "mydatasource",
    "targetIndexName" : "myindex",
    "fieldMappings" : [ { "sourceFieldName" : "_city", "targetFieldName" : "city" } ]
}
Exemplo: Caminhos de dados um-para-muitos ou bifurcados
Este exemplo mapeia um único campo de origem para múltiplos campos-alvo (mapeamentos "um-para-muitos"). Pode "bifurcar" um campo, copiando o mesmo conteúdo do campo de origem para dois campos de índice diferentes que serão analisados ou atribuídos de forma distinta no índice.
"fieldMappings" : [
    { "sourceFieldName" : "text", "targetFieldName" : "textStandardEnglishAnalyzer" },
    { "sourceFieldName" : "text", "targetFieldName" : "textSoundexAnalyzer" }
]
Pode usar uma abordagem semelhante para conteúdos gerados por competências.
Funções de mapeamento e exemplos
Uma função de mapeamento de campos transforma o conteúdo de um campo antes de este ser armazenado no índice. As seguintes funções de mapeamento são atualmente suportadas:
- base64Encode
- base64Decode
- extractTokenAtPosition
- fixedLengthEncode
- jsonArrayToStringCollection
- toJson
- urlEncode
- urlDecode
Note-se que estas funções são suportadas exclusivamente para índices principais neste momento. Não são compatíveis com mapeamento de índice em blocos, por isso, estas funções não podem ser usadas para projeções de índices.
Função base64Encode
Executa a codificação Base64 da cadeia de entrada de forma segura para URL. Assume que a entrada está codificada em UTF-8.
Exemplo: Codificação base de uma chave de documento
Apenas caracteres seguros para URL podem aparecer numa chave de documento do Pesquisa de IA do Azure (para que possa endereçar o documento usando a Lookup API). Se o campo fonte da sua chave contiver caracteres URL-inseguros, como - e \, use a base64Encode função para convertê-la em tempo de indexação.
O exemplo seguinte especifica a função base64Encode em metadata_storage_name para o tratamento de caracteres não suportados.
PUT /indexers?api-version=2026-04-01
{
  "dataSourceName" : "my-blob-datasource ",
  "targetIndexName" : "my-search-index",
  "fieldMappings" : [
    {
        "sourceFieldName" : "metadata_storage_name",
        "targetFieldName" : "key",
        "mappingFunction" : {
            "name" : "base64Encode",
            "parameters" : { "useHttpServerUtilityUrlTokenEncode" : false }
        }
    }
  ]
}
Uma chave de documento (tanto antes como depois da conversão) não pode ter mais de 1.024 caracteres. Quando recuperares a chave codificada na hora da pesquisa, usa a base64Decode função para obter o valor original da chave e usa-a para recuperar o documento de origem.
Exemplo: Tornar um campo codificado na base "pesquisável"
Há momentos em que precisas de usar uma versão codificada de um campo como metadata_storage_path a chave, mas também precisas de uma versão não codificada para pesquisa de texto completo. Para suportar ambos os cenários, você pode mapear metadata_storage_path para dois campos: um para a chave (codificada) e um segundo para um campo de caminho que podemos considerar como searchable no esquema de índice.
PUT /indexers/blob-indexer?api-version=2026-04-01
{
    "dataSourceName" : " blob-datasource ",
    "targetIndexName" : "my-target-index",
    "schedule" : { "interval" : "PT2H" },
    "fieldMappings" : [
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "key", "mappingFunction" : { "name" : "base64Encode" } },
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "path" }
      ]
}
Exemplo - preservar os valores originais
O indexador de armazenamento de blobs adiciona automaticamente um mapeamento de campo do URI do blob metadata_storage_path para o campo de chave de índice, caso o mapeamento de campos não seja especificado. Este valor está codificado em Base64, por isso é seguro usá-lo como chave de documento do Pesquisa de IA do Azure. O exemplo seguinte mostra como mapear simultaneamente uma versão codificada em Base64, segura para URL, para um campo e preservar o valor original num campo metadata_storage_path:
"fieldMappings": [
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "metadata_storage_path"
  },
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "index_key",
    "mappingFunction": {
       "name": "base64Encode"
    }
  }
]
Se não incluires uma propriedade de parâmetros para a tua função de mapeamento, ela passa por defeito ao valor {"useHttpServerUtilityUrlTokenEncode" : true}.
O Pesquisa de IA do Azure suporta duas codificações Base64 diferentes. Deves usar os mesmos parâmetros ao codificar e decodificar o mesmo campo. Para mais informações, consulte as opções de codificação base64 para decidir quais os parâmetros a utilizar.
Função base64Decode
Realiza a decodificação Base64 da cadeia de entrada. Assume-se que a entrada é uma cadeia Base64 codificada de maneira segura para URL.
Exemplo - decodificar metadados ou URLs de blobs
Os seus dados de origem podem conter cadeias codificadas em Base64, como cadeias de metadados de blob ou URLs web, que pretende tornar pesquisáveis como texto simples. Pode usar a base64Decode função para transformar os dados codificados de volta em strings normais ao preencher o seu índice de pesquisa.
"fieldMappings" : [
  {
    "sourceFieldName" : "Base64EncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "base64Decode",
      "parameters" : { "useHttpServerUtilityUrlTokenDecode" : false }
    }
  }
]
Se não incluires uma propriedade de parâmetros, ela passa por defeito ao valor {"useHttpServerUtilityUrlTokenEncode" : true}.
O Pesquisa de IA do Azure suporta duas codificações Base64 diferentes. Deves usar os mesmos parâmetros ao codificar e decodificar o mesmo campo. Para mais informações, consulte as opções de codificação base64 para decidir quais os parâmetros a utilizar.
Opções de codificação base64
O Pesquisa de IA do Azure suporta codificação base64 segura para URL e codificação base64 normal. Uma cadeia codificada em base64 durante a indexação deve ser decodificada mais tarde com as mesmas opções de codificação, caso contrário o resultado não corresponderá ao original.
Se os parâmetros useHttpServerUtilityUrlTokenEncode e useHttpServerUtilityUrlTokenDecode para codificação e descodificação, respetivamente, forem definidos para true, então base64Encode comporta-se como HttpServerUtility.UrlTokenEncode e base64Decode comporta-se como HttpServerUtility.UrlTokenDecode.
Aviso
Se base64Encode for usado para produzir valores-chave, useHttpServerUtilityUrlTokenEncode deve ser definido como verdadeiro. Apenas a codificação base64 segura para URL pode ser usada para valores-chave.
Consulte Regras de nomenclatura para o conjunto completo de restrições sobre caracteres em valores-chave.
As bibliotecas .NET no Pesquisa de IA do Azure assumem o framework .NET completo, que fornece codificação incorporada.
useHttpServerUtilityUrlTokenEncode e useHttpServerUtilityUrlTokenDecode opções aplicam esta funcionalidade integrada. Se estiver a usar .NET Core ou outro framework, recomendamos definir essas opções para false e chamar diretamente as funções de codificação e decodificação do seu framework.
A tabela seguinte compara diferentes codificações base64 da cadeia 00>00?00. Para determinar o processamento necessário (se houver) para as suas funções base64, aplique a função de codificação da biblioteca na cadeia 00>00?00 e compare a saída com a saída MDA-MDA_MDAesperada.
| Codificação | Saída de codificação Base64 | Processamento extra após a codificação da biblioteca | Processamento extra antes da decodificação da biblioteca |
|---|---|---|---|
| Base64 com preenchimento | MDA+MDA/MDA= |
Utilize caracteres seguros para URLs e remova o preenchimento | Use caracteres base64 padrão e adicione preenchimento |
| Base64 sem preenchimento | MDA+MDA/MDA |
Use caracteres seguros para URL | Use caracteres base64 padrão |
| Base64 seguro para URLs com enchimento | MDA-MDA_MDA= |
Remover o acolchoamento | Adicionar almofadamento |
| base64 seguro para URLs sem enchimento | MDA-MDA_MDA |
Nenhuma | Nenhuma |
Função extractTokenAtPosition
Divide um campo de cadeias usando o delimitador especificado e escolhe a ficha na posição especificada na divisão resultante.
Esta função utiliza os seguintes parâmetros:
-
delimiter: uma cadeia para usar como separador ao dividir a cadeia de entrada. -
position: uma posição inteira baseada em zero do token a escolher depois de a cadeia de entrada ser dividida.
Por exemplo, se a entrada é Jane Doe, o delimiter é " "(espaço) e o position é 0, o resultado é Jane; se o position é 1, o resultado é Doe. Se a posição se referir a um token que não existe, é devolto um erro.
Exemplo - extrair um nome
A tua fonte de dados contém um PersonName campo e queres indexá-lo como dois campos separados FirstName e LastName. Pode usar esta função para dividir a entrada usando o carácter de espaço como delimitador.
"fieldMappings" : [
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "FirstName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 0 } }
  },
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "LastName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 1 } }
  }]
Função jsonArrayToStringCollection
Transforma uma string formatada como um array JSON de strings num array de strings que pode ser utilizado para preencher o campo
Por exemplo, se a cadeia de entrada for ["red", "white", "blue"], então o campo alvo do tipo Collection(Edm.String) será preenchido com os três valores red, white, e blue. Para valores de entrada que não podem ser analisados como arrays de strings JSON, é devolvido um erro.
Exemplo - preencher a recolha a partir de dados relacionais
Base de Dados SQL do Azure não tem um tipo de dado incorporado que naturalmente mapeie para campos Collection(Edm.String) em Pesquisa de IA do Azure. Para preencher os campos de recolha de strings, pode pré-processar os seus dados de origem como um array de strings JSON e depois usar a jsonArrayToStringCollection função de mapeamento.
"fieldMappings" : [
  {
    "sourceFieldName" : "tags",
    "mappingFunction" : { "name" : "jsonArrayToStringCollection" }
  }]
Função urlEncode
Esta função pode ser usada para codificar uma cadeia de caracteres para que seja "segura para URL". Quando usada com uma string que contém caracteres que não são permitidos numa URL, esta função converte esses caracteres "inseguros" em equivalentes entidade de caracteres. Esta função utiliza o formato de codificação UTF-8.
Exemplo - consulta de chaves de documento
urlEncode função pode ser usada como alternativa à base64Encode função, se apenas caracteres URL inseguros forem convertidos, mantendo os outros caracteres as-is.
Por exemplo, a cadeia de entrada é <hello> - então o campo alvo do tipo (Edm.String) será preenchido com o valor %3chello%3e
Quando recuperares a chave codificada na hora da pesquisa, podes então usar a urlDecode função para obter o valor original da chave e usá-la para recuperar o documento de origem.
"fieldMappings" : [
  {
    "sourceFieldName" : "SourceKey",
    "targetFieldName" : "IndexKey",
    "mappingFunction" : {
      "name" : "urlEncode"
    }
  }
]
Função urlDecode
Esta função converte uma cadeia codificada por URL numa cadeia decodificada usando o formato de codificação UTF-8.
Exemplo - decodificar metadados do blob
Alguns clientes de armazenamento Azure codificam automaticamente metadados de blob por URL se estes conterem caracteres não ASCII. No entanto, se quiser tornar esses metadados pesquisáveis (como texto simples), pode usar a urlDecode função para transformar os dados codificados de volta em strings regulares ao preencher o índice de pesquisa.
"fieldMappings" : [
  {
    "sourceFieldName" : "UrlEncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "urlDecode"
    }
  }
]
Função fixedLengthEncode
Esta função converte uma cadeia de qualquer comprimento numa cadeia de comprimento fixo.
Exemplo - mapear chaves de documento que são demasiado longas
Quando ocorrem erros relacionados com o comprimento da chave do documento exceder 1024 caracteres, esta função pode ser aplicada para reduzir o comprimento da chave do documento.
"fieldMappings" : [
 {
   "sourceFieldName" : "metadata_storage_path",
   "targetFieldName" : "your key field",
   "mappingFunction" : {
     "name" : "fixedLengthEncode"
   }
 }
]
função toJson
Esta função converte uma string num objeto JSON formatado. Isto pode ser usado em cenários onde a fonte de dados, como o SQL do Azure, não suporta nativamente tipos de dados compostos ou hierárquicos, e depois mapeá-la para campos complexos.
Exemplo - mapear conteúdo textual para um campo complexo
Suponha que existe uma linha SQL com uma string JSON que precisa de ser mapeada para um campo complexo (correspondentemente definido) no índice, a toJson função pode ser usada para conseguir isso. Por exemplo, se um campo complexo no índice precisar de ser preenchido com os seguintes dados:
{
    "id": "5",
    "info": {
        "name": "Jane",
        "surname": "Smith",
        "skills": [
            "SQL",
            "C#",
            "Azure"
        ],
        "dob": "2005-11-04T12:00:00"
    }
}
Pode ser conseguido usando a função de mapeamento toJson numa coluna de string JSON numa linha SQL que se assemelha a esta: {"id": 5, "info": {"name": "Jane", "surname": "Smith", "skills": ["SQL", "C#", "Azure"]}, "dob": "2005-11-04T12:00:00"}.
O mapeamento de campo deve ser especificado conforme mostrado abaixo.
"fieldMappings" : [
  {
    "sourceFieldName" : "content",
    "targetFieldName" : "complexField",
    "mappingFunction" : {
      "name" : "toJson"
    }
  }
]
Cenários avançados de mapeamento de campo
Em cenários em que tenha relações de documentos "um-para-muitos", como fragmentação ou divisão de dados, segue estas orientações para mapear campos dos documentos pai para documentos "filhos" (em fragmentos):
1. Omitir a indexação de documentos pais
Se estiveres a saltar a indexação dos documentos pais (definindo projectionMode como skipIndexingParentDocuments no conjunto indexProjectionsde competências ), usa projeções de índice para mapear campos dos documentos pais para os documentos "filhos".
2. Indexação de documentos pais e "filhos"
Se estiver a indexar tanto documentos pais como documentos "filhos":
- Use mapeamentos de campos de forma a mapear campos nos documentos pais.
- Use projeções de índice para associar campos aos documentos "filhos".
3. Mapear valores transformados pela função para documentos pais e/ou "filhos"
Se um campo no documento pai necessitar de uma transformação (usando funções de mapeamento específicas, como a codificação) e precisar ser mapeado para os documentos pai e/ou "filhos":
- Aplique a transformação usando as funções de mapeamentos de campo no indexador.
- Use projeções de índice no conjunto de competências para mapear o campo transformado para os documentos "filhos".