Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Note
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
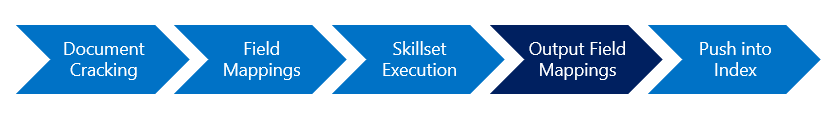
Este artigo explica como configurar mapeamentos de campos de saída, que definem um caminho de dados entre os dados em memória gerados durante o processamento do conjunto de competências e os campos-alvo num índice de pesquisa. Durante a execução do indexador, a informação gerada pela competência existe apenas na memória. Para persistir esta informação num índice de pesquisa, deve indicar ao indexador para onde enviar os dados.
Um mapeamento de campo de saída é definido em um indexador e tem os seguintes elementos:
"outputFieldMappings": [
  {
    "sourceFieldName": "document/path-to-a-node-in-an-enriched-document",
    "targetFieldName": "some-search-field-in-an-index",
    "mappingFunction": null
  }
],
Em contraste com uma definição fieldMappings que mapeia um caminho entre campos de origem literais e campos de índice, uma definição outputFieldMappings mapeia enriquecimentos em memória para campos num índice de pesquisa.
Pré-requisitos
Indexador, índice, fonte de dados e conjunto de habilidades.
Os campos de índice devem ser simples ou de nível superior. Não é possível produzir para um tipo complexo. No entanto, se você tiver um tipo complexo, poderá usar uma definição de campo de saída para nivelar partes do tipo complexo e enviá-las para uma coleção em um índice de pesquisa.
Quando usar um mapeamento de campo de saída
Os mapeamentos de campo de saída são necessários se o indexador tiver um conjunto de habilidades anexado que crie novas informações desejadas no índice. Exemplos incluem:
- Vetores de aptidões de incorporação.
- Reconhecimento ótico de caracteres (OCR) de texto a partir de competências de imagem.
- Localizações, organizações ou pessoas com competências de reconhecimento de entidades.
Os mapeamentos de campo de saída também podem ser usados para:
Crie várias cópias do conteúdo gerado (mapeamentos de campo de saída um-para-muitos).
Simplificar o tipo complexo de um documento de origem. Por exemplo, suponha que os documentos de origem tenham um tipo complexo, como um endereço com várias partes, e você queira apenas a cidade. Você pode usar um mapeamento de campo de saída para nivelar uma estrutura de dados aninhada e, em seguida, usar um mapeamento de campo de saída para enviar a saída para uma coleção de cadeia de caracteres em seu índice de pesquisa.
Os mapeamentos de campo de saída aplicam-se apenas aos índices de pesquisa. Se você estiver preenchendo um repositório de conhecimento, use projeções para a configuração do caminho de dados.
Definir um mapeamento de campo de saída
Os mapeamentos de campo de saída são adicionados à outputFieldMappings matriz em uma definição de indexador, normalmente colocada após a fieldMappings matriz. Um mapeamento de campo de saída consiste em três partes.
Você pode usar a API REST ou um SDK do Azure para definir mapeamentos de campo de saída.
Gorjeta
Os indexadores criados pelo assistente de Importação de dados incluem os mapeamentos de campos de saída gerados pelo assistente. Se precisar de exemplos, execute o assistente sobre a fonte de dados para ver os mapeamentos de campo de saída no indexador.
Use Criar Indexador ou Criar ou Atualizar Indexador ou um método equivalente em um SDK do Azure. Aqui está um exemplo de uma definição de indexador.
{
   "name": "myindexer",
   "description": null,
   "dataSourceName": "mydatasource",
   "targetIndexName": "myindex",
   "schedule": { },
   "parameters": { },
   "fieldMappings": [],
   "outputFieldMappings": [],
   "disabled": false,
   "encryptionKey": { }
 }
Preencha a
outputFieldMappingsmatriz para especificar os mapeamentos. Um mapeamento de campo consiste em três partes."outputFieldMappings": [ { "sourceFieldName": "/document/path-to-a-node-in-an-enriched-document", "targetFieldName": "some-search-field-in-an-index", "mappingFunction": null } ]
| Propriedade | Descrição |
|---|---|
| sourceFieldName | Obrigatório. Especifica um caminho para conteúdo enriquecido. Um exemplo pode ser /document/content. Consulte Enriquecimentos de referência em um conjunto de habilidades de Pesquisa de IA do Azure para obter sintaxe de caminho e exemplos. |
| targetFieldName | Opcional. Especifica o campo de pesquisa que recebe o conteúdo enriquecido. Os campos de destino devem ser campos simples de nível superior ou coleções. Não pode ser um caminho para um subcampo de um tipo complexo. Se quiser recuperar nós específicos em uma estrutura complexa, você pode nivelar nós individuais na memória e, em seguida, enviar a saída para uma coleção de cadeias de caracteres em seu índice. |
| Função de mapeamento | Opcional. Adiciona processamento extra fornecido por funções de mapeamento suportadas por indexadores. Para nós de enriquecimento, codificação e decodificação são as funções mais comumente usadas. |
O
targetFieldNameé sempre o nome do campo no índice de pesquisa.O
sourceFieldNamerepresenta um caminho para um nó no documento enriquecido. É o resultado de uma habilidade. O caminho sempre começa com /document e, se você estiver indexando a partir de um blob, o segundo elemento do caminho será /content. O terceiro elemento é o valor produzido pela habilidade. Para obter mais informações e exemplos, consulte Enriquecimentos de referência em um conjunto de habilidades do Pesquisa de IA do Azure.Este exemplo adiciona entidades e rótulos de sentimento extraídos da propriedade de conteúdo de um blob a campos num índice de pesquisa.
{
    "name": "myIndexer",
    "dataSourceName": "myDataSource",
    "targetIndexName": "myIndex",
    "skillsetName": "myFirstSkillSet",
    "fieldMappings": [],
    "outputFieldMappings": [
        {
            "sourceFieldName": "/document/content/organizations/*/description",
            "targetFieldName": "descriptions",
            "mappingFunction": {
                "name": "base64Decode"
            }
        },
        {
            "sourceFieldName": "/document/content/organizations",
            "targetFieldName": "orgNames"
        },
        {
            "sourceFieldName": "/document/content/sentiment",
            "targetFieldName": "sentiment"
        }
    ]
}
Atribua todas as funções de mapeamento necessárias para transformar o conteúdo de um campo antes que ele seja armazenado no índice. Para nós de enriquecimento, codificação e decodificação são as funções mais comumente usadas.
Mapeamento de campo de saída um-para-muitos
Você pode usar um mapeamento de campo de saída para rotear um único campo de origem para vários campos em um índice de pesquisa. Você pode fazer isso para testes de comparação ou se quiser campos com atributos diferentes.
Suponha um conjunto de habilidades que gera incorporações para um campo vetorial e um índice que tem vários campos vetoriais que variam de acordo com o algoritmo e as configurações de compactação. Dentro do indexador, mapeie a saída da habilidade de incorporação para cada um dos vários campos vetoriais em um índice de pesquisa.
"outputFieldMappings": [
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_hnsw" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_eknn" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_narrow" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_no_stored" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_scalar" }
  ]
O caminho do campo de origem é o output de habilidade. Neste exemplo, a saída é text_vetor. O nome do destino é uma propriedade opcional. Se você não der ao mapeamento de saída um nome de destino, o caminho será incorporado ou, mais precisamente, /document/content/embedding.
{
  "name": "test-vector-size-ss",
  "description": "Generate embeddings using Azure OpenAI in Foundry Models",
  "skills": [
    {
      "@odata.type": "#Microsoft.Skills.Text.AzureOpenAIEmbeddingSkill",
      "name": "#1",
      "description": null,
      "context": "/document/content",
      "resourceUri": "https://my-demo-eastus.openai.azure.com",
      "apiKey": null,
      "deploymentId": "text-embedding-ada-002",
      "dimensions": 1536,
      "modelName": "text-embedding-ada-002",
      "inputs": [
        {
          "name": "text",
          "source": "/document/content"
        }
      ],
      "outputs": [
        {
          "name": "embedding",
          "targetName": "text_vector"
        }
      ],
      "authIdentity": null
    }
  ]
}
Nivelar estruturas complexas em uma coleção de cadeias de caracteres
Se os dados de origem forem compostos por JSON aninhado ou hierárquico, não será possível usar mapeamentos de campo para configurar os caminhos de dados. Em vez disso, seu índice de pesquisa deve espelhar a estrutura de dados de origem em cada nível para uma importação completa.
Esta seção orienta você por um processo de importação que produz um reflexo um-para-um de um documento complexo nos lados de origem e destino. De seguida, utiliza o mesmo documento fonte para ilustrar a recuperação e achatamento de nós individuais em coleções de cadeias.
Aqui está um exemplo de um documento no Azure Cosmos DB com JSON aninhado:
{
   "palette":"primary colors",
   "colors":[
      {
         "name":"blue",
         "medium":[
            "acrylic",
            "oil",
            "pastel"
         ]
      },
      {
         "name":"red",
         "medium":[
            "acrylic",
            "pastel",
            "watercolor"
         ]
      },
      {
         "name":"yellow",
         "medium":[
            "acrylic",
            "watercolor"
         ]
      }
   ]
}
Se você quisesse indexar totalmente este documento de origem, criaria uma definição de índice onde os nomes, níveis e tipos de campo são refletidos como um tipo complexo. Como não há suporte para mapeamentos de campo para tipos complexos no índice de pesquisa, sua definição de índice deve espelhar o documento de origem.
{
  "name": "my-test-index",
  "defaultScoringProfile": "",
  "fields": [
    { "name": "id", "type": "Edm.String", "searchable": false, "retrievable": true, "key": true},
    { "name": "palette", "type": "Edm.String", "searchable": true, "retrievable": true },
    { "name": "colors", "type": "Collection(Edm.ComplexType)",
      "fields": [
        {
          "name": "name",
          "type": "Edm.String",
          "searchable": true,
          "retrievable": true
        },
        {
          "name": "medium",
          "type": "Collection(Edm.String)",
          "searchable": true,
          "retrievable": true,
        }
      ]
    }
  ]
}
Aqui está uma definição de indexador de exemplo que executa a importação. Observe que não há mapeamentos de campo nem conjunto de habilidades.
{
  "name": "my-test-indexer",
  "dataSourceName": "my-test-ds",
  "skillsetName": null,
  "targetIndexName": "my-test-index",

  "fieldMappings": [],
  "outputFieldMappings": []
}
O resultado é o seguinte documento de pesquisa de exemplo, semelhante ao original no Azure Cosmos DB.
{
  "value": [
    {
      "@search.score": 1,
      "id": "11bb11bb-cc22-dd33-ee44-55ff55ff55ff",
      "palette": "primary colors",
      "colors": [
        {
          "name": "blue",
          "medium": [
            "acrylic",
            "oil",
            "pastel"
          ]
        },
        {
          "name": "red",
          "medium": [
            "acrylic",
            "pastel",
            "watercolor"
          ]
        },
        {
          "name": "yellow",
          "medium": [
            "acrylic",
            "watercolor"
          ]
        }
      ]
    }
  ]
}
Uma alternativa de representação em um índice de pesquisa é achatar os nós individuais da estrutura aninhada da fonte em uma coleção de strings num índice de pesquisa.
Para realizar essa tarefa, você precisará de um outputFieldMappings que mapeie um nó na memória para uma coleção de cadeias de caracteres no índice. Embora os mapeamentos de campo de saída se apliquem principalmente a saídas de habilidades, também se podem usar para tratar de nós após o document cracking, onde o indexador abre um documento de origem e o lê na memória.
A definição de índice de exemplo a seguir usa coleções de cadeia de caracteres para receber saída achatada:
{
  "name": "my-new-flattened-index",
  "defaultScoringProfile": "",
  "fields": [
    { "name": "id", "type": "Edm.String", "searchable": false, "retrievable": true, "key": true },
    { "name": "palette", "type": "Edm.String", "searchable": true, "retrievable": true },
    { "name": "color_names", "type": "Collection(Edm.String)", "searchable": true, "retrievable": true },
    { "name": "color_mediums", "type": "Collection(Edm.String)", "searchable": true, "retrievable": true}
  ]
}
Aqui está a definição de indexador de exemplo, usando outputFieldMappings para associar o JSON aninhado com os campos de coleção de strings. O campo de origem usa a sintaxe de percurso para nós de enriquecimento, embora não exista um conjunto de competências. Documentos enriquecidos são criados no sistema durante a quebra de documentos, o que significa que você pode acessar nós em cada árvore de documentos, desde que esses nós existam quando o documento é quebrado.
{
  "name": "my-test-indexer",
  "dataSourceName": "my-test-ds",
  "skillsetName": null,
  "targetIndexName": "my-new-flattened-index",
  "parameters": {  },
  "fieldMappings": [   ],
  "outputFieldMappings": [
    {
       "sourceFieldName": "/document/colors/*/name",
       "targetFieldName": "color_names"
    },
    {
       "sourceFieldName": "/document/colors/*/medium",
       "targetFieldName": "color_mediums"
    }
  ]
}
Os resultados da definição são os seguintes. A simplificação da estrutura perde contexto neste caso. Não há mais associações entre uma determinada cor e os meios em que ela está disponível. No entanto, dependendo do seu cenário, um resultado semelhante ao exemplo a seguir pode ser exatamente o que você precisa.
{
  "value": [
    {
      "@search.score": 1,
      "id": "11bb11bb-cc22-dd33-ee44-55ff55ff55ff",
      "palette": "primary colors",
      "color_names": [
        "blue",
        "red",
        "yellow"
      ],
      "color_mediums": [
        "[\"acrylic\",\"oil\",\"pastel\"]",
        "[\"acrylic\",\"pastel\",\"watercolor\"]",
        "[\"acrylic\",\"watercolor\"]"
      ]
    }
  ]
}