Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Nota
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
O Pesquisa de IA do Azure aceita um conjunto de linhas simples como entrada para o pipeline de indexação. Se os dados de origem forem originados de tabelas unidas em um banco de dados relacional do SQL Server, este artigo explica como construir o conjunto de linhas e como modelar uma relação pai-filho em um índice do Pesquisa de IA do Azure.
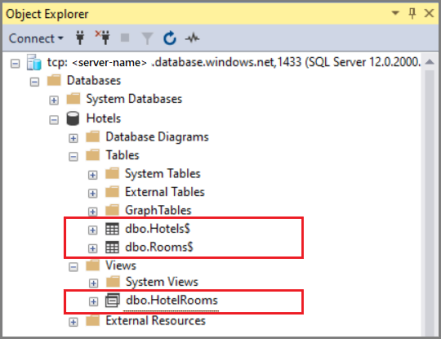
A título de ilustração, referimo-nos a uma hipotética base de dados de hotéis, baseada em dados de exemplo. Suponha que o banco de dados consiste em uma Hotels$ tabela com 50 hotéis e uma Rooms$ tabela com quartos de diferentes tipos, tarifas e comodidades, para um total de 750 quartos. Há uma relação um-para-muitos entre as tabelas. Na nossa abordagem, uma visualização fornece a consulta que retorna 50 linhas, uma linha por hotel, com o detalhe do quarto associado incorporado a cada linha.
O problema dos dados desnormalizados
Um dos desafios em trabalhar com relações um-para-muitos é que as consultas padrão criadas em tabelas unidas retornam dados desnormalizados, o que não funciona bem em um cenário de Pesquisa de IA do Azure. Considere o exemplo a seguir que une hotéis e quartos.
SELECT * FROM Hotels$
INNER JOIN Rooms$
ON Rooms$.HotelID = Hotels$.HotelID
Os resultados dessa consulta retornam todos os campos Hotel, seguidos por todos os campos Quarto, com informações preliminares do hotel repetidas para cada valor de quarto.
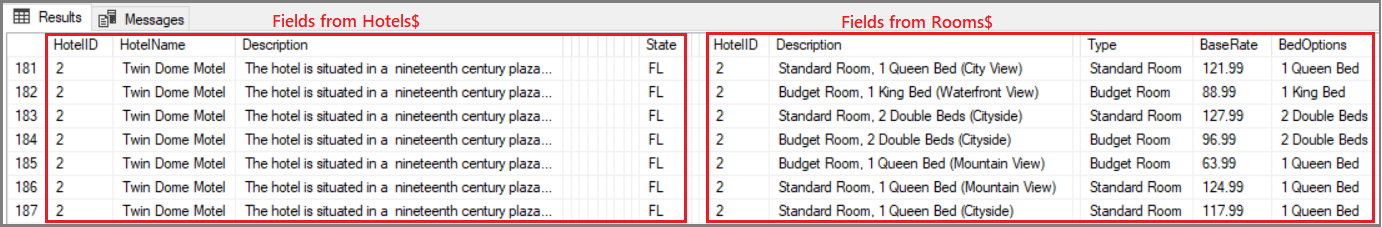
Embora essa consulta seja bem-sucedida na superfície (fornecendo todos os dados em um conjunto de linhas simples), ela falha em fornecer a estrutura de documento correta para a experiência de pesquisa esperada. Durante a indexação, o Pesquisa de IA do Azure cria um documento de pesquisa para cada linha ingerida. Se seus documentos de pesquisa se parecessem com os resultados acima, você teria percebido duplicatas - sete documentos separados apenas para o Old Century Hotel. Uma consulta sobre "hotéis na Flórida" retornaria sete resultados apenas para o Old Century Hotel, empurrando outros hotéis relevantes para os resultados de pesquisa.
Para obter a experiência esperada de um documento por hotel, você deve fornecer um conjunto de linhas com a granularidade correta, mas com informações completas. Este artigo explica como.
Definir uma consulta que retorna JSON incorporado
Para fornecer a experiência de pesquisa esperada, seu conjunto de dados deve consistir em uma linha para cada documento de pesquisa no Pesquisa de IA do Azure. No nosso exemplo, queremos uma fila para cada hotel, mas também queremos que os nossos utilizadores possam pesquisar noutros campos relacionados com o quarto que lhes interessam, como a taxa por noite, o tamanho e o número de camas, ou uma vista para a praia, que fazem parte de um detalhe do quarto.
A solução é capturar os detalhes da sala como JSON aninhado e, em seguida, inserir a estrutura JSON num campo numa visualização, conforme mostrado na segunda etapa.
Suponha que existam duas tabelas,
Hotels$eRooms$, que contêm detalhes de 50 hotéis e 750 quartos, e que estão unidas pelo campo HotelID. Individualmente, estas tabelas contêm 50 hotéis e 750 quartos relacionados.CREATE TABLE [dbo].[Hotels$]( [HotelID] [nchar](10) NOT NULL, [HotelName] [nvarchar](255) NULL, [Description] [nvarchar](max) NULL, [Description_fr] [nvarchar](max) NULL, [Category] [nvarchar](255) NULL, [Tags] [nvarchar](255) NULL, [ParkingIncluded] [float] NULL, [SmokingAllowed] [float] NULL, [LastRenovationDate] [smalldatetime] NULL, [Rating] [float] NULL, [StreetAddress] [nvarchar](255) NULL, [City] [nvarchar](255) NULL, [State] [nvarchar](255) NULL, [ZipCode] [nvarchar](255) NULL, [GeoCoordinates] [nvarchar](255) NULL ) ON [PRIMARY] TEXTIMAGE_ON [PRIMARY] GO CREATE TABLE [dbo].[Rooms$]( [HotelID] [nchar](10) NULL, [Description] [nvarchar](255) NULL, [Description_fr] [nvarchar](255) NULL, [Type] [nvarchar](255) NULL, [BaseRate] [float] NULL, [BedOptions] [nvarchar](255) NULL, [SleepsCount] [float] NULL, [SmokingAllowed] [float] NULL, [Tags] [nvarchar](255) NULL ) ON [PRIMARY] GOCrie um modo de exibição composto por todos os campos na tabela pai (
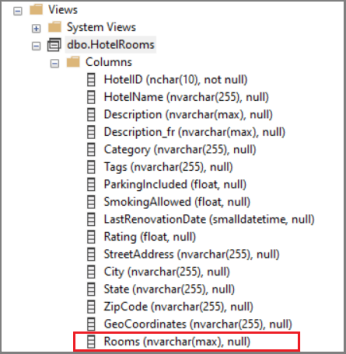
SELECT * from dbo.Hotels$), com a adição de um novo campo Quartos que contém a saída de uma consulta aninhada. A cláusula FOR JSON AUTO emSELECT * from dbo.Rooms$estrutura a saída como JSON.CREATE VIEW [dbo].[HotelRooms] AS SELECT *, (SELECT * FROM dbo.Rooms$ WHERE dbo.Rooms$.HotelID = dbo.Hotels$.HotelID FOR JSON AUTO) AS Rooms FROM dbo.Hotels$ GOA captura de tela a seguir mostra a exibição resultante, com o campo Rooms nvarchar na parte inferior. O campo Rooms existe apenas na vista HotelRooms.
Execute
SELECT * FROM dbo.HotelRoomspara recuperar o conjunto de linhas. Essa consulta retorna 50 linhas, uma por hotel, com informações de quarto associadas como uma coleção JSON.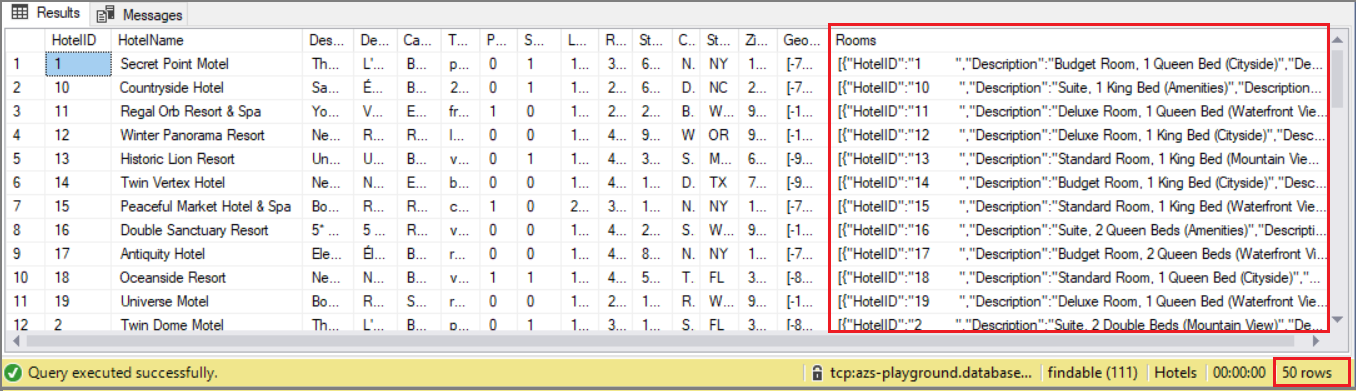
Esse conjunto de linhas agora está pronto para importação para o Pesquisa de IA do Azure.
Nota
Essa abordagem pressupõe que o JSON incorporado esteja abaixo dos limites máximos de tamanho de coluna do SQL Server.
Use uma coleção complexa para o lado "muitos" de um relacionamento um-para-muitos
No lado da Pesquisa de IA do Azure, crie um esquema de índice que modele a relação um-para-muitos usando JSON aninhado. O conjunto de resultados que você criou na seção anterior geralmente corresponde ao esquema de índice fornecido a seguir (cortamos alguns campos para abreviar).
O exemplo a seguir é semelhante ao exemplo em Como modelar tipos de dados complexos. A estrutura Quartos , que tem sido o foco deste artigo, está na coleção de campos de um índice chamado hotéis. Este exemplo também mostra um tipo complexo para Address, que difere de Rooms porque é composto por um conjunto fixo de itens, em oposição ao número múltiplo e arbitrário de itens permitidos em uma coleção.
{
  "name": "hotels",
  "fields": [
    { "name": "HotelId", "type": "Edm.String", "key": true, "filterable": true },
    { "name": "HotelName", "type": "Edm.String", "searchable": true, "filterable": false },
    { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
    { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
    { "name": "Category", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": true },
    { "name": "ParkingIncluded", "type": "Edm.Boolean", "filterable": true, "facetable": true },
    { "name": "Tags", "type": "Collection(Edm.String)", "searchable": true, "filterable": true, "facetable": true },
    { "name": "Address", "type": "Edm.ComplexType",
      "fields": [
        { "name": "StreetAddress", "type": "Edm.String", "filterable": false, "sortable": false, "facetable": false, "searchable": true },
        { "name": "City", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true },
        { "name": "StateProvince", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true }
      ]
    },
    { "name": "Rooms", "type": "Collection(Edm.ComplexType)",
      "fields": [
        { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
        { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
        { "name": "Type", "type": "Edm.String", "searchable": true },
        { "name": "BaseRate", "type": "Edm.Double", "filterable": true, "facetable": true },
        { "name": "BedOptions", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": false },
        { "name": "SleepsCount", "type": "Edm.Int32", "filterable": true, "facetable": true },
        { "name": "SmokingAllowed", "type": "Edm.Boolean", "filterable": true, "facetable": false},
        { "name": "Tags", "type": "Edm.Collection", "searchable": true }
      ]
    }
  ]
}
Dado o conjunto de resultados anterior e o esquema de índice acima, você tem todos os componentes necessários para uma operação de indexação bem-sucedida. O conjunto de dados nivelado atende aos requisitos de indexação, mas preserva informações detalhadas. No índice Pesquisa de IA do Azure, os resultados da pesquisa caem facilmente em entidades baseadas em hotéis, preservando o contexto de quartos individuais e seus atributos.
Comportamento de facetas em subcampos de tipo complexos
Os campos que têm um pai, como os campos em Endereço e Salas, são chamados de subcampos. Embora se possa atribuir um atributo "facetable" a um subcampo, a contagem da faceta é sempre para o documento principal.
Para tipos complexos como Address, onde há apenas um "Address/City" ou "Address/stateProvince" no documento, o comportamento da faceta se comporta conforme o esperado. No entanto, no caso das salas, onde existem vários subdocumentos para cada documento principal, as contagens de facetas podem ser enganosas.
Como observado em Modelos de tipos complexos: "As contagens de documentos retornadas nos resultados da faceta são calculadas para o documento pai (um hotel), não para os subdocumentos de uma coleção complexa (salas). Por exemplo, suponha que um hotel tenha 20 quartos do tipo "suíte". Dado este parâmetro de faceta facet=Quartos/Tipo, a contagem de facetas é de uma para o hotel e não de 20 para os quartos.
Próximos passos
Usando o seu próprio conjunto de dados, pode usar o assistente Importar dados para criar e carregar o índice. O assistente deteta a coleção JSON incorporada, como a contida em Rooms, e infere um esquema de índice que inclui uma coleção de tipos complexa.
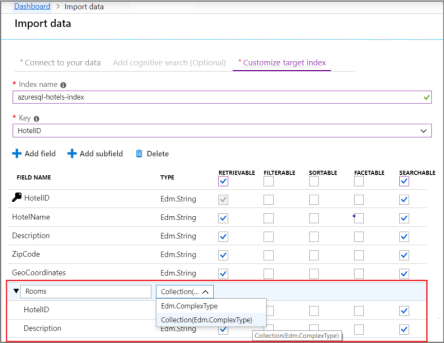
Experimente o seguinte quickstart para aprender os passos básicos do assistente de importação de dados .