Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Nota
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
A pesquisa de texto completo é uma abordagem na recuperação de informações que corresponde ao texto sem formatação armazenado em um índice. Por exemplo, dada uma cadeia de caracteres de consulta "hotéis em San Diego na praia", o mecanismo de pesquisa procura cadeias de caracteres tokenizadas com base nesses termos. Para tornar as verificações mais eficientes, as cadeias de caracteres de consulta passam por uma análise lexical: reduzir todos os termos, remover palavras irrelevantes como "o" e reduzir os termos para formas raiz primitivas. Quando os termos correspondentes são encontrados, o mecanismo de pesquisa recupera documentos, os classifica em ordem de relevância e retorna os principais resultados.
A execução da consulta pode ser complexa. Este artigo é para desenvolvedores que precisam de uma compreensão mais profunda de como a pesquisa de texto completo funciona em Pesquisa de IA do Azure . Para consultas de texto, Pesquisa de IA do Azure entrega os resultados esperados de forma perfeita na maioria dos cenários, mas ocasionalmente, você pode obter um resultado que parece "estranho" de alguma forma. Nessas situações, ter um plano de fundo nos quatro estágios da execução da consulta Lucene (análise de consulta, análise lexical, correspondência de documentos e pontuação) pode ajudá-lo a identificar alterações específicas nos parâmetros de consulta ou na configuração de índice que produzem o resultado desejado.
Nota
Pesquisa de IA do Azure usa Apache Lucene para pesquisa de texto completo, mas a integração do Lucene não é exaustiva. Expõemos e estendemos seletivamente a funcionalidade lucene para habilitar os cenários importantes para Pesquisa de IA do Azure .
Visão geral e diagrama da arquitetura
A execução da consulta tem quatro estágios:
- Análise de consulta
- Análise lexical
- Recuperação de documento
- Pontuação
Uma consulta de pesquisa de texto completo começa com a análise do texto da consulta para extrair os termos e operadores de pesquisa. Há dois analisadores para que você possa escolher entre velocidade e complexidade. Uma fase de análise é a próxima, em que os termos de consulta individuais às vezes são divididos e reconstituídos em novos formulários. Esta etapa ajuda a lançar uma rede mais ampla sobre o que poderia ser considerado como uma possível correspondência. Em seguida, o mecanismo de pesquisa examina o índice para localizar documentos com termos correspondentes e pontua cada correspondência. Um conjunto de resultados é classificado por uma pontuação de relevância atribuída a cada documento de correspondência individual. Aqueles no topo da lista com a classificação são retornados para o aplicativo de chamada.
O diagrama a seguir ilustra os componentes usados para processar uma solicitação de pesquisa:
Diagrama da arquitetura de consulta Lucene no Pesquisa de IA do Azure .
| Componentes principais | Descrição funcional |
|---|---|
| Analisadores de consulta | Separe os termos de consulta dos operadores de consulta e crie a estrutura de consulta (uma árvore de consulta) a ser enviada ao mecanismo de pesquisa. |
| Analisadores | Realize a análise lexical nos termos da consulta. Esse processo pode envolver a transformação, a remoção ou a expansão dos termos da consulta. |
| Índice | Uma estrutura de dados eficiente usada para armazenar e organizar termos pesquisáveis extraídos de documentos indexados. |
| Mecanismo de pesquisa | Recupera e pontua documentos correspondentes com base no conteúdo do índice invertido. |
Anatomia de uma solicitação de pesquisa
Uma solicitação de pesquisa é uma especificação completa do que deve ser retornado em um conjunto de resultados. Em sua forma mais simples, é uma consulta vazia sem critérios de qualquer tipo. Um exemplo mais realista inclui parâmetros, vários termos de consulta, talvez com escopo para determinados campos, com possivelmente uma expressão de filtro e regras de ordenação.
O exemplo a seguir é uma solicitação de pesquisa que você pode enviar para Pesquisa de IA do Azure usando a API REST:
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
Para essa solicitação, o mecanismo de pesquisa faz as seguintes operações:
Localiza documentos em que o preço é de pelo menos US$ 60 e menos de US$ 300.
Executa a consulta. Neste exemplo, a consulta de pesquisa consiste em frases e termos:
"Spacious, air-condition* +\"Ocean view\""(os usuários normalmente não inserem pontuação, mas ao incluí-la no exemplo, podemos explicar como os analisadores lidam com ela).)Para essa consulta, o mecanismo de pesquisa verifica os campos de descrição e título especificados em "searchFields" em busca de documentos que contenham
"Ocean view", além disso, no termo"spacious"ou em termos que começam com o prefixo"air-condition". O parâmetro "searchMode" é usado para corresponder a qualquer termo (padrão) ou a todos eles, para casos em que um termo não é explicitamente necessário (+).Ordena o conjunto resultante de hotéis por proximidade com um determinado local de geografia e retorna os resultados para o aplicativo de chamada.
A maior parte deste artigo é sobre o processamento da consulta de pesquisa: "Spacious, air-condition* +\"Ocean view\"". A filtragem e a ordenação estão fora do escopo. Para obter mais informações, consulte a documentação de referência da API de Pesquisa.
Estágio 1: Análise de consulta
Conforme observado, a cadeia de caracteres de consulta é a primeira linha da solicitação:
"search": "Spacious, air-condition* +\"Ocean view\"",
O analisador de consulta separa os operadores (como * e + no exemplo) dos termos de pesquisa e desconstrui a consulta de pesquisa em subconsultas de um tipo com suporte:
- consulta de termo para termos independentes (espaçoso, por exemplo)
- consulta de frase para termos entre aspas (vista para o mar, por exemplo)
-
consulta de prefixo para termos seguidos por um operador
*de prefixo (como ar-condicionado)
Para obter uma lista completa de tipos de consulta com suporte, consulte a sintaxe de consulta Lucene.
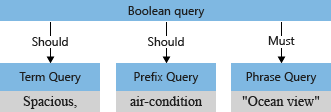
Os operadores associados com uma subconsulta determinam se a consulta deve ser obrigatoriamente satisfeita ou não para um documento ser considerado uma correspondência. Por exemplo, +"Ocean view" é "necessário" devido ao operador +.
O analisador de consulta reestrutura as subconsultas em uma árvore de consulta (uma estrutura interna que representa a consulta), que ela passa para o mecanismo de pesquisa. No primeiro estágio de análise de consulta, a árvore de consulta tem esta aparência:
Analisadores suportados: Simple e Full Lucene
Pesquisa de IA do Azure expõe duas linguagens de consulta diferentes: simple (padrão) e full. Ao definir o queryType parâmetro com sua solicitação de pesquisa, você informa ao analisador de consulta qual idioma de consulta você escolhe para que ele saiba como interpretar os operadores e a sintaxe.
A linguagem de consulta simples é intuitiva e robusta, geralmente adequada para interpretar a entrada do usuário como está sem processamento no lado do cliente. Ela oferece suporte a operadores de consulta familiares de mecanismos de pesquisa.
A linguagem de consulta Lucene completa, que você obtém definindo
queryType=full, estende a linguagem de consulta simples padrão adicionando suporte para mais operadores e tipos de consulta, como curinga, difusa, regex e consultas com escopo de campo. Por exemplo, uma expressão regular enviada na sintaxe de consulta simples seria interpretada como uma cadeia de caracteres de consulta e não como uma expressão. A solicitação de exemplo neste artigo usa a linguagem de consulta Complete Lucene.
Impacto do searchMode no analisador
Outro parâmetro de solicitação de pesquisa que afeta a análise é o parâmetro "searchMode". Ele controla o operador padrão para consultas boolianas: qualquer (padrão) ou tudo.
Quando "searchMode=any", que é o padrão, o delimitador de espaço entre espaçoso e ar-condicio for OR (||), tornando o texto da consulta de exemplo equivalente a:
Spacious,||air-condition*+"Ocean view"
Operadores explícitos, como + em +"Ocean view", são inequívocas na construção de consulta booliana (o termo deve corresponder). Menos óbvio é como interpretar os termos restantes: espaçoso e ar-condicionado. O mecanismo de pesquisa deve localizar correspondências para vista para o mar e espaçoso e ar-condicio? Ou deve encontrar vista para o mar mais qualquer um dos demais termos?
Por padrão ("searchMode=any"), o mecanismo de pesquisa assume a interpretação mais ampla. Cada campo deve ter uma correspondência, refletindo a semântica de "ou". A árvore de consulta inicial ilustrada anteriormente, com as duas operações "should", mostra o padrão.
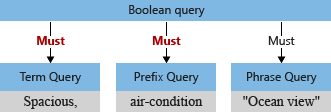
Suponha que agora definimos "searchMode=all". Nesse caso, o espaço é interpretado como uma operação "e". Ambos os termos restantes devem estar presentes no documento para se qualificarem como uma correspondência. A consulta de exemplo resultante seria interpretada desta forma:
+Spacious,+air-condition*+"Ocean view"
Uma árvore de consulta modificada para essa consulta, em que um documento correspondente é a interseção das três subconsultas, teria esta aparência:
Nota
Escolher "searchMode=any" em vez de "searchMode=all" é uma decisão melhor tomada executando consultas representativas. Os usuários mais propensos a incluir operadores (comum ao pesquisar repositórios de documentos) podem encontrar resultados mais intuitivos se "searchMode=all" informar construções de consulta boolianas. Para obter mais informações sobre a interação entre "searchMode" e operadores, consulte a sintaxe de consulta simples.
Estágio 2: análise lexical
Analisadores léxicos processam consultas de termo e consultas de frase depois que a árvore de consulta é estruturada. Um analisador aceita as entradas de texto fornecidas a ele pelo analisador, processa o texto e envia de volta os termos tokenizados a serem incorporados à árvore de consulta.
A forma mais comum de análise léxico é a análise linguística, que transforma os termos de consulta com base em regras específicas para um determinado idioma. Isso envolve:
- Reduzindo um termo de consulta à forma raiz de uma palavra.
- Removendo palavras não essenciais (palavras de parada, como "o" ou "e" em inglês).
- Dividindo uma palavra composta em partes de componente.
- Letras minúsculas em maiúsculas.
Todas essas operações tendem a apagar diferenças entre a entrada de texto fornecida pelo usuário e os termos armazenados no índice. Essas operações vão além do processamento de texto e exigem um conhecimento aprofundado do próprio idioma. Para adicionar essa camada de conhecimento linguístico, o Pesquisa de IA do Azure oferece suporte a uma longa lista de analisadores de linguagem de Lucene e Microsoft.
Nota
Dependendo do cenário, os requisitos de análise podem variar de mínimo a elaborado. Você pode controlar a complexidade da análise lexical selecionando um dos analisadores predefinidos ou criando seu próprio analisador custom. O escopo dos analisadores inclui campos pesquisáveis e são especificados como parte de uma definição do campo. Isso permite que você varie a análise lexical por campo. Se não for especificado, o analisador Lucene padrão será usado.
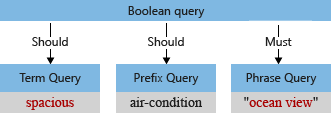
Em nosso exemplo, antes da análise, a árvore de consulta inicial tem o termo "Espaçoso", com "S" maiúsculo e uma vírgula que o analisador de consultas interpreta como parte do termo de consulta (uma vírgula não é considerada um operador de linguagem de consulta).
Quando o analisador padrão processa o termo, converterá em minúsculas "vista para o mar" e "espaçoso" e removerá o caractere de vírgula. A árvore de consulta modificada tem esta aparência:
Testando comportamentos do analisador
O comportamento de um analisador pode ser testado usando a API Analyze. Forneça o texto que você deseja analisar para ver quais termos o analisador fornecido gera. Por exemplo, para ver como o analisador padrão processaria o texto "ar-condicionado", você pode emitir a seguinte solicitação:
{
    "text": "air-condition",
    "analyzer": "standard"
}
O analisador padrão quebra o texto de entrada nos dois tokens a seguir, associando atributos como deslocamentos inicial e final (usados para realçar ocorrências), bem como sua posição (usada para correspondência de frase):
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
Exceções à análise lexical
A análise lexical aplica-se apenas a tipos de consulta que exigem termos completos, uma consulta de termo ou uma consulta de frase. Ele não se aplica a tipos de consulta com termos incompletos — consulta de prefixo, consulta curinga e consulta regex — ou a uma consulta difusa. Esses tipos de consulta, incluindo a consulta de prefixo com o termo air-condition* em nosso exemplo, são adicionados diretamente à árvore de consulta, ignorando o estágio de análise. A única transformação realizada em termos de consulta desses tipos é colocá-los em letras minúsculas.
Estágio 3: Recuperação de documento
Recuperação de documento refere-se à localização de documentos com termos correspondentes no índice. Esse estágio é melhor compreendido por meio de um exemplo. Vamos começar com um índice de hotéis que tem o seguinte esquema simples:
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
Suponha ainda que esse índice contenha os quatro documentos a seguir:
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
Como os termos são indexados
Para entender a recuperação, ajuda a conhecer algumas noções básicas sobre indexação. A unidade de armazenamento é um índice invertido, um para cada campo pesquisável. Dentro de um índice invertido há uma lista classificada de todos os termos de todos os documentos. Cada termo é mapeado para a lista de documentos nos quais ele ocorre, tão evidente no exemplo a seguir.
Para produzir os termos em um índice invertido, o mecanismo de pesquisa executa uma análise lexical sobre o conteúdo dos documentos, semelhante ao que acontece durante o processamento da consulta:
- As entradas de texto são passadas para um analisador, em letras minúsculas, despojadas de pontuação e assim por diante, dependendo da configuração do analisador.
- Tokens são a saída da análise lexical.
- Os termos são adicionados ao índice.
É comum, mas não necessário, usar os mesmos analisadores para operações de pesquisa e indexação para que os termos de consulta se pareçam mais com os termos dentro do índice.
Nota
Pesquisa de IA do Azure permite especificar analisadores diferentes para indexação e pesquisa por meio de parâmetros de campo indexAnalyzer e searchAnalyzer adicionais. Se não for especificado, o conjunto de analisadores com a analyzer propriedade será usado para indexação e pesquisa.
Índice invertido para documentos de exemplo
Retornando ao nosso exemplo, para o campo de título , o índice invertido tem esta aparência:
| Termo | Lista de documentos |
|---|---|
| Atman | 1 |
| Praia | 2 |
| Hotel | 1, 3 |
| Oceano | 4 |
| Playa | 3 |
| Resort | 2 |
| Retiro | 4 |
No campo título, somente o hotel aparece em dois documentos: 1 e 3.
Para o campo de descrição , o índice tem esta aparência:
| Termo | Lista de documentos |
|---|---|
| Ar | 3 |
| E | 4 |
| Praia | 1 |
| Condicionado | 3 |
| Confortável | 3 |
| Distância | 1 |
| Ilha | 2 |
| kauaʻi | 2 |
| Localizado | 2 |
| Norte | 2 |
| Oceano | 1, 2, 3 |
| De | 2 |
| em | 2 |
| Tranquila | 4 |
| Quartos | 1, 3 |
| Isolado | 4 |
| Costa | 2 |
| Espaçoso | 1 |
| O | 1, 2 |
| Para | 1 |
| exibição | 1, 2, 3 |
| Andando | 1 |
| Com | 3 |
Correspondência de termos de consulta em termos indexados
Considerando os índices invertidos acima, vamos retornar à consulta de exemplo e ver como os documentos correspondentes são encontrados para nossa consulta de exemplo. Lembre-se de que a árvore de consulta final tem esta aparência:
Durante a execução da consulta, as consultas individuais são executadas nos campos pesquisáveis de forma independente.
O TermQuery "spacious" corresponde ao documento 1 (Hotel Atman).
O PrefixQuery, "ar-condicionado*", não corresponde a nenhum documento.
Esse comportamento às vezes confunde os desenvolvedores. Embora o termo ar-condicionado exista no documento, ele é dividido em dois termos pelo analisador padrão. Lembre-se de que as consultas de prefixo, que contêm termos parciais, não são analisadas. Portanto, os termos com o prefixo "ar-condicionado" são pesquisados no índice invertido e não encontrados.
A PhraseQuery, "vista para o oceano", procura os termos "oceano" e "vista" e verifica a proximidade dos termos no documento original. Os documentos 1, 2 e 3 correspondem a essa consulta no campo de descrição. Observe que o documento 4 tem o termo "oceano" no título, mas não é considerado uma correspondência, pois estamos procurando a frase "vista do oceano" em vez de palavras individuais.
Nota
Uma consulta de pesquisa é executada independentemente em todos os campos pesquisáveis no índice Pesquisa de IA do Azure , a menos que você limite os campos definidos com o parâmetro searchFields, conforme ilustrado na solicitação de pesquisa de exemplo. Os documentos que correspondem a qualquer um dos campos selecionados são retornados.
No geral, para a consulta em questão, os documentos que correspondem são 1, 2 e 3.
Estágio 4: Pontuação
Cada documento em um conjunto de resultados de pesquisa recebe uma pontuação de relevância. A função da pontuação de relevância é classificar mais alto os documentos que melhor respondem a uma pergunta do usuário, conforme expresso pela consulta de pesquisa. A pontuação é calculada com base nas propriedades estatísticas dos termos correspondentes. No núcleo da fórmula de pontuação está a frequência de termos– frequência inversa de documento (TF/IDF). Em consultas que contêm termos raros e comuns, O TF/IDF promove resultados que contêm o termo raro. Por exemplo, em um índice hipotético com todos os artigos da Wikipédia, de documentos que correspondam à consulta do presidente, os documentos correspondentes ao presidente são considerados mais relevantes do que os documentos correspondentes ao.
Exemplo de pontuação
Lembre-se dos três documentos que corresponderam à nossa consulta de exemplo:
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
O documento 1 foi o que melhor correspondeu à consulta, pois tanto o termo espaçoso como a frase solicitada vista para o mar ocorrem no campo descrição. Os dois documentos seguintes correspondem apenas à frase vista do oceano. Você pode se surpreender que as pontuações de relevância dos documentos 2 e 3 sejam diferentes, mesmo que correspondam à consulta da mesma maneira. Isso ocorre porque a fórmula de pontuação tem mais componentes do que apenas TF/IDF. Nesse caso, o documento 3 recebeu uma pontuação ligeiramente maior porque sua descrição é mais curta. Saiba mais sobre a Fórmula de Pontuação Prática da Lucene para entender como o comprimento do campo e outros fatores podem influenciar a pontuação de relevância.
Alguns tipos de consulta (curinga, prefixo e regex) sempre contribuem com uma pontuação constante para a pontuação geral do documento. Isso permite que as correspondências encontradas por meio da expansão da consulta sejam incluídas nos resultados sem afetar a classificação.
Um exemplo ilustra por que isso importa. Pesquisas curinga, incluindo pesquisas de prefixo, são ambíguas por definição porque a entrada é uma cadeia de caracteres parcial com possíveis correspondências em um número muito grande de termos diferentes. Considere uma entrada de "tour*", com correspondências encontradas em "tours", "tourettes" e "tourmaline". Dada a natureza desses resultados, não há como inferir razoavelmente quais termos são mais valiosos do que outros. Por esse motivo, ignoramos as frequências de termos ao pontuar resultados em consultas de tipos curinga, prefixo e regex. Em uma solicitação de pesquisa de várias partes que inclui termos parciais e completos, os resultados da entrada parcial são incorporados com uma pontuação de constante para evitar desvios em relação às correspondências potencialmente inesperadas.
Ajuste de relevância
Há duas maneiras de ajustar pontuações de relevância em Pesquisa de IA do Azure :
Perfis de pontuação promovem documentos na lista classificada de resultados com base em um conjunto de regras. Em nosso exemplo, poderíamos considerar documentos que corresponderam ao campo de título mais relevantes do que os documentos correspondentes no campo de descrição. Além disso, se nosso índice tivesse um campo de preço para cada hotel, poderíamos promover documentos com preços mais baixos. Saiba mais sobre como adicionar perfis de pontuação a um índice de pesquisa.
Reforço de termo (disponível apenas na sintaxe de consulta Lucene completa) fornece um operador de reforço
^que pode ser aplicado a qualquer parte da árvore de consulta. Em nosso exemplo, em vez de pesquisar pelo prefixo ar-condicionado*, é possível procurar pelo termo exato ar-condicionado ou pelo prefixo, mas os documentos que correspondem ao termo exato são classificados mais alto ao aplicar aumento à consulta do termo: ar-condicionado^2||ar-condicionado*. Saiba mais sobre incremento do termo em uma consulta.
Pontuação em um índice distribuído
Todos os índices em Pesquisa de IA do Azure são divididos automaticamente em vários fragmentos, permitindo distribuir rapidamente o índice entre vários nós durante a escala vertical ou horizontal do serviço. Quando uma solicitação de pesquisa é emitida, ela é emitida em relação a cada fragmento de forma independente. Os resultados de cada fragmento são então mesclados e ordenados por pontuação (se nenhuma outra ordem for definida). É importante saber que a função de pontuação faz a ponderação da frequência do termo de consulta em relação a sua frequência de documento inversa em todos os documentos dentro do fragmento, não em todos os fragmentos!
Isso significa que uma pontuação de relevância poderá ser diferente para documentos idênticos se residirem em fragmentos diferentes. Felizmente, essas diferenças tendem a desaparecer à medida que o número de documentos no índice aumenta devido à distribuição de termos mais uniformes. Não é possível supor em qual fragmento um determinado documento será colocado. No entanto, supondo que uma chave de documento não seja alterada, ela sempre será atribuída ao mesmo fragmento.
Em geral, a pontuação de documentos não é o melhor atributo para classificar documentos se a estabilidade da classificação for importante. Por exemplo, dados dois documentos com uma pontuação idêntica, não há garantia de que um apareça primeiro em ordenações subsequentes da mesma consulta. A pontuação do documento só deve dar uma noção geral da relevância do documento em relação a outros documentos no conjunto de resultados.
Conclusão
O sucesso dos mecanismos de pesquisa comerciais aumentou as expectativas de pesquisa de texto completo sobre dados privados. Para quase qualquer tipo de experiência de pesquisa, agora esperamos que o mecanismo entenda nossa intenção, mesmo quando os termos estiverem incorretos ou incompletos. Podemos até esperar correspondências com base em termos ou sinônimos quase equivalentes que nunca especificamos.
Do ponto de vista técnico, a pesquisa de texto completo é altamente complexa, exigindo uma análise linguística sofisticada e uma abordagem sistemática para o processamento de maneiras que destilam, expandem e transformam termos de consulta para fornecer um resultado relevante. Dadas as complexidades inerentes, há muitos fatores que podem afetar o resultado de uma consulta. Por esse motivo, investir tempo para entender a mecânica da pesquisa de texto completo oferece benefícios tangíveis ao tentar trabalhar com resultados inesperados.
Este artigo explorou a pesquisa de texto completo no contexto de Pesquisa de IA do Azure . Esperamos que ele lhe dê plano de fundo suficiente para reconhecer possíveis causas e resoluções para resolver problemas comuns de consulta.
Próximas etapas
Crie o índice de exemplo, experimente consultas diferentes e examine os resultados. Para obter instruções, consulte Build e consulte um índice no portal Azure.
Experimente outra sintaxe de consulta da seção de exemplo Search Documents ou da sintaxe de consulta Simple query syntax no Search explorer do portal Azure.
Examine os perfis de pontuação se você quiser ajustar a classificação em seu aplicativo de pesquisa.
Configure analisadores personalizados para processamento mínimo ou processamento especializado em campos específicos.