Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Nota
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
Importante
Recursos, funcionalidades ou propriedades marcados como (versão prévia) não são cobertos por um contrato de nível de serviço (SLA), não são recomendados para cargas de trabalho de produção e podem mudar ou ser restringidos antes da disponibilidade geral. Os termos de visualização do Pesquisa de IA do Azure se aplicam a toda funcionalidade em visualização, seja autônoma ou parte de um recurso de disponibilidade geral.
No Pesquisa de IA do Azure, a recuperação por meio de agentes é um pipeline de várias consultas projetado para perguntas complexas feitas por usuários ou agentes em aplicativos de chat e Copilot. Destina-se a padrões de geração aumentada de recuperação (RAG) e fluxos de trabalho de agente para agente.
Veja como a busca orientada por agentes funciona:
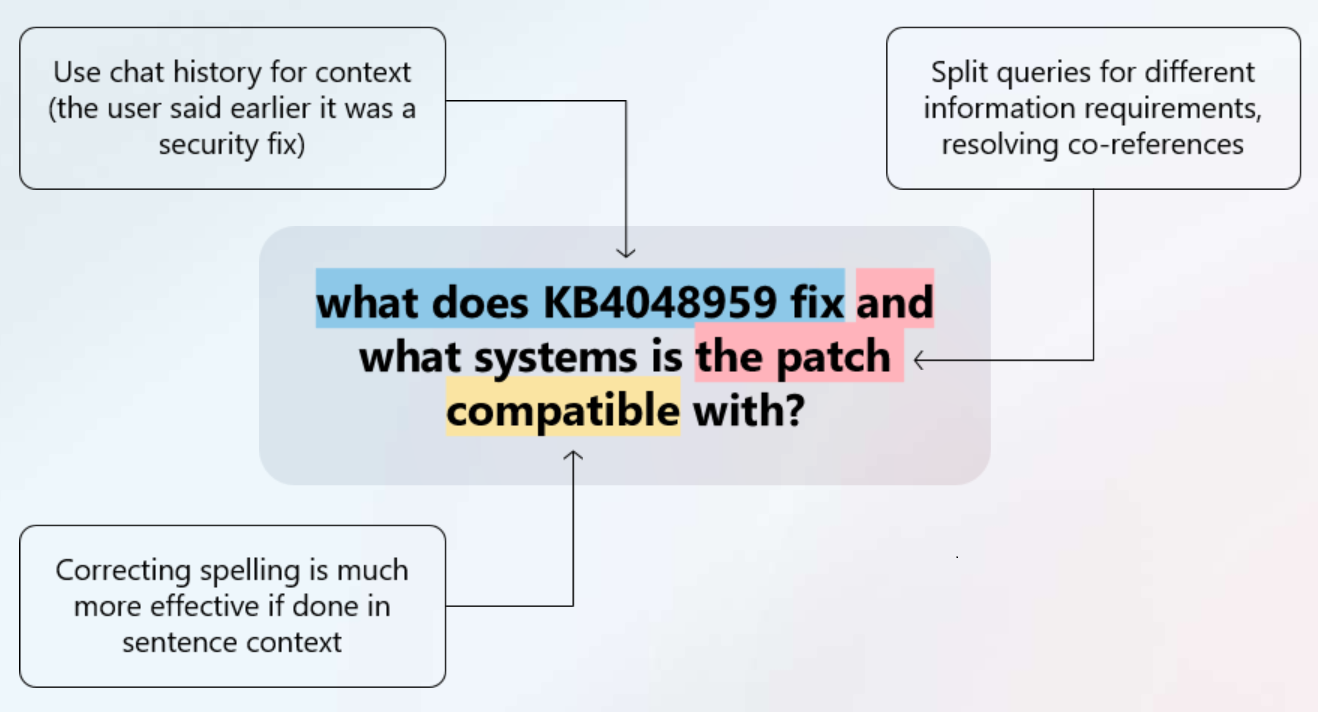
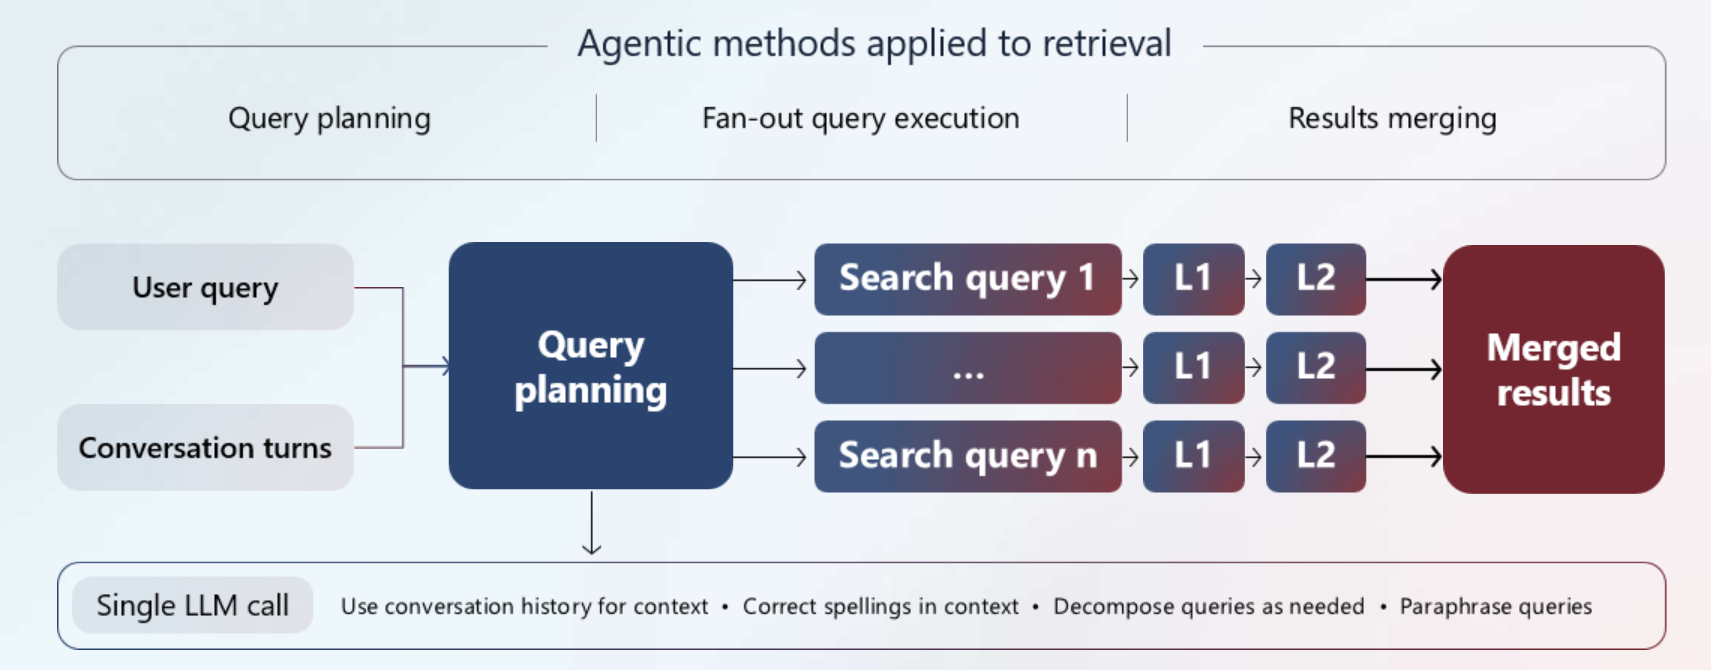
Pode usar o planejamento de consulta baseado em LLM (versão prévia) para dividir uma consulta complexa em subconsultas menores e focadas para uma melhor cobertura em conteúdo proprietário e externo. O planejamento de consultas pode usar o histórico de chat para contexto adicional.
Executa subconsultas em paralelo. Cada subconsulta é reclassificada semanticamente para promover as correspondências mais relevantes.
Combina os melhores resultados em uma resposta unificada que um LLM pode usar para gerar respostas fundamentadas.
Pode retornar referências de origem e um log de atividades juntamente com o conteúdo mesclado, para que você possa usar apenas os dados de fundamentação ou passá-los para um LLM para obter uma resposta completa.
Esse pipeline de alto desempenho ajuda você a gerar dados de embasamento de alta qualidade ou respostas para o seu aplicativo de chat e permite responder rapidamente a perguntas complexas.
Por que usar recuperação agêntica?
A recuperação por meio de agentes oferece suporte a experiências gerenciadas e personalizadas para agentes e aplicativos. No portal do Microsoft Foundry, ele fornece o IQ do Foundry como uma camada de conhecimento gerenciada para agentes. Você também pode criar soluções de recuperação agente personalizadas usando o portal Azure, a API REST do Serviço de Pesquisa ou um SDK do Azure com suporte.
Use a recuperação agêntica quando quiser fornecer a agentes e aplicativos o conteúdo mais relevante para responder a perguntas mais difíceis, com base no contexto do chat, no seu conteúdo proprietário e em fontes externas.
A recuperação por meio de agentes adiciona latência em comparação com um pipeline de consulta única, mas dá conta da complexidade de consultas que uma consulta única não consegue lidar. Por exemplo, ele pode lidar com:
Perguntas com múltiplas solicitações, como "encontre para mim um hotel perto da praia, com traslado do aeroporto e que fique a uma distância que dê para ir a pé de restaurantes vegetarianos."
Perguntas que dependem do contexto anterior na conversa.
Consultas que se beneficiam da reformulação, usando mapas de sinônimos e paráfrases geradas por LLM para ampliar a cobertura em todo o seu conteúdo.
Erros de ortografia.
Arquitetura e fluxo de trabalho
O processo de recuperação agêntico funciona da seguinte maneira:
Iniciação do fluxo de trabalho: Seu aplicativo chama uma base de dados de conhecimento com uma ação de recuperação que fornece uma consulta e histórico de conversas.
Planejamento de consulta: Nos níveis
lowemediumde esforço de raciocínio de recuperação, a base de conhecimento envia sua consulta e o histórico da conversa para um LLM, que gera subconsultas direcionadas. Em esforçominimal, essa etapa é ignorada, e as consultas são emitidas diretamente para fontes de conhecimento. O esforço de raciocínio usa como padrãolowe está configurado na base de dados de conhecimento.Execução da consulta: A base de dados de conhecimento envia as subconsultas para suas fontes de conhecimento. Todas as subconsultas são executadas simultaneamente e podem ser palavras-chave, vetor ou pesquisa híbrida. Cada subconsulta passa por uma reclassificação semântica para encontrar as correspondências mais relevantes. As referências são extraídas e retidas para fins de citação.
Síntese de resultados: O sistema combina todos os resultados em uma resposta unificada. O conteúdo mesclado sempre é retornado. Referências de origem e um log de atividades de execução são opcionais.
Components
Para todos os cenários de recuperação agêntica, é necessário uma base de conhecimento e pelo menos uma fonte de conhecimento. Outros componentes são opcionais e dependem da configuração.
| Componente | Serviço | Papel |
|---|---|---|
| Base de conhecimento | Pesquisa de IA do Azure | Orquestra o pipeline, gerenciando fontes de conhecimento e parâmetros de consulta. |
| Fonte de conhecimento | Pesquisa de IA do Azure | Define o conteúdo utilizado no pipeline. Pode ser indexado (apoiado por um índice de pesquisa em seu serviço) ou remoto (conteúdo recuperado no momento da consulta de uma plataforma externa). |
| Índice de pesquisa | Pesquisa de IA do Azure | Armazena conteúdo pesquisável (texto e vetores) com uma configuração semântica. Determina quais tipos de consulta são executados e quais otimizações se aplicam. Necessário apenas para fontes de conhecimento indexadas. |
| Classificador semântico | Pesquisa de IA do Azure | Usado internamente pelo pipeline de recuperação por meio de agentes para reclassificar os resultados por relevância (reclassificação de nível 2). |
| Mestrado em Direito | OpenAI do Azure | Pode dar suporte a vários estágios da recuperação agêntica: planejar consultas e selecionar fontes de conhecimento (versão prévia), resumir resultados da Web e gerar respostas com citações por meio da síntese de respostas (versão prévia). |
Requisitos de integração
Seu aplicativo conduz o pipeline chamando a base de conhecimento e tratando a resposta. O pipeline retorna dados de fundamentação que você pode passar para um LLM para gerar respostas ou usar diretamente na sua interface de conversação. Para obter detalhes sobre a implementação, consulte Tutorial: Criar uma solução de recuperação agente de ponta a ponta.
Disponibilidade de funcionalidades
A recuperação agêntica oferece suporte a funcionalidades de disponibilidade geral e em versão prévia. Escolha a versão da API REST do Serviço de Busca que corresponda à sua experiência de recuperação agêntica:
Use a API REST do
2026-04-01para cargas de trabalho de produção que utilizam tipos de fonte de conhecimento de disponibilidade geral com recuperação extrativa mínima.Use a API REST do
2026-08-01-previewpara explorar tipos de fontes de conhecimento e recursos, como planejamento de consultas baseado em LLM, síntese de respostas, raciocínio de recuperação não minimalista e mensagens em múltiplos turnos. Consulte os termos de versão prévia do Pesquisa de IA do Azure .
O portal do Azure e o portal do Microsoft Foundry fornecem acesso somente em versão prévia a todos os recursos de recuperação agêntica. Os objetos criados em um ou outro portal podem usar esquemas em versão prévia e exigir migração ao passar para a versão da API REST disponibilizada para o público geral. Para ver um detalhamento versão por versão e orientações de migração, consulte Migrar o código de recuperação agêntica para a versão mais recente.
Disponibilidade regional, limites e cobrança
Antes de usar a recuperação agêntica, consulte sua disponibilidade regional, os limites de serviço e o modelo de cobrança.
Disponibilidade da região
A recuperação agentic está disponível em regiões selecionadas.
Limits
As fontes de conhecimento e as bases de dados de conhecimento têm limites máximos que variam de acordo com o tipo de preço e o esforço de raciocínio de recuperação.
Faturamento
A recuperação por meio de agentes incorre em cobranças de dois serviços:
A Pesquisa de IA do Azure cobra pelos tokens de recuperação consumidos durante a execução da subconsulta e a classificação semântica. O plano gratuito (padrão) fornece uma cota mensal de tokens. O plano padrão permite o pagamento conforme o uso após o consumo da franquia gratuita. Para obter mais informações, consulte Habilitar ou desabilitar a cobrança de recuperação por meio de agentes.
Azure OpenAI cobra por tokens de entrada e saída usados no planejamento de consultas baseado em LLM e na síntese de respostas (versão prévia). O preço é sempre pago conforme o uso e baseado no modelo que você atribui à base de conhecimento. As cobranças aparecem na sua fatura do Azure OpenAI. Para ver os preços, consulte preços do Azure OpenAI.
A tabela a seguir compara a cobrança entre o pipeline clássico de consulta única e o pipeline de recuperação por meio de agentes com várias consultas. No pipeline clássico, o componente faturável é o classificador semântico.
| Aspecto | Pipeline clássico | Recuperação com agentes |
|---|---|---|
| Unidade | Com base na consulta | Baseado em token |
| Custo por unidade | Custo uniforme por consulta | Custo variável por token (depende do esforço de raciocínio) |
| Estimativa de custo | Estimar contagem de consultas | Estimar o uso do token |
| Subsídio gratuito | Subsídio mensal de consulta gratuita | Cota mensal de tokens gratuitos |
Exemplo: estimar custos
Este exemplo ajuda a ilustrar o processo de estimativa de custo para planejamento e execução de consultas, mas não a síntese de resposta. Seus custos podem ser menores. Para obter as taxas atuais, consulte os preços do Pesquisa de IA do Azure e do Azure OpenAI.
Para estimar os custos do plano de consulta no modelo pago conforme o uso no OpenAI do Azure, vamos considerar o gpt-4o-mini:
- 15 centavos por 1 milhão de tokens de entrada.
- 60 centavos por 1 milhão de tokens de saída.
- 2.000 tokens de entrada para o tamanho médio da conversa de chat.
- 350 tokens para um tamanho médio de plano de saída.
Custos estimados de cobrança para execução da consulta
Para estimar as contagens de tokens de recuperação por meio de agentes, comece com uma ideia de como é um documento médio em seu índice. Por exemplo, você pode estimar:
- 10.000 partes, em que cada parte é de um a dois parágrafos de um PDF.
- 500 tokens por bloco.
- Cada subconsulta reclassifica até 50 fragmentos.
- Em média, há três subconsultas por plano de consulta.
Calculando o preço da execução
Suponha que façamos 2.000 recuperações de agentes com três subconsultas por plano. Isso nos dá cerca de 6.000 consultas totais.
Reordenar 50 blocos por subconsulta, o que totaliza 300.000 blocos.
O bloco médio é de 500 tokens, portanto, o total de tokens para o processo de reranqueamento é de 150 milhões.
Dado um preço hipotético de 0,022 por token, US$ 3,30 é o custo total para a reclassificação em dólares americanos.
Passando para os custos do plano de consulta: 2.000 tokens de entrada multiplicados por 2.000 recuperações de agentes resultam em 4 milhões de tokens de entrada, totalizando 60 centavos.
Estime os custos de saída com base em uma média de 350 tokens. Se multiplicarmos 350 por 2.000 recuperações de agentes, obtemos um total de 700.000 tokens de saída, totalizando 42 centavos.
Juntando tudo isso, você pagaria cerca de US$ 3,30 pela recuperação agêntica em Pesquisa de IA do Azure , 60 centavos por tokens de entrada em Azure OpenAI e 42 centavos por tokens de saída em Azure OpenAI, totalizando US$ 1,02 para o planejamento de consultas. O custo combinado para a execução completa é de US$ 4,32.
Dicas para controlar os custos
Examine o log de atividades na resposta para descobrir quais consultas foram emitidas para quais fontes e parâmetros foram usados. Você pode reemissar essas consultas em relação aos índices e usar um tokenizador público para estimar tokens e comparar com o uso relatado pela API. No entanto, a reconstrução precisa de uma consulta ou resposta não é garantida. Os fatores incluem o tipo de fonte de conhecimento, como dados da Web públicos ou uma fonte de conhecimento de SharePoint remota que se baseia em uma identidade de usuário, o que pode afetar a reprodução da consulta.
Reduzir o número de fontes de conhecimento (índices); consolidar o conteúdo pode reduzir o fan-out e o volume de tokens.
Reduza o esforço de raciocínio para diminuir o uso do LLM durante o planejamento e a expansão de consultas (busca iterativa).
Organize o conteúdo para que as informações mais relevantes possam ser encontradas com menos fontes e documentos (por exemplo, resumos ou tabelas coletados).
Como começar
Para criar uma solução de recuperação agente, você pode usar o portal Azure, o portal Microsoft Foundry (novo), as APIs REST ou um pacote SDK do Azure equivalente.
- Guia de Início Rápido: recuperação por meio de agentes no portal do Azure
- Quickstart: recuperação agentica (C#, Java, JavaScript, Python, TypeScript, REST)