Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Note
Foundry IQ (Wyszukiwanie AI platformy Azure) udostępnia bezpośrednie interfejsy API indeksowania i zapytań, a także interfejsy API wyższego poziomu dla źródeł wiedzy i baz wiedzy do zarządzanego pobierania. Użyj portalu Azure, interfejsów API REST lub Azure SDKs, aby skonfigurować te funkcje lub połączyć agentów z bazami wiedzy w portalu Microsoft Foundry.
Informacje o terminach stosowanych podczas nawiązywania połączenia z zewnętrznymi źródłami danych znajdziesz w sekcji Zewnętrzne źródła danych.
Indeksator plików OneLake importuje zawartość i metadane z usługi Lakehouse w Microsoft OneLake i sprawia, że zawartość jest wyszukiwana w usłudze Foundry IQ (Wyszukiwanie AI platformy Azure).
Aby skonfigurować i uruchomić indeksator, możesz użyć:
- Interfejs API REST źródła danych z interfejsem API REST indeksatora
- Pakiet Azure SDK, który udostępnia funkcję
- Kreator importu danychw portalu Azure.
W tym artykule użyto interfejsów API REST do zilustrowania poszczególnych kroków.
Aby zachować uprawnienia źródła, zobacz Zachowywanie uprawnień usługi OneLake. Poniższe przykłady umożliwiają skonfigurowanie pozyskiwania bez uprawnień na poziomie dokumentu.
Wymagania wstępne
Przestrzeń robocza Fabric. Skorzystaj z tego samouczka, aby utworzyć obszar roboczy Fabric.
Jezioro w obszarze roboczym Fabric. Wykonaj czynności opisane w tym samouczku, aby utworzyć jezioro.
Dane tekstowe. Jeśli masz dane binarne, możesz użyć analizy obrazów wzbogacania przez sztuczną inteligencję, aby wyodrębnić tekst lub wygenerować opisy obrazów. Zawartość pliku nie może przekroczyć limitów indeksatora dla warstwy usługi IQ rozwiązania Foundry.
Przetwarzanie plików źródłowych i wzbogacanie sztucznej inteligencji mają oddzielne limity. Kolejna umiejętność lub usługa zewnętrzna może akceptować mniej danych, niż indeksator wyodrębnia, dlatego sprawdź artykuł referencyjny dla każdej umiejętności w zestawie umiejętności.
Zawartość nieustrukturyzowana w lokalizacji Pliki w twoim lakehouse. Dane można dodawać, wykonując następujące czynności:
- Przekaż bezpośrednio do magazynu lakehouse
- Użyj potoków danych z Microsoft Fabric
- Dodaj skróty z zewnętrznych źródeł danych, takich jak Amazon S3 lub Google Cloud Storage.
Usługa Foundry IQ, warstwa cenowa Basic lub wyższa, skonfigurowana do używania tożsamości zarządzanej przez system albo tożsamości zarządzanej przypisanej przez użytkownika. Usługa Foundry IQ musi znajdować się w tym samym dzierżawcy co obszar roboczy Microsoft Fabric.
Przypisanie roli Administrator lub Współautor w obszarze roboczym Microsoft Fabric, w którym znajduje się jezioro. Kroki opisano w sekcji Udzielanie uprawnień w tym artykule.
Zezwalaj dostęp na dane usługi OneLake z aplikacji spoza środowiska Fabric.
Klient REST do formułowania wywołań REST podobnych do tych przedstawionych w tym artykule.
Ograniczenia
Typy plików Parquet (w tym Delta Parquet) nie są obecnie obsługiwane.
Usuwanie plików nie jest obsługiwane w przypadku skrótów amazon S3 i Google Cloud Storage.
Ten indeksator nie obsługuje zawartości lokalizacji tabel w obszarze roboczym OneLake.
Ten indeksator nie obsługuje zapytań SQL. Parametr
queryw konfiguracji źródła danych określa tylko opcjonalny folder lub skrót do indeksu.Nie istnieje możliwość pozyskiwania plików z obszaru Mój obszar roboczy w usłudze OneLake, ponieważ jest to repozytorium osobiste dla użytkownika.
Indeksowanie plików przedmiotów Fabric z etykietami poufności, takich jak lakehouses, nie jest obsługiwane. Jeśli jednak etykiety poufności są stosowane bezpośrednio do poszczególnych dokumentów, przetwarzanie chronionej zawartości i skojarzonych etykiet jest obsługiwane. W takich przypadkach usługa Foundry IQ może wyodrębniać i honorować etykiety poufności oraz zawartość dokumentów oznaczonych etykietami za pomocą integracji z usługą Purview (wersja zapoznawcza).
Uprawnienia oparte na rolach obszaru roboczego w usłudze Microsoft OneLake mogą mieć wpływ na dostęp indeksatora do plików. Udziel jednostce usługi Foundry IQ (tożsamości zarządzanej) dostępu do plików, które zamierzasz indeksować w docelowym obszarze roboczym Microsoft Fabric.
Obsługiwane zadania
Tego indeksatora można używać do wykonywania następujących zadań:
- Indeksowanie danych i indeksowanie przyrostowe: Indeksator może indeksować pliki i skojarzone metadane ze ścieżek danych w usłudze Lakehouse. Wykrywa nowe i zaktualizowane pliki i metadane za pomocą wbudowanego wykrywania zmian. Odświeżanie danych można skonfigurować zgodnie z harmonogramem lub na żądanie.
- Wykrywanie usuwania: Indeksator może wykrywać usunięcia za pomocą niestandardowych metadanych dla większości plików i skrótów. Wymaga to dodania metadanych do plików w celu oznaczenia, że zostały one "usunięte nietrwale", co umożliwia usunięcie ich z indeksu wyszukiwania. Obecnie nie można wykryć usunięcia w usłudze Google Cloud Storage lub plikach skrótów Amazon S3, ponieważ niestandardowe metadane nie są obsługiwane dla tych źródeł danych.
- Zastosowanie wzbogacania sztucznej inteligencji za pomocą zestawów umiejętności:zestawy umiejętności są w pełni obsługiwane przez indeksator plików OneLake. Obejmuje to kluczowe funkcje, takie jak wektoryzacja zintegrowana , które dodają kroki fragmentowania i osadzania danych.
- Tryby analizowania: Indeksator obsługuje tryby analizowania w formacie JSON, jeśli chcesz przeanalizować tablice JSON lub wiersze na oddzielne dokumenty wyszukiwania. Obsługuje również tryb analizowania języka Markdown.
- Zgodność z innymi funkcjami: Indeksator OneLake obsługuje funkcje, takie jak sesje debugowania, pamięć podręczna indeksatora na potrzeby wzbogacania przyrostowego (wersja zapoznawcza) i magazyn wiedzy. Aby uzyskać informacje o ograniczeniach pozyskiwania uprawnień, zobacz Ograniczenia uprawnień usługi OneLake.
Obsługiwane formaty dokumentów
Indeksator plików OneLake może wyodrębnić tekst z następujących formatów dokumentów:
- CSV (zobacz Indeksowanie obiektów blob CSV)
- EML
- EPUB
- GZ
- HTML
- JSON (zobacz Indeksowanie obiektów blob JSON)
- KML (XML dla reprezentacji geograficznych)
- Markdown
- formaty Microsoft Office: DOCX/DOC/DOCM, XLSX/XLS/XLSM, PPTX/PPT/PPTM, MSG (Outlook wiadomości e-mail), XML (zarówno 2003, jak i 2006 WORD XML)
- Otwieranie formatów dokumentów: ODT, ODS, ODP
- Pliki zwykłego tekstu (zobacz też Indeksowanie zwykłego tekstu)
- RTF
- XML
- ZIP
Obsługiwane skróty
Zawartość skrótu nie jest uwzględniana w wyszukiwaniu uwzględniającym uprawnienia.
Następujące skróty OneLake są obsługiwane przez indeksator plików OneLake:
Skrót OneLake (skrót do innego wystąpienia OneLake)
Ważne
Niepowodzenie spełnienia któregokolwiek z wymagań wstępnych lub próba wykonania operacji objętej udokumentowanymi ograniczeniami spowoduje błędy podczas wyświetlania listy elementów w lakehouse.
Przygotowywanie danych do indeksowania
Przed skonfigurowaniem indeksowania przejrzyj dane źródłowe, aby określić, czy musisz wprowadzić jakiekolwiek zmiany w danych w Lakehouse. Indeksator może indeksować zawartość z jednego kontenera (lakehouse) jednocześnie. Domyślnie indeksator przetwarza wszystkie pliki w lakehouse. Aby przetwarzać pliki bardziej selektywnie, rozważ następujące opcje:
Umieść pliki w folderze wirtualnym. Definicja źródła danych indeksatora zawiera parametr "query", który może być podfolderem typu lakehouse lub skrótem. Jeśli ta wartość jest określona, indeksowane są tylko te pliki w podfolderze lub skrót w obiekcie lakehouse.
Dołączanie lub wykluczanie plików według typu pliku. Lista obsługiwanych formatów dokumentów może pomóc w ustaleniu, które pliki mają zostać wykluczone. Możesz na przykład wykluczyć pliki obrazów lub audio, które nie udostępniają tekstu z możliwością wyszukiwania. Ta funkcja jest kontrolowana za pomocą ustawień konfiguracji w indeksatorze.
Dołączanie lub wykluczanie dowolnych plików. Jeśli chcesz pominąć określony plik z dowolnego powodu, możesz dodawać właściwości i wartości metadanych do plików w lakehouse. Gdy indeksator napotka tę właściwość, pomija plik lub jego zawartość w przebiegu indeksowania.
Dołączanie i wykluczanie plików są omówione w kroku konfiguracji indeksatora . Jeśli nie ustawisz kryteriów, indeksator zgłasza niekwalifikowany plik jako błąd i przechodzi dalej. Jeśli wystąpi wystarczająca liczba błędów, przetwarzanie może zostać zatrzymane. Tolerancja błędów można określić w ustawieniach konfiguracji indeksatora.
Indeksator zazwyczaj tworzy jeden dokument wyszukiwania na plik, w którym zawartość tekstowa i metadane są przechwytywane jako pola z możliwością wyszukiwania w indeksie. Jeśli pliki są całymi plikami, możesz je potencjalnie przeanalizować w wielu dokumentach wyszukiwania. Można na przykład przeanalizować wiersze w pliku CSV , aby utworzyć jeden dokument wyszukiwania dla każdego wiersza. Jeśli musisz podzielić pojedynczy dokument na mniejsze fragmenty, aby wektoryzować dane, rozważ użycie wektoryzacji zintegrowanej.
Metadane pliku indeksowania
Metadane plików mogą być również indeksowane i jest to przydatne, jeśli uważasz, że dowolne ze standardowych lub niestandardowych właściwości metadanych jest przydatne w filtrach i zapytaniach.
Właściwości metadanych określonych przez użytkownika są wyodrębniane dosłownie. Aby otrzymywać wartości, należy zdefiniować pole w indeksie wyszukiwania typu Edm.String, o takiej samej nazwie jak klucz metadanych obiektu blob. Jeśli na przykład obiekt blob ma klucz metadanych o Priority wartości High, należy zdefiniować pole o nazwie Priority w indeksie wyszukiwania i zostanie wypełnione wartością High.
Standardowe metadane pliku można wyodrębnić do pól o podobnych nazwach i typach danych, jak pokazano poniżej. Indeksator plików OneLake automatycznie tworzy wewnętrzne mapowania pól dla tych właściwości metadanych, konwertując oryginalną nazwę z łącznikiem ("metadata-storage-name") na odpowiednik z podkreślnikiem ("metadata_storage_name").
Nadal musisz dodać pola podkreślone do definicji indeksu, ale można pominąć mapowania pól indeksatora, ponieważ indeksator automatycznie tworzy skojarzenie.
metadata_storage_name (
Edm.String) — nazwa pliku. Jeśli na przykład masz plik /mydatalake/my-folder/subfolder/resume.pdf, wartość tego pola toresume.pdf.metadata_storage_path (
Edm.String) — pełny identyfikator URI obiektu blob, w tym nazwę konta magazynu. Na przykład:https://myaccount.blob.core.windows.net/my-container/my-folder/subfolder/resume.pdfmetadata_storage_content_type (
Edm.String) — typ zawartości określony przez kod użyty do przesłania obiektu blob. Na przykładapplication/octet-stream.metadata_storage_last_modified (
Edm.DateTimeOffset) — znacznik czasu ostatniej modyfikacji obiektu blob. Foundry IQ używa tego znacznika czasu do identyfikowania zmienionych obiektów blob, aby uniknąć ponownego indeksowania wszystkiego po początkowym indeksowaniu.metadata_storage_size (
Edm.Int64) — rozmiar obiektu blob w bajtach.metadata_storage_content_md5 (
Edm.String) — skrót MD5 zawartości obiektu blob, jeśli jest dostępny.
Na koniec wszystkie właściwości metadanych specyficzne dla formatu dokumentu plików indeksowania mogą być również reprezentowane w schemacie indeksu. Aby uzyskać więcej informacji na temat metadanych specyficznych dla zawartości, zobacz Właściwości metadanych zawartości.
Ważne jest, aby podkreślić, że nie musisz definiować pól dla wszystkich powyższych właściwości w indeksie wyszukiwania — po prostu przechwyć właściwości potrzebne dla aplikacji.
Udzielanie uprawnień
Indeksator OneLake używa uwierzytelniania tokenu i dostępu opartego na rolach dla połączeń z usługą OneLake. Uprawnienia są przypisywane w usłudze OneLake. Nie ma żadnych wymagań dotyczących uprawnień w fizycznych magazynach danych wspierających skróty. Jeśli na przykład indeksujesz z platformy AWS, nie musisz udzielać uprawnień usługi IQ usługi Foundry na platformie AWS.
Minimalnym przypisaniem roli tożsamości usługi Foundry IQ jest Współautor.
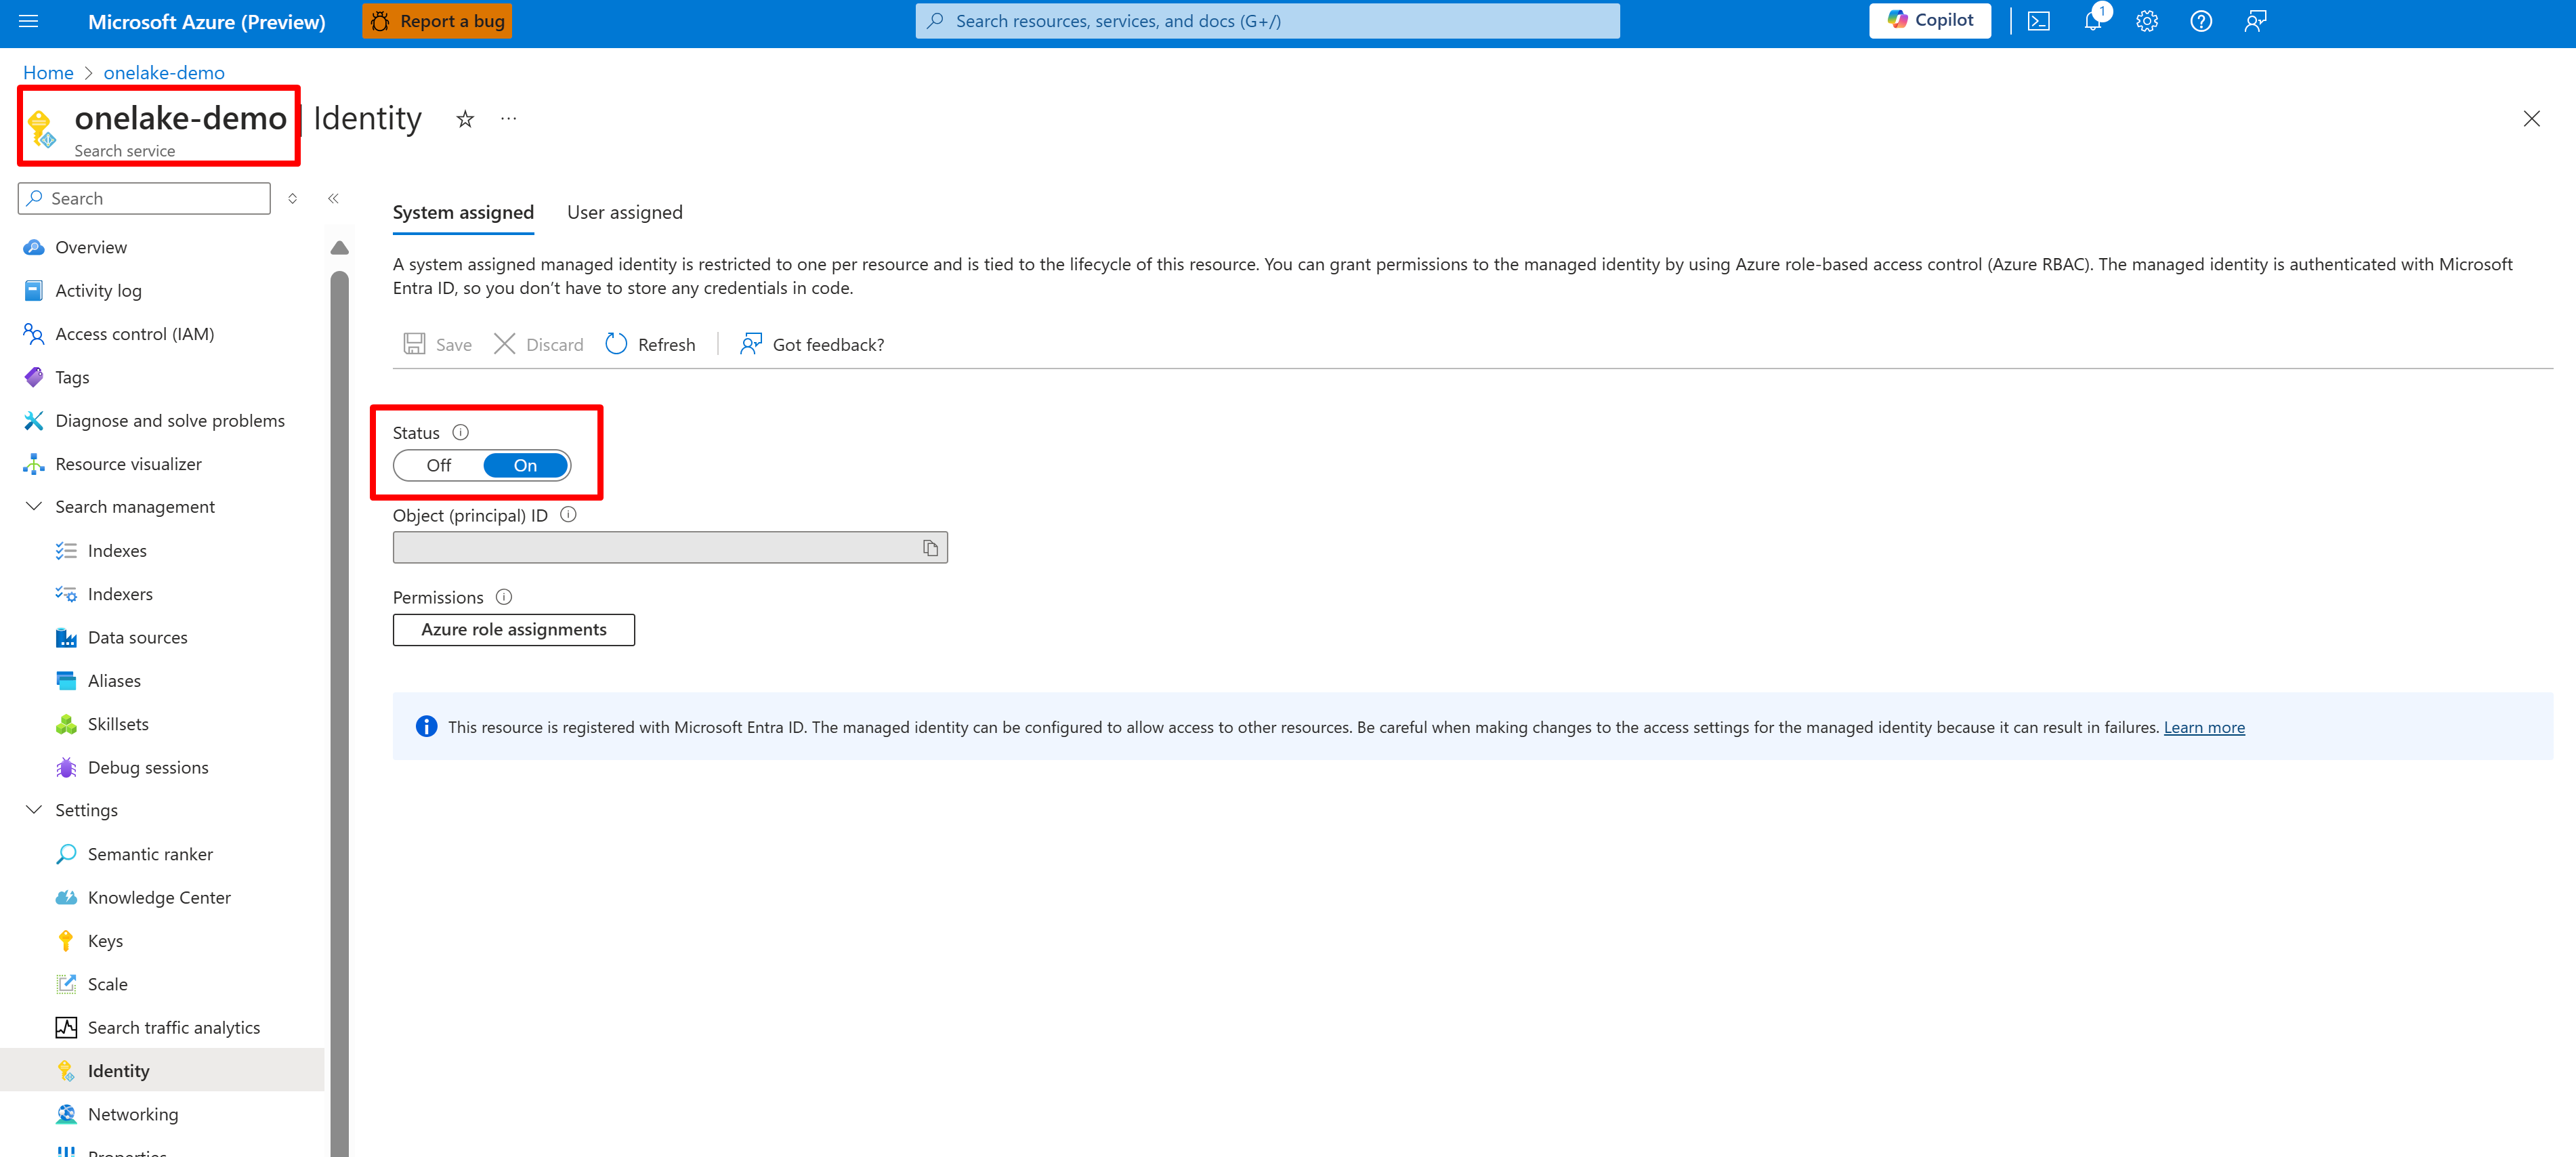
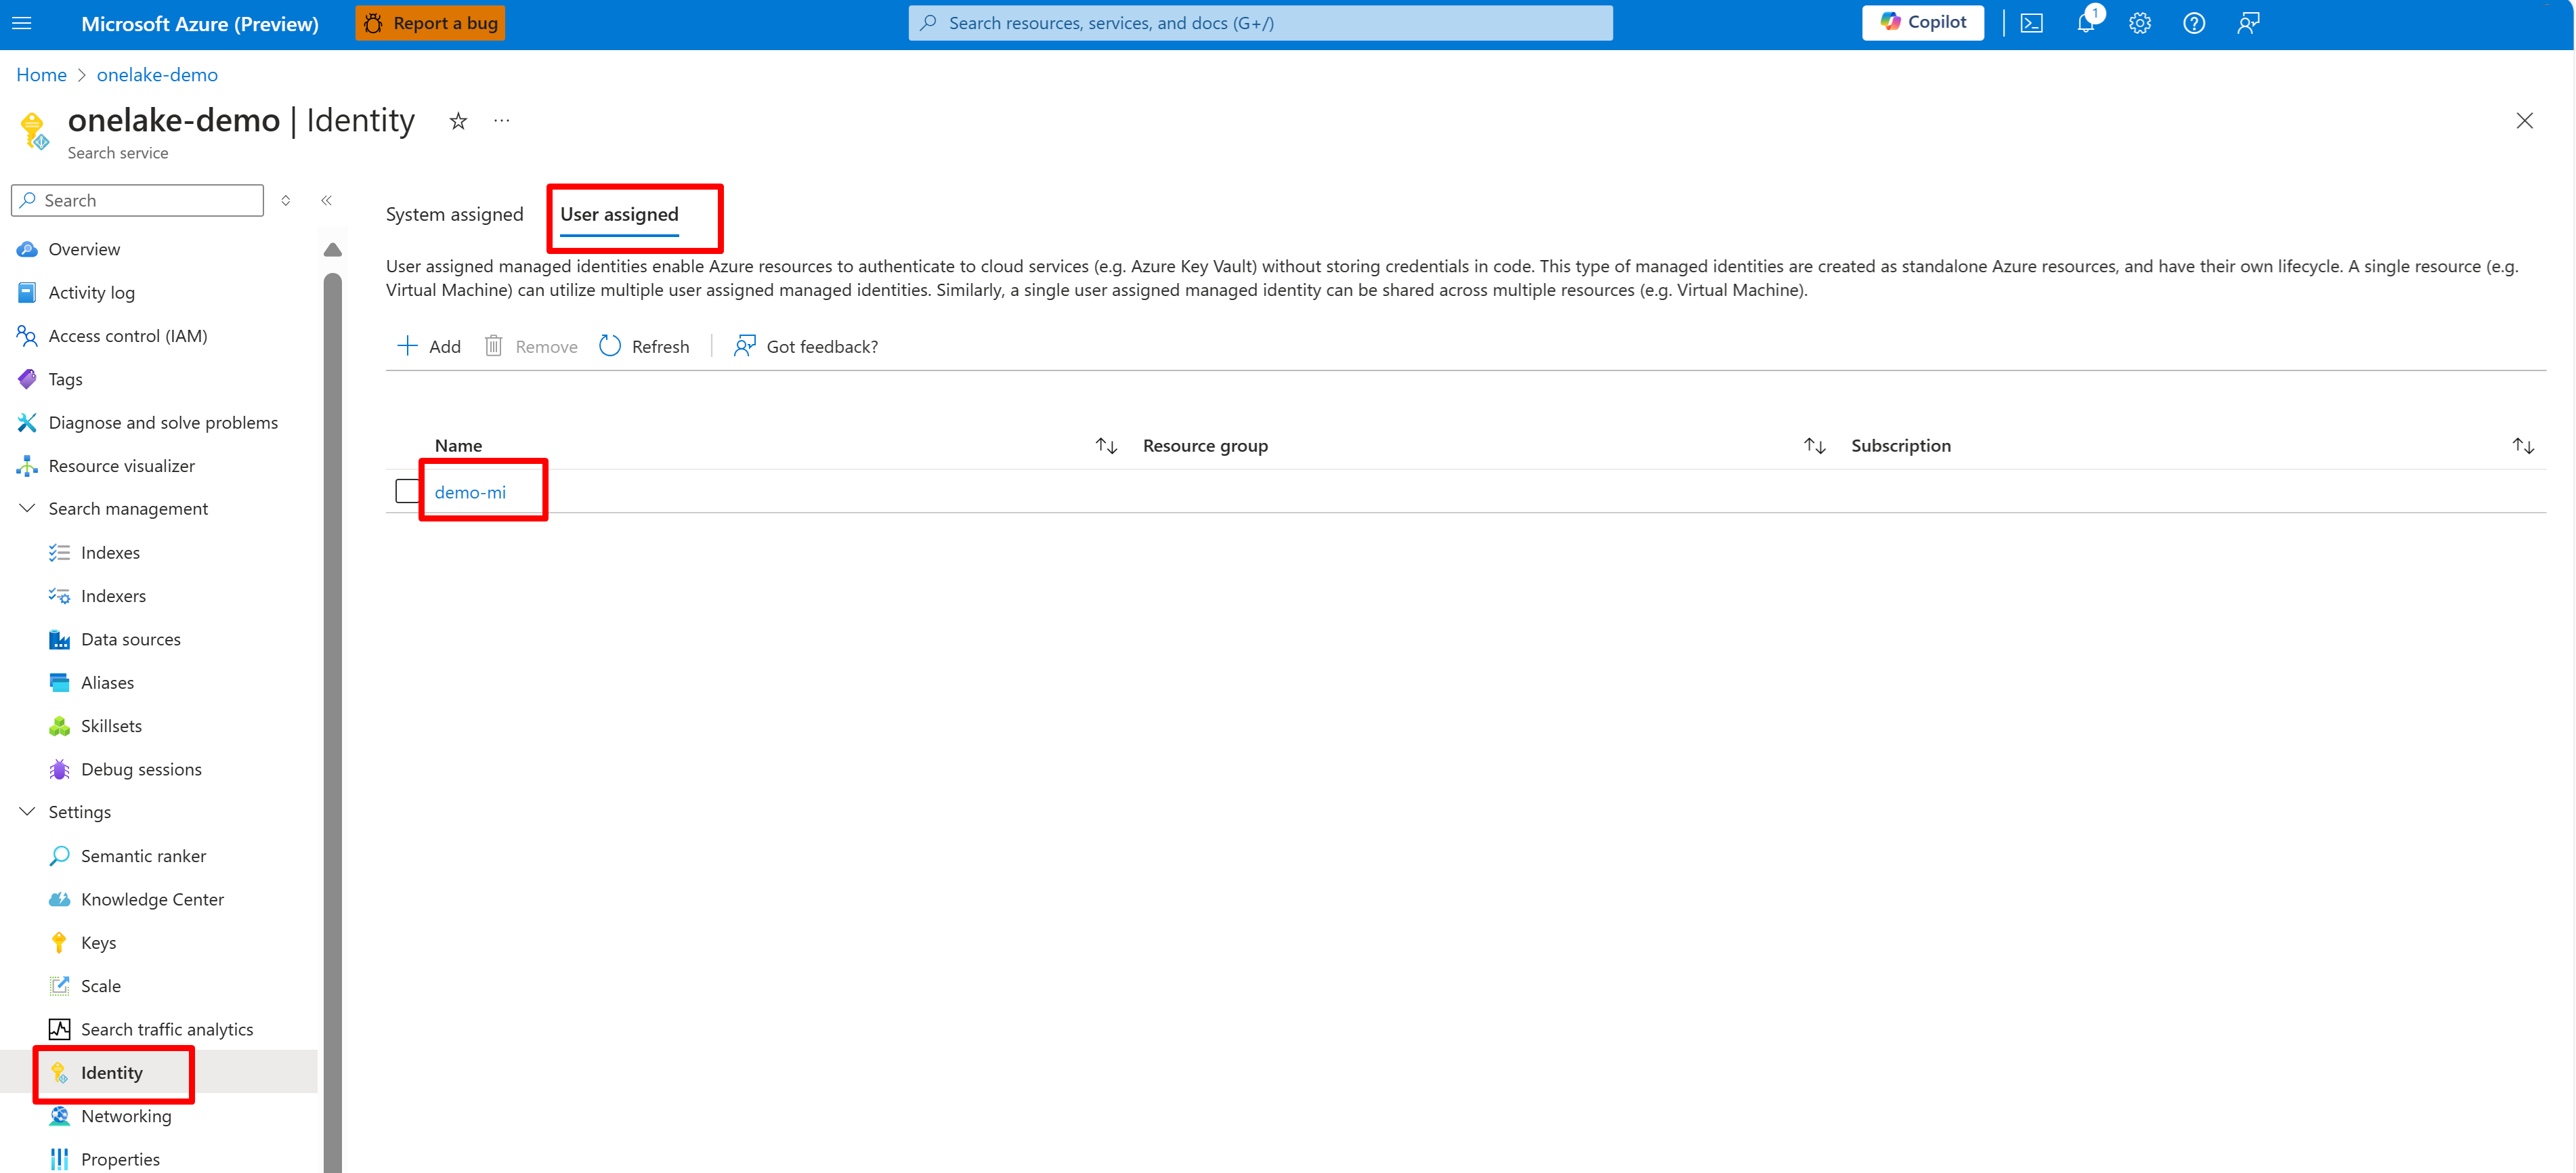
Skonfiguruj tożsamość systemową lub zarządzaną przez użytkownika dla usługi Foundry IQ.
Poniższy zrzut ekranu przedstawia tożsamość zarządzaną przez system dla usługi Foundry IQ o nazwie "onelake-demo".
Ten zrzut ekranu przedstawia tożsamość zarządzaną przez użytkownika dla tej samej usługi Foundry IQ.
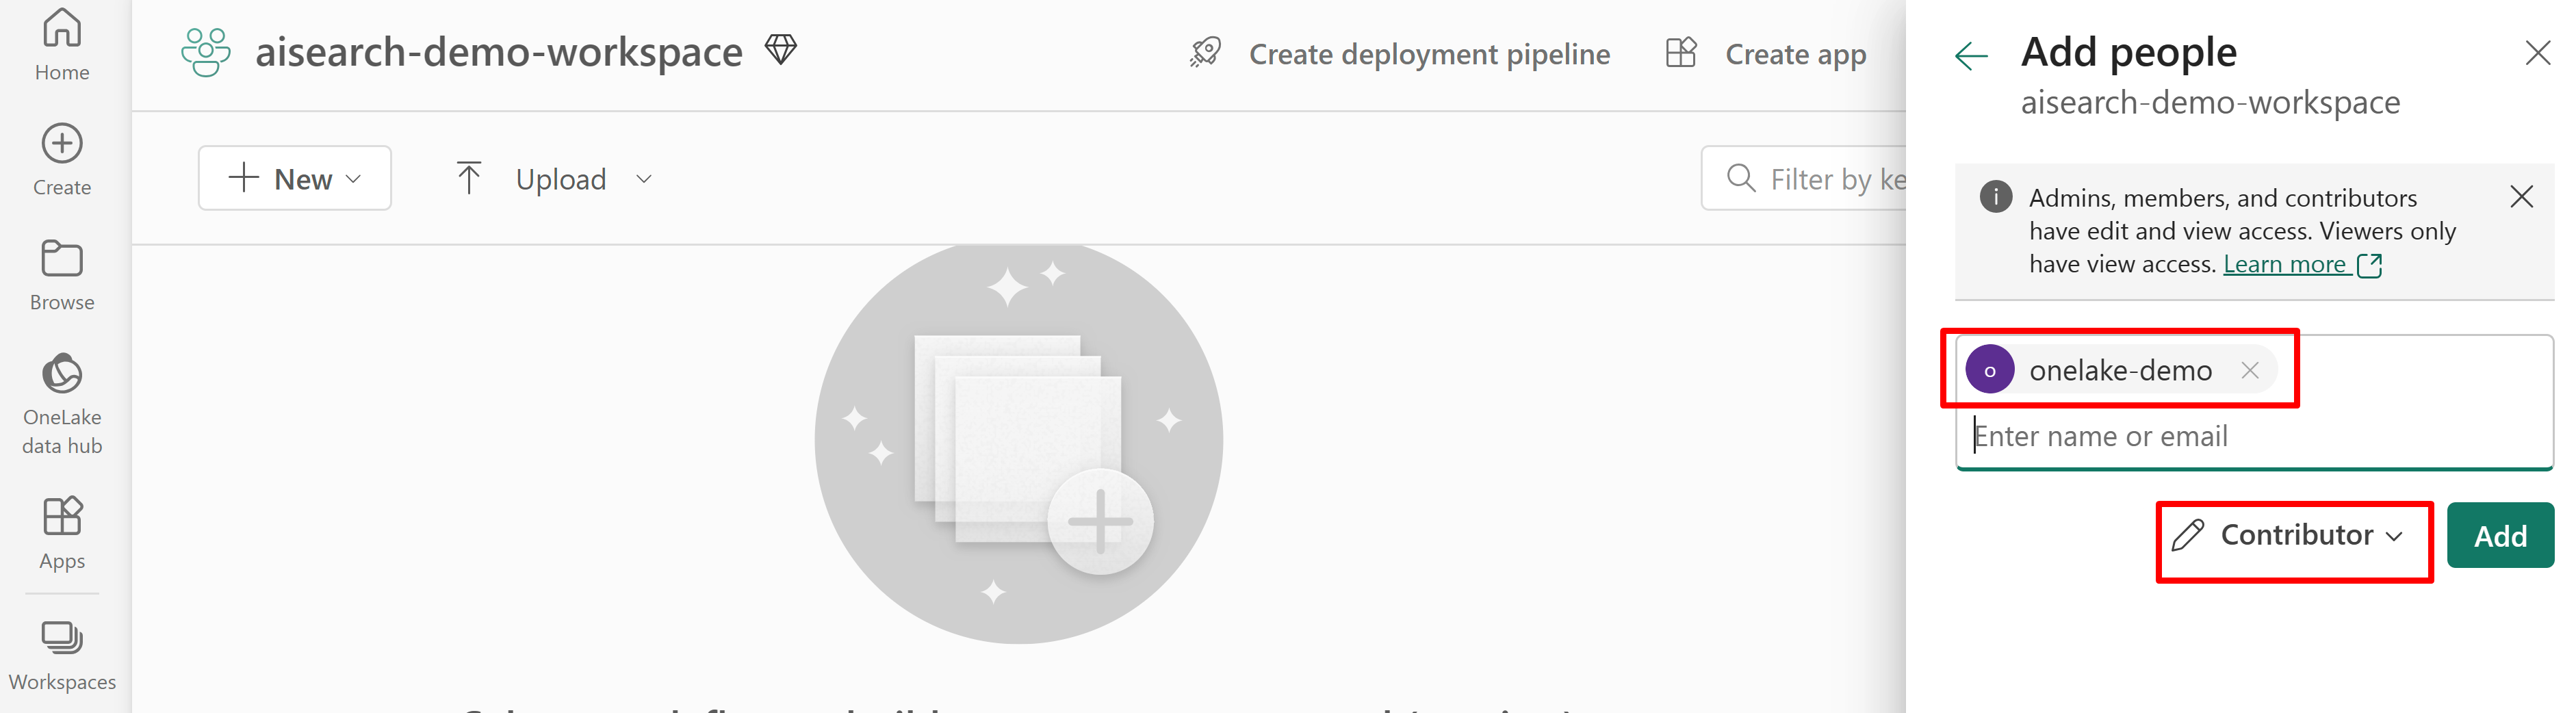
Przyznaj uprawnienie dostępu usłudze Foundry IQ do obszaru roboczego Fabric. Usługa Foundry IQ ustanawia połączenie w imieniu indeksatora.
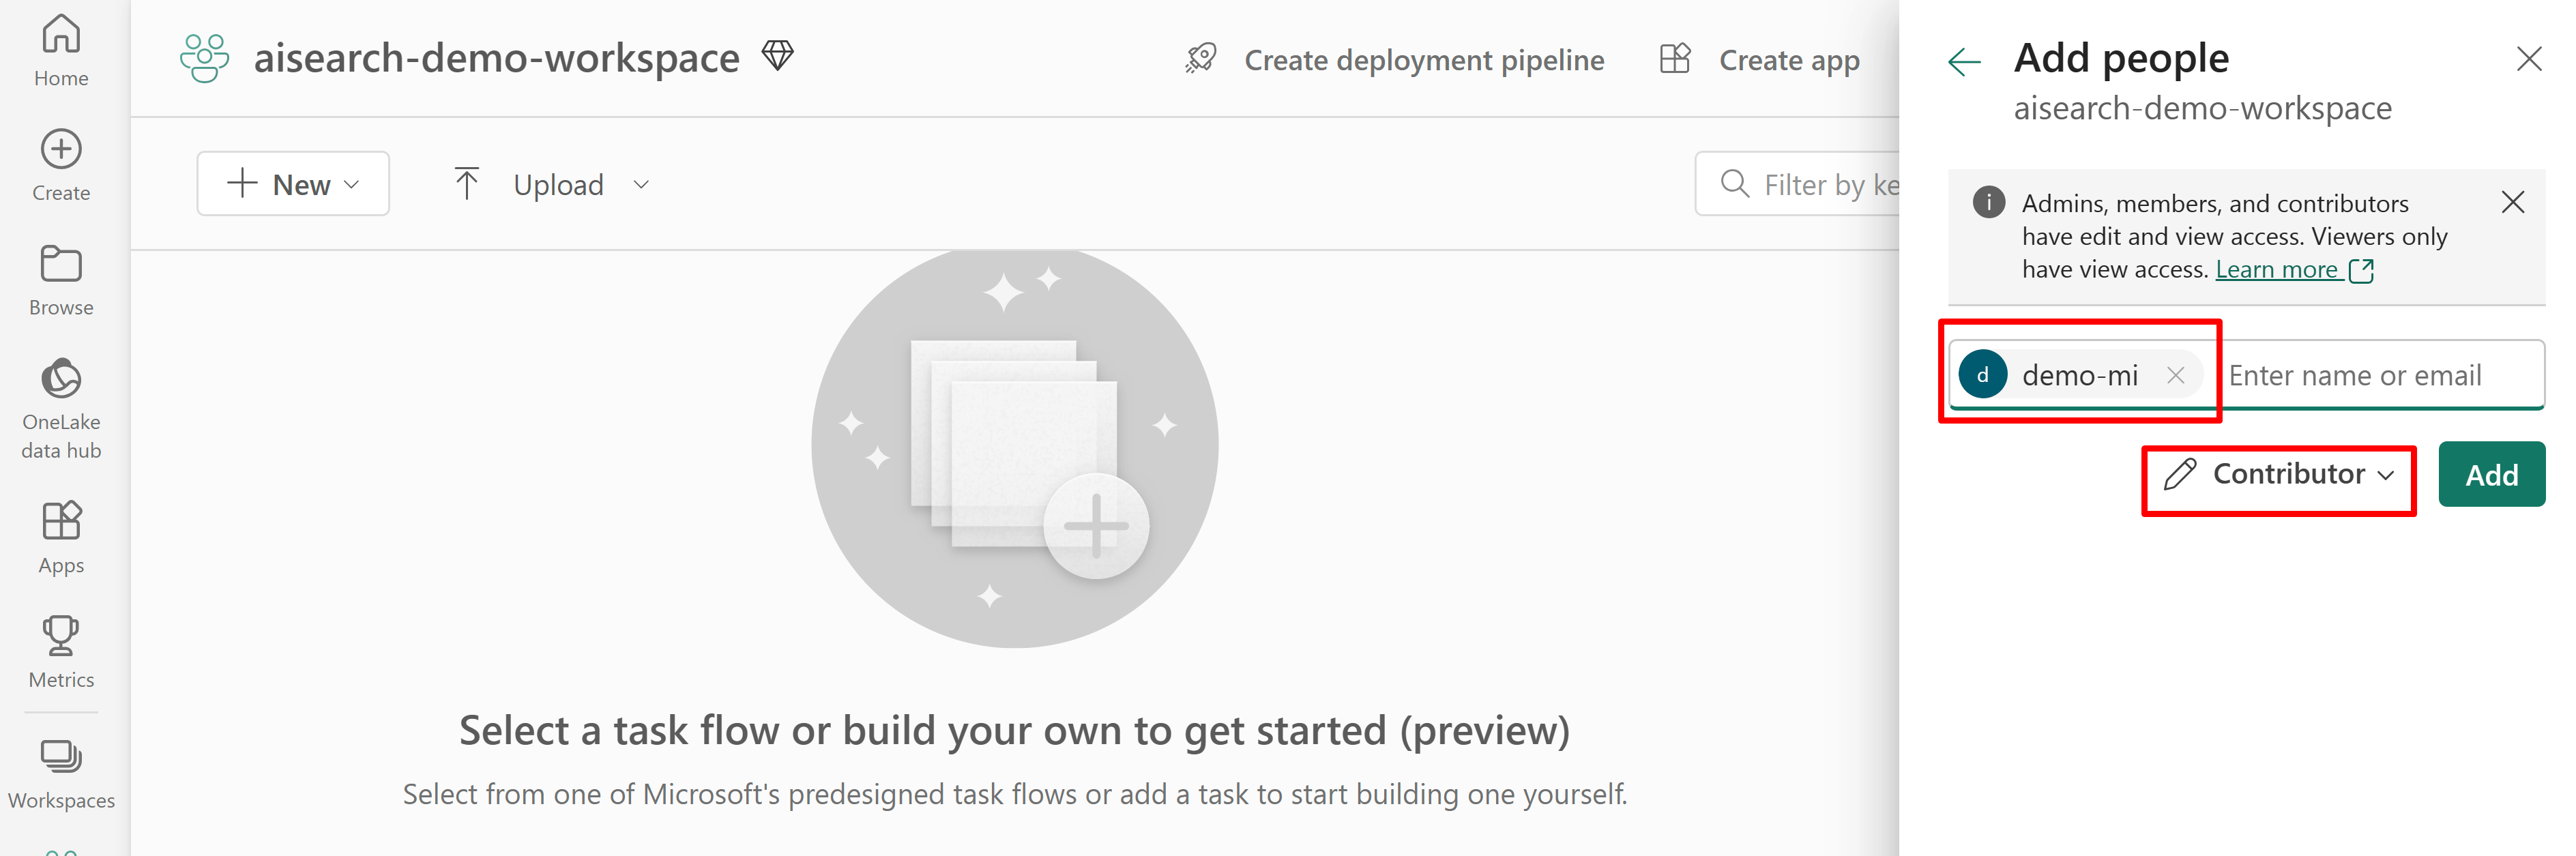
Jeśli używasz tożsamości zarządzanej przypisanej przez system, wyszukaj nazwę usługi Foundry IQ. W przypadku tożsamości zarządzanej przypisanej przez użytkownika wyszukaj nazwę zasobu tożsamości.
Poniższy zrzut ekranu przedstawia przypisanie roli współautora przy użyciu tożsamości zarządzanej przez system.
Ten zrzut ekranu przedstawia przypisanie roli Contributor przy użyciu tożsamości zarządzanej przypisanej przez użytkownika.
Skonfiguruj udostępnione łącze prywatne (wymagane w przypadku korzystania z łącza prywatnego na poziomie obszaru roboczego Fabric)
Jeśli obszar roboczy Fabric jest zabezpieczony za pomocą łącza prywatnego, usługa Foundry IQ nie będzie mogła uzyskać dostępu do danych usługi Lakehouse za pośrednictwem publicznego Internetu i nie będzie można skonfigurować indeksatora ani wymaganych zależności, takich jak źródło danych. Aby włączyć dostęp, należy skonfigurować udostępnione łącze prywatne między funkcją IQ rozwiązania Foundry i obszarem roboczym Fabric.
Definiowanie źródła danych
Źródło danych jest definiowane jako niezależny zasób, dzięki czemu może być używane przez wiele indeksatorów.
Użyj interfejsu API REST tworzenia lub aktualizowania źródła danych , aby ustawić jego definicję. Są to najważniejsze kroki definicji.
Ustaw
"type"na"onelake"(wymagane).Pobierz identyfikator GUID obszaru roboczego Microsoft Fabric i identyfikator GUID usługi Lakehouse:
W Power BI otwórz usługę Lakehouse, z której chcesz zaimportować dane. Zwróć uwagę na adres URL usługi Lakehouse w przeglądarce. Powinien wyglądać podobnie do tego przykładu: "https://msit.powerbi.com/groups/00000000-0000-0000-0000-000000000000/lakehouses/11111111-1111-1111-1111-111111111111". Adres URL zawiera zarówno identyfikator GUID obszaru roboczego, jak i identyfikator GUID lakehouse. Jeśli obszar roboczy Fabric jest zabezpieczony za pomocą łącza prywatnego, adres URL rozpocznie się od "https://{FabricWorkspaceGuid}.z{xy}.blob.fabric. microsoft.com".
Skopiuj identyfikator GUID obszaru roboczego, który znajduje się po prawej stronie "grup" w adresie URL. W tym przykładzie będzie to 000000000-0000-0000-0000-000000000000000. W pliku REST utwórz zmienną środowiskową dla
{FabricWorkspaceGuid}i ustaw ją na identyfikator GUID obszaru roboczego. Jeśli obszar roboczy używa łącza prywatnego, identyfikator GUID obszaru roboczego będzie wyświetlany w innej lokalizacji w adresie URL. Pamiętaj, aby odwołać się do poprawnej części adresu URL zgodnie z twoją konfiguracją.

Skopiuj identyfikator GUID usługi Lakehouse, który znajduje się bezpośrednio po "lakehouses" w adresie URL. W tym przykładzie będzie to 1111111111-1111-1111-1111-1111111111111111111. W pliku REST utwórz zmienną środowiskową i
{LakehouseGuid}ustaw ją na identyfikator GUID usługi Lakehouse.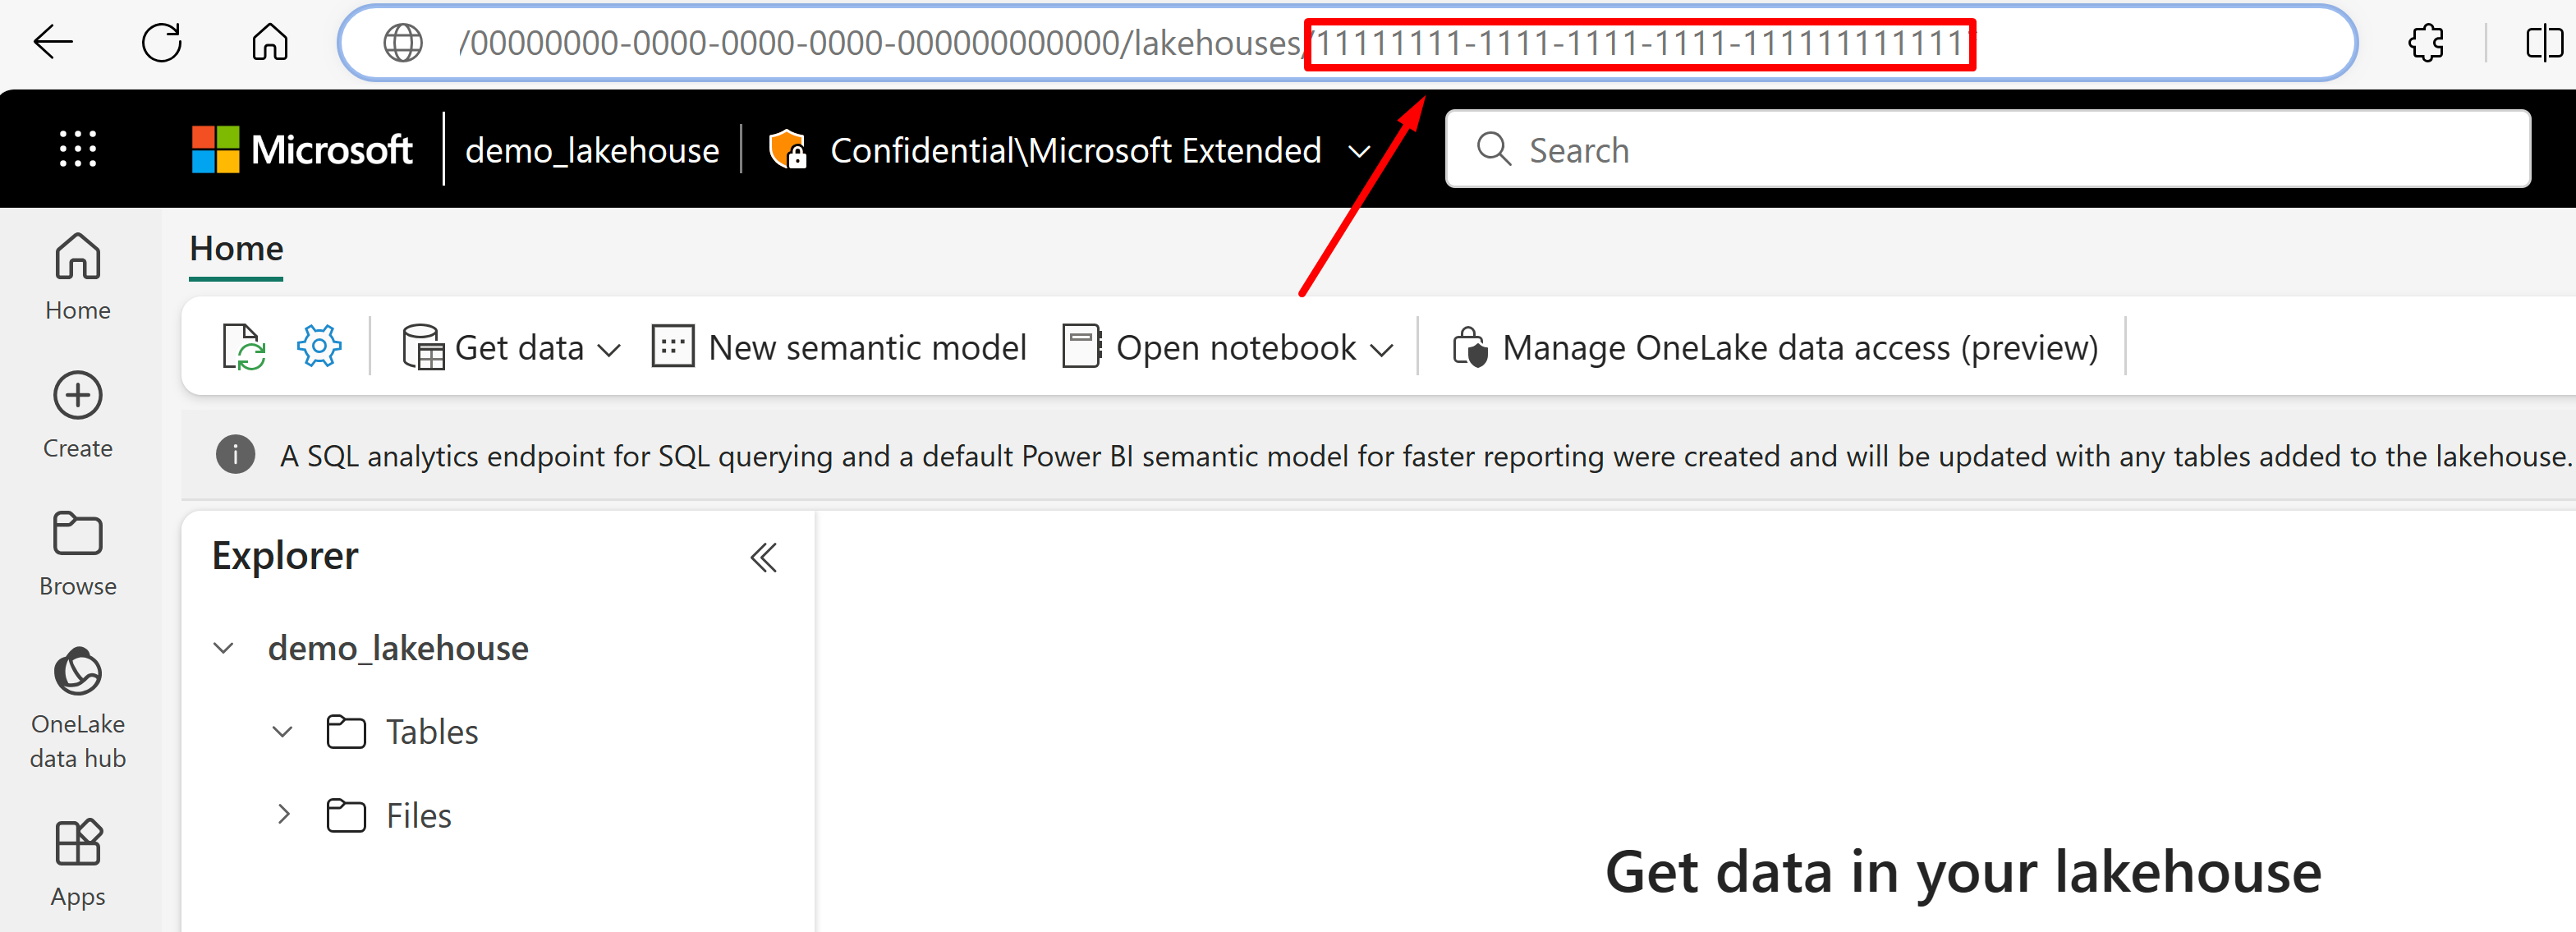
Ustaw
"credentials"na identyfikator GUID obszaru roboczego Microsoft Fabric, zastępując{FabricWorkspaceGuid}wartością skopiowaną w poprzednim kroku. Jest to usługa OneLake, do której można uzyskać dostęp przy użyciu tożsamości zarządzanej, którą skonfigurujesz w dalszej części tego przewodnika."credentials": { "connectionString": "ResourceId={FabricWorkspaceGuid}" }

W przypadku konfiguracji z udostępnionym łączem prywatnym, skonfiguruj tożsamości zarządzane przy użyciu następującego ciągu połączenia, który różni się od konfiguracji wykorzystującej Internet do komunikacji. Należy pamiętać, że nie tylko adres URL jest inny, ale także WorkspaceEndpoint jest używany, zamiast ResourceId. Weź to pod uwagę przy konfigurowaniu ustawień tożsamości zarządzanej przez system lub tożsamości zarządzanej przez użytkownika.
 "credentials": {
 "connectionString": "WorkspaceEndpoint=https://{FabricWorkspaceGuid}.z{xy}.blob.fabric.microsoft.com"
 }
Ustaw
"container.name"jako identyfikator GUID Lakehouse, zastępując{LakehouseGuid}wartością skopiowaną w poprzednim kroku. Użyj"query", aby opcjonalnie określić podfolder lub skrót lakehouse."container": { "name": "{LakehouseGuid}", "query": "{optionalLakehouseFolderOrShortcut}" }Ustaw metodę uwierzytelniania za pomocą tożsamości zarządzanej przypisanej przez użytkownika, lub pomiń ten krok, aby użyć tożsamości zarządzanej przez system.
{
  "name": "{dataSourceName}",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId={FabricWorkspaceGuid}"
  },
  "container": {
    "name": "{LakehouseGuid}",
    "query": "{optionalLakehouseFolderOrShortcut}"
  },
  "identity": {
    "@odata.type": "Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "{userAssignedManagedIdentity}"
  }
}
Wartość
userAssignedIdentitymożna znaleźć, uzyskując dostęp do zasobu{userAssignedManagedIdentity}w sekcji Właściwości, gdzie jest ona nazwanaId.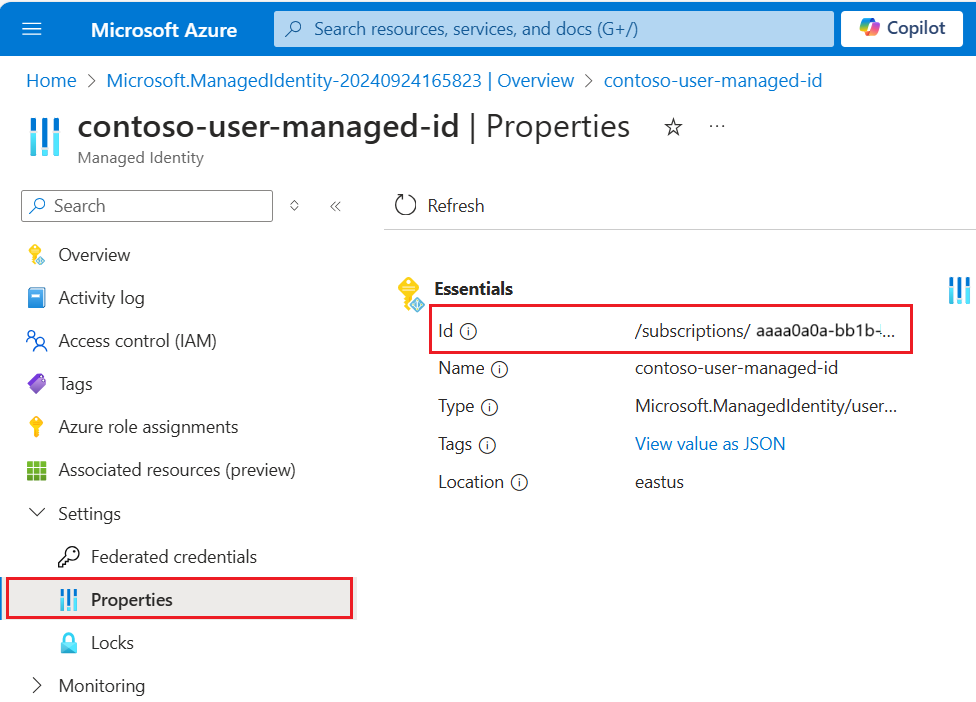
Przykład:
{
  "name": "mydatasource",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId=a0a0a0a0-bbbb-cccc-dddd-e1e1e1e1e1e1"
  },
  "container": {
    "name": "11111111-1111-1111-1111-111111111111",
    "query": "folder_name"
  },
  "identity": {
    "@odata.type": "Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "/subscriptions/333333-3333-3333-3333-33333333/resourcegroups/myresourcegroup/providers/Microsoft.ManagedIdentity/userAssignedIdentities/demo-mi"
  }
}
Opcjonalnie należy zamiast tego użyć tożsamości zarządzanej przypisanej przez system. Wartość "tożsamość" zostanie usunięta z definicji, jeśli jest używana tożsamość zarządzana przypisana przez system.
{
  "name": "{dataSourceName}",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId={FabricWorkspaceGuid}"
  },
  "container": {
    "name": "{LakehouseGuid}",
    "query": "{optionalLakehouseFolderOrShortcut}"
  }
}
Przykład:
{
  "name": "mydatasource",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId=a0a0a0a0-bbbb-cccc-dddd-e1e1e1e1e1e1"
  },
  "container": {
    "name": "11111111-1111-1111-1111-111111111111",
    "query": "folder_name"
  }
}
Wykrywanie usuwania za pośrednictwem metadanych niestandardowych
Definicja źródła danych indeksatora plików OneLake może zawierać politykę miękkiego usuwania, jeśli indeksator ma usunąć dokument wyszukiwania, gdy dokument źródłowy zostanie oznaczony do usunięcia.
Aby włączyć automatyczne usuwanie plików, użyj niestandardowych metadanych, aby wskazać, czy dokument wyszukiwania powinien zostać usunięty z indeksu.
Przepływ pracy wymaga trzech oddzielnych akcji:
- "Usuwanie nietrwałe" pliku w usłudze OneLake
- Indeksator usuwa dokument wyszukiwania w indeksie
- Trwałe usunięcie pliku w systemie OneLake
Polecenie "Usuwanie miękkie" informuje indeksatora, co należy zrobić (usunąć dokument z wyszukiwarki). Jeśli najpierw usuniesz plik fizyczny w usłudze OneLake, nie ma nic do odczytania przez indeksator i odpowiedni dokument wyszukiwania w indeksie staje się osierocony.
Należy wykonać określone kroki zarówno w OneLake, jak i w Foundry IQ, ale nie ma zależności od żadnych innych funkcji.
W pliku lakehouse dodaj niestandardową parę klucz-wartość do metadanych, aby wskazać, że plik został oznaczony do usunięcia. Można na przykład nazwać właściwość "IsDeleted", ustawioną na false. Jeśli chcesz usunąć plik, zmień go na true.
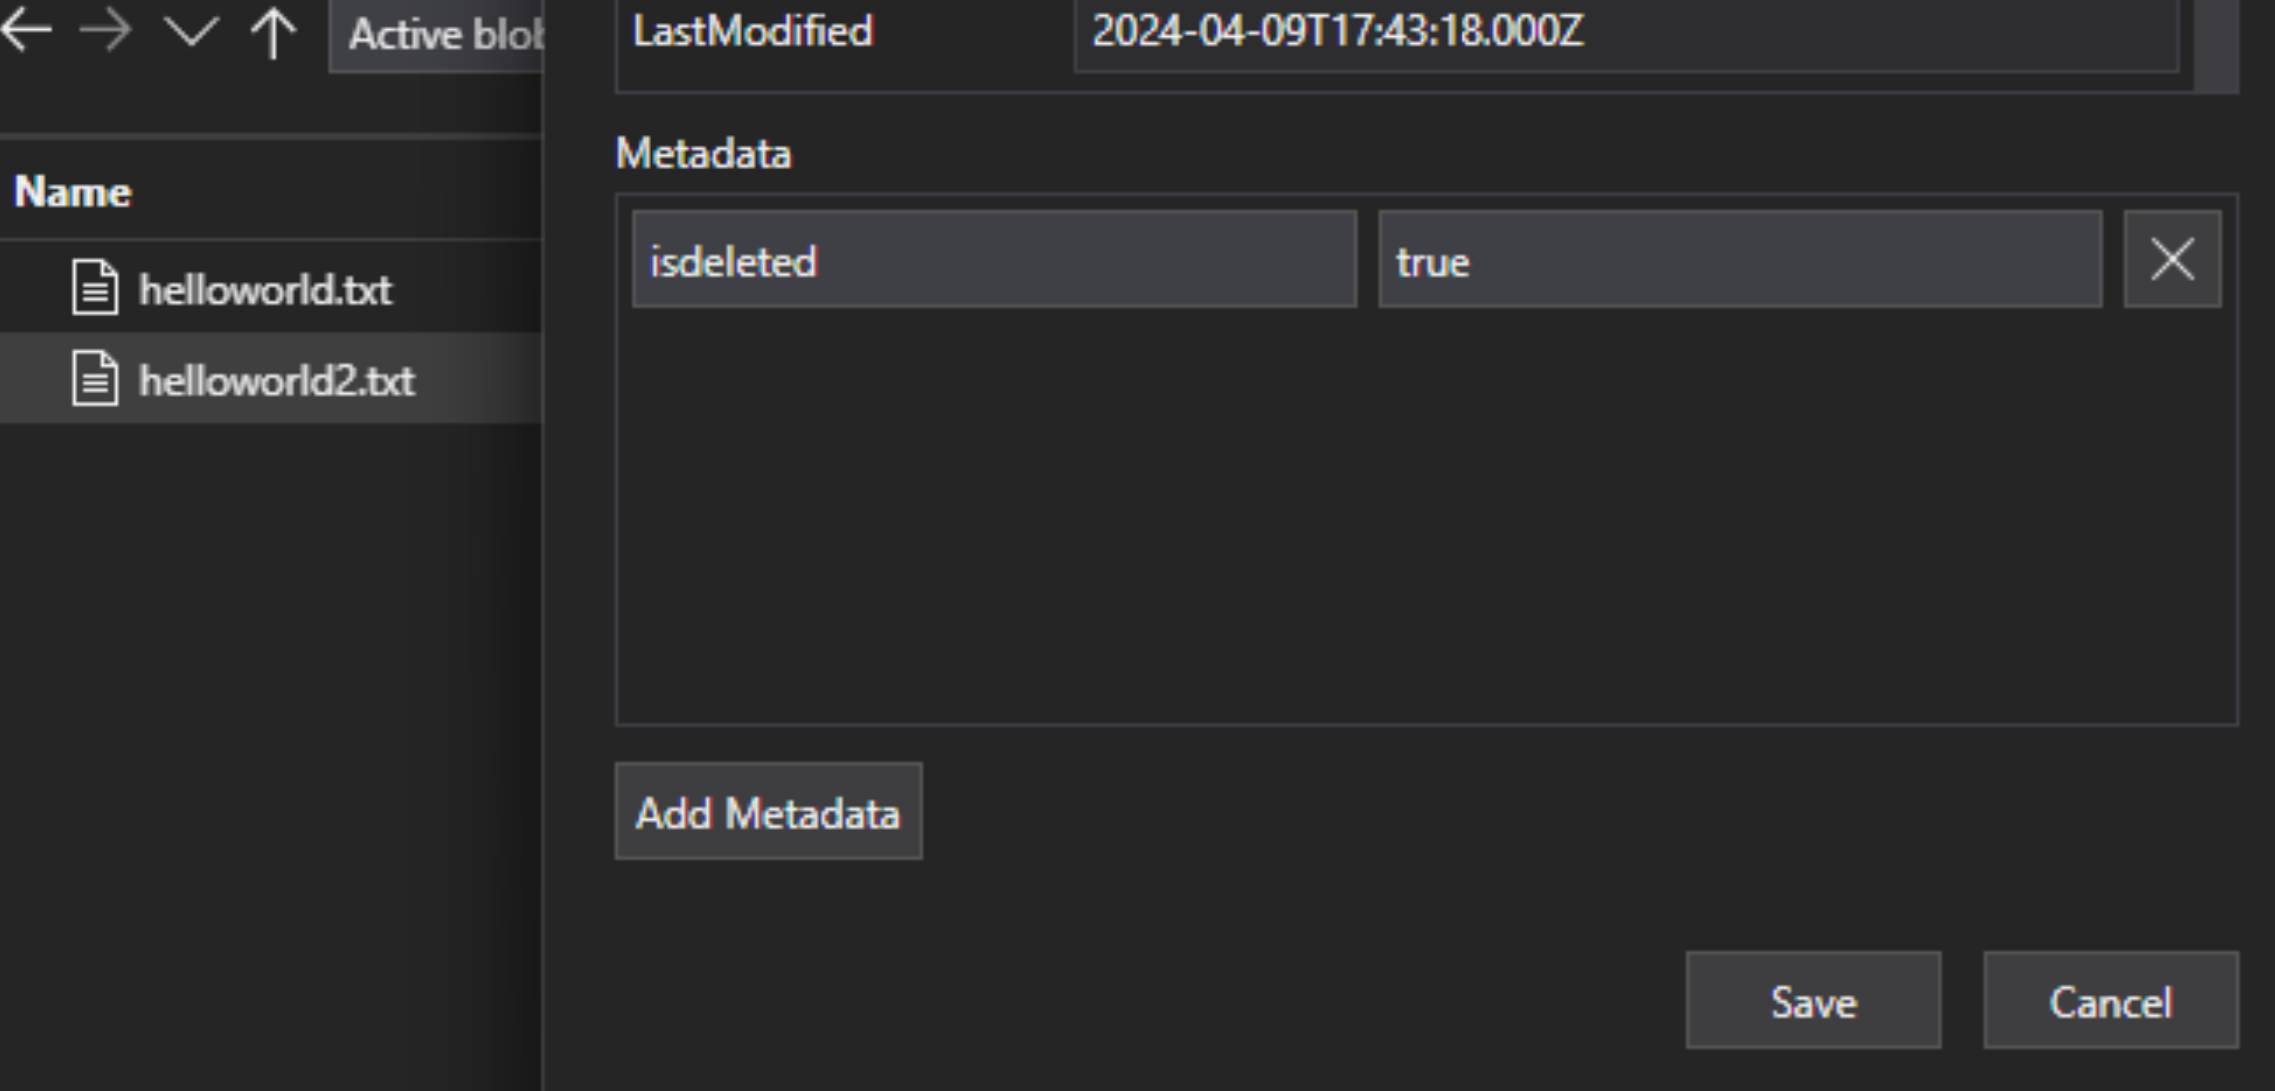
W pliku Foundry IQ zmodyfikuj definicję źródła danych, aby uwzględnić właściwość "dataDeletionDetectionPolicy". Na przykład następujące zasady uznają plik za usunięty, jeśli ma właściwość metadanych "IsDeleted" o wartości true:
PUT https://[service name].search.windows.net/datasources/file-datasource?api-version=2026-10-01
{
    "name" : "onelake-datasource",
    "type" : "onelake",
     "credentials": {
        "connectionString": "ResourceId={FabricWorkspaceGuid}"
    },
    "container": {
        "name": "{LakehouseGuid}",
        "query": "{optionalLakehouseFolderOrShortcut}"
    },
    "dataDeletionDetectionPolicy" : {
        "@odata.type" :"#Microsoft.Azure.Search.SoftDeleteColumnDeletionDetectionPolicy",
        "softDeleteColumnName" : "IsDeleted",
        "softDeleteMarkerValue" : "true"
    }
}
Po uruchomieniu indeksatora i usunięciu dokumentu z indeksu wyszukiwania można usunąć plik fizyczny w usłudze Data Lake.
Oto niektóre kluczowe kwestie:
Planowanie przebiegu indeksatora pomaga zautomatyzować ten proces. Zalecamy harmonogramy dla wszystkich scenariuszy indeksowania przyrostowego.
Jeśli zasady wykrywania usuwania nie zostały ustawione na pierwszym uruchomieniu indeksatora, należy zresetować indeksator , aby odczytał zaktualizowaną konfigurację.
Pamiętaj, że wykrywanie usuwania nie jest obsługiwane w przypadku skrótów amazon S3 i Google Cloud Storage ze względu na zależność od metadanych niestandardowych.
Dodawanie pól wyszukiwania do indeksu
W indeksie wyszukiwania dodaj pola, aby zaakceptować zawartość i metadane plików usługi OneLake data lake.
Utwórz lub zaktualizuj indeks, aby zdefiniować pola wyszukiwania, które przechowują zawartość pliku i metadane:
{
    "name" : "my-search-index",
    "fields": [
        { "name": "ID", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "content", "type": "Edm.String", "searchable": true, "filterable": false },
        { "name": "metadata_storage_name", "type": "Edm.String", "searchable": false, "filterable": true, "sortable": true  },
        { "name": "metadata_storage_size", "type": "Edm.Int64", "searchable": false, "filterable": true, "sortable": true  },
        { "name": "metadata_storage_content_type", "type": "Edm.String", "searchable": false, "filterable": true, "sortable": true }
    ]
}
Utwórz pole klucza dokumentu ("key": true). W przypadku zawartości pliku najlepszymi kandydatami są właściwości metadanych.
metadata_storage_path(ustawienie domyślne) pełna ścieżka do obiektu lub pliku. Pole klucza ("ID" w tym przykładzie) jest wypełniane wartościami z metadata_storage_path, ponieważ jest to ustawienie domyślne.metadata_storage_name, nadaje się do użycia tylko wtedy, gdy nazwy są unikatowe. Jeśli chcesz, aby to pole było kluczem, przejdź"key": truedo tej definicji pola.Niestandardowa właściwość metadanych dodana do plików. Ta opcja wymaga, aby proces przekazywania pliku dodawał tę właściwość metadanych do wszystkich obiektów blob. Ponieważ klucz jest wymaganą właściwością, wszystkie pliki, których brakuje wartości, nie mogą być indeksowane. Jeśli używasz niestandardowej właściwości metadanych jako klucza, unikaj wprowadzania zmian w tej właściwości. Indeksatory dodają zduplikowane dokumenty dla tego samego pliku, jeśli właściwość klucza ulegnie zmianie.
Właściwości metadanych często zawierają znaki, takie jak
/i-, które są nieprawidłowe dla kluczy dokumentów. Ponieważ indeksator ma właściwość "base64EncodeKeys" (prawda domyślnie), automatycznie koduje właściwość metadanych bez wymaganej konfiguracji ani mapowania pól.Dodaj pole "content", aby przechowywać wyodrębniony tekst z każdego pliku za pomocą właściwości "content" pliku. Nie musisz używać tej nazwy, ale umożliwia to korzystanie z niejawnych mapowań pól.
Dodaj pola dla standardowych właściwości metadanych. Indeksator może odczytywać właściwości metadanych niestandardowych, właściwości standardowych metadanych i właściwości metadanych specyficznych dla zawartości .
Konfigurowanie i uruchamianie indeksatora plików OneLake
Po utworzeniu indeksu i źródła danych możesz utworzyć indeksator. Konfiguracja indeksatora określa dane wejściowe, parametry i właściwości kontrolujące zachowania czasu wykonywania. Można również określić, które części obiektu blob mają być indeksowane.
Utwórz lub zaktualizuj indeksator , podając mu nazwę i odwołując się do źródła danych i indeksu docelowego:
{
  "name" : "my-onelake-indexer",
  "dataSourceName" : "my-onelake-datasource",
  "targetIndexName" : "my-search-index",
  "parameters": {
      "batchSize": null,
      "maxFailedItems": null,
      "maxFailedItemsPerBatch": null,
      "base64EncodeKeys": null,
      "configuration": {
          "indexedFileNameExtensions" : ".pdf,.docx",
          "excludedFileNameExtensions" : ".png,.jpeg",
          "dataToExtract": "contentAndMetadata",
          "parsingMode": "default"
      }
  },
  "schedule" : { },
  "fieldMappings" : [ ]
}
Ustaw wartość "batchSize", jeśli wartość domyślna (10 dokumentów) niewystarczająco wykorzystuje lub przeciąża dostępne zasoby. Domyślne rozmiary partii są specyficzne dla źródła danych. Indeksowanie plików ustawia rozmiar partii na 10 dokumentów, z uwagi na większy średni rozmiar dokumentów.
W obszarze "konfiguracja" steruj plikami, które są indeksowane na podstawie typu pliku, lub pozostaw nieokreślone, aby pobrać wszystkie pliki.
Dla
"indexedFileNameExtensions"podaj oddzieloną przecinkami listę rozszerzeń plików (z kropką wiodącą). Wykonaj to samo dla"excludedFileNameExtensions", aby wskazać, które rozszerzenia powinny zostać pominięte. Jeśli to samo rozszerzenie znajduje się na obu listach, jest wykluczone z indeksowania.W obszarze "configuration" ustaw wartość "dataToExtract", aby kontrolować, które części plików są indeksowane:
Wartość domyślna to "contentAndMetadata". Określa, że wszystkie metadane i zawartość tekstowa wyodrębniona z pliku są indeksowane.
"storageMetadata" określa, że indeksowane są tylko standardowe właściwości pliku i metadane określone przez użytkownika . Chociaż właściwości są udokumentowane dla obiektów blob Azure, właściwości pliku są takie same dla usługi OneLake, z wyjątkiem metadanych związanych z tokenem SAS.
"allMetadata" określa, że standardowe właściwości pliku i wszelkie metadane dla znalezionych typów zawartości są wyodrębniane z zawartości pliku i indeksowane.
W obszarze "konfiguracja" ustaw wartość "parsingMode", jeśli pliki powinny być mapowane na wiele dokumentów wyszukiwania lub jeśli składają się z zwykłego tekstu, dokumentów JSON lub plików CSV.
Określ mapowania pól , jeśli istnieją różnice w nazwie lub typie pola lub jeśli potrzebujesz wielu wersji pola źródłowego w indeksie wyszukiwania.
W indeksowaniu plików często można pominąć mapowania pól, ponieważ indeksator ma wbudowaną obsługę mapowania właściwości "zawartości" i metadanych na podobnie nazwane i wpisane pola w indeksie. W przypadku właściwości metadanych indeksator automatycznie zastępuje łączniki
-podkreśleniami w indeksie wyszukiwania.
Aby uzyskać więcej informacji na temat innych właściwości, utwórz indeksator. Aby uzyskać pełną listę opisów parametrów, zobacz Tworzenie indeksatora (REST) w interfejsie API REST. Parametry są takie same dla Microsoft OneLake.
Domyślnie indeksator jest uruchamiany automatycznie podczas jego tworzenia. To zachowanie można zmienić, ustawiając wartość "disabled" na true. Jeśli utworzysz indeksator w stanie wyłączonym, uruchom indeksator na żądanie , gdy wszystko będzie gotowe do użycia, lub umieść go zgodnie z harmonogramem.
Sprawdzanie stanu indeksatora
Zapoznaj się z wieloma podejściami do monitorowania stanu indeksatora i historii wykonywania tutaj.
Zarządzanie błędami
Błędy, które często występują podczas indeksowania, obejmują nieobsługiwane typy zawartości, brak zawartości lub nadmiernie zdużone pliki. Domyślnie indeksator plików OneLake zatrzymuje się zaraz po napotkaniu pliku z nieobsługiwanym typem zawartości. Jednak indeksowanie może być kontynuowane nawet w przypadku wystąpienia błędów, a następnie debugowanie poszczególnych dokumentów później.
Błędy przejściowe są typowe dla rozwiązań obejmujących wiele platform i produktów. Jeśli jednak utrzymasz indeksator zgodnie z harmonogramem (na przykład co 5 minut), indeksator powinien mieć możliwość odzyskania po tych błędach w następnym przebiegu.
Istnieje pięć właściwości indeksatora, które kontrolują odpowiedź indeksatora w przypadku wystąpienia błędów.
{
  "parameters" : {
    "maxFailedItems" : 10,
    "maxFailedItemsPerBatch" : 10,
    "configuration" : {
        "failOnUnsupportedContentType" : false,
        "failOnUnprocessableDocument" : false,
        "indexStorageMetadataOnlyForOversizedDocuments": false
    }
  }
}
| Parametr | Prawidłowe wartości | Opis |
|---|---|---|
| maxNieudanychElementów | -1, null lub 0, dodatnia liczba całkowita | Kontynuuj indeksowanie, jeśli błędy występują w dowolnym momencie przetwarzania, podczas analizowania obiektów blob lub podczas dodawania dokumentów do indeksu. Ustaw te właściwości na liczbę dopuszczalnych niepowodzeń. Wartość -1 umożliwia przetwarzanie bez względu na liczbę błędów. W przeciwnym razie wartość jest dodatnią liczbą całkowitą. |
| "maxFailedItemsPerBatch" | -1, null lub 0, dodatnia liczba całkowita | Tak samo jak powyżej, ale używany do indeksowania wsadowego. |
| błądNaNieobsługiwanymTypieTreści | prawda lub fałsz | Jeśli indeksator nie może określić typu zawartości, określ, czy kontynuować, czy nie wykonać zadania. |
| "ZawiedźNaNieprzetwarzalnymDokumencie" | prawda lub fałsz | Jeśli indeksator nie może przetworzyć dokumentu innego obsługiwanego typu zawartości, określ, czy kontynuować, czy nie wykonać zadania. |
| "indexPrzechowywanieMetadanychTylkoDlaZbytDużychDokumentów" | prawda lub fałsz | Nadmiernie duże obiekty są domyślnie traktowane jako błędy. Jeśli ustawisz ten parametr na wartość true, indeksator spróbuje zaindeksować jego metadane, nawet jeśli nie można indeksować zawartości. Aby uzyskać informacje o limitach dotyczących rozmiaru obiektu blob, zobacz Limity usługi. |
Następne kroki
Sprawdź, jak działa asystent importu danych i wypróbuj go dla tego indeksatora. Za pomocą zintegrowanej wektoryzacji można fragmentować i tworzyć osadzanie dla wektorów lub wyszukiwania hybrydowego przy użyciu schematu domyślnego.