Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Uwaga
Usługa Foundry IQ (Wyszukiwanie AI platformy Azure) udostępnia bezpośrednie indeksowanie i interfejsy API zapytań wraz z interfejsami API źródeł wiedzy i baz wiedzy wyższego poziomu na potrzeby pobierania zarządzanego. Użyj portalu Azure, interfejsów API REST lub Azure SDKs, aby skonfigurować te możliwości lub połączyć agentów z bazami wiedzy w portalu Microsoft Foundry.
Wyszukiwanie w różnych typach zawartości przechowywanych w Azure Blob Storage może być trudnym problemem do rozwiązania, ale funkcja Foundry IQ (Wyszukiwanie AI platformy Azure) zapewnia głęboką integrację w warstwie zawartości, wyodrębnianie i wnioskowanie informacji tekstowych, które następnie można wykonywać zapytania w indeksie wyszukiwania.
W tym artykule zapoznaj się z podstawowym przepływem pracy umożliwiającym wyodrębnianie zawartości i metadanych z obiektów blob oraz wysyłanie ich do indeksu wyszukiwania w usłudze Foundry IQ. Wynikowy indeks można odpytować przy użyciu wyszukiwania pełnotekstowego lub wyszukiwania wektorowego. Opcjonalnie możesz wysłać przetworzoną zawartość obiektu blob do magazynu wiedzy dla scenariuszy niezwiązanych z wyszukiwaniem.
Uwaga
Znasz już przepływ pracy i kompozycję? Konfigurowanie indeksatora obiektów blob to kolejny krok.
Co to znaczy dodać wyszukiwanie w danych blob
Foundry IQ to autonomiczna usługa, która obsługuje obciążenia związane z indeksowaniem i zapytaniami w indeksach zdefiniowanych przez użytkownika, które zawierają prywatną zawartość z możliwością wyszukiwania hostowaną w chmurze. Współlokowanie zawartości możliwej do wyszukiwania z silnikiem wyszukiwania jest niezbędne dla zapewnienia wydajności, zapewniającą prędkość wyników, jakiej użytkownicy oczekują od wyszukiwarek w chmurze.
Usługa Foundry IQ integruje się z Azure Blob Storage w warstwie indeksowania, importując zawartość obiektu blob jako dokumenty wyszukiwania, które są indeksowane do indeksów odwróconych i innych struktur zapytań, które obsługują swobodne zapytania tekstowe, zapytania wektorowe i wyrażenia filtrów. Ponieważ zawartość obiektu blob jest indeksowana w indeksie wyszukiwania, możesz użyć pełnego zakresu funkcji zapytań w usłudze Foundry IQ, aby znaleźć informacje w zawartości obiektu blob.
Dane wejściowe to Twoje obiekty blob znajdujące się w jednym kontenerze w usłudze Azure Blob Storage. Obiekty blob mogą być niemal dowolnym rodzajem danych tekstowych. Jeśli obiekty blob zawierają obrazy, możesz dodać wzbogacanie za pomocą sztucznej inteligencji, aby utworzyć i wyodrębnić tekst oraz cechy z obrazów.
Wynikiem jest zawsze indeks Foundry IQ, używany do szybkiego wyszukiwania tekstu, pobierania informacji i eksploracji w aplikacjach klienckich. Pośrodku znajduje się sama architektura potoku indeksowania. Potok jest oparty na funkcji indeksatora omówionej dokładniej w tym artykule.
Po utworzeniu i wypełnieniu indeksu istnieje niezależnie od kontenera obiektów blob, ale możesz ponownie uruchomić operacje indeksowania, aby odświeżyć indeks na podstawie zmienionych dokumentów. Informacje o znacznikach czasowych poszczególnych obiektów blob są używane do wykrywania zmian. Możesz wybrać zaplanowane wykonywanie lub indeksowanie na żądanie jako mechanizm odświeżania.
Zasoby używane w rozwiązaniu do wyszukiwania blobów
Potrzebujesz usługi Foundry IQ, Azure Blob Storage i klienta. Usługa Foundry IQ jest zazwyczaj jednym z kilku składników w rozwiązaniu, w którym kod aplikacji wystawia zapytania o żądania interfejsu API i obsługuje odpowiedź. Możesz również napisać kod aplikacji do obsługi indeksowania, chociaż w przypadku próby koncepcji i zadań bez przygotowania często używa się portalu Azure jako klienta wyszukiwania.
W usłudze Blob Storage potrzebny jest kontener, który udostępnia zawartość źródłową. Można ustawić kryteria dołączania i wykluczania plików oraz określać, które części obiektu blob są indeksowane w Foundry IQ.
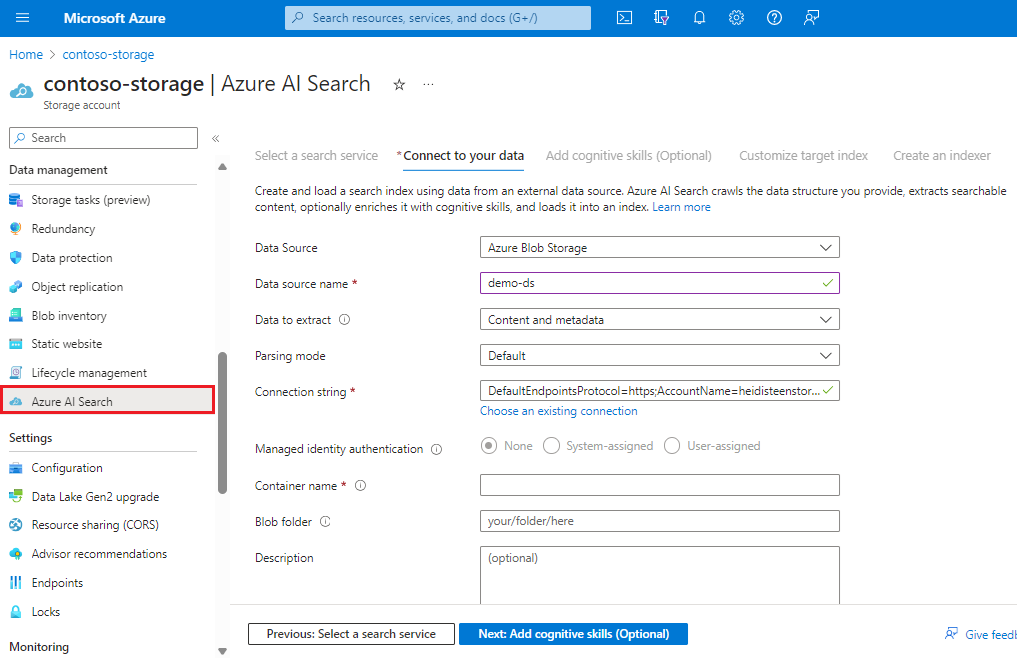
Możesz uruchomić bezpośrednio na stronie portalu konta usługi Storage.
W lewym okienku nawigacji w obszarze Zarządzanie danymi wybierz pozycję Foundry IQ, aby wybrać lub utworzyć usługę Foundry IQ.
Użyj kreatora importu, aby wyodrębnić zawartość z obiektów blob i opcjonalnie uczynić ją możliwą do wyszukiwania. Przepływ pracy tworzy indeksator, źródło danych, indeks i opcjonalny zestaw umiejętności w usłudze IQ usługi Foundry.
Użyj Eksploratora wyszukiwania na stronie portalu wyszukiwania, aby wysłać zapytanie do zawartości.
Kreator jest najlepszym miejscem na początek, ale podczas samodzielnego konfigurowania indeksatora obiektów blob znajdziesz bardziej elastyczne opcje. Możesz użyć klienta REST. Samouczek: indeksowanie i wyszukiwanie częściowo ustrukturyzowanych danych (obiektów blob JSON) przeprowadzi Cię przez kroki wywoływania interfejsu API REST.
Jak indeksowane są obiekty blob
Domyślnie większość obiektów blob jest indeksowana jako pojedynczy dokument wyszukiwania w indeksie, w tym obiekty blob z zawartością ustrukturyzowaną, taką jak JSON lub CSV, które są indeksowane jako pojedynczy fragment tekstu. Jednak w przypadku dokumentów JSON lub CSV, które mają strukturę wewnętrzną (ograniczniki), można przypisać tryby analizowania w celu wygenerowania poszczególnych dokumentów wyszukiwania dla każdego wiersza lub elementu:
- Indeksowanie obiektów blob JSON
- Indeksowanie obiektów blob CSV
- Indeksowanie blobów Markdown
- Indeksowanie obiektów blob w postaci zwykłego tekstu
Złożony lub osadzony dokument (taki jak archiwum ZIP, dokument programu Word z osadzoną wiadomością e-mail programu Outlook zawierającą załączniki lub . Plik MSG z załącznikami) jest również indeksowany jako pojedynczy dokument. Na przykład wszystkie obrazy wyodrębnione z załączników pliku .MSG zostaną zwrócone w polu normalized_images. Jeśli masz obrazy, rozważ dodanie wzbogacania sztucznej inteligencji, aby zwiększyć użyteczność wyszukiwania z tej zawartości.
Tekstowa zawartość dokumentu jest wyodrębniona do pola ciągu o nazwie "content". Można również wyodrębnić standardowe i zdefiniowane przez użytkownika metadane.
Uwaga
Funkcja IQ rozwiązania Foundry nakłada limity indeksatora na ilość tekstu, którą wyodrębnia, w zależności od poziomu cenowego. W odpowiedzi stanu indeksatora zostanie wyświetlone ostrzeżenie, jeśli dokumenty zostaną obcięte.
Użyj indeksatora obiektów blob do wyodrębniania zawartości
Indeksator jest podusługą z obsługą źródła danych w usłudze Foundry IQ, wyposażoną w wewnętrzną logikę próbkowania danych, odczytywanie i pobieranie danych oraz metadanych oraz serializowanie danych z formatów natywnych do dokumentów JSON w celu późniejszego importu.
Obiekty blob w usłudze Azure Storage są indeksowane przy użyciu indeksatora blob. Ten indeksator można wywołać przy użyciu polecenia IQ usługi Foundry w Azure Storage, Kreatora importu danych w portalu Azure, interfejsie API REST lub zestawie SDK .NET. W kodzie ten indeksator jest używany przez ustawienie typu oraz podanie informacji o połączeniu, które zawiera konto Azure Storage wraz z kontenerem Blob. Obiekty blob można podzielić na podzbiory, tworząc wirtualny katalog, który można następnie przekazać jako parametr, lub filtrując według rozszerzenia typu pliku.
Indeksator "analizuje dokument", otwierając obiekt blob w celu sprawdzenia zawartości. Po połączeniu się ze źródłem danych jest to pierwszy krok w procesie pracy. W przypadku danych obiektów blob są wykrywane pliki PDF, dokumenty pakietu Office i inne typy zawartości. Wydobywanie tekstu z dokumentów jest bezpłatne. Jeśli obiekty blob zawierają zawartość obrazu, obrazy zostaną zignorowane, chyba że dodasz wzbogacenie za pomocą sztucznej inteligencji. Indeksowanie standardowe dotyczy tylko zawartości tekstowej.
Indeksator obiektów blob platformy Azure zawiera parametry konfiguracji i obsługuje śledzenie zmian, jeśli bazowe dane zawierają wystarczające informacje. Więcej informacji na temat podstawowych funkcji można uzyskać w artykule Indeksowanie danych z usługi Azure Blob Storage.
Obsługiwane warstwy dostępu
Warstwy dostępu w magazynie obiektów blob obejmują Gorącą, Chłodną, Zimną i Archiwalną. Indeksatory mogą pobierać obiekty blob w warstwach dostępu Gorąca, Chłodna i Zimna.
Obsługiwane typy zawartości
Uruchamiając indeksator obiektów blob w kontenerze, można wyodrębnić tekst i metadane z następujących typów zawartości za pomocą jednego zapytania:
- CSV (zobacz Indeksowanie obiektów blob CSV)
- EML
- EPUB
- GZ
- HTML
- JSON (zobacz Indeksowanie JSON blobs)
- KML (XML dla reprezentacji geograficznych)
- Markdown
- Formaty pakietu Microsoft Office: DOCX/DOC/DOCM, XLSX/XLS/XLSM, PPTX/PPT/PPTM, MSG (wiadomości e-mail programu Outlook), XML (zarówno 2003, jak i 2006 WORD XML)
- Format dokumentów Open Document: ODT, ODS, ODP
- Pliki zwykłego tekstu (zobacz też Indeksowanie zwykłego tekstu)
- RTF
- XML
- ZIP
Kontrolowanie indeksowanych obiektów blob
Możesz kontrolować, które obiekty blob są indeksowane i które są pomijane przez typ pliku obiektu blob lub przez ustawienie właściwości obiektu blob na samym obiekcie blob, co powoduje, że indeksator pomija je.
Uwzględnij określone rozszerzenia plików, ustawiając "indexedFileNameExtensions" na rozdzielaną przecinkami listę rozszerzeń plików (z kropką wiodącą). Wyklucz określone rozszerzenia plików, ustawiając "excludedFileNameExtensions" na rozszerzenia, które powinny zostać pominięte. Jeśli to samo rozszerzenie znajduje się na obu listach, jest wykluczone z indeksowania.
PUT /indexers/[indexer name]?api-version=2026-10-01
{
    "parameters" : {
        "configuration" : {
            "indexedFileNameExtensions" : ".pdf, .docx",
            "excludedFileNameExtensions" : ".png, .jpeg"
        }
    }
}
Dodaj metadane "skip" do obiektu blob
Parametry konfiguracji indeksatora dotyczą wszystkich blobów w kontenerze lub folderze. Czasami chcesz kontrolować sposób indeksowania poszczególnych obiektów blob .
Dodaj następujące właściwości i wartości metadanych do obiektów blob w usłudze Blob Storage. Gdy indeksator napotka tę właściwość, pomija obiekt blob lub jego zawartość w przebiegu indeksowania.
Indeksowanie metadanych obiektu blob
Typowym scenariuszem, który ułatwia sortowanie obiektów blob dowolnego typu zawartości, jest indeksowanie zarówno niestandardowych metadanych, jak i właściwości systemu dla każdego obiektu blob. W ten sposób informacje dotyczące wszystkich obiektów blob są indeksowane niezależnie od typu dokumentu przechowywanego w indeksie w usłudze IQ usługi Foundry. Przy użyciu nowego indeksu możesz następnie przejść do sortowania, filtrowania i facetowania całej zawartości Blob Storage.
Uwaga
Tagi indeksów blobów są natywnie indeksowane przez usługę Blob Storage i udostępniane do zapytań. Jeśli atrybuty klucza/wartości obiektu blob wymagają możliwości indeksowania i filtrowania, tagi indeksu obiektów blob powinny być używane zamiast metadanych.
Aby dowiedzieć się więcej na temat indeksu obiektów blob, zobacz Zarządzanie danymi i znajdowanie ich w usłudze Azure Blob Storage za pomocą indeksu obiektów blob.
Wyszukiwanie zawartości obiektu blob w indeksie wyszukiwania
Dane wyjściowe indeksatora to indeks wyszukiwania używany do eksploracji interakcyjnej przy użyciu wolnego tekstu i filtrowanych zapytań w aplikacji klienckiej. W celu wstępnej eksploracji i weryfikacji zawartości zalecamy rozpoczęcie pracy z Eksploratorem wyszukiwania w witrynie Azure Portal w celu zbadania struktury dokumentów. W Eksploratorze wyszukiwania można użyć:
Bardziej trwałe rozwiązanie polega na zbieraniu danych wejściowych zapytań i prezentowaniu odpowiedzi jako wyników wyszukiwania w aplikacji klienckiej.