Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Opmerking
Azure AI Zoeken is beschikbaar via de Azure-portal, REST API's en Azure-SDK's. Het vormt ook een basis voor Foundry IQ, de beheerde kennislaag die bedrijfsinhoud transformeert in herbruikbare, machtigingsbewuste knowledge bases voor agents in de Microsoft Foundry-portal.
Azure AI Zoeken is een volledig beheerde, in de cloud gehoste service die uw gegevens verbindt met AI. De service integreert de toegang tot bedrijfs- en webinhoud, zodat agents en grote taalmodellen (LLM's) context, chatgeschiedenis en multi-source signalen kunnen gebruiken om betrouwbare, geaarde antwoorden te produceren.
Veelvoorkomende toepassingen zijn klassiek zoeken en retrieval-augmented generation (RAG) met behulp van agentgestuurde informatieophaling, waarbij de service de planning van query's, de informatieophaling en het opstellen van antwoorden orkestreert. Deze mogelijkheden ondersteunen scenario's, variërend van traditionele zoekervaringen tot AI-agents en chattoepassingen die geschikt zijn voor bedrijfs- en consumentenscenario's.
Wanneer u een zoekservice maakt, zijn de volgende mogelijkheden opgenomen:
- Twee engines: klassieke zoekopdrachten voor enkelvoudige aanvragen en agentisch ophalen voor parallelle, iteratieve, door LLM ondersteunde zoekopdrachten.
- Volledige tekst-, vector-, hybride- en multimodale zoekopdrachten over lokale (geïndexeerde) en externe inhoud.
- AI-verrijking voor segmenten, vectoriseren en anderszins onbewerkte inhoud doorzoekbaar maken.
- Relevantieafstemming om intentiekoppeling en resultaatkwaliteit te verbeteren.
- Azure schaalbaarheid, beveiliging, monitoring en naleving.
- Azure integraties met ondersteunde gegevensplatformen, Azure OpenAI en Microsoft Foundry.
Waarom Azure AI Zoeken gebruiken?
Grondagenten en chatbots in eigen ontwikkelde systemen, zakelijke of webgegevens voor nauwkeurige, contextbewuste reacties.
Toegang tot gegevens uit Azure Blob Storage, Azure Cosmos DB, Microsoft SharePoint, Microsoft OneLake en andere ondersteunde gegevensbronnen. Kies geïndexeerde of externe toegang op basis van uw nieuwheid, latentie en nalevingsbehoeften.
Inhoud verrijken en structureren bij indexering of querytijd met vaardigheden die segmentering, insluiting en door LLM ondersteunde transformaties uitvoeren.
Combineer zoeken in volledige tekst met vectorzoekopdrachten (hybride zoekopdrachten) om precisie en terughalen te balanceren.
Query's uitvoeren op inhoud met zowel tekst als afbeeldingen in één multimodale pijplijn.
Implementeer eenvoudig zoekgerelateerde functies: relevantieafstemming, facetnavigatie, filters (inclusief geo-ruimtelijke zoekopdracht), synoniemtoewijzing en automatisch aanvullen.
Bedrijfsbeveiliging, toegangsbeheer en naleving bieden via Microsoft Entra ID, Azure Private Link, toegangsbeheer op documentniveau en op rollen gebaseerde toegang.
Schaal en beheer in productie met Azure-betrouwbaarheid, bewaking en diagnose (logboeken, metrieken en waarschuwingen) en tooling voor REST API of SDK voor automatisering.
Zie Features of Azure AI Zoeken voor meer informatie over specifieke functionaliteit.
Wat is klassieke zoekopdracht?
Klassieke zoekopdrachten zijn een index-first ophaalmodel voor voorspelbare query's met lage latentie. Elke query is gericht op één vooraf gedefinieerde zoekindex en retourneert gerangschikte documenten in één aanvraagresponscyclus. Tijdens het ophalen vindt geen planning, iteratie of synthese ondersteund door LLM plaats.
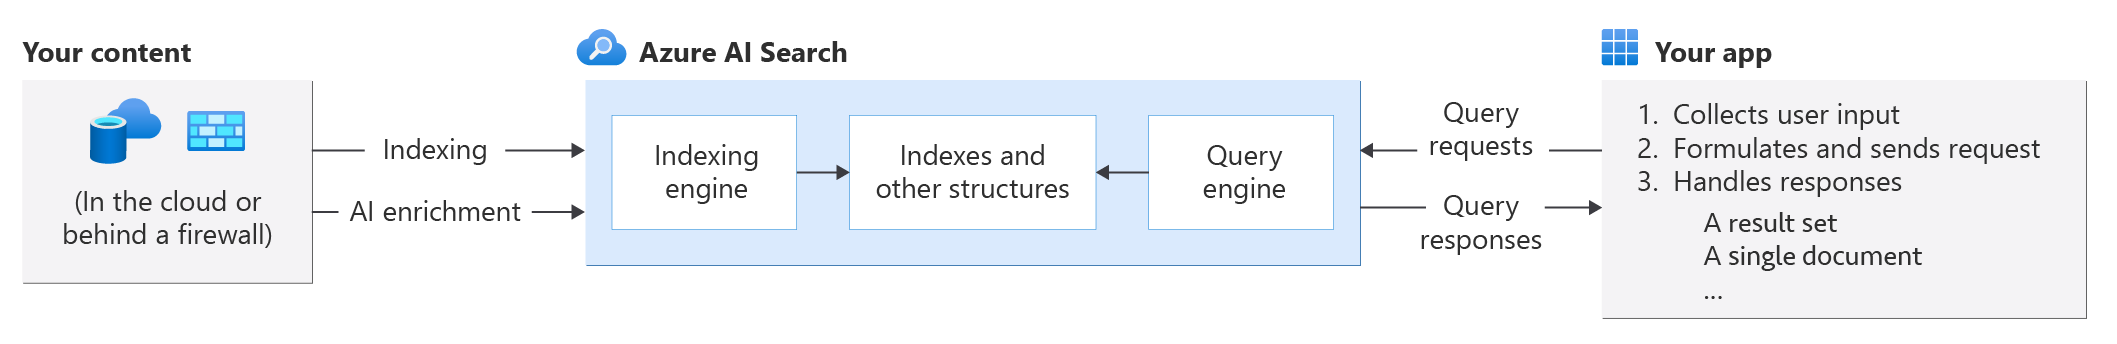
In deze architectuur bevindt uw zoekservice zich tussen de gegevensarchieven die uw niet-verwerkte inhoud en uw client-app bevatten. De app is verantwoordelijk voor het verzenden van queryaanvragen naar uw zoekservice en het verwerken van het antwoord.
Deze architectuur heeft twee primaire workloads:
Door inhoud te indexeren wordt inhoud in een index geladen en kan deze worden doorzocht. Intern wordt inkomende tekst getokeniseerd en opgeslagen in omgekeerde indexen, terwijl inkomende vectoren worden opgeslagen in vectorindices. Azure AI Zoeken kan alleen JSON-documenten indexeren. U kunt de pushmethode gebruiken om JSON-documenten rechtstreeks te uploaden of de pull-methode (indexeerfunctie of werkstroom voor logische apps) om gegevens op te halen en te serialiseren in JSON.
Tijdens het indexeren kunt u AI-verrijking gebruiken om tekst te segmenteren, vectoren te genereren en andere transformaties toe te passen die structuur en inhoud maken. Azure AI Zoeken serialiseert vervolgens de verrijkte uitvoer in JSON-documenten en neemt deze op in de index.
Opmerking
Dit diagram scheidt de indexerings- en query-engines voor duidelijkheid, maar in Azure AI Zoeken zijn ze hetzelfde onderdeel dat werkt in de modus lezen/schrijven en alleen-lezen.
Wat is agentische terugwinning?
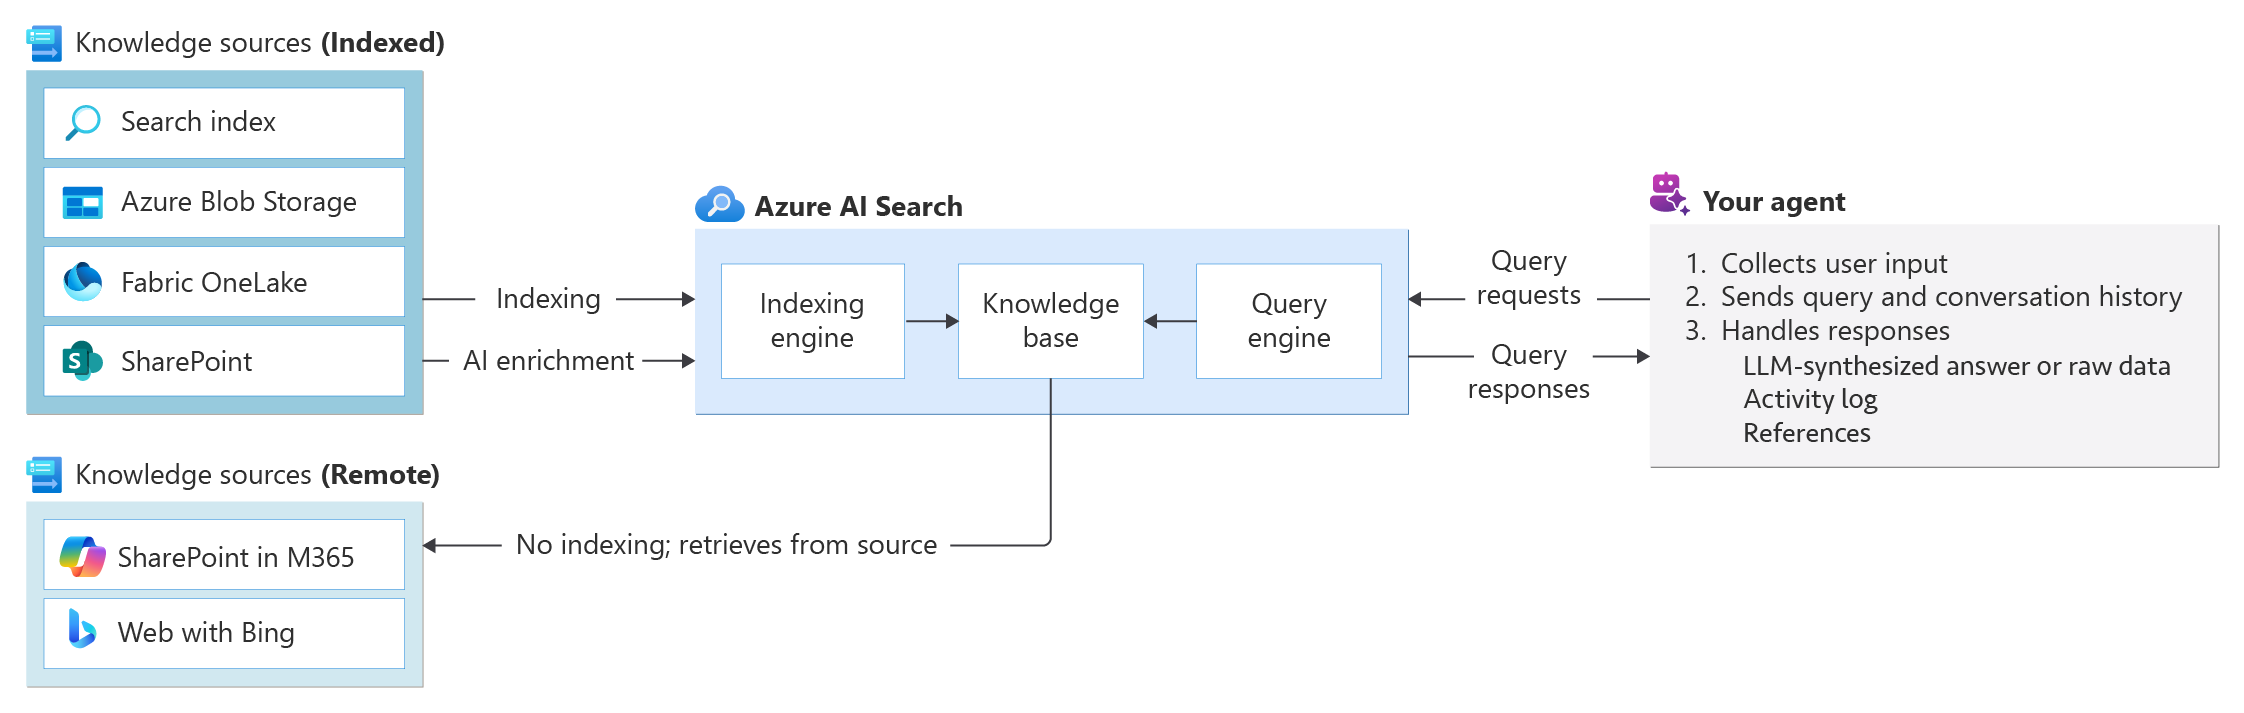
Agentic retrieval is een multi-query pijplijn die is ontworpen voor complexe agent-naar-agent werkstromen. Elke query is gericht op een knowledge base die een volledig kennisdomein vertegenwoordigt. Uw agent verwijst naar de kennisbasis voor wat er moet worden geaard, terwijl de kennisbasis bepaalt hoe dat aarden moet worden uitgevoerd.
Een knowledge base bestaat uit een of meer kennisbronnen, een optionele LLM voor queryplanning en antwoordsynthese en parameters die het ophalen van gedrag bepalen. Elke query ondergaat planning, ontleding in gerichte subquery's, parallel ophalen uit kennisbronnen, semantische rerankering en samenvoeging van resultaten. De drieledige reactie is geoptimaliseerd voor agentverbruik.
Onder de schermen bouwt agentisch ophalen voort op de klassieke zoekarchitectuur door een contextlaag (knowledge base) toe te voegen die het ophalen van meerdere bronnen organiseert. Kennisbronnen kunnen worden geïndexeerd of extern: geïndexeerde bronnen gebruiken dezelfde indexerings- en query-engines als klassieke zoekopdrachten, terwijl externe bronnen indexering omzeilen en live worden opgevraagd.
Hoe ze zich met elkaar vergelijken
Klassiek zoeken en agentisch ophalen zijn complementaire modi voor het ophalen van informatie. Beide ondersteunen zoeken in volledige tekst, vector, hybride en multimodale zoekopdrachten. Ze verschillen echter in hoe inhoud wordt opgenomen en opgevraagd. De volgende tabel bevat een overzicht van de belangrijkste verschillen.
| Aspect | Klassieke zoekopdracht | Agentisch ophalen |
|---|---|---|
| Zoekcorpus | Zoekindex | Kennisbron |
| Zoekdoel | Eén index gedefinieerd door een schema | Een knowledge base die verwijst naar een of meer kennisbronnen |
| Queryplan | Geen plan, alleen een aanvraag | Door LLM ondersteund of door de gebruiker verstrekt plan |
| Queryaanvraag | Documenten zoeken in een index | Ophalen uit kennisbronnen |
| Reactie | Afgevlakte zoekresultaten op basis van schema | MET antwoord geformuleerd door LLM of onbewerkte brongegevens, activiteitlogboek, verwijzingen |
| Regiobeperkingen | Nee | Ja |
| Toestand | Algemeen beschikbaar | Algemeen beschikbaar, met enkele mogelijkheden in preview |
| Ondersteuning voor toegewezen prijsmodellen | Ja | Ja |
| Ondersteuning voor serverloze prijsmodellen (preview) | Ja | Ja |
Aan de slag
U kunt Azure AI Zoeken openen via de Azure-portal, REST-API's, en Azure-SDK's voor .NET, Java, JavaScript en Python.
De portal is handig voor servicebeheer en inhoudsbeheer, met hulpprogramma's voor het maken van prototypen van uw knowledge bases, kennisbronnen, indexen, indexeerfuncties, vaardighedensets en gegevensbronnen. REST API's en SDK's zijn handig voor productieautomatisering.
Kies uw pad
Voordat u aan de slag gaat, gebruikt u deze controlelijst om belangrijke beslissingen te nemen:
Kies een prijsmodel: Selecteer tussen het prijsmodel Dedicated of Serverless (preview). Zie Een prijsmodel en servicelaag kiezen voor hulp bij het kiezen van het model dat het beste bij uw behoeften past.
Kies hoe u gegevens wilt ophalen: U kunt rechtstreeks vanuit een zoekindex query's uitvoeren op voorspelbare resultaten met lage latentie of agentisch ophalen gebruiken om query's uit te voeren op meerdere indexen via een Knowledge Base. Als u een traditionele app bouwt zonder een agent of chatbot, kunnen directe indexquery's voldoen aan de meeste behoeften met lagere kosten en complexiteit. Als u met meerdere kennisbronnen wilt werken of meer geavanceerde scenario's wilt ondersteunen, overweeg dan agentische retrieval met minimale redeneerinspanning (preview).
Kies een regio: Als u agent-based retrieval gebruikt, kies dan een ondersteunde regio. Kies voor klassiek zoeken een regio met de functies en capaciteit die u nodig hebt.
Kies een opnamemethode voor indexgebonden inhoud: Als uw inhoud zich in een ondersteunde gegevensbron bevindt, gebruikt u de pull-methode om gegevens op te halen en te serialiseren in JSON. Als u geen ondersteunde gegevensbron hebt of als uw inhoud en index in realtime moeten worden gesynchroniseerd, is de pushmethode de enige optie.
Heb je vectoren nodig? VOOR LLM's en agents zijn geen vectoren vereist. Gebruik ze alleen als u overeenkomsten zoekt of als u inhoud hebt die in vectoren kan worden gehomogeniseerd. Azure AI Zoeken biedt geïntegreerde vectorisatie voor deze taak.
Hebt u gebruikergebaseerde machtigingenerfenis nodig? Externe SharePoint is ontworpen voor dit scenario, maar u kunt ook gebruikersmachtigingen overnemen die zijn gekoppeld aan inhoud in Azure Blob Storage of ADLS Gen2. Voor alle andere scenario's kunt u de tijdelijke oplossing voor beveiligingsfilters gebruiken.
Uw leerbronnen kiezen
Deze quickstarts en voorbeelden zijn beschikbaar om u te helpen aan de slag te gaan.
- Quickstart: Agent-gebaseerd ophalen (portal of programmatisch)
- Quickstart: Zoeken in volledige tekst (portal of programmatisch)
- Quickstart: Vector search (portal of programmatisch)
Tip
Voor hulp bij complexe of aangepaste oplossingen contact opnemen met een partner met diepgaande expertise in Azure AI Zoeken.