Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Notitie
Azure AI Zoeken is beschikbaar via de Azure-portal, REST API's en Azure-SDK's. Het vormt ook een basis voor Foundry IQ, de beheerde kennislaag die bedrijfsinhoud transformeert in herbruikbare, machtigingsbewuste knowledge bases voor agents in de Microsoft Foundry-portal.
Af en toe ondervinden indexeerfuncties problemen die geen fouten veroorzaken of die optreden in andere Azure-services, zoals tijdens verificatie of bij het maken van verbinding. Dit artikel is gericht op het oplossen van problemen met indexeerfuncties wanneer er geen berichten zijn om u te helpen. Het biedt ook probleemoplossing voor fouten die afkomstig zijn van niet-zoekbronnen die tijdens het indexeren worden gebruikt.
Notitie
Als u een Azure AI Zoeken-fout hebt om te onderzoeken, kunt u in plaats daarvan Veelvoorkomende indexeerfouten en waarschuwingen oplossen raadplegen.
Beste praktijken
Dit zijn enkele aanbevolen procedures en aanbevelingen bij het werken met indexeerfuncties:
Indexeerfuncties zijn ontworpen om te worden uitgevoerd volgens een schema
- Voor betrouwbare indexering configureert u uw indexeerfuncties zodanig dat ze volgens een normaal schema worden uitgevoerd. Geplande uitvoeringen halen automatisch alle documenten op die in eerdere uitvoeringen zijn gemist vanwege tijdelijke fouten, netwerkonderbrekingen of tijdelijke serviceproblemen. Deze aanpak helpt bij het behouden van gegevensconsistentie en minimaliseert de noodzaak van handmatige interventie.
- Voor grote gegevensbronnen kan de eerste inventarisatie en indexering uren of zelfs dagen duren. Als u de indexeerfunctie volgens een schema uitvoert, wordt de voortgang voortgezet en worden fouten automatisch opnieuw geprobeerd. Vertrouw niet uitsluitend op handmatige of on-demand indexeerbewerkingen, omdat deze opties niet dezelfde betrouwbaarheid of hetzelfde herstel van tijdelijke fouten bieden.
Indexers bieden naar beste kunnen indexering in de loop van de tijd.
- Ingebouwde indexeerders verwerken documenten zonder blijvende fouten en proberen het opnieuw bij volgende geplande uitvoeringen. Ze bieden een handige, weinig code of geen code manier om gegevens te indexeren voor algemene scenario's, waardoor sneller ontwikkelen en eenvoudiger onderhoud mogelijk is. Wanneer een indexeerfunctie een vaardighedenset uitvoert, heeft elke uitvoering een vaste uitvoeringstijdlimiet. Indexeerfuncties die worden uitgevoerd in de uitvoeringsomgeving met meerdere tenants , hebben een maximale uitvoeringstijd van twee uur. Deze limiet is het meest voorkomende geval, gebruikt wanneer vaardighedensets geen gedeelde privékoppelingen vereisen. Indexeerfuncties die zijn geconfigureerd voor het gebruik van gedeelde privékoppelingen worden uitgevoerd in een privé-uitvoeringsomgeving met een maximum van 24 uur. Zie Indexeerlimieten voor de volledige tabel. Als verwerking van vaardighedensets per document voorkomt dat de indexeerfunctie vóór de tijdslimiet eindigt, worden de resterende documenten niet verwerkt. Volledige verwerking wordt niet gegarandeerd wanneer documentvolume, bestandsgrootte, complexiteit van vaardigheden of uitvoeringsomgeving voorkomen dat de indexeerfunctie binnen de maximale uitvoeringstijd wordt voltooid. Het partitioneren van uw gegevensbron kan dit risico verminderen, maar elimineert dit niet, met name als u later grote hoeveelheden bestanden aan een partitie toevoegt. Dit gedrag wordt verwacht. Raadpleeg Grote gegevenssets indexeren en Indexeerders plannen voor strategieën voor het beheren van grote gegevenssets en voor ondersteuning van incrementeel herstel. Als voor uw oplossing strikte controle is vereist wanneer de indexeerfunctie documenten verwerkt, gebruikt u het alternatief voor de Push-API in dit artikel.
- Als voor uw oplossing strikte controle over de indexeringstijdlijnen is vereist, gebruikt u in plaats daarvan de Push-API's, zoals de REST API van Documents Index of de Methode IndexDocuments (Azure SDK voor .NET). Met deze opties hebt u volledige controle over de indexeringspijplijn.
- Indexeerfuncties kunnen af en toe buiten de planning vallen. Hoewel deze situatie ongebruikelijk is en mechanismen voor automatisch herstel bestaan, kan het herstel enige tijd in beslag nemen. Dit gedrag wordt verwacht.
Problemen met verbindingen met beperkte resources oplossen
Voor gegevensbronnen onder Azure-netwerkbeveiliging zijn indexeerfuncties beperkt in de wijze waarop ze de verbinding maken. Op dit moment hebben indexeerfuncties toegang tot beperkte gegevensbronnen achter een IP-firewall of via een virtueel netwerk via een privé-eindpunt met behulp van een gedeelde privékoppeling.
Fout bij het maken van verbinding met een Microsoft Foundry-resource op een privéverbinding
Als u foutcode 403 krijgt met het volgende bericht, hebt u mogelijk een probleem met de wijze waarop het resource-eindpunt wordt opgegeven in een vaardighedenset:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
Deze fout treedt op als u een gedeelde privékoppeling hebt geconfigureerd voor verbindingen met een Azure Foundry-resource en het eindpunt een aangepast subdomein mist. Een aangepast subdomein is het eerste deel van het eindpunt (bijvoorbeeld http://my-custom-subdomain.services.ai.azure.com). Er ontbreekt mogelijk een aangepast domein als u de resource in de Foundry-portal hebt gemaakt in plaats van Azure Portal.
Als de Foundry-resource zich niet in dezelfde regio bevindt als Azure AI Zoeken, gebruikt u een sleutelloze verbinding om de resource te koppelen.
Fout bij het gebruik van een gedeelde privékoppeling
Als u foutcode 403 krijgt met het volgende bericht, maakt de indexeerfunctie mogelijk verbinding via het openbare eindpunt in plaats van een goedgekeurde gedeelde privékoppeling:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
Deze fout kan optreden wanneer de indexeerfunctie niet is geconfigureerd voor het gebruik van de privé-uitvoeringsomgeving. Controleer of de gedeelde privélink is goedgekeurd, stel de executionEnvironment van de indexeerfunctie in op private, en controleer of de verbinding het juiste resource-eindpunt en de groeps-id gebruikt.
Firewallregels
Azure Storage, Azure Cosmos DB en Azure SQL bieden een configureerbare firewall. Er is geen specifiek foutbericht wanneer de firewall de aanvraag blokkeert. Firewallfouten zijn doorgaans algemeen. Enkele veelvoorkomende fouten zijn:
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
Gebruik een van de volgende opties om indexeerfuncties toegang te geven tot deze resources:
Configureer een binnenkomende regel voor het IP-adres van uw zoekservice en het IP-adresbereik van
AzureCognitiveSearchde servicetag. Zie de volgende koppelingen voor meer informatie over het configureren van beperkingen voor IP-adresbereiken voor elk gegevensbrontype:Als laatste redmiddel of als tijdelijke maatregel schakelt u de firewall uit door toegang vanuit alle netwerken toe te staan.
Beperking: beperkingen voor IP-adresbereiken werken alleen als uw zoekservice en uw opslagaccount zich in verschillende regio's bevinden.
Naast het ophalen van gegevens verzenden indexeerfuncties ook uitgaande aanvragen via vaardighedensets en aangepaste vaardigheden. Voor aangepaste vaardigheden op basis van een Azure-functie moet u er rekening mee houden dat Azure-functies ook IP-adresbeperkingen hebben. De lijst met IP-adressen die doorlaatbaar zijn voor de uitvoering van aangepaste vaardigheden omvat het IP-adres van uw zoekservice en het IP-adresbereik van de AzureCognitiveSearch servicetag.
NSG-regels (netwerkbeveiligingsgroep)
Wanneer een indexeerfunctie toegang heeft tot gegevens in een met SQL beheerd exemplaar of wanneer een Azure-VM wordt gebruikt als de webservice-URI voor een aangepaste vaardigheid, bepaalt de netwerkbeveiligingsgroep of aanvragen zijn toegestaan in.
Voor externe resources die zich in een virtueel netwerk bevinden, configureert u binnenkomende NSG-regels voor de AzureCognitiveSearch servicetag.
Zie Een verbinding met SQL Server configureren op een Azure-VM voor meer informatie over het maken van verbinding met een virtuele machine.
Netwerkfouten
Meestal zijn netwerkfouten algemeen. Enkele veelvoorkomende fouten zijn:
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
Wanneer u een van deze fouten ontvangt:
- Zorg ervoor dat u toegang hebt tot uw bron door er rechtstreeks verbinding mee te maken en niet via de zoekservice.
- Controleer uw resource in de Azure-portal op eventuele huidige fouten of storingen.
- Controleer op netwerkstoringen in Azure Status.
- Controleer of u een openbare DNS gebruikt voor naamomzetting en geen Azure Privé-DNS.
Serverloze indexering van Azure SQL Database (foutcode 40613)
Als uw SQL-database zich op een serverloze rekenlaag bevindt, moet u ervoor zorgen dat de database wordt uitgevoerd (en niet onderbroken) wanneer de indexeerfunctie hiermee verbinding maakt.
Als de database is gepauzeerd, wordt deze bij de eerste aanmelding vanuit uw zoekservice automatisch hervat, maar wordt toch een fout geretourneerd waarin staat dat de database niet beschikbaar is, met foutcode 40613. Nadat de database is uitgevoerd, probeert u zich opnieuw aan te melden om verbinding te maken.
Beleid voor voorwaardelijke toegang van Microsoft Entra
Wanneer u een SharePoint indexeerfunctie maakt, moet u zich aanmelden bij uw Microsoft Entra-app nadat u een apparaatcode hebt opgegeven. Als u een bericht ontvangt met de mededeling"Your sign-in was successful but your admin requires the device requesting access to be managed": een beleid voor voorwaardelijke toegang blokkeert waarschijnlijk de indexeerfunctie uit de SharePoint documentbibliotheek.
Het beleid bijwerken en indexeerfunctietoegang tot de documentbibliotheek toestaan:
Open Azure Portal en zoek naar voorwaardelijke toegang van Microsoft Entra.
Selecteer Beleid in het linkermenu. Als u geen toegang hebt om deze pagina weer te geven, moet u iemand zoeken die toegang heeft, of zelf toegang krijgen.
Bepaal welk beleid de SharePoint-indexeerfunctie blokkeert voor toegang tot de documentbibliotheek. Het beleid dat de indexeerfunctie kan blokkeren, bevat het gebruikersaccount dat u hebt gebruikt om te verifiëren tijdens de stap voor het maken van de indexeerfunctie in de sectie Gebruikers en groepen . Het beleid kan ook voorwaarden hebben die:
- Beperk Windows-platform.
- Mobiele apps en desktopclients beperken.
- Stel de apparaatstatus in op Ja.
Zodra u hebt bevestigd welk beleid de indexeerfunctie blokkeert, maakt u een uitzondering voor de indexeerfunctie. Begin met het ophalen van het IP-adres van de zoekservice.
Haal eerst de FQDN (Fully Qualified Domain Name) van uw zoekservice op. De FQDN ziet er als volgt uit
<your-search-service-name>.search.windows.net. U vindt de FQDN in Azure Portal.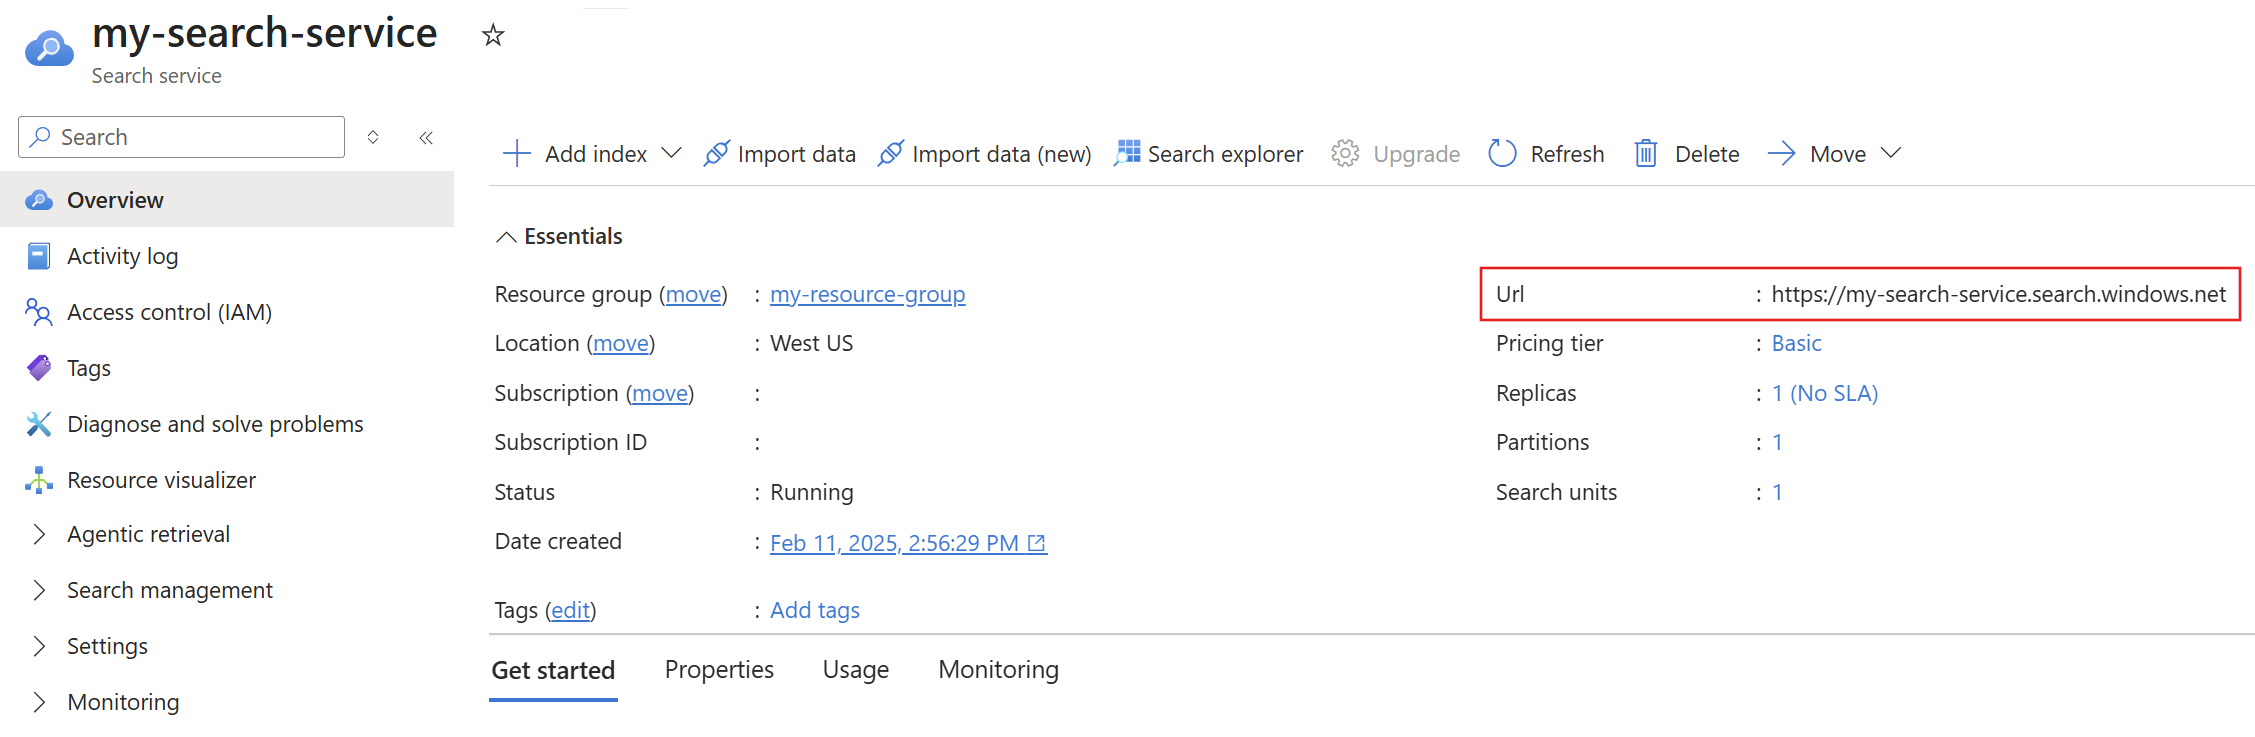
Nu u de FQDN hebt, haalt u het IP-adres van de zoekservice op door een
nslookup(of eenping) van de FQDN uit te voeren. In het volgende voorbeeld voegt u een regel voor inkomend verkeer toe150.0.0.1aan de Azure Storage firewall. Het kan tot 15 minuten duren voordat de firewallinstellingen zijn bijgewerkt voordat de indexeerfunctie van de zoekservice toegang heeft tot het Azure Storage-account.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netHaal de IP-adresbereiken op voor de uitvoeringsomgeving van de indexeerfunctie voor uw regio.
Extra IP-adressen worden gebruikt voor aanvragen die afkomstig zijn van de multitenant-uitvoeringsomgeving van de indexeerfunctie. U kunt dit IP-adresbereik ophalen uit de servicetag.
U kunt de IP-adresbereiken voor de
AzureCognitiveSearchservicetag ophalen via de detectie-API of het downloadbare JSON-bestand.Voor deze oefening, ervan uitgaande dat de zoekservice de Azure openbare cloud is, downloadt u het Azure openbaar JSON-bestand.
Vanuit het JSON-bestand, ervan uitgaande dat de zoekservice zich in VS - west-centraal bevindt, wordt de lijst met IP-adressen voor de uitvoeringsomgeving voor de multitenant-indexeerfunctie vermeld.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
Selecteer op de pagina Voorwaardelijke toegang in Azure Portal Genoemde locaties in het menu aan de linkerkant en selecteer vervolgens + Nieuwe locatie voor IP-bereiken. Geef uw nieuwe benoemde locatie een naam en voeg de IP-bereiken toe voor uw zoekservice- en indexeeromgevingen die u in de laatste twee stappen hebt verzameld. 1
- Voor het IP-adres van uw zoekservice moet u mogelijk '/32' toevoegen aan het einde van het IP-adres, omdat deze alleen geldige IP-bereiken accepteert.
- Houd er rekening mee dat u voor de IP-adresbereiken van de indexeerfunctie alleen de IP-bereiken hoeft toe te voegen voor de regio waarin uw zoekservice zich bevindt.
Sluit de nieuwe benoemde locatie uit van het beleid:
- Selecteer Beleid in het linkermenu.
- Selecteer het beleid dat de indexeerfunctie blokkeert.
- Selecteer Voorwaarden.
- Selecteer Locaties.
- Selecteer Uitsluiten en voeg vervolgens de nieuwe benoemde locatie toe.
- Sla de wijzigingen op .
Wacht enkele minuten totdat het beleid is bijgewerkt en de nieuwe beleidsregels worden afgedwongen.
Probeer de indexeerfunctie opnieuw te maken:
- Verzend een updateaanvraag voor het gegevensbronobject dat u hebt gemaakt.
- De aanvraag voor het maken van de indexeerfunctie opnieuw verzenden. Gebruik de nieuwe code om u aan te melden en vervolgens een andere aanvraag voor het maken van een indexeerfunctie te verzenden.
Niet-ondersteunde documenttypen indexeren
Als u inhoud van Azure Blob Storage indexeert en de container blobs van een niet-ondersteund inhoudstype bevat, slaat de indexeerfunctie dat document over. In andere gevallen kunnen er problemen zijn met afzonderlijke documenten.
In dit geval kunt u configuratieopties instellen zodat de verwerking van indexeerfuncties kan worden voortgezet als er problemen zijn met afzonderlijke documenten.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Ontbrekende documenten
Indexeerfuncties extraheren documenten of rijen uit een externe gegevensbron en maken zoekdocumenten, die door de zoekservice worden geïndexeerd. Af en toe kan een document in de gegevensbron niet worden weergegeven in een zoekindex. Dit onverwachte resultaat kan worden veroorzaakt door de volgende redenen:
- U hebt het document bijgewerkt nadat de indexeerfunctie is uitgevoerd. Als uw indexeerfunctie volgens een schema staat, wordt het document uiteindelijk opnieuw uitgevoerd en opgehaald.
- Er is een time-out opgetreden voordat het document kan worden opgenomen. Er zijn maximale verwerkingstijdlimieten waarna er geen documenten worden verwerkt. U kunt de status van de indexeerfunctie controleren in Azure Portal of door de Status van de indexeerfunctie (REST API) aan te roepen.
- Veldtoewijzingen of AI-verrijking hebben het document gewijzigd en de bijbehorende articulatie in de zoekindex verschilt van wat u verwacht.
- Waarden voor het bijhouden van wijzigingen zijn onjuist of vereisten ontbreken. Als uw hoge grenswaarde een datum is die is ingesteld op een toekomstige tijd, slaat de indexeerfunctie alle documenten over die een eerdere datum hebben. U kunt de status van het bijhouden van wijzigingen van de indexeerfunctie bepalen met behulp van de
initialTrackingStateenfinalTrackingStatevelden in de status van de indexeerfunctie. Indexeerfuncties voor Azure SQL en MySQL moeten een index hebben op de kolom met hoge watermarkeringen van de brontabel, of query's die door de indexeerfunctie worden gebruikt, kunnen een time-out hebben.
Aanbeveling
Als documenten ontbreken, controleert u de query die u gebruikt om ervoor te zorgen dat het betreffende document niet wordt uitgesloten. Gebruik de Lookup Document REST API om een specifiek document op te vragen.
Ontbrekende inhoud in Blob Storage
De blob-indexeerfunctie zoekt en extraheert tekst uit blobs in een container. Enkele problemen met het extraheren van tekst zijn:
Het document bevat alleen gescande afbeeldingen. PDF-blobs met niet-tekstinhoud, zoals gescande afbeeldingen (JPG's), produceren geen resultaten in een standaard-blobindexeringspijplijn. Als u afbeeldingsinhoud met tekstelementen hebt, kunt u OCR of afbeeldingsanalyse gebruiken om de tekst te zoeken en te extraheren.
De blob-indexeerfunctie is geconfigureerd voor alleen indexmetagegevens. Als u inhoud wilt extraheren, moet u de blob-indexeerfunctie configureren om zowel inhoud als metagegevens te extraheren:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Ontbrekende inhoud in Azure Cosmos DB
Azure AI Zoeken heeft een impliciete afhankelijkheid van azure Cosmos DB-indexering. Als u automatische indexering in Azure Cosmos DB uitschakelt, retourneert Azure AI Zoeken een geslaagde status, maar kan de inhoud van de container niet indexeren. Zie Indexering beheren in Azure Cosmos DB voor instructies over het controleren van instellingen en het inschakelen van indexering.
Afwijking van het aantal documenten tussen de gegevensbron en de index
Een indexeerfunctie kan een ander aantal documenten weergeven dan de gegevensbron, de index zelf of het aantal in uw code. Hier volgen enkele mogelijke redenen waarom dit gedrag kan optreden:
- De index kan vertraging vertonen bij het weergeven van het werkelijke aantal documenten, met name in Azure Portal.
- De indexeerfunctie heeft een verwijderd documentbeleid. De verwijderde documenten worden geteld door de indexeerfunctie als de documenten worden geïndexeerd voordat ze worden verwijderd.
- Als de id-kolom in de gegevensbron niet uniek is. Deze voorwaarde is van toepassing op gegevensbronnen met het concept kolommen, zoals Azure Cosmos DB.
- Als de definitie van de gegevensbron een andere query heeft dan de definitie die u gebruikt om het aantal records te schatten. In uw database voert u bijvoorbeeld een query uit op het aantal databaserecords, terwijl u in de definitiequery voor de gegevensbron slechts een subset records selecteert die u wilt indexeren.
- De aantallen worden gecontroleerd met verschillende intervallen voor elk onderdeel van de pijplijn: gegevensbron, indexeerfunctie en index.
- De gegevensbron heeft een bestand dat is geconfigureerd voor veel documenten. Deze voorwaarde kan optreden wanneer het indexeren van blobs plaatsvindt en 'parsingMode' is ingesteld op
jsonArrayenjsonLines.
Documenten die meerdere keren worden verwerkt
Indexeerfuncties gebruiken een conservatieve bufferstrategie om ervoor te zorgen dat elk nieuw en gewijzigd document in de gegevensbron wordt opgehaald tijdens het indexeren. In bepaalde situaties kunnen deze buffers elkaar overlappen, waardoor een indexeerfunctie een document twee of meer keer kan indexeren. Als gevolg hiervan is het aantal verwerkte documenten meer dan het werkelijke aantal documenten in de gegevensbron. Dit gedrag heeft geen invloed op de gegevens die zijn opgeslagen in de index, zoals het dupliceren van documenten, alleen dat het langer kan duren om uiteindelijke consistentie te bereiken. Deze voorwaarde komt vooral voor als aan een van de volgende criteria wordt voldaan:
- Aanvragen voor indexeerfunctie op aanvraag worden snel achter elkaar uitgegeven.
- De topologie van de gegevensbron bevat meerdere replica's en partities, zoals de topologie die wordt beschreven in consistentieniveaus in Azure Cosmos DB.
- De gegevensbron is een Azure SQL database en de kolom die is gekozen als 'hoog waterteken' is van het type
datetime2.
Indexeerfuncties zijn niet bedoeld om meerdere keren achter elkaar aan te roepen. Als u snel updates nodig hebt, is de ondersteunde methode het pushen van updates naar de index terwijl de gegevensbron tegelijkertijd wordt bijgewerkt. Voor verwerking op aanvraag voert u uw aanvragen in intervallen van vijf minuten of meer af en voert u de indexeerfunctie uit volgens een schema.
Voorbeeld van dubbele documentverwerking met buffer van 30 seconden
In de volgende tijdlijn worden de voorwaarden uitgelegd waaronder een document tweemaal wordt verwerkt. Het noteert elke actie en tegenactie. De volgende tijdlijn illustreert het probleem:
| Tijdlijn (uu:mm:ss) | Gebeurtenis | Indexeerfunctie hoog watermerk | Opmerking |
|---|---|---|---|
| 00:01:00 | Schrijven doc1 naar gegevensbron met uiteindelijke consistentie |
null |
De tijdstempel van het document is 00:01:00. |
| 00:01:05 | Schrijven doc2 naar gegevensbron met uiteindelijke consistentie |
null |
De tijdstempel van het document is 00:01:05. |
| 00:01:10 | Indexeerfunctie wordt gestart | null |
|
| 00:01:11 | De indexeerfunctie vraagt om alle wijzigingen voor 00:01:10; de replica waar de indexeerder naar vraagt is slechts op de hoogte van doc2; alleen doc2 wordt opgehaald |
null |
De indexeerfunctie vraagt om alle wijzigingen van vóór een bepaalde tijdstempel, maar ontvangt uiteindelijk slechts een subset. Dit gedrag vereist de terugblikbufferperiode. |
| 00:01:12 | Indexeerprogramma verwerkt doc2 voor de eerste keer |
null |
|
| 00:01:13 | Indexeerfunctie eindigt | 00:01:10 | Hoogwatermerk wordt bijgewerkt naar het begintijdsstempel van de huidige indexatieve uitvoering. |
| 00:01:20 | Indexeerfunctie wordt gestart | 00:01:10 | |
| 00:01:21 | Indexeer zoekt naar alle wijzigingen tussen 00:00:40 en 00:01:20; de door de indexeerfunctie geraadpleegde replica is op de hoogte van zowel doc1 als doc2; haalt doc1 en doc2 op |
00:01:10 | Indexeerfunctieaanvragen voor alle wijzigingen tussen de huidige hoge watermarkering min de buffer van 30 seconden en de begintijdstempel van de huidige indexeerfunctieuitvoering. |
| 00:01:22 | Indexeerprogramma verwerkt doc1 voor de eerste keer |
00:01:10 | |
| 00:01:23 | Indexeerprogramma verwerkt doc2 voor de tweede keer |
00:01:10 | |
| 00:01:24 | Indexeerfunctie eindigt | 00:01:20 | Hoogwatermerk wordt bijgewerkt naar het begintijdsstempel van de huidige indexatieve uitvoering. |
| 00:01:32 | Indexeerfunctie wordt gestart | 00:01:20 | |
| 00:01:33 | De indexeerder voert query's uit voor alle wijzigingen tussen 00:00:50 en 00:01:32; haalt doc1 en doc2 op. |
00:01:20 | Indexeerfunctieaanvragen voor alle wijzigingen tussen de huidige hoge watermarkering min de buffer van 30 seconden en de begintijdstempel van de huidige indexeerfunctieuitvoering. |
| 00:01:34 | Indexeerprogramma verwerkt doc1 voor de tweede keer |
00:01:20 | |
| 00:01:35 | Indexeerfunctie verwerkt doc2 voor de derde keer |
00:01:20 | |
| 00:01:36 | Indexeerfunctie eindigt | 00:01:32 | Hoogwatermerk wordt bijgewerkt naar het begintijdsstempel van de huidige indexatieve uitvoering. |
| 00:01:40 | Indexeerfunctie wordt gestart | 00:01:32 | |
| 00:01:41 | Indexerqueries voor alle wijzigingen tussen 00:01:02 en 00:01:40; opgehaald doc2 |
00:01:32 | Indexeerfunctieaanvragen voor alle wijzigingen tussen de huidige hoge watermarkering min de buffer van 30 seconden en de begintijdstempel van de huidige indexeerfunctieuitvoering. |
| 00:01:42 | Indexer verwerkt doc2 voor de vierde keer |
00:01:32 | |
| 00:01:43 | Indexeerfunctie eindigt | 00:01:40 | Merk op dat deze indexeerfunctie meer dan 30 seconden na de laatste schrijfbewerking naar de gegevensbron is gestart en doc2 ook is verwerkt. Dit is het verwachte gedrag omdat als alle indexeerfuncties vóór 00:01:35 worden geëlimineerd, dit de eerste en enige uitvoering wordt om te verwerken doc1 en doc2. |
In de praktijk gebeurt dit scenario alleen wanneer u binnen enkele minuten van elkaar handmatig indexeerfuncties op aanvraag aanroept, voor bepaalde gegevensbronnen. Dit kan resulteren in niet-overeenkomende getallen (zoals de indexeerfunctie verwerkt 345 documenten in totaal volgens de uitvoeringsstatistieken van de indexeerfunctie, maar er zijn 340 documenten in de gegevensbron en index) of mogelijk verhoogde facturering als u meerdere keren dezelfde vaardigheden voor hetzelfde document uitvoert. Het uitvoeren van een indexeerfunctie volgens een schema is de aanbevolen aanbeveling.
Parallelle indexering
Wanneer meerdere indexeerfuncties tegelijkertijd worden uitgevoerd, voeren sommige indexeerfuncties doorgaans een wachtrij in en wachten ze op beschikbare resources voordat ze beginnen. Verschillende factoren bepalen hoeveel indexeerfuncties gelijktijdig kunnen worden uitgevoerd. Als de indexeerfuncties geen koppeling maken naar vaardighedensets, bepaalt het aantal replica's en partities in de AI Search-service hoeveel indexeerfuncties parallel kunnen worden uitgevoerd.
Als u een indexeerfunctie koppelt aan een vaardighedenset, wordt deze uitgevoerd binnen de interne AI Search-clusters. De complexiteit van de vaardighedenset en of andere vaardighedensets tegelijkertijd worden uitgevoerd, bepalen hoeveel indexeerfuncties gelijktijdig kunnen worden uitgevoerd. Ingebouwde indexeerfuncties extraheren betrouwbaar gegevens uit de bron, dus er worden geen gegevens gemist als ze volgens een schema worden uitgevoerd. De indexeerfunctieprocessen voor parallellisatie en uitschalen hebben echter enige tijd nodig om te voltooien.
Documenten indexeren met vertrouwelijkheidslabels
Als u vertrouwelijkheidslabels instelt voor documenten, kunt u deze mogelijk niet indexeren. Als er fouten optreden, verwijdert u de labels voordat u indexeert.