참고
Azure AI 검색 Azure 포털, REST API 및 Azure SDK 통해 사용할 수 있습니다. 또한 엔터프라이즈 콘텐츠를 Microsoft Foundry 포털의 에이전트에 대해 재사용 가능한 사용 권한 인식 기술 자료로 변환하는 관리되는 기술 계층인 Foundry IQ를 뒷받침합니다.
중요
기능, 기능 또는 표시된 속성(미리 보기)은 서비스 수준 계약에 포함되지 않으며 프로덕션 워크로드에는 권장되지 않으며 일반적으로 사용 가능해지기 전에 변경되거나 제한될 수 있습니다. Azure AI 검색 미리 보기 용어는 독립 실행형 기능이든 일반 공급 기능의 일부이든 관계없이 모든 미리 보기 기능에 적용됩니다.
Azure AI 검색에서는 필터 식을 사용하여 포함 및 제외 조건을 벡터 쿼리에 추가할 수 있습니다. 필터를 적용하는 필터링 모드를 지정할 수도 있습니다.
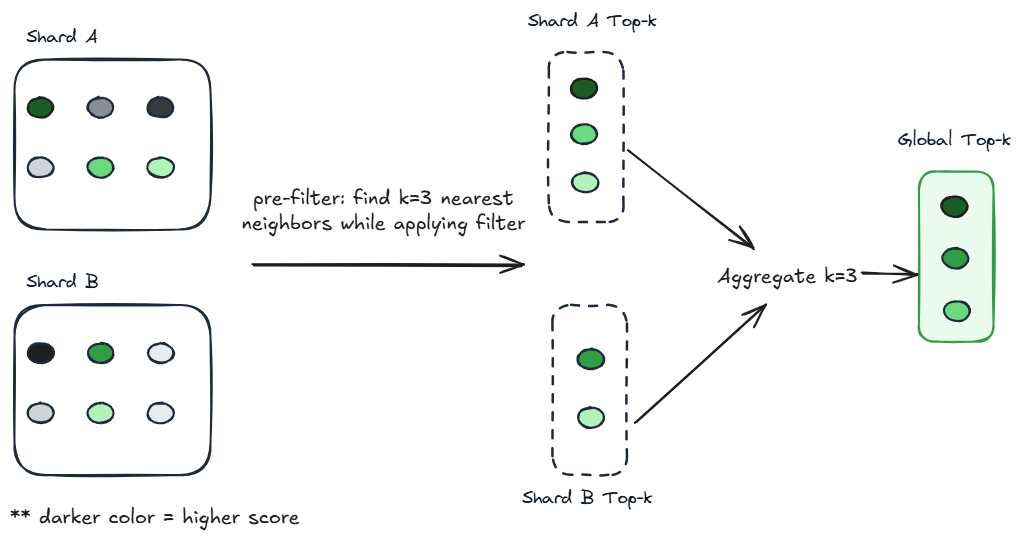
- 쿼리를 실행하기 전에 미리 필터링이라고 합니다.
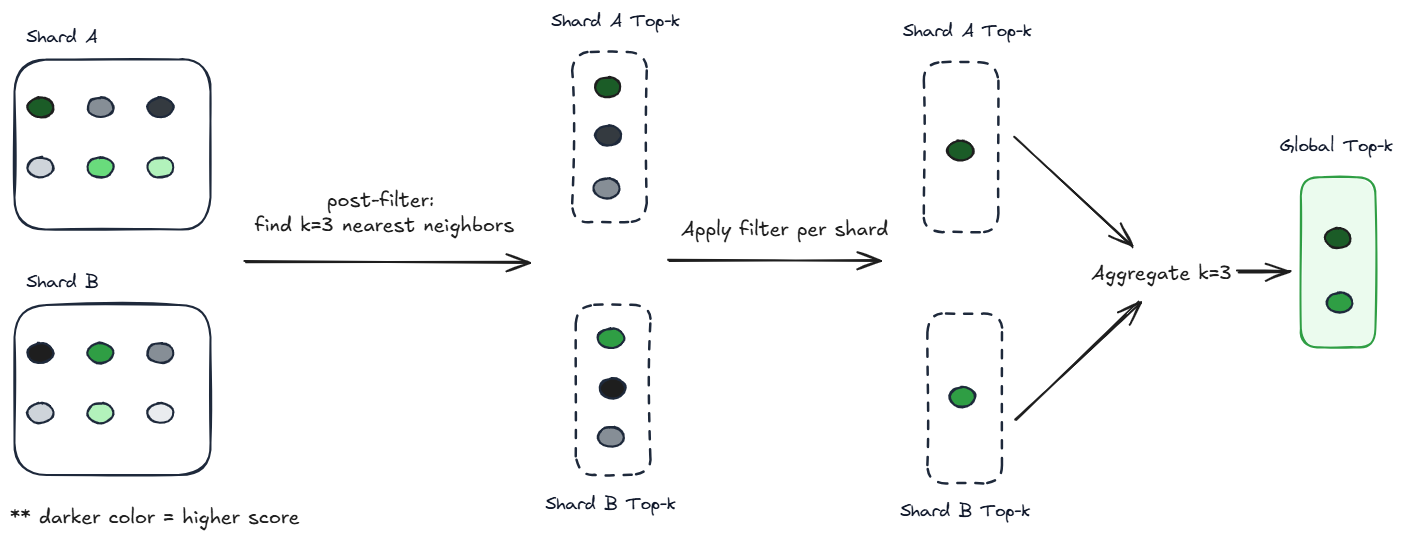
- 쿼리 실행 후 사후 필터링이라고 합니다.
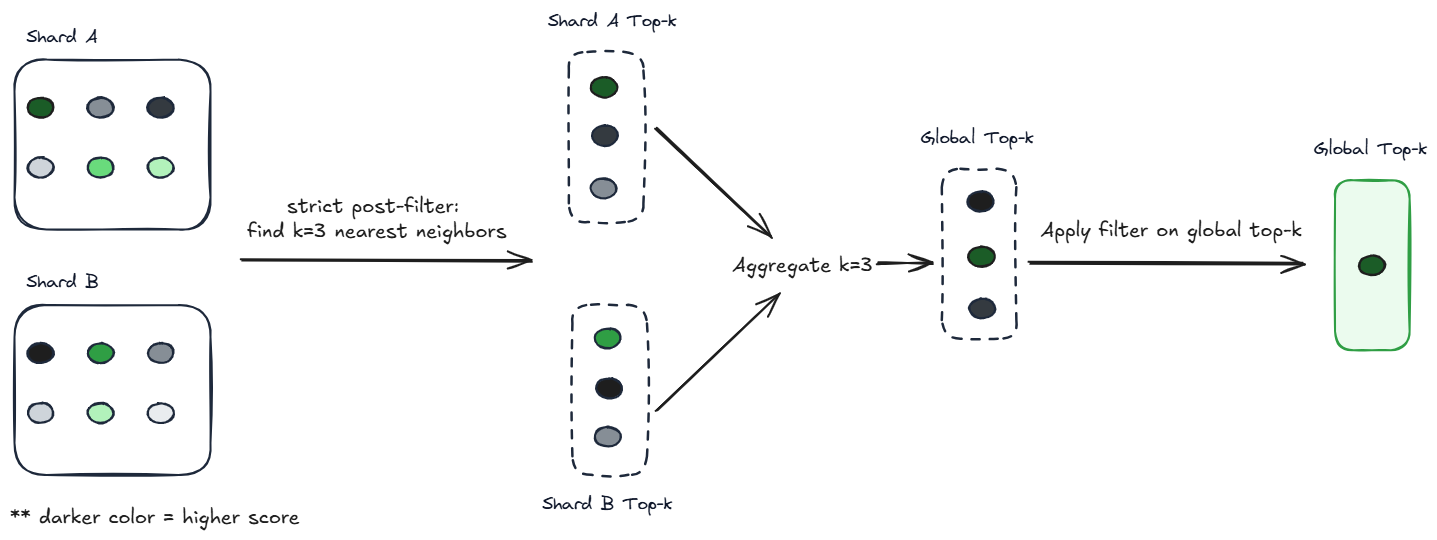
- 전 세계 최상위 결과가 식별된 후에는 이를
k(미리 보기)이라고 합니다.
이 문서에서는 그림에 REST를 사용합니다. 벡터 쿼리를 포함하는 다른 언어 및 엔드투엔드 솔루션의 코드 샘플은 azure-search-vector-samples GitHub 리포지토리를 참조하세요.
Azure 포털에서 Search Explorer를 사용하여 벡터 콘텐츠를 쿼리할 수도 있습니다. JSON 보기에서 필터를 추가하고 필터 모드를 지정할 수 있습니다.
벡터 쿼리에서 필터링이 작동하는 방식
Azure AI 검색 ANN(근사한 이웃) 검색에 HNSW(계층적 탐색 가능 Small World) 알고리즘을 사용하여 여러 분할된 데이터베이스에 HNSW 그래프를 저장합니다. 각 분할된 데이터베이스에는 전체 인덱스의 일부가 포함됩니다.
필터는 필터 조건에 따라 검색 문서를 포함하거나 제외하기 위해 filterable 문자열 또는 숫자의 비벡터 필드에 적용됩니다. 벡터 필드 자체는 필터링할 수 없지만 동일한 인덱스의 다른 필드에 대한 필터를 사용하여 벡터 검색으로 간주되는 문서의 범위를 좁힐 수 있습니다. 인덱스에 적합한 텍스트 또는 숫자 필드가 없는 경우 필터링에 도움이 될 수 있는 문서 메타데이터(예: LastModified 또는 CreatedBy 속성)를 확인하십시오.
매개 변수는 vectorFilterMode 검색 단계에서 필터 작업이 적용되는 위치를 제어하며, 이는 결과가 항목의 하위 집합(예: 범주, 태그 또는 기타 특성)으로 필터링되는 방식에 영향을 미치고 대기 시간, 회수 및 처리량에 영향을 줍니다. 세 가지 모드가 있습니다.
preFilter는 각 샤드의 HNSW 순회 중에 필터를 적용합니다. 이 모드는 회수를 최대화하지만 더 많은 그래프를 트래버스하여 매우 선택적인 필터에 대한 CPU 및 대기 시간을 늘릴 수 있습니다.postFilter는 각 분할된 데이터베이스에 대해 독립적으로 HNSW 순회 및 필터링을 실행하고, 분할된 데이터베이스 수준에서 결과를 교차한 다음, 각 분할된 데이터베이스의 상위k를 전역 상위k로 집계합니다. 이 모드는 선택성이 높은 필터나 작은k값에 대해 가음성을 만들 수 있습니다.strictPostFilter(미리 보기)는 필터를 적용k필터링되지 않은 전역 상단 을 찾습니다. 이 모드는 매우 선택적인 필터와 작은k값에 대해 위음성이 발생할 위험이 가장 높습니다.
이러한 모드에 대한 자세한 내용은 필터 모드 설정을 참조하세요.
필터 정의
필터는 벡터 쿼리의 범위를 결정하며 문서 - 검색 게시물(REST API)을 사용하여 정의됩니다. 미리 보기 기능을 사용하지 않으려면 안정적인 최신 버전의 Search Service REST API 를 사용하여 요청을 작성합니다.
이 REST API는 다음을 제공합니다.
-
filter기준에 대한 것입니다. -
vectorFilterMode벡터 쿼리 중에 필터가 적용되는 시기를 지정합니다. 지원되는 모드는 필터 모드 설정을 참조하세요.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
이 예제에서 벡터 임베딩은 contentVector 필드를 대상으로 하며, 필터 조건은 category라는 필터링 가능한 텍스트 필드에 적용됩니다. 모드가 preFilter 사용되므로 검색 엔진이 쿼리를 실행하기 전에 필터가 적용되므로 범주의 Databases 문서만 벡터 검색 중에 고려됩니다.
필터 모드 설정
매개 변수는 vectorFilterMode 벡터 쿼리 실행을 기준으로 필터가 적용되는 시기와 방법을 결정합니다. 다음 모드를 사용할 수 있습니다.
-
preFilter(권장) postFilter-
strictPostFilter(미리 보기)
참고
preFilter 는 2023년 10월 15일 이후에 생성된 인덱스의 기본값입니다. 이 날짜 postFilter 이전에 만든 인덱스의 경우 기본값입니다. 벡터 압축과 같은 기타 고급 벡터 기능을 사용 preFilter 하려면 인덱스 다시 만들어야 합니다.
REST API 버전 이상에서 "vectorFilterMode": "preFilter" 벡터 쿼리 2023-10-01-preview 를 전송하여 호환성을 테스트할 수 있습니다. 쿼리가 실패하면, 귀하의 인덱스는 preFilter를 지원하지 않습니다.
사전 필터링은 쿼리 실행 전에 필터를 적용하여 벡터 검색 알고리즘에 대한 후보 집합을 줄입니다. 그러면 필터링된 이 집합에서 상위k 결과가 선택됩니다.
벡터 쿼리 preFilter 에서는 대기 시간보다 회수 및 품질을 선호하기 때문에 기본 모드입니다.
이 모드의 작동 방식
각 샤드에서 HNSW 순회 중에 필터 프레디케이트를 적용하여
k후보가 발견될 때까지 그래프를 확장합니다.샤드마다 미리 필터링된 로컬 상위
k결과를 생성합니다.필터링된 결과를 전역 상위
k결과 집합으로 집계합니다.
이 모드의 효과
특히 필터가 선택적인 경우, 트래버설은 검색 범위를 확장하여 필터링된 후보를 더 많이 찾을 수 있도록 합니다. 이렇게 하면 모든 분할된 데이터베이스에서 가장 유사한 상위k 결과가 생성됩니다. 각 샤드는 필터 조건을 k 충족하는 결과를 식별합니다.
사전 필터링은 인덱스에 k 있는 경우 결과가 반환되도록 보장합니다. 매우 선택적인 필터의 경우 이로 인해 그래프의 상당 부분이 트래버스되어 처리량을 줄이면서 계산 비용 및 대기 시간이 증가할 수 있습니다. 필터가 매우 선택적이고(일치하는 항목이 거의 없는 경우) 경우, exhaustive: true를 사용하여 철저한 검색을 수행하는 것을 고려하는 것이 좋습니다.
비교 테이블
| 모드 | 회수(필터링된 결과) | 계산 비용 | 위음성 위험 | 사용 시기 |
|---|---|---|---|---|
preFilter |
매우 높음 | 더 높아집니다(필터 선택성 및 복잡성에 따라 증가) | 위험 없음 | 모든 시나리오에 권장되는 기본값 |
postFilter |
중간에서 높음(필터 선택성이 높아질수록 감소) | 필터링되지 않은 것과 유사하지만 필터 복잡성이 증가합니다. | 보통(분할당 일치 항목을 놓칠 수 있음) | 너무 선택적이지 않은 필터 및 상위k 쿼리에 대한 옵션입니다. |
strictPostFilter |
가장 낮음(필터 선택성을 사용하여 가장 빠르게 감소) | 필터링되지 않은 것과 유사 | 가장 높음(선택적인 필터 또는 작은 k에 대해 0개의 결과를 반환할 수 있음) |
필터를 적용한 뒤에도 더 많은 결과를 노출해 사용자 경험에 더 큰 영향을 미쳐야 하는, 거짓 부정의 위험보다 패싯 검색 애플리케이션에서 더 중요한 옵션입니다. 작은 k과 함께 사용하지 마세요. |
사전 필터링 및 사후 필터링의 벤치마크 테스트
중요
이 섹션은 엄격한 사후 필터링이 아니라 사전 필터링 및 사후 필터링에 적용됩니다.
한 필터 모드가 다른 필터 모드보다 더 잘 수행되는 조건을 이해하기 위해 일련의 테스트를 실행하여 소형, 중간 및 대형 인덱스에 대한 쿼리 결과를 평가했습니다.
- 작음(문서 100,000개, 2.5GB 인덱스, 1,536차원)
- 중간(문서 100만 개, 25GB 인덱스, 1,536차원)
- 대형(문서 10억 개, 1.9TB 인덱스, 96차원)
중소 규모의 워크로드의 경우 파티션 1개와 복제본 1개를 사용하는 Standard 2(S2) 서비스를 사용했습니다. 대규모 워크로드의 경우 12개의 파티션과 1개의 복제본이 있는 표준 3(S3) 서비스를 사용했습니다.
인덱스에는 키 필드 1개, 벡터 필드 1개, 텍스트 필드 1개, 필터링 가능한 숫자 필드 1개 등 동일한 구조가 있습니다. 다음 인덱스는 2023-11-01 구문을 사용하여 정의됩니다.
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
쿼리에서는 프리필터 및 사후 필터 작업 모두에 동일한 필터를 사용했습니다. 간단한 필터를 사용하여 필터 복잡성이 아니라 필터링 모드로 인한 성능 변화를 확인했습니다.
결과는 QPS(초당 쿼리)로 측정되었습니다.
요점
성능이 거의 같은 작은 인덱스를 제외하고, 사전 필터링은 거의 항상 사후 필터링보다 느립니다.
더 큰 데이터 세트에서는 사전 필터링이 훨씬 더 느립니다.
거의 항상 느린 경우 프리필터가 기본값인 이유는 무엇인가요? 미리 필터링은 결과가 인덱스에 존재하는 경우 반드시
k결과를 반환하는 것을 보장합니다. 여기서 편향은 속도보다 재현율과 정확성을 중시합니다.다음과 같은 경우 사후 필터링을 사용합니다.
선택보다 속도를 중시하세요(사후 필터링은
k개 미만의 결과를 반환할 수 있습니다).지나치게 선택적이지 않은 필터를 사용합니다.
사전 필터링 성능이 허용되지 않는 충분한 크기의 인덱스를 갖습니다.
세부 정보
1,536차원에서 100,000개의 벡터가 있는 데이터 세트를 지정합니다.
데이터 세트의 30개 이상의% 필터링할 때는 프리필터링 및 사후 필터링을 비교할 수 있었습니다.
데이터 세트의 0.1% 미만을 필터링할 때, 사전 필터링이 사후 필터링보다 약 50% 느렸습니다.
1,536차원에서 100만 개의 벡터가 있는 데이터 세트를 지정합니다.
데이터 세트에서 30% 이상을 걸러낼 때는 접두사 필터링이 약 30% 더 느린 것으로 나타났습니다.
데이터 세트의 2% 미만을 필터링할 때 사전 필터링은 약 7배 느렸습니다.
96차원에서 10억 개의 벡터가 있는 데이터 세트를 지정합니다.
데이터 세트의 5개 이상의% 필터링할 때 프리필터링 속도가 약 50% 느렸습니다.
데이터 세트의 10개 미만% 필터링할 때 사전 필터링은 약 7배 느렸습니다.
다음 그래프는 후처리 QPS로 나눈 프리필터 QPS로 계산된 프리필터 상대적 QPS를 보여줍니다.
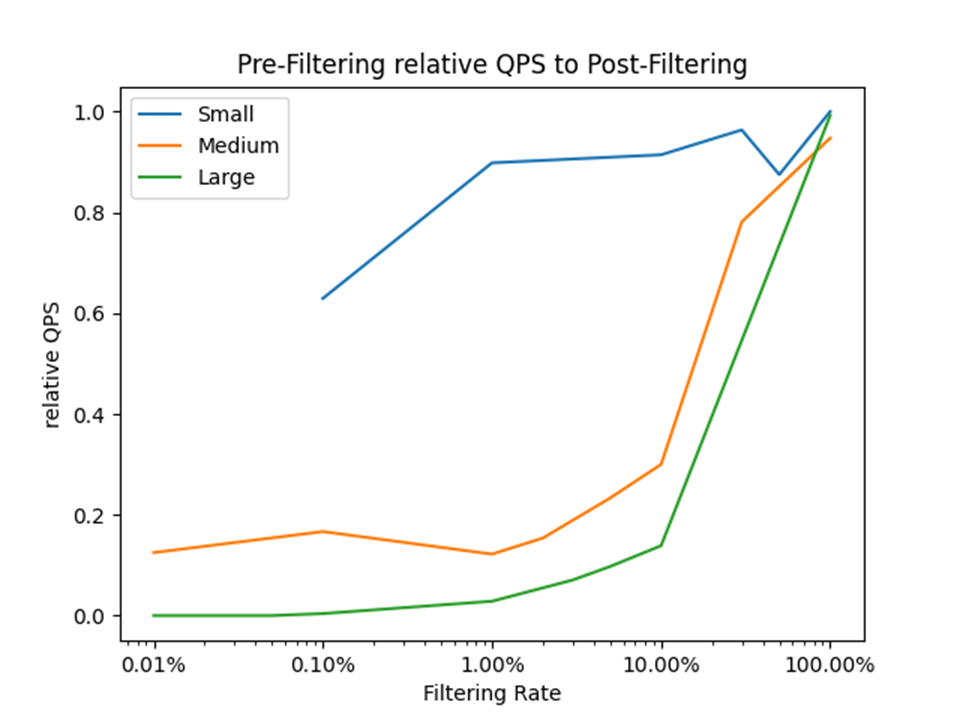
세로 축은 사후 필터링에 비해 사전 필터링의 상대적 성능을 나타내며 QPS(초당 쿼리 수)의 비율로 표현됩니다. 예를 들어:
-
0.0즉, 사전 필터링 값은 100% 후 필터링보다 느립니다. -
0.5의 값은 프리필터링이 50% 더 느리다는 것을 의미합니다. - 미리 필터링 및 사후 필터링의
1.0값은 동일합니다.
가로 축은 필터를 적용한 후 필터링 속도 또는 후보 문서의 백분율을 나타냅니다. 예를 들어, 비율이 1.00%이면 필터 조건이 검색 데이터 집합의 1%를 선정했음을 의미합니다.