참고
Azure AI 검색 Azure 포털, REST API 및 Azure SDK 통해 사용할 수 있습니다. 또한 엔터프라이즈 콘텐츠를 Microsoft Foundry 포털의 에이전트에 대해 재사용 가능한 사용 권한 인식 기술 자료로 변환하는 관리되는 기술 계층인 Foundry IQ를 뒷받침합니다.
전체 텍스트 검색은 인덱스에 저장된 일반 텍스트와 일치하는 정보 검색의 접근 방식입니다. 예를 들어 "해변에 있는 샌디에이고 호텔"이라는 쿼리 문자열이 지정된 경우 검색 엔진은 해당 용어에 따라 토큰화된 문자열을 찾습니다. 검색을 보다 효율적으로 만들기 위해 쿼리 문자열은 어휘 분석을 거칩니다. 즉, 모든 용어의 대/소문자를 낮추고, "the"와 같은 중지 단어를 제거하고, 용어를 기본 루트 형식으로 줄입니다. 일치하는 용어가 발견되면 검색 엔진은 문서를 검색하고 관련성 순서대로 순위를 지정하며 상위 결과를 반환합니다.
쿼리 실행은 복잡할 수 있습니다. 이 문서는 Azure AI 검색 전체 텍스트 검색이 작동하는 방식을 더 깊이 이해해야 하는 개발자를 위한 것입니다. 텍스트 쿼리의 경우, Azure AI 검색는 대부분의 시나리오에서 예상한 대로 결과를 원활하게 제공하지만, 때때로 다소 엉뚱한 결과를 얻을 수 있습니다. 이러한 상황에서는 Lucene 쿼리 실행의 4단계(쿼리 구문 분석, 어휘 분석, 문서 일치 및 점수 매기기)에 대한 배경 지식이 있으면 원하는 결과를 생성하는 쿼리 매개 변수 또는 인덱스 구성에 대한 특정 변경 내용을 식별하는 데 도움이 될 수 있습니다.
참고
Azure AI 검색 전체 텍스트 검색에 Apache Lucene 사용하지만 Lucene 통합은 완전하지 않습니다. Azure AI 검색 중요한 시나리오를 사용하도록 Lucene 기능을 선택적으로 노출하고 확장합니다.
아키텍처 개요 및 다이어그램
쿼리 실행에는 다음 네 단계가 있습니다.
- 쿼리 구문 분석
- 어휘 분석
- 문서 검색
- 점수
전체 텍스트 검색 쿼리는 쿼리 텍스트를 구문 분석하여 검색 용어 및 연산자를 추출하는 것으로 시작합니다. 속도와 복잡성 중에서 선택할 수 있도록 두 개의 파서가 있습니다. 분석 단계는 다음 단계로, 개별 쿼리 용어가 때때로 세분화되고 새 형식으로 재구성됩니다. 이 단계는 잠재적 일치 항목으로 간주될 수 있는 것을 더 폭넓게 탐색하는 데 도움이 됩니다. 검색 엔진은 인덱스를 검색하여 일치하는 용어를 찾고 각 일치를 평가합니다. 그런 다음 결과 집합은 일치하는 각 개별 문서에 할당된 관련성 점수를 기준으로 정렬됩니다. 순위가 지정된 목록의 맨 위에 있는 항목은 호출 애플리케이션에 반환됩니다.
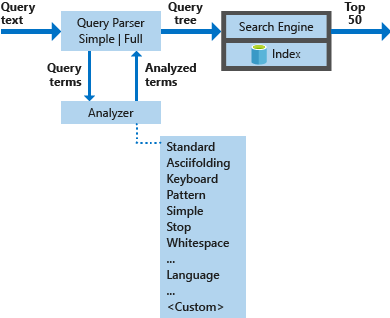
다음 다이어그램에서는 검색 요청을 처리하는 데 사용되는 구성 요소를 보여 줍니다.
| 주요 구성 요소 | 기능 설명 |
|---|---|
| 쿼리 파서 | 쿼리 연산자와 쿼리 용어를 분리하고 검색 엔진에 보낼 쿼리 구조(쿼리 트리)를 만듭니다. |
| 분석기 | 쿼리 용어에 대한 어휘 분석을 수행합니다. 이 프로세스에는 쿼리 용어 변환, 제거 또는 확장이 포함될 수 있습니다. |
| 인덱스 | 인덱싱된 문서에서 추출된 검색 가능한 용어를 저장하고 구성하는 데 사용되는 효율적인 데이터 구조입니다. |
| 검색 엔진 | 반전된 인덱스의 내용을 기반으로 일치하는 문서를 검색하고 점수를 매깁니다. |
검색 요청의 해부
검색 요청은 결과 집합에 반환되어야 하는 내용의 전체 사양입니다. 가장 간단한 형식으로, 어떤 종류의 조건도 없는 빈 쿼리입니다. 보다 현실적인 예제에는 매개 변수, 여러 쿼리 용어, 특정 필드로 범위가 지정될 수 있으며, 필터 식 및 순서 지정 규칙이 있을 수 있습니다.
다음 예제는 REST API 사용하여 Azure AI 검색 보낼 수 있는 검색 요청입니다.
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
이 요청의 경우 검색 엔진은 다음 작업을 수행합니다.
가격이 $60 이상이고 $300 미만인 문서를 찾습니다.
쿼리를 실행합니다. 이 예제에서 검색 쿼리는 구와 용어
"Spacious, air-condition* +\"Ocean view\""로 구성됩니다. (사용자는 일반적으로 문장 부호를 입력하지 않지만 예제에 포함하면 분석기가 이를 처리하는 방법을 설명할 수 있습니다.)이 쿼리에 대해 검색 엔진은 "searchFields"에 지정된 설명 및 제목 필드를 검색하여
"Ocean view"를 포함하는 문서를 검색하고, 추가로"spacious"용어에 대해 또는 접두어"air-condition"로 시작하는 용어에 대해 검색합니다. "searchMode" 매개 변수는 기본값으로 모든 용어 중 아무거나 일치시키거나 또는 모든 용어와 일치시키기 위해 사용됩니다. 이는 매개 변수가 명시적으로 필요하지 않은 경우에 적용됩니다 (+).지정된 지리 위치에 근접하여 결과 호텔 집합을 주문한 다음 호출 애플리케이션에 결과를 반환합니다.
이 문서의 대부분은 검색 쿼리"Spacious, air-condition* +\"Ocean view\"" 처리에 관한 것입니다. 필터링 및 순서 지정이 범위를 벗어났습니다. 자세한 내용은 Search API 참조 설명서를 참조하세요.
1단계: 쿼리 구문 분석
언급했듯이 쿼리 문자열은 요청의 첫 번째 줄입니다.
"search": "Spacious, air-condition* +\"Ocean view\"",
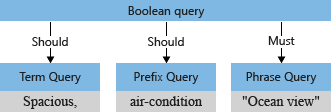
쿼리 파서는 연산자(예: *+ 예제)를 검색 용어와 분리하고 검색 쿼리를 지원되는 형식의 하위 쿼리 로 분해합니다.
- 독립적으로 사용되는 용어에 대한 용어 쿼리(예: 넓음)
- 따옴표 붙은 용어에 대한 구문 조회(예: 바다 전망)
-
접두사 쿼리 는 접두사 연산자
*이(가) 뒤에 오는 용어 예시 (예: air-condition)
지원되는 쿼리 형식의 전체 목록은 Lucene 쿼리 구문을 참조하세요.
하위 쿼리와 연결된 연산자는 쿼리를 만족시켜야 하는지 혹은 만족할 수도 있는지를 결정함으로써 문서가 일치하는지 여부를 평가합니다. 예를 들어 +"Ocean view"에 + 연산자가 붙었기 때문에 "반드시" 만족되어야 합니다.
쿼리 파서는 하위 쿼리를 검색 엔진에 전달하는 쿼리 트리 (쿼리를 나타내는 내부 구조)로 재구성합니다. 쿼리 구문 분석의 첫 번째 단계에서 쿼리 트리는 다음과 같습니다.
지원되는 파서: 단순(simple) 및 전체(full) Lucene
Azure AI 검색 simple(기본값) 및 full 두 가지 쿼리 언어를 노출합니다. 검색 요청을 사용하여 매개 변수를 queryType 설정하면 연산자와 구문을 해석하는 방법을 알 수 있도록 선택한 쿼리 언어를 쿼리 파서에 알릴 수 있습니다.
단순 쿼리 언어는 직관적이고 강력하며 클라이언트 쪽 처리 없이 사용자 입력 as-is 해석하는 데 적합합니다. 웹 검색 엔진에서 익숙한 쿼리 연산자를 지원합니다.
기본 Simple 쿼리 언어를 기반으로 Full Lucene 쿼리 언어는
queryType=full을 설정하여 사용할 수 있으며, 와일드카드, 퍼지 검색, 정규식, 필드 범위 쿼리 등 더 다양한 연산자와 쿼리 유형을 지원합니다. 예를 들어 단순 쿼리 구문으로 전송된 정규식은 식이 아닌 쿼리 문자열로 해석됩니다. 이 문서의 예제 요청은 전체 Lucene 쿼리 언어를 사용합니다.
searchMode가 파서에 미치는 영향
구문 분석에 영향을 주는 또 다른 검색 요청 매개 변수는 "searchMode" 매개 변수입니다. 부울 쿼리의 기본 연산자(모두(기본값) 또는 모두)를 제어합니다.
기본값인 "searchMode=any"이면 넓은 조건과 공조 사이의 공간 구분 기호는 OR(||)이며, 샘플 쿼리 텍스트는 다음과 같습니다.
Spacious,||air-condition*+"Ocean view"
+의 +"Ocean view" 같은 명시적 연산자는 부울 쿼리 구조에서 모호하지 않습니다(용어가 반드시 일치해야 함). 나머지 용어인 '넓고'와 '에어컨'을 해석하는 방법은 덜 명확합니다. 검색 엔진이 바다 전망 및 넓은 공간 및 에어컨 조건에서 일치 항목을 찾아야 하나요? 아니면 바다 전망과 나머지 조건 중 하나를 찾아야 합니까?
기본적으로("searchMode=any") 검색 엔진은 더 광범위한 해석을 가정합니다. 필드 두 개 중 어느 하나가 일치하도록 해야 하며, 이는 "또는" 논리를 반영합니다. 두 개의 "should" 작업이 있는 이전에 설명한 초기 쿼리 트리는 기본값을 보여 줍니다.
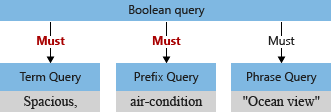
이제 "searchMode=all"을 설정한다고 가정합니다. 이 경우 공간은 "and" 연산으로 해석됩니다. 일치 항목으로 자격을 얻으려면 나머지 두 용어도 문서에 모두 포함되어 있어야 합니다. 결과 샘플 쿼리는 다음과 같이 해석됩니다.
+Spacious,+air-condition*+"Ocean view"
일치하는 문서가 세 하위 쿼리의 교차점인 이 쿼리에 대해 수정된 쿼리 트리는 다음과 같습니다.
참고
"searchMode=all"보다 "searchMode=any"를 선택하기 위해 대표 쿼리를 실행하여 결정하는 것이 좋습니다. 연산자를 포함할 가능성이 있는 사용자(문서 저장소를 검색할 때 일반적임)는 "searchMode=all"이 부울 쿼리 구문을 알리는 경우 결과를 보다 직관적으로 찾을 수 있습니다. "searchMode"와 연산자 간의 상호 작용에 대한 자세한 내용은 단순 쿼리 구문을 참조하세요.
2단계: 어휘 분석
어휘 분석기는 쿼리 트리 가 구조화된 후 용어 쿼리 및 구 쿼리 를 처리합니다. 분석기는 파서에서 제공된 텍스트 입력을 수락하고, 텍스트를 처리한 다음, 토큰화된 용어를 다시 보내 쿼리 트리에 통합합니다.
어휘 분석의 가장 일반적인 형태는 지정된 언어와 관련된 규칙을 기반으로 쿼리 용어를 변환하는 언어 분석입니다. 여기에는 다음이 포함됩니다.
- 쿼리 용어를 단어의 루트 형식으로 줄입니다.
- 필수적이지 않은 단어(영어의 "the" 또는 "and"와 같은 중지 단어)를 제거합니다.
- 복합 단어를 구성 요소 부분으로 분리합니다.
- 대문자로 된 단어들을 소문자로 변환하는 작업을 수행합니다.
이러한 모든 작업은 사용자가 제공한 텍스트 입력과 인덱스에 저장된 용어 간의 차이를 지우는 경향이 있습니다. 이러한 작업은 텍스트 처리를 넘어 언어 자체에 대한 심층적인 지식이 필요합니다. 이 언어 인식 계층을 추가하기 위해 Azure AI 검색 Lucene과 Microsoft 모두의 긴 언어 분석기 목록을 지원합니다.
참고
시나리오에 따라 분석 요구 사항은 최소에서 정교까지 다양할 수 있습니다. 미리 정의된 분석기 중 하나를 선택하거나 고유한 custom 분석기 만들어 어휘 분석의 복잡성을 제어할 수 있습니다. 분석기는 검색 가능한 필드로 범위가 지정되며 필드 정의의 일부로 지정됩니다. 이를 통해 필드별로 어휘 분석을 변경할 수 있습니다. 지정되지 않은 경우 표준 Lucene 분석기가 사용됩니다.
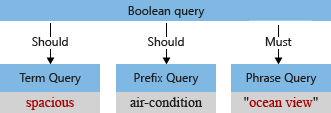
이 예제에서 분석하기 전에 초기 쿼리 트리에는 대문자 "S"와 쿼리 파서가 쿼리 용어의 일부로 해석하는 쉼표가 있는 "넓은"이라는 용어가 있습니다(쉼표는 쿼리 언어 연산자로 간주되지 않음).
기본 분석기는 용어를 처리할 때 "ocean view" 및 "spacious"를 소문자로 지정하고 쉼표 문자를 제거합니다. 수정된 쿼리 트리는 다음과 같습니다.
분석기 동작 테스트
분석 API를 사용하여 분석기의 동작을 테스트할 수 있습니다. 분석하려는 텍스트를 제공하여 지정된 분석기에서 생성하는 용어를 확인합니다. 예를 들어 표준 분석기가 "공조"라는 텍스트를 처리하는 방법을 확인하려면 다음 요청을 실행할 수 있습니다.
{
    "text": "air-condition",
    "analyzer": "standard"
}
표준 분석기는 입력 텍스트를 다음 두 토큰으로 나누며 시작 및 끝 오프셋(적중 강조 표시에 사용됨)과 해당 위치(구 일치에 사용됨)와 같은 특성으로 주석을 추가합니다.
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
어휘 분석에 대한 예외
어휘 분석은 용어 쿼리 또는 구 쿼리 중 완전한 용어가 필요한 쿼리 형식에만 적용됩니다. 불완전한 용어가 있는 쿼리 형식(접두사 쿼리, 와일드카드 쿼리 및 정규식 쿼리) 또는 유사 항목 쿼리에는 적용되지 않습니다. 예제의 용어 air-condition* 가 포함된 접두사 쿼리를 비롯한 이러한 쿼리 형식은 분석 단계를 우회하여 쿼리 트리에 직접 추가됩니다. 이러한 쿼리 용어에 적용되는 유일한 변환 작업은 소문자로의 변환입니다.
3단계: 문서 검색
문서 검색은 인덱스에 일치하는 용어가 있는 문서를 찾는 것을 의미합니다. 이 단계는 예제를 통해 가장 잘 이해됩니다. 다음 간단한 스키마가 있는 호텔 인덱스로 시작해 보겠습니다.
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
또한 이 인덱스에 다음 네 개의 문서가 포함되어 있다고 가정합니다.
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
용어 인덱싱 방법
검색을 이해하려면 인덱싱에 대한 몇 가지 기본 사항을 파악하는 데 도움이 됩니다. 스토리지 단위는 검색 가능한 각 필드에 대해 하나씩 반전된 인덱스입니다. 반전된 인덱스 내에는 모든 문서의 모든 용어에 대한 정렬된 목록이 있습니다. 각 용어는 아래 예제에서 알 수 있듯이 해당 용어가 발생하는 문서 목록에 매핑됩니다.
반전된 인덱스에 용어를 생성하기 위해 검색 엔진은 쿼리 처리 중에 발생하는 것과 유사하게 문서 내용에 대한 어휘 분석을 수행합니다.
- 텍스트 입력 은 분석기 구성에 따라 분석기에 전달되어 소문자로 변환되고, 문장 부호가 제거되는 등의 처리를 받습니다.
- 토큰은 어휘 분석의 출력입니다.
- 용어가 인덱스에 추가됩니다.
쿼리 용어가 인덱스 내의 용어처럼 보이도록 검색 및 인덱싱 작업에 동일한 분석기를 사용하는 것은 일반적이지만 필수는 아닙니다.
참고
Azure AI 검색 추가 indexAnalyzer 및 searchAnalyzer 필드 매개 변수를 통해 인덱싱 및 검색을 위해 다른 분석기를 지정할 수 있습니다. 지정되지 않은 경우 속성이 포함된 analyzer 분석기 집합이 인덱싱 및 검색 모두에 사용됩니다.
예제 문서에 대한 반전된 인덱스
예제로 돌아가서 제목 필드의 경우 반전된 인덱스가 다음과 같이 표시됩니다.
| 용어 | 문서 목록 |
|---|---|
| Atman | 1 |
| 비치 | 2 |
| 호텔 | 1, 3 |
| 바다 | 4 |
| 플 라 야 | 3 |
| 리조트 | 2 |
| 퇴각 | 4 |
제목 필드에는 호텔 만 1과 3의 두 문서에 표시됩니다.
설명 필드의 경우 인덱스 모양은 다음과 같습니다.
| 용어 | 문서 목록 |
|---|---|
| 공기 | 3 |
| 및 | 4 |
| 비치 | 1 |
| 조건부 | 3 |
| 편안한 | 3 |
| 거리 | 1 |
| 섬 | 2 |
| 카우아이 | 2 |
| 있나요 | 2 |
| 북쪽 | 2 |
| 바다 | 1, 2, 3 |
| 의 | 2 |
| on | 2 |
| 조용한 | 4 |
| 객실 | 1, 3 |
| 한적한 | 4 |
| 해안 | 2 |
| 넓은 | 1 |
| Tthe | 1, 2 |
| 다음과 같이 변경합니다 | 1 |
| view | 1, 2, 3 |
| 산책 | 1 |
| 다음과 같이 바꿉니다. | 3 |
인덱싱된 용어와 쿼리 용어 일치
위의 반전된 인덱스를 고려할 때 샘플 쿼리로 돌아가서 예제 쿼리에 대해 일치하는 문서를 찾는 방법을 살펴보겠습니다. 마지막 쿼리 트리는 다음과 같습니다.
쿼리를 실행하는 동안 개별 쿼리는 검색 가능한 필드에 대해 독립적으로 실행됩니다.
TermQuery "spacious"는 문서 1(Hotel Atman)과 일치합니다.
PrefixQuery "air-condition*"은 문서와 일치하지 않습니다.
이 동작은 때때로 개발자를 혼란스럽게 합니다. 문서에는 "air-conditioned"라는 용어가 존재하지만, 기본 분석기에 의해 이 용어가 두 개의 단어로 분할됩니다. 부분 용어를 포함하는 접두사 쿼리는 분석되지 않습니다. 따라서 접두사 "공조"가 있는 용어는 반전된 인덱스로 조회되며 찾을 수 없습니다.
"PhraseQuery '오션 뷰'는 'ocean' 및 'view' 용어를 조회하여 원래 문서 내에서 이 용어의 근접성을 확인합니다." 문서 1, 2 및 3은 설명 필드에서 이 쿼리와 일치합니다. 문서 4에는 제목에 "ocean"이라고 용어가 있지만, 우리는 개별 단어가 아닌 "바다 보기"라는 구를 찾고 있으므로 일치하는 것으로 간주되지 않습니다.
참고
검색 쿼리는 예제 검색 요청에 설명된 대로 searchFields 매개 변수로 설정된 필드를 제한하지 않는 한 Azure AI 검색 인덱스 내의 모든 검색 가능한 필드에 대해 독립적으로 실행됩니다. 선택한 필드에서 일치하는 문서가 반환됩니다.
전체적으로 해당 쿼리의 경우 일치하는 문서는 1, 2 및 3입니다.
4단계: 점수 매기기
검색 결과 집합의 모든 문서에는 관련성 점수가 할당됩니다. 관련성 점수의 기능은 검색 쿼리에서 표현한 대로 사용자 질문에 가장 잘 대답하는 문서의 순위를 높이는 것입니다. 점수는 일치하는 용어의 통계 속성을 기반으로 계산됩니다. 채점 수식의 핵심은 용어 빈도-역 문서 빈도 (TF/IDF)입니다. 희귀하고 일반적인 용어가 포함된 쿼리에서 TF/IDF는 드문 용어를 포함하는 결과를 승격합니다. 예를 들어 모든 Wikipedia 문서가 있는 가상 인덱스에서, 대통령과 일치하는 쿼리에 일치하는 문서 중에서, 대통령과 일치하는 문서가 the와 일치하는 문서보다 더 관련성이 높은 것으로 간주됩니다.
채점 예제
예제 쿼리와 일치하는 세 개의 문서를 기억하세요.
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
문서 1은 설명 필드에서 넓은 용어와 필요한 구 바다 전망이 모두 발생하여, 쿼리에 가장 잘 일치했습니다. 다음 두 문서는 바다 전망과만 일치합니다. 당신은 문서 2와 3이 같은 방식으로 쿼리에 일치했더라도 관련성 점수가 다를 수 있다는 점에 놀랄 수도 있습니다. 점수 매기기 수식에는 TF/IDF보다 더 많은 구성 요소가 있기 때문입니다. 이 경우 설명이 짧기 때문에 문서 3에 약간 더 높은 점수가 할당되었습니다. Lucene의 실용적인 점수 매기기 수식에 대해 알아보고 필드 길이 및 기타 요소가 관련성 점수에 미치는 영향을 이해합니다.
일부 쿼리 형식(와일드카드, 접두사 및 정규식)은 항상 전체 문서 점수에 상수 점수를 부여합니다. 이렇게 하면 쿼리 확장을 통해 찾은 일치 항목이 순위에 영향을 주지 않고 결과에 포함될 수 있습니다.
이 문제가 중요한 이유를 보여 주는 예제입니다. 와일드카드 검색은 접두어 검색을 포함하여, 정의상 모호할 수 있습니다. 이는 입력이 매우 많은 수의 이질적인 용어에서 일치할 수 있는 부분 문자열이기 때문입니다. “tour”, “tourettes”, “tourmaline”과 같이 “tour*” 입력과 일치하는 항목들을 살펴보세요. 이러한 결과의 특성을 감안할 때, 어떤 용어가 다른 용어보다 더 가치 있는지 합리적으로 유추할 수 있는 방법은 없습니다. 이러한 이유로 와일드카드, 접두사 및 정규식 형식의 쿼리 결과를 채점할 때 용어 빈도는 무시됩니다. 부분 및 전체 용어를 포함하는 다중 파트 검색 요청에서 부분 입력의 결과는 잠재적으로 예기치 않은 일치 항목에 대한 바이어스를 방지하기 위해 상수 점수와 통합됩니다.
관련성 조정
Azure AI 검색 관련성 점수를 조정하는 방법에는 두 가지가 있습니다.
점수 매기기 프로필 은 일련의 규칙에 따라 결과의 순위 목록에서 문서의 순위를 높입니다. 이 예제에서는 제목 필드에 일치하는 문서가 설명 필드에 일치하는 문서보다 관련성이 더 큰 것으로 간주할 수 있습니다. 또한 인덱스가 각 호텔에 대한 가격 필드가 있는 경우 더 낮은 가격으로 문서를 홍보할 수 있습니다. 검색 인덱스에 점수 매기기 프로필을 추가하는 방법에 대해 자세히 알아봅니다.
용어 부스팅 은 전체 Lucene 쿼리 구문에서만 사용할 수 있으며, 쿼리 트리의 모든 부분에 적용 가능한 부스팅 연산자
^를 제공합니다. 이 예제에서는 접두사 air-condition*를 검색하는 대신, 정확한 용어 air-condition 또는 접두사를 검색할 수 있습니다. 그러나 용어 쿼리에 부스트를 적용하여 정확한 용어와 일치하는 문서의 순위가 더 높습니다: air-condition^2||air-condition*. 쿼리에서 용어 상승에 대해 자세히 알아봅니다.
분산 인덱스의 채점
Azure AI 검색 모든 인덱스는 자동으로 여러 분할된 데이터베이스로 분할되므로 서비스 스케일 업 또는 스케일 다운 중에 여러 노드 간에 인덱스를 신속하게 분산할 수 있습니다. 검색 요청이 실행되면 각 샤드에 대해 독립적으로 처리됩니다. 그러면 각 분할된 데이터베이스의 결과가 병합되고 점수별로 정렬됩니다(다른 순서가 정의되지 않은 경우). 점수 매기기 함수는 분할 영역 전체가 아닌 해당 분할 영역 내부의 모든 문서에서 반전 문서 빈도보다 쿼리 용어 빈도에 가중치를 부여한다는 것을 기억해야 합니다.
즉, 서로 다른 샤드에 있는 경우 동일한 문서에 대해 관련성 점수가 다를 수 있습니다. 다행히 이러한 차이는 더 균등한 용어 분포로 인해 인덱스의 문서 수가 증가함에 따라 사라지는 경향이 있습니다. 주어진 문서가 어느 샤드에 배치될 것인지 가정할 수 없습니다. 그러나 문서 키가 변경되지 않는다고 가정하면 항상 동일한 샤드에 할당됩니다.
일반적으로 문서 점수는 순서 안정성이 중요한 경우 문서 순서 지정에 가장 적합한 특성이 아닙니다. 예를 들어 동일한 점수를 가진 두 개의 문서가 있는 경우 동일한 쿼리의 후속 실행에서 문서가 먼저 표시된다는 보장은 없습니다. 문서 점수는 결과 집합의 다른 문서와 관련된 일반적인 문서 관련성만 제공해야 합니다.
결론
상용 검색 엔진의 성공으로 개인 데이터에 대한 전체 텍스트 검색에 대한 기대가 높아졌습니다. 거의 모든 종류의 검색 환경에서는 용어의 철자가 잘못되었거나 불완전한 경우에도 엔진이 의도를 이해할 것으로 기대합니다. 지정하지 않은 거의 동등한 용어 또는 동의어를 기반으로 일치를 예상할 수도 있습니다.
기술적 관점에서 전체 텍스트 검색은 매우 복잡하므로 정교한 언어 분석과 쿼리 용어를 증류, 확장 및 변환하여 관련 결과를 제공하는 방식으로 처리에 대한 체계적인 접근 방식이 요구됩니다. 내재된 복잡성을 감안할 때 쿼리 결과에 영향을 줄 수 있는 여러 가지 요인이 있습니다. 이러한 이유로 전체 텍스트 검색의 메커니즘을 이해하는 데 시간을 투자하면 예기치 않은 결과를 통해 작업하려고 할 때 실질적인 이점이 제공됩니다.
이 문서에서는 Azure AI 검색 컨텍스트에서 전체 텍스트 검색을 살펴보세요. 일반적인 쿼리 문제를 해결하기 위한 잠재적 원인과 해결 방법을 인식할 수 있는 충분한 배경 지식이 제공되기를 바랍니다.
다음 단계
샘플 인덱스를 작성하고, 다른 쿼리를 사용해 보며, 결과를 검토합니다. 지침은 Azure Portal에서 인덱스 빌드 및 쿼리 참조하세요.
Azure 포털의 검색 탐색기에서 Search Documents 예제 섹션이나 Simple 쿼리 구문에서 다른 쿼리 구문을 시도해 보세요.
검색 애플리케이션에서 순위를 조정하려는 경우 점수 매기기 프로필을 검토합니다.
특정 필드에서 최소 처리 또는 특수 처리를 위해 사용자 지정 분석기를 구성합니다.