注意
Azure AI 検索は、Azure ポータル、REST API、およびAzure SDKから使用できます。 また、Foundry IQ は、エンタープライズ コンテンツを、Microsoft Foundry ポータルのエージェントの再利用可能なアクセス許可に対応したナレッジ ベースに変換するマネージド ナレッジ レイヤーです。
時折、インデクサーがエラーを発生させない問題に直面することがあります。また、認証中や接続時など、他の Azure サービスで問題が発生することもあります。 この記事では、ガイドとなるメッセージがない場合のインデクサーの問題のトラブルシューティングに焦点を当てます。 また、インデックス作成中に使用される検索以外のリソースから発生するエラーのトラブルシューティングも提供します。
注意
調査する Azure AI 検索のエラーがある場合は、代わりに、「インデクサーの一般的なエラーと警告のトラブルシューティング」を参照してください。
ベスト プラクティス
インデクサーを使用する場合のベスト プラクティスと推奨事項を次に示します。
インデクサーはスケジュールに従って実行するように設計されています
- 信頼性の高いインデックス作成を行うために、 定期的なスケジュールで実行するようにインデクサーを構成します。 スケジュールされた実行では、一時的なエラー、ネットワークの中断、または一時的なサービスの問題が原因で、前回の実行で見逃したドキュメントが自動的に取得されます。 この方法は、データの一貫性を維持し、手動による介入の必要性を最小限に抑えるのに役立ちます。
- 大規模なデータ ソースの場合、初期列挙とインデックス作成には数時間または数日かかることがあります。 スケジュールに従ってインデクサーを実行すると、進行状況が続行され、エラーが自動的に再試行されます。 これらのオプションは同じ信頼性または一時的なエラー復旧を提供しないため、手動またはオンデマンドのインデクサーの実行のみに依存しないようにします。
インデクサーは、時間の経過に伴うベスト エフォート インデックス作成を提供します
- 組み込みのインデクサーは、永続的なエラーなしでドキュメントを処理し、スケジュールされた実行間で再試行します。 これらは、一般的なシナリオでデータのインデックスを作成するための便利な、低コードまたはコードなしの方法を提供し、開発の高速化とメンテナンスの容易化を実現します。 インデクサーがスキルセットを実行すると、各実行の実行時間制限が固定されます。 マルチテナント実行環境で実行されるインデクサーの最大実行時間は 2 時間です。 この制限は、スキルセットが共有プライベート リンクを必要としない場合に使用される最も一般的なケースです。 共有プライベート リンクを使用するように構成されたインデクサーは、最大 24 時間のプライベート実行環境で実行されます。 完全な表については、「 インデクサーの制限」を参照してください。 ドキュメントごとのスキルセット処理でインデクサーが制限時間より前に終了できない場合は、停止し、残りのドキュメントは処理されません。 ドキュメント ボリューム、ファイル サイズ、スキルセットの複雑さ、または実行環境でインデクサーが最大実行時間内に終了できない場合、完全な処理は保証されません。 データ ソースをパーティション分割すると、このリスクは軽減されますが、特に後で大量のファイルをパーティションに追加する場合は、このリスクを排除できません。 この動作は予期されています。 大規模なデータセットを管理し、増分復旧をサポートする方法については、 大規模なデータ セットのインデックス作成 と インデクサーのスケジュール設定に関するページを参照してください。 インデクサーがドキュメントを処理するタイミングを厳密に制御する必要があるソリューションの場合は、この記事の Push API の代替手段を使用してください。
- ソリューションでインデックス作成のタイムラインを厳密に制御する必要がある場合は、代わりに、 Documents Index REST API や IndexDocuments メソッド (Azure SDK for .NET) などのプッシュ API を使用してください。 これらのオプションを使用すると、インデックス作成パイプラインを完全に制御できます。
- インデックス作成ツールがスケジュールからずれることがあります。 この状態は一般的ではありません。自動回復メカニズムは存在しますが、復旧には時間がかかる場合があります。 この動作は予期されています。
制限されたリソースへの接続のトラブルシューティング
Azure ネットワーク セキュリティが適用されているデータ ソースの場合、インデクサーの接続方法は制限されます。 現在、インデクサーは、共有プライベート リンクを使用して、IP ファイアウォールの背後の、またはプライベート エンドポイントを介した仮想ネットワーク上の、制限されたデータ ソースにアクセスできます。
プライベート接続で Microsoft Foundry リソースに接続中にエラーが発生しました
次のメッセージでエラー コード 403 が表示される場合は、スキルセットでリソース エンドポイントを指定する方法に問題がある可能性があります。
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
このエラーは、Azure Foundry リソースへの接続用に共有プライベート リンクを構成し、エンドポイントにカスタム サブドメインがない場合に発生します。 カスタム サブドメインは、エンドポイントの最初のパートです (例、http://my-custom-subdomain.services.ai.azure.com)。 Azure portal ではなく Foundry ポータルでリソースを作成した場合、カスタム ドメインが見つからない可能性があります。
Foundry リソースが Azure AI 検索 と同じリージョンにない場合は、 キーレス接続を使用 してリソースをアタッチします。
共有プライベート リンクの使用中にエラーが発生しました
次のメッセージを含むエラー コード 403 が表示された場合、インデクサーは、承認された共有プライベート リンクではなくパブリック エンドポイントを介して接続している可能性があります。
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
このエラーは、インデクサーがプライベート実行環境を使用するように構成されていない場合に発生する可能性があります。 共有プライベート リンクが承認されていることを確認し、インデクサーの executionEnvironment を privateに設定し、接続で正しいリソース エンドポイントと グループ ID が使用されていることを確認します。
ファイアウォール規則
Azure Storage、Azure Cosmos DB、および Azure SQL には、構成可能なファイアウォールが用意されています。 ファイアウォールが要求をブロックする場合、特定のエラー メッセージはありません。 通常、ファイアウォールのエラーは一般的です。 一般的なエラーには次のようなものがあります。
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
インデクサーがこれらのリソースにアクセスできるようにするには、次のいずれかのオプションを使用します。
検索サービスの IP アドレスと
AzureCognitiveSearchサービス タグの IP アドレス範囲の受信規則を構成します。 各データ ソースの種類に対する IP アドレス範囲の制限の構成の詳細については、次のリンクを参照してください。最後の手段として、または一時的な手段として、すべてのネットワークからのアクセスを許可してファイアウォールを無効にします。
制限: IP アドレス範囲の制限は、検索サービスとストレージ アカウントが異なるリージョンにある場合にのみ機能します。
インデクサーは、データ取得に加えて、スキルセットとカスタム スキルを通じた送信要求の送信も行います。 Azure 関数に基づくカスタム スキルの場合は、Azure 関数にも IP アドレス制限があることに注意してください。 カスタム スキルの実行に使用できる IP アドレスの一覧には、検索サービスの IP アドレスと AzureCognitiveSearch サービス タグの IP アドレス範囲が含まれます。
ネットワーク セキュリティ グループ (NSG) のルール
インデクサーが SQL マネージド インスタンス上のデータにアクセスするとき、またはカスタム スキルの Web サービス URI として Azure VM が使用されている場合、ネットワーク セキュリティ グループは要求が許可されるかどうかを判断します。
仮想ネットワーク上に存在する外部リソースの場合は、
仮想マシンへの接続の詳細については、Azure VM での SQL Server への接続の構成に関する記事を参照してください。
ネットワーク エラー
通常、ネットワーク エラーは一般的です。 一般的なエラーには次のようなものがあります。
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
次のいずれかのエラーが発生した場合:
- 検索サービスではなく、ソースに直接接続してソースにアクセスできることを確認します。
- Azure ポータルで、現在のエラーや停止がないかリソースを確認します。
- Azure状態でネットワークの停止を確認します。
- Azure プライベート DNSではなく、名前解決にパブリック DNS を使用していることを確認します。
Azure SQL Database のサーバーレス インデックス作成 (エラー コード 40613)
SQL データベースがサーバーレスのコンピューティング層にある場合は、インデクサーが接続しているときに、データベースが実行中であり、一時停止されていないことを確認します。
データベースが一時停止されている場合、検索サービスからの最初のサインインではデータベースが自動的に再開されますが、代わりにデータベースが使用できないことを示すエラーが返され、エラー コード 40613 が返されます。 データベースが実行されたら、サインインを再試行して接続を確立します。
Microsoft Entra 条件付きアクセス ポリシー
SharePoint インデクサーを作成するときは、デバイス コードを指定した後、Microsoft Entra アプリにサインインする必要があります。
"Your sign-in was successful but your admin requires the device requesting access to be managed"というメッセージを受け取った場合、条件付きアクセス ポリシーによって、SharePoint ドキュメント ライブラリからインデクサーがブロックされている可能性があります。
ポリシーを更新し、インデクサーによるドキュメント ライブラリへのアクセスを許可するには:
Azure portal を開き、Microsoft Entra 条件付きアクセスを検索します。
左側のメニューの [ポリシー] を選択します。 このページを表示するためのアクセス権がない場合は、アクセス権を持つ他のユーザーを見つけるか、アクセス権を取得する必要があります。
SharePoint インデクサーによるドキュメント ライブラリへのアクセスをブロックしているポリシーを決定します。 インデクサーをブロックする可能性があるポリシーには、[ ユーザーとグループ ] セクションのインデクサーの作成手順で認証に使用したユーザー アカウントが含まれます。 ポリシーには次の条件も含まれている場合があります。
- Windows プラットフォームを制限する。
- モバイル アプリとデスクトップ クライアントを制限する。
- [デバイスの状態] を [はい] に設定します。
インデクサーをブロックしているポリシーを確認したら、インデクサーの除外を行います。 まず、検索サービスの IP アドレスを取得します。
最初に、お使いの検索サービスの完全修飾ドメイン名 (FQDN) を取得します。 FQDN は
<your-search-service-name>.search.windows.netのようになります。 FQDN は Azure portal で確認できます。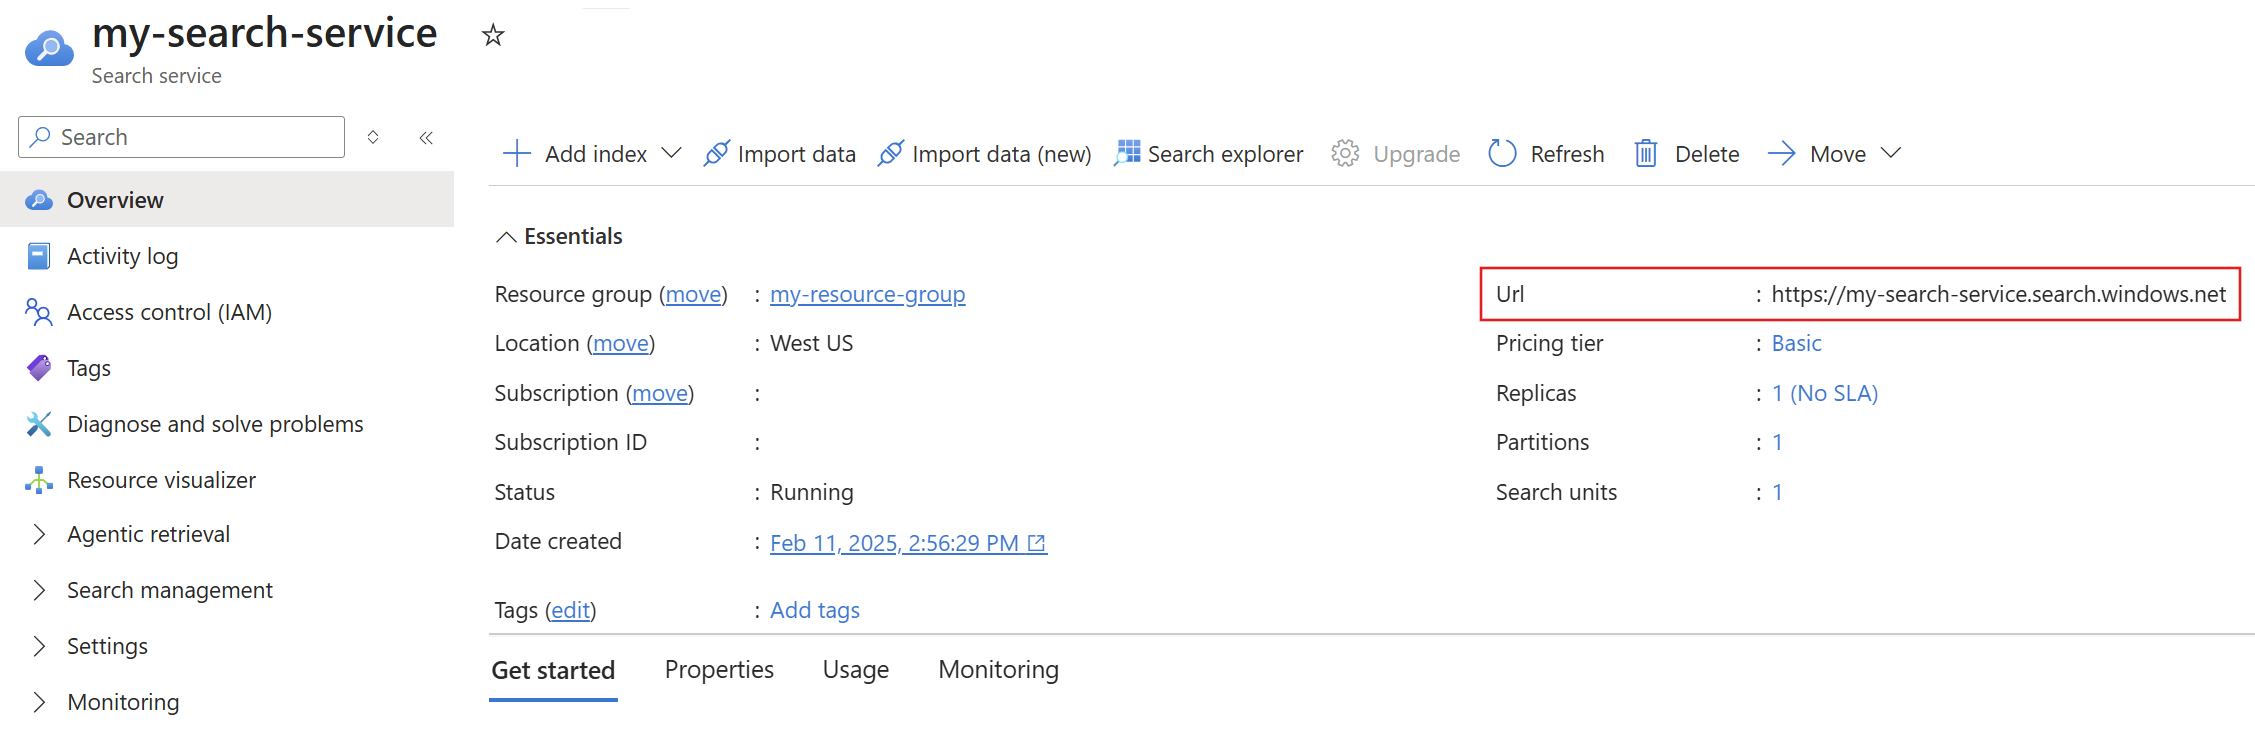
FQDN を取得したら、FQDN の
nslookup(またはping) を実行して検索サービスの IP アドレスを取得します。 次の例では、Azure Storage ファイアウォールの受信規則に150.0.0.1を追加します。 検索サービス インデクサーが Azure Storage アカウントにアクセスするには、ファイアウォール設定が更新されてから最大 15 分かかる場合があります。nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netリージョンのインデクサー実行環境の IP アドレスの範囲を取得します。
追加の IP アドレスは、インデクサーのマルチテナント実行環境から発信される要求に使用されます。 この IP アドレス範囲は、 サービス タグから取得できます。
AzureCognitiveSearchまたはダウンロード可能な JSON ファイルを使用して、 サービス タグの IP アドレス範囲を取得できます。この演習では、検索サービスが Azure パブリック クラウドであると仮定して、Azureパブリック JSON ファイルをダウンロードします。
JSON ファイルから、検索サービスが米国中西部にあると仮定すると、マルチテナント インデクサー実行環境の IP アドレスの一覧が一覧表示されます。
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
Azure portal の [条件付きアクセス] ページに戻り、左側のメニューで [ネームド ロケーション] を選択し、[IP 範囲の場所] を選択します。 新しいネームド ロケーションに名前を付けて、最後の 2 つの手順で収集した検索サービスとインデクサーの実行環境の IP 範囲を追加します。 1
- 検索サービスの IP アドレスでは、有効な IP 範囲のみが受け入れられるため、IP アドレスの末尾に "/32" を追加する必要がある場合があります。
- インデクサーの実行環境の IP 範囲は、検索サービスが存在するリージョンの IP 範囲を追加する必要があるだけであることに注意してください。
新しいネームド ロケーションをポリシーから除外します。
- 左側のメニューの [ポリシー] を選択します。
- インデクサーをブロックしているポリシーを選択します。
- [条件] を選択します。
- [場所] を選択します。
- [除外] を選択し、新しいネームド ロケーションを追加します。
- 変更を [保存] します。
ポリシーが更新され、新しいポリシー ルールが適用されるまで数分待ちます。
インデクサーを再作成することを試みます。
- 作成したデータ ソース オブジェクトに対する更新要求を送信します。
- インデクサー作成要求を再送信します。 新しいコードを使用してサインインした後、別のインデクサー作成要求を送信します。
サポートされていないドキュメントの種類のインデックス作成
Azure Blob Storageからコンテンツのインデックスを作成していて、コンテナーにサポートされていないコンテンツ タイプの BLOB が含まれている場合、インデクサーはそのドキュメントをスキップします。 それ以外の場合、個々のドキュメントに問題がある可能性があります。
このような状況では、個々のドキュメントに問題がある場合にインデクサーの処理を続行できるようにするための、構成オプションを設定できます。
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
ドキュメントの欠落
インデクサーは、外部 データ ソース からドキュメントまたは行を抽出し、 検索ドキュメントを作成します。このドキュメントは、検索サービスによってインデックスが作成されます。 データ ソースに存在するドキュメントが検索インデックスに表示されない場合があります。 この予想外の結果は、次の理由で発生する可能性があります。
- インデクサーの実行後にドキュメントを更新しました。 インデクサーがスケジュール設定されている場合は、いずれ再実行されて、ドキュメントを処理します。
- ドキュメントを取り込む前にインデクサーがタイムアウトした。 最大処理時間の制限があり、これを超えるとドキュメントは処理されなくなります。 インデクサーの状態は、Azure portal で確認するか、Get Indexer Status (REST API) を呼び出すことで確認できます。
- フィールド マッピング または AI エンリッチメント によってドキュメントが変更され、検索インデックス内のアーティキュレーションが想定とは異なります。
- 変更の追跡の値が間違っている、または前提条件が満たされていない。 高基準値が将来の時刻に設定された日付の場合、インデクサーは、以前の日付のドキュメントをスキップします。 インデクサーの状態の
initialTrackingStateフィールドとfinalTrackingStateフィールドを使用して、 インデクサーの変更追跡状態を確認できます。 Azure SQL と MySQL のインデクサーには、ソース テーブルの高いウォーター マーク列のインデックスが必要です。または、インデクサーによって使用されているクエリがタイムアウトしている可能性があります。
ヒント
ドキュメントが見つからない場合は、使用しているクエリを調べ、問題のドキュメントが除外されていないことを確認します。 特定のドキュメントのクエリを実行するには、Lookup Document REST API を使用します。
Blob Storage のコンテンツが見つからない
BLOB インデクサーによって、コンテナー内の BLOB からテキストが検索されて抽出されます。 テキストの抽出に関する問題には次のものがあります。
ドキュメントに、スキャンしたイメージしか含まれていません。 スキャンしたイメージ (JPG) などテキスト以外のコンテンツを含む PDF BLOB では、標準 BLOB インデックス パイプラインで結果が生成されません。 イメージ コンテンツにテキスト要素が含まれる場合は、OCR または画像分析を使用して、テキストを検索して抽出できます。
BLOB インデクサーは、メタデータのインデックス付けのみを行うように構成されています。 コンテンツを抽出するには、 コンテンツとメタデータの両方を抽出するように BLOB インデクサーを構成する必要があります。
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Azure Cosmos DB のコンテンツが見つからない
Azure AI 検索 には、Azure Cosmos DB のインデックス作成に対する暗黙的な依存関係があります。 Azure Cosmos DB で自動インデックス作成を無効にすると、Azure AI 検索 は正常な状態を返しますが、コンテナーの内容のインデックス作成に失敗します。 設定を確認してインデックス付けをオンにする手順については、Azure Cosmos DB でのインデックス付けの管理に関する記事をご覧ください。
データ ソースとインデックスのドキュメント数の不一致
インデクサーでは、データ ソース、インデックス自体、またはコード内のカウントとは異なるドキュメント数が表示される場合があります。 この動作が発生する可能性がある理由を次に示します。
- インデックスでは、実際のドキュメント数の表示に遅延が発生する可能性があります (特に Azure portal)。
- インデクサーに、削除されたドキュメント ポリシーがある。 ドキュメントが削除される前にインデックスが作成されている場合、削除されたドキュメントがインデクサーによってカウントされます。
- データ ソースの ID 列が一意ではない場合。 この条件は、Azure Cosmos DBなどの列の概念を持つデータ ソースに適用されます。
- データ ソース定義に、レコード数の見積もりに使用しているものとは異なるクエリがある場合。 たとえば、データベースではデータベース レコード数のクエリを実行していますが、データ ソース定義クエリでは、インデックスを作成するレコードのサブセットのみを選択している可能性があります。
- カウントは、パイプラインのコンポーネント (データ ソース、インデクサー、インデックス) ごとに異なる間隔でチェックされます。
- データ ソースに、多数のドキュメントにマップされたファイルがある。 この条件は、BLOB にインデックスを作成しているときに、"parsingMode" が
jsonArrayおよびjsonLinesに設定されていると発生する可能性があります。
ドキュメントが複数回処理される
インデクサーでは、インデックス付けを行うときにデータ ソース内の新規および変更されたすべてのドキュメントが確実に取得されるように、保守的なバッファリング戦略が使用されます。 状況によっては、これらのバッファーが重複し、インデクサーによってドキュメントに 2 回以上インデックスが作成される場合があります。 その結果、処理されたドキュメント数は、データ ソース内のドキュメントの実際の数を超えています。 この動作は、ドキュメントの複製など、インデックスに格納されているデータには影響しません。最終的な整合性に達するまでに時間がかかる場合のみです。 この条件は、次のいずれかの条件に該当する場合に特によく見られます。
- オンデマンドのインデクサー要求は、短時間に連続して発行されます。
- データ ソースのトポロジには、Azure Cosmos DBの整合性レベルで説明されているトポロジなど、複数のレプリカとパーティションが含まれます。
- データ ソースはAzure SQL データベースであり、"high water mark" として選択された列は
datetime2型です。
インデクサーは、すばやく連続して複数回呼び出されるようには意図されていません。 すばやい更新が必要な場合、サポートされているアプローチでは、更新をインデックスにプッシュし、同時にデータ ソースを更新します。 オンデマンド処理の場合は、要求のペースを 5 分以上に設定し、スケジュールに従ってインデクサーを実行します。
30 秒のバッファーを使用したドキュメント重複処理の例
次のタイムラインでは、ドキュメントが 2 回処理される条件について説明します。 それぞれのアクションと対抗措置を記録します。 次のタイムラインから、この問題を確認できます。
| タイムライン (hh:mm:ss) | イベント | インデクサーのハイウォーターマーク | コメント |
|---|---|---|---|
| 00:01:00 |
doc1 をデータ ソースへ書き込み、最終的に整合させる |
null |
ドキュメントのタイムスタンプは 00:01:00 です。 |
| 00:01:05 |
doc2 をデータ ソースへ書き込み、最終的に整合させる |
null |
ドキュメントのタイムスタンプは 00:01:05 です。 |
| 00:01:10 | インデクサーが開始する | null |
|
| 00:01:11 | インデクサーによって、00:01:10 より前のすべての変更のクエリが実行される。インデクサーによってクエリが実行されるレプリカが、たまたま doc2 のみを認識し、doc2 のみが取得される |
null |
インデクサーによって、タイムスタンプを開始する前にすべての変更が要求されますが、実際にはサブセットを受け取ります。 この動作には、ルック バック バッファー期間が必要です。 |
| 00:01:12 | インデクサーによって、doc2 の 1 回目の処理が行われる |
null |
|
| 00:01:13 | インデクサーが終了する | 00:01:10 | 高基準が、現在のインデクサー実行のタイムスタンプを開始するように更新されます。 |
| 00:01:20 | インデクサーが開始する | 00:01:10 | |
| 00:01:21 | インデクサーによって、00:00:40 から 00:01:20 の間のすべての変更のクエリが実行される。インデクサーによってクエリが実行されるレプリカが、たまたま doc1 と doc2 の両方を認識し、doc1 と doc2 が取得される |
00:01:10 | インデクサーは、現在のハイウォーターマークから30秒のバッファを差し引いた時点と、現在のインデクサー実行の開始タイムスタンプの間のすべての変更についてリクエストを行います。 |
| 00:01:22 | インデクサーによって、doc1 の 1 回目の処理が行われる |
00:01:10 | |
| 00:01:23 | インデクサーによって、doc2 の 2 回目の処理が行われる |
00:01:10 | |
| 00:01:24 | インデクサーが終了する | 00:01:20 | 高基準が、現在のインデクサー実行のタイムスタンプを開始するように更新されます。 |
| 00:01:32 | インデクサーが開始する | 00:01:20 | |
| 00:01:33 | インデクサーによって、00:00:50 から 00:01:32 の間のすべての変更のクエリが実行され、doc1 と doc2 が取得される |
00:01:20 | インデクサーは、現在のハイウォーターマークから30秒のバッファを差し引いた時点と、現在のインデクサー実行の開始タイムスタンプの間のすべての変更についてリクエストを行います。 |
| 00:01:34 | インデクサーによって、doc1 の 2 回目の処理が行われる |
00:01:20 | |
| 00:01:35 | インデクサーによって、doc2 の 3 回目の処理が行われる |
00:01:20 | |
| 00:01:36 | インデクサーが終了する | 00:01:32 | 高基準が、現在のインデクサー実行のタイムスタンプを開始するように更新されます。 |
| 00:01:40 | インデクサーが開始する | 00:01:32 | |
| 00:01:41 | インデクサーによって、00:01:02 から 00:01:40 の間のすべての変更のクエリが実行され、doc2 が取得される |
00:01:32 | インデクサーは、現在のハイウォーターマークから30秒のバッファを差し引いた時点と、現在のインデクサー実行の開始タイムスタンプの間のすべての変更についてリクエストを行います。 |
| 00:01:42 | インデクサーによって、doc2 の 4 回目の処理が行われる |
00:01:32 | |
| 00:01:43 | インデクサーが終了する | 00:01:40 | このインデクサーの実行が、データ ソースへの最後の書き込みから 30 秒を超えて開始され、doc2 も処理されていることに注意してください。 これは、00:01:35 より前のすべてのインデクサー実行が削除された場合、doc1 と doc2 を処理する最初で唯一の実行になるため、予期される動作です。 |
実際には、このシナリオは、特定のデータ ソースに対して、数分以内にオンデマンド インデクサーを手動で呼び出す場合にのみ発生します。 同じドキュメントに対して同じスキルを複数回実行している場合、数が一致しない (インデクサーの実行統計によると合計 345 ドキュメントがインデクサーによって処理されたが、データ ソースとインデックスに 340 ドキュメントがあるような場合) か、請求が増える可能性があります。 スケジュールを使用してインデクサーを実行することをお勧めします。
並列インデックス作成
複数のインデクサーが同時に実行される場合、一部のインデクサーは通常、キューに入り、使用可能なリソースを待機してから開始します。 同時に実行できるインデクサーの数は、いくつかの要因によって決まります。 インデクサーが スキルセットにリンクしていない場合、AI Search サービスの レプリカとパーティション の数によって、並列で実行できるインデクサーの数が決まります。
インデクサーをスキルセットに関連付ける場合は、AI Search 内部クラスター内で実行されます。 スキルセットの複雑さと、同時に実行される他のスキルセットによって、同時に実行できるインデクサーの数が決まります。 組み込みのインデクサーは確実にソースからデータを抽出するため、スケジュールに従って実行してもデータが見落とされません。 ただし、並列化とスケールアウトのためのインデクサー プロセスの完了には、ある程度の時間が必要です。
秘密度ラベルを使用したドキュメントのインデックス作成
ドキュメントに秘密度ラベルを設定すると、インデックスを作成できない可能性があります。 エラーが発生した場合は、インデックスを作成する前にラベルを削除します。