Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Nota
Azure AI Search è disponibile tramite il portale di Azure, le API REST e Azure SDK. È inoltre alla base di Foundry IQ, il livello di conoscenza gestito che trasforma il contenuto aziendale in knowledge base riutilizzabili e con riconoscimento delle autorizzazioni per gli agenti nel portale di Microsoft Foundry.
La ricerca full-text è un approccio al recupero delle informazioni che corrisponde al testo normale archiviato in un indice. Ad esempio, data una stringa di query "hotels in San Diego on the beach", il motore di ricerca cerca stringhe con token in base a tali termini. Per rendere le analisi più efficienti, le stringhe di query vengono sottoposte a un'analisi lessicale: convertendo tutti i termini in minuscolo, rimuovendo parole non significative come "il" e riducendo i termini alle forme base primitive. Quando vengono trovati termini corrispondenti, il motore di ricerca recupera i documenti, li classifica in ordine di pertinenza e restituisce i risultati principali.
L'esecuzione di query può essere complessa. Questo articolo è destinato agli sviluppatori che necessitano di una comprensione più approfondita del funzionamento della ricerca full-text in Azure AI Search. Per le query di testo, Azure AI Search offre senza problemi i risultati attesi nella maggior parte degli scenari, ma occasionalmente si potrebbe ottenere un risultato che sembra "sbagliato" in qualche modo. In queste situazioni, avere uno sfondo nelle quattro fasi dell'esecuzione di query Lucene (analisi delle query, analisi lessicale, corrispondenza dei documenti e assegnazione dei punteggi) consente di identificare modifiche specifiche ai parametri di query o alla configurazione dell'indice che producono il risultato desiderato.
Nota
Azure AI Search usa Apache Lucene per la ricerca full-text, ma l'integrazione di Lucene non è esaustiva. Vengono esposte ed estese selettivamente le funzionalità Lucene per abilitare gli scenari fondamentali di Azure AI Search.
Panoramica e diagramma dell'architettura
L'esecuzione delle query ha quattro fasi:
- Analisi delle query
- Analisi lessicale
- Recupero documenti
- Punteggio
Una ricerca full-text inizia analizzando il testo della query per estrarre i termini e gli operatori di ricerca. Sono disponibili due parser in modo da poter scegliere tra velocità e complessità. Una fase di analisi è successiva, in cui i singoli termini di query vengono talvolta suddivisi e ricostituiti in nuove forme. Questo passaggio consente di allargare la rete su quello che può essere considerato una potenziale corrispondenza. Il motore di ricerca analizza quindi l'indice per trovare documenti con termini corrispondenti e assegna un punteggio a ciascuna corrispondenza. Un set di risultati viene quindi ordinato in base a un punteggio di pertinenza assegnato a ogni singolo documento corrispondente. Quelli nella parte superiore dell'elenco di pertinenza vengono restituiti all'applicazione chiamante.
Il diagramma seguente illustra i componenti usati per elaborare una richiesta di ricerca:
Diagramma dell'architettura delle query 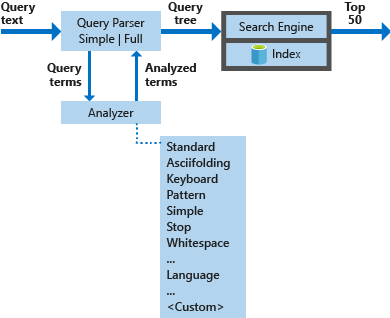
| Componenti chiave | Descrizione funzionale |
|---|---|
| Parser di query | Separare i termini della query dagli operatori della query e creare la struttura della query (un albero di query) da inviare al motore di ricerca. |
| Analizzatori | Eseguire l'analisi lessicale sui termini della query. Questo processo può comportare la trasformazione, la rimozione o l'espansione dei termini di query. |
| Indice | Struttura dei dati efficiente usata per archiviare e organizzare termini ricercabili estratti da documenti indicizzati. |
| Motore di ricerca | Recupera e assegna punteggi ai documenti corrispondenti in base al contenuto dell'indice invertito. |
Anatomia di una richiesta di ricerca
Una richiesta di ricerca è una specifica completa di ciò che deve essere restituito in un set di risultati. Nella sua forma più semplice, si tratta di una query vuota senza criteri di alcun tipo. Un esempio più realistico include parametri, diversi termini di query, ad esempio con ambito per determinati campi, con possibilmente un'espressione di filtro e regole di ordinamento.
L'esempio seguente è una richiesta di ricerca che è possibile inviare a Azure AI Search usando l'API REST:
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
Per questa richiesta, il motore di ricerca esegue le operazioni seguenti:
Trova i documenti in cui il prezzo è di almeno $60 e inferiore a $ 300.
Esegue la query. In questo esempio, la query di ricerca è composta da frasi e termini:
"Spacious, air-condition* +\"Ocean view\""(gli utenti in genere non immettono punteggiatura, ma includendola nell'esempio, è possibile spiegare come gli analizzatori la gestiscono).Per questa query, il motore di ricerca analizza i campi della descrizione e del titolo specificati in "searchFields" per i documenti che contengono
"Ocean view"e in aggiunta al termine"spacious", o in termini che iniziano con il prefisso"air-condition". Il parametro "searchMode" viene usato per trovare una corrispondenza con qualsiasi termine (impostazione predefinita) o per tutti, nei casi in cui un termine non è richiesto in modo esplicito (+).Ordina il set risultante di hotel in base alla prossimità a una determinata posizione geografica e quindi restituisce i risultati all'applicazione chiamante.
La maggior parte di questo articolo riguarda l'elaborazione della query di ricerca: "Spacious, air-condition* +\"Ocean view\"". Il filtro e l'ordinamento non rientrano nell'ambito. Per altre informazioni, vedere la documentazione di riferimento dell'API di ricerca.
Fase 1: Analisi delle query
Come indicato, la stringa di query è la prima riga della richiesta:
"search": "Spacious, air-condition* +\"Ocean view\"",
Il parser di query separa gli operatori , ad esempio * e + nell'esempio, dai termini di ricerca e decostruisce la query di ricerca in sottoquery di un tipo supportato:
- query del termine per i termini singoli (ad esempio spazioso)
- query della frase per i termini tra virgolette (ad esempio vista oceano)
-
query del prefisso per i termini seguiti da un operatore prefisso
*(ad esempio, aria condizionata)
Per un elenco completo dei tipi di query supportati, vedere sintassi delle query Lucene.
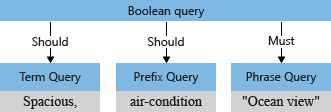
Gli operatori associati a una sottoquery determinano se la query "deve essere" o "dovrebbe essere" soddisfatta al fine di considerare un documento come corrispondenza. Ad esempio, +"Ocean view" è "obbligatorio" a causa dell'operatore +.
Il parser di query ristruttura le sottoquery in un albero di query (una struttura interna che rappresenta la query), che passa al motore di ricerca. Nella prima fase dell'analisi delle query, l'albero delle query è simile al seguente:
Parser supportati: Lucene semplice e completa
Azure AI Search espone due linguaggi di query diversi: simple (impostazione predefinita) e full. Impostando il parametro con la queryType richiesta di ricerca, si indica al parser di query il linguaggio di query scelto in modo che sia in grado di interpretare gli operatori e la sintassi.
Il linguaggio di query semplice è intuitivo e affidabile, spesso adatto per interpretare l'input dell'utente as-is senza elaborazione lato client. Supporta operatori di query familiari dai motori di ricerca su internet.
Il Linguaggio di query Lucene Full, che si ottiene impostando
queryType=full, estende il linguaggio di query semplice di impostazione predefinita aggiungendo il supporto per più operatori e tipi di query quali carattere jolly, fuzzy, regex e query con ambito campo. Ad esempio, un'espressione regolare inviata nella sintassi di query semplice viene interpretata come stringa di query e non come espressione. La richiesta di esempio in questo articolo usa il linguaggio di query Full Lucene.
Impatto di searchMode sul parser
Un altro parametro della richiesta di ricerca che influisce sull'analisi è il parametro "searchMode". Controlla l'operatore predefinito per le query booleane: qualsiasi (impostazione predefinita) o tutti.
Quando "searchMode=any", che è il valore predefinito, il delimitatore di spazio tra spazioso e aria condizionata è OR (||), rendendo il testo della query di esempio equivalente a:
Spacious,||air-condition*+"Ocean view"
Gli operatori espliciti, ad esempio + in +"Ocean view", non sono ambigui nella costruzione di query booleane (il termine deve corrispondere). Meno ovvio è come interpretare i termini rimanenti: spazioso e aria condizionata. Il motore di ricerca dovrebbe trovare corrispondenze su vista sull'oceano and spazioso and aria condizionata? O dovrebbe trovare vista sull'oceano più uno dei termini rimanenti?
Per impostazione predefinita ("searchMode=any"), il motore di ricerca presuppone l'interpretazione più ampia. Uno dei campi dovrebbe essere associato, riflettendo la semantica di "or". L'albero delle query iniziale illustrato in precedenza, con le due operazioni "should", mostra l'impostazione predefinita.
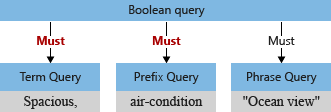
Si supponga di impostare "searchMode=all". In questo caso, lo spazio viene interpretato come un'operazione "and". Entrambi i termini rimanenti devono essere presenti nel documento per essere considerati come corrispondenza. La query di esempio risultante verrà interpretata come segue:
+Spacious,+air-condition*+"Ocean view"
Un albero di query modificato per questa query, in cui un documento corrispondente è l'intersezione di tutte e tre le sottoquery, sarà simile al seguente:
Nota
La scelta di "searchMode=any" su "searchMode=all" è una scelta migliore eseguendo query rappresentative. Gli utenti che probabilmente includono operatori (comuni durante la ricerca negli archivi di documenti) potrebbero trovare risultati più intuitivi se "searchMode=all" influenza i costrutti delle query booleane. Per ulteriori informazioni sull'interazione tra "searchMode" e gli operatori, vedere Sintassi semplice delle query.
Fase 2: Analisi lessicale
Gli analizzatori lessicali elaborano le query sui termini e le query di frasi dopo che l'albero delle query è strutturato. Un analizzatore accetta gli input di testo forniti dal parser, elabora il testo e quindi restituisce i termini con token da incorporare nell'albero delle query.
La forma più comune di analisi lessicale è l'analisi linguistica, che trasforma i termini di query in base alle regole specifiche di un determinato linguaggio. Ciò comporta:
- Riduzione di un termine della query nella forma radice di una parola.
- Rimozione di stopwords (parole non essenziali, come "il" o "e" in inglese).
- Suddividere una parola composita in parti componenti.
- In minuscolo una parola maiuscola.
Tutte queste operazioni tendono a cancellare le differenze tra l'input di testo fornito dall'utente e i termini archiviati nell'indice. Tali operazioni vanno oltre l'elaborazione del testo e richiedono una conoscenza approfondita del linguaggio stesso. Per aggiungere questo livello di consapevolezza linguistica, Azure AI Search supporta un lungo elenco di analizzatori language di Lucene e Microsoft.
Nota
A seconda dello scenario, i requisiti di analisi possono variare da minimo a elaborato. È possibile controllare la complessità dell'analisi lessicale selezionando uno degli analizzatori predefiniti o creando un analizzatore personalizzato. Gli analizzatori hanno come ambito campi ricercabili e vengono specificati come parte di una definizione di campo. In questo modo è possibile variare l'analisi lessicale in base al campo. Se non è specificato, viene usato l'analizzatore Lucene standard.
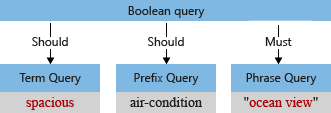
In questo esempio, prima dell'analisi, l'albero delle query iniziale ha il termine "Spazioso", con una "S" maiuscola e una virgola che il parser di query interpreta come parte del termine di query (una virgola non è considerata un operatore del linguaggio di query).
Quando l'analizzatore predefinito elabora il termine, renderà minuscoli "vista oceano" e "spazioso" e rimuoverà il carattere virgola. L'albero delle query modificato è simile al seguente:
Test dei comportamenti dell'analizzatore
Il comportamento di un analizzatore può essere testato usando l'API Analizza. Specificare il testo da analizzare per visualizzare i termini generati dall'analizzatore specificato. Ad esempio, per vedere come l'analizzatore standard elabora il testo "aria condizionata", è possibile inviare la richiesta seguente:
{
    "text": "air-condition",
    "analyzer": "standard"
}
L'analizzatore standard suddivide il testo di input nei due token seguenti, annotandoli con attributi come gli offset di inizio e fine (usati per l'evidenziazione degli hit) e la relativa posizione (usata per la corrispondenza di frasi):
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
Eccezioni all'analisi lessicale
L'analisi lessicale si applica solo ai tipi di query che richiedono termini completi, ovvero una query di termini o una query di frasi. Non si applica ai tipi di query con termini incompleti: query di prefisso, query con caratteri jolly, query regex o query fuzzy. Questi tipi di query, inclusa la query di prefisso con il termine air-condition* nell'esempio, vengono aggiunti direttamente all'albero delle query, ignorando la fase di analisi. L'unica trasformazione eseguita per i termini della query di queste tipologie è la conversione in lettere minuscole.
Fase 3: Recupero dei documenti
Il recupero dei documenti si riferisce alla ricerca di documenti con termini corrispondenti nell'indice. Questa fase è più comprensibile tramite un esempio. Si inizierà con un indice di hotel con lo schema semplice seguente:
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
Si supponga inoltre che questo indice contenga i quattro documenti seguenti:
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
Modalità di indicizzazione dei termini
Per comprendere il recupero, è utile conoscere alcune nozioni di base sull'indicizzazione. L'unità di archiviazione è un indice invertito, uno per ogni campo ricercabile. All'interno di un indice invertito è un elenco ordinato di tutti i termini di tutti i documenti. Ogni termine viene mappato all'elenco di documenti in cui si verifica, come evidente nell'esempio seguente.
Per produrre i termini in un indice invertito, il motore di ricerca esegue un'analisi lessicale sul contenuto dei documenti, analogamente a quanto accade durante l'elaborazione delle query:
- Gli input di testo vengono passati a un analizzatore, convertiti in minuscolo, privati della punteggiatura e altro ancora, a seconda della configurazione dell'analizzatore.
- I token sono l'output dell'analisi lessicale.
- I termini vengono aggiunti all'indice.
È comune, ma non necessario, usare gli stessi analizzatori per le operazioni di ricerca e indicizzazione in modo che i termini di query siano più simili ai termini all'interno dell'indice.
Nota
Azure AI Search consente di specificare analizzatori diversi per l'indicizzazione e la ricerca tramite parametri di campo aggiuntivi indexAnalyzer e searchAnalyzer. Se non specificato, l'analizzatore impostato con la proprietà analyzer viene usato sia per l'indicizzazione che per la ricerca.
Indice invertito per documenti di esempio
Se si torna all'esempio, per il campo del titolo , l'indice invertito è simile al seguente:
| Termine | Elenco documenti |
|---|---|
| Atman | 1 |
| Spiaggia | 2 |
| Hotel | 1, 3 |
| Oceano | 4 |
| Playa | 3 |
| Villaggio turistico | 2 |
| Ritiro | 4 |
Nel campo titolo viene visualizzato solo l'hotel in due documenti: 1 e 3.
Per il campo della descrizione , l'indice è simile al seguente:
| Termine | Elenco documenti |
|---|---|
| Aria | 3 |
| E | 4 |
| Spiaggia | 1 |
| Condizionato | 3 |
| comodo | 3 |
| Distanza | 1 |
| Isola | 2 |
| kauaʻi | 2 |
| Situato | 2 |
| Nord | 2 |
| Oceano | 1, 2, 3 |
| Di | 2 |
| su | 2 |
| Silenzioso | 4 |
| Camere | 1, 3 |
| Isolato | 4 |
| Riva | 2 |
| spaziose | 1 |
| il | 1, 2 |
| A | 1 |
| Visualizza | 1, 2, 3 |
| Camminare | 1 |
| Con | 3 |
Corrispondenza dei termini di query rispetto ai termini indicizzati
Dato gli indici invertiti precedenti, torniamo alla query di esempio e vediamo come vengono trovati i documenti corrispondenti per la query di esempio. Tenere presente che l'albero delle query finale è simile al seguente:
Durante l'esecuzione della query, le singole query vengono eseguite sui campi ricercabili in modo indipendente.
TermQuery, "spazioso", corrisponde al documento 1 (Hotel Atman).
PrefixQuery, "air-condition*", non corrisponde ad alcun documento.
Questo comportamento talvolta confonde gli sviluppatori. Anche se il termine aria condizionata esiste nel documento, viene suddiviso in due termini dall'analizzatore di default. Tenere presente che le query di prefisso, che contengono termini parziali, non vengono analizzate. Pertanto, i termini con il prefisso "aria condizionata" vengono cercati nell'indice invertito e non vengono trovati.
PhraseQuery, "ocean view", cerca i termini "ocean" e "view" e controlla la prossimità dei termini nel documento originale. I documenti 1, 2 e 3 corrispondono a questa query nel campo descrizione. Si noti che il documento 4 ha il termine "oceano" nel titolo, ma non è considerato una corrispondenza, perché stiamo cercando la frase "vista oceano" anziché singole parole.
Nota
Una query di ricerca viene eseguita in modo indipendente su tutti i campi ricercabili nell'indice Azure AI Search, a meno che non si limitino i campi impostati con il parametro searchFields, come illustrato nella richiesta di ricerca di esempio. Vengono restituiti i documenti corrispondenti in uno dei campi selezionati.
Nel complesso, per la query in questione, i documenti che corrispondono sono 1, 2 e 3.
Fase 4: Assegnazione dei punteggi
A ogni documento in un set di risultati di ricerca viene assegnato un punteggio di pertinenza. La funzione del punteggio di pertinenza consiste nel classificare più in alto i documenti che meglio rispondono a una domanda dell'utente espressa dalla query di ricerca. Il punteggio viene calcolato in base alle proprietà statistiche dei termini corrispondenti. Al centro della formula di assegnazione dei punteggi c'è la frequenza dei termini - frequenza inversa dei documenti (TF/IDF). Nelle query contenenti termini rari e comuni, TF/IDF promuove i risultati contenenti il termine raro. Ad esempio, in un indice ipotetico contenente tutti gli articoli di Wikipedia, tra i documenti che corrispondono alla query il presidente, i documenti che corrispondono a presidente sono considerati più rilevanti rispetto ai documenti che corrispondono a the.
Esempio di assegnazione dei punteggi
Richiama i tre documenti che corrispondevano al nostro esempio di query.
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
Il documento 1 corrisponde alla query meglio perché sia il termine spazioso che la frase vista sull'oceano richiesta si trovano nel campo della descrizione. I prossimi due documenti corrispondono solo alla frase vista oceano. Si potrebbe essere sorpresi che i punteggi di pertinenza per i documenti 2 e 3 sono diversi, anche se corrispondono alla query nello stesso modo. Ciò è dovuto al fatto che la formula di assegnazione dei punteggi include più componenti rispetto a TF/IDF.That's because the scoring formula has more components than just TF/IDF. In questo caso, al documento 3 è stato assegnato un punteggio leggermente superiore perché la relativa descrizione è più breve. Informazioni sulla formula di punteggio pratico di Lucene per comprendere in che modo la lunghezza del campo e altri fattori possono influenzare il punteggio di pertinenza.
Alcuni tipi di query (carattere jolly, prefisso e regex) contribuiscono sempre con un punteggio costante al punteggio complessivo del documento. In questo modo, le corrispondenze trovate tramite l'espansione delle query possono essere incluse nei risultati senza influire sulla classificazione.
Un esempio illustra il motivo per cui è importante. Le ricerche con caratteri jolly, incluse le ricerche con prefisso, sono ambigue per definizione perché l'input è una stringa parziale con potenziali corrispondenze su un numero molto elevato di termini diversi. Si consideri un input di "tour*", con corrispondenze trovate in "tours", "tourettes" e "tourmaline". Data la natura di questi risultati, non c'è modo di dedurre ragionevolmente quali termini sono più preziosi di altri. Per questo motivo, ignoriamo le frequenze dei termini quando assegniamo i punteggi ai risultati delle query di tipo wildcard, prefisso ed espressione regolare. In una richiesta di ricerca in più parti che include termini parziali e completi, i risultati dell'input parziale vengono incorporati con un punteggio costante per evitare distorsioni verso corrispondenze potenzialmente impreviste.
Ottimizzazione della pertinenza
Esistono due modi per ottimizzare i punteggi di pertinenza in Azure AI Search:
I profili di punteggio alzano di livello i documenti nell'elenco classificato dei risultati in base a un set di regole. In questo esempio, è possibile considerare i documenti corrispondenti nel campo del titolo più rilevanti rispetto ai documenti corrispondenti nel campo della descrizione. Inoltre, se il nostro indice aveva un campo di prezzo per ogni hotel, potremmo promuovere i documenti con prezzi più bassi. Altre informazioni sull'aggiunta di profili di punteggio a un indice di ricerca.
Il potenziamento dei termini (disponibile solo nella sintassi completa della query Lucene) offre un operatore
^di potenziamento che può essere applicato a qualsiasi parte della struttura delle query. In questo esempio, invece di cercare il prefisso air-condition*, è possibile cercare il termine esatto air-condition o il prefisso, ma i documenti che corrispondono al termine esatto vengono classificati più in alto applicando un incremento alla query termine: air-condition^2||air-condition*. Altre informazioni sull'aumento del numero di termini in una query.
Assegnazione dei punteggi in un indice distribuito
Tutti gli indici in Azure AI Search vengono suddivisi automaticamente in più partizioni, consentendo di distribuire rapidamente l'indice tra più nodi durante l'aumento o la riduzione delle prestazioni del servizio. Quando viene eseguita una richiesta di ricerca, viene eseguita in modo indipendente per ogni partizione. I risultati di ogni partizione vengono quindi uniti e ordinati in base al punteggio (se non è definito alcun altro ordinamento). È importante sapere che la funzione di assegnazione dei punteggi pesa la frequenza del termine della query rispetto alla frequenza inversa del documento in tutti i documenti all'interno della partizione, non in tutte le partizioni.
Ciò significa che un punteggio di pertinenza può essere diverso per i documenti identici se risiedono in partizioni diverse. Fortunatamente, tali differenze tendono a scomparire man mano che il numero di documenti nell'indice cresce a causa di una distribuzione di termini più uniforme. Non è possibile presupporre in quale partizione verrà inserito alcun documento specificato. Tuttavia, supponendo che una chiave del documento non venga modificata, viene sempre assegnata alla stessa partizione.
In generale, il punteggio del documento non è l'attributo migliore per ordinare i documenti se la stabilità dell'ordine è importante. Ad esempio, dati due documenti con un punteggio identico, non c'è alcuna garanzia che uno venga visualizzato per primo nelle interrogazioni successive della stessa query. Il punteggio del documento deve dare solo un'idea generale della pertinenza del documento rispetto ad altri documenti nel set di risultati.
Conclusione
Il successo dei motori di ricerca commerciale ha generato aspettative per la ricerca full-text sui dati privati. Per quasi qualsiasi tipo di esperienza di ricerca, ora ci aspettiamo che il motore comprenda l'intenzione, anche quando i termini sono errati o incompleti. È anche possibile prevedere corrispondenze basate su termini o sinonimi quasi equivalenti che non sono mai stati specificati.
Dal punto di vista tecnico, la ricerca full-text è estremamente complessa, che richiede un'analisi linguistica sofisticata e un approccio sistematico all'elaborazione in modi che distillano, espandono e trasformano i termini di query per fornire un risultato pertinente. Data la complessità intrinseca, esistono molti fattori che possono influire sul risultato di una query. Per questo motivo, investire il tempo per comprendere i meccanismi della ricerca full-text offre vantaggi tangibili quando si tenta di gestire risultati imprevisti.
Questo articolo ha esaminato la ricerca full-text nel contesto di Azure AI Search. Ci auguriamo che fornisca un'adeguata base di conoscenze per individuare le potenziali cause e le relative soluzioni per affrontare i problemi comuni delle query.
Passaggi successivi
Compilare l'indice di esempio, provare a eseguire query diverse ed esaminare i risultati. Per le istruzioni, vedere Creare ed eseguire query su un indice nel portale di Azure.
Provare la sintassi di query aggiuntiva dalla sezione di esempio Eseguire ricerche nei documenti o da Sintassi di query semplice in Esplora ricerche nel portale di Azure.
Esamina i profili di punteggio se si vuole migliorare la classificazione nell'applicazione di ricerca.
Configurare analizzatori personalizzati per l'elaborazione minima o l'elaborazione specializzata in campi specifici.