Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Ez a témakör az indexelési folyamat három szakaszát és az egyes elsődleges összetevőket ismerteti, ismerteti az indexelési tevékenység időzítését, és néhány megjegyzést tartalmaz azoknak a külső fejlesztőknek, akik indexelni szeretnék az adattáraikat vagy fájlformátumaikat.
Ez a témakör a következőképpen van rendszerezve:
- Áttekintés
- 1. szakasz: URL-ek sorba állítása indexeléshez
- 2. szakasz: Bejárási URL-címek
- 3. szakasz: Az index frissítése
- Indexelés ütemezése
- Implementátorok
- Kapcsolódó témakörök
Áttekintés
A Windows Search támogatja a különböző fájlformátumú fájlok tulajdonságainak és tartalmának indexelését, például .doc vagy .jpeg formátumokat, valamint adattárakat, például a fájlrendszert vagy a Windows Outlook-postaládákat. Kétféle index létezik: értékindexek, amelyek lehetővé teszik a szűrést és rendezést egy tulajdonság teljes értéke alapján, valamint fordított indexek, amelyek szöveges tulajdonságokon vagy tartalomon belül indexelik a szavakat. Ha egyéni fájlformátummal vagy adattárral rendelkezik, meg kell értenie, hogy a Windows Search hogyan indexeli az elemeket, hogy helyesen történjen az indexelésük.
Az indexelési folyamat három fázisban történik, amelyet egy Windows Search-összetevő, az adatgyűjtő vezérel. Az első szakaszban az adatgyűjtő URL-címeket ad hozzá az üzenetsorokhoz. Az URL-címek azonosítják az indexelendő elemeket, és a sorok csupán rangsorolt URL-címek. A második szakaszban az adatgyűjtő koordinálja a Windows Search többi és külső összetevőjét, hogy hozzáférjenek az elemekhez, és adatokat gyűjtsenek róluk. Végül a harmadik szakaszban a rendszer hozzáadja az összegyűjtött adatokat az indexhez.
Az alábbi ábra az alapvető összetevőket és az adatok indexelési folyamaton keresztüli áramlását mutatja be. Az index adatainak gyűjtésében számos összetevő vesz részt. Ezek némelyike a Windows Search része, néhány pedig külső alkalmazásokból származik. Ha egyéni adattár- vagy fájlformátummal rendelkezik, a Windows Search a protokollkezelőre támaszkodik, és szűri az URL-címek elérését és az indexelés tulajdonságainak kibocsátását. A Windows Search-összetevők kék, a harmadik féltől származó összetevők pedig zöld színnel jelennek meg.
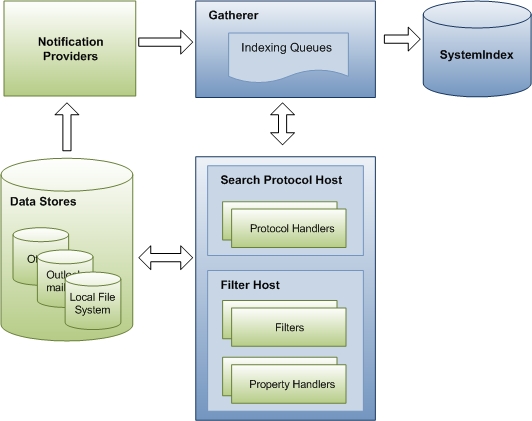
1. szakasz: url-címek várólistára helyezése indexeléshez
Az indexelés első szakaszában az adatgyűjtő adatokat gyűjt az adattárak frissítéseiről, összehasonlítja ezeket az információkat az ismert bejárási hatókörrel, majd létrehoz egy url-címsort az index adatainak gyűjtéséhez. A nem értesítésen alapuló források, például a FAT-meghajtók esetében az adatgyűjtő rendszeres időközönként kezdeményezi a bejárási hatókör teljes bejárását, hogy az indexben lévő adatok frissek legyenek. Az NTFS-hez hasonló források esetében csak egyetlen bejárás van, és minden mást a USN Change Journalértesítései kezelnek. A Microsoft Outlook sem kerül bejárásra. Az alábbi ábra a nem bejárási indexelés várólistás folyamatának magas szintű nézetét mutatja be.
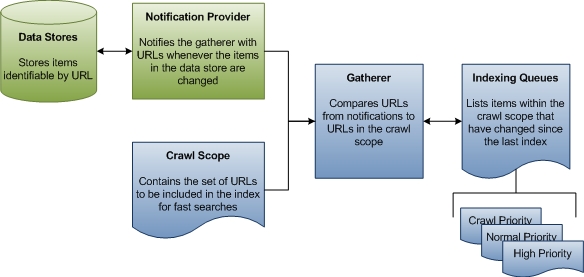
A szakasz további része azt ismerteti, hogy a Windows Search hogyan határozza meg a bejárandó URL-címeket, és hogyan határoz meg néhány fontos kifejezést az út során.
bejárási hatókör A bejárási hatókör olyan URL-címek készlete, amelyeket a Windows Search bejár, hogy adatokat gyűjtsön azokról az elemekről, amelyeket a felhasználó gyorsabban szeretne indexelni. A Windows Search alapértelmezés szerint hozzáad néhány URL-címet a bejárási hatókörhöz, például a felhasználók Dokumentumok és Képek mappáinak elérési útjait. Más URL-címeket külső alkalmazások, felhasználók és csoportházirendek is hozzáadhatnak. Végül a felhasználók és a csoportházirend kifejezetten kizárhatják az URL-címeket. A Windows Search az összes hozzáadott URL-címet felveszi, és eltávolítja a kizárt URL-címeket a bejárási hatókör meghatározásához. Ez azoknak az URL-címeknek a munkakészlete, amelyekből az adatgyűjtő megkezdi a munkáját.
Adatgyűjtő Az adatgyűjtő egy Windows Search-összetevő, amely adatokat gyűjt a bejárási hatókörben lévő URL-címekről, és létrehoz egy url-üzenetsort az indexelő bejárásához. Ha a bejárási hatókör egy elemét hozzáadják, törölik vagy frissítik, az adatgyűjtőt az adattár értesítési szolgáltatója értesíti. Van egy kezdeti bejárás, ahol az adatgyűjtő a bejárási hatókör gyökerénél kezd. Az URL-címet a protokollkezelőnek adják át, majd a megfelelő IFilterkövetkezik. A szűrő általában egy címtár-számbavétel, amely több URL-címet hoz létre. Az értesítések állandó állapotúak. Az egyes adattárak általában saját protokollkezelőt használnak, amely ezeket az értesítéseket biztosítja. A helyi fájlrendszerben például az USN change journal az file:// protokoll alatti összes URL-cím értesítésszolgáltatójaként működik. Hasonlóképpen, a Microsoft Outlook az mapi:// protokollon belüli összes URL-cím értesítésszolgáltatójaként működik. Amikor egy felhasználó megkapja, áthelyezi vagy törli az e-maileket, az Outlook értesíti az e-mail megváltozott állapotáról az adatgyűjtőt. Ezekből az értesítésekből az adatgyűjtő indexelési sorokat hoz létre az URL-címek bejárásához.
indexelő üzenetsorok Az indexelő üzenetsorok olyan URL-címek, amelyek azonosítják az indexelendő vagy újraindexelendő elemeket. Az adatgyűjtő összehasonlítja az értesítések szolgáltatóitól kapott URL-címeket a bejárási hatókör url-címével. A bejárási hatókörbe tartozó értesítésszolgáltatók minden URL-címe hozzá lesz adva egy üzenetsorhoz, amelyet az adatgyűjtő a következő feldolgozáshoz használt URL-címek rangsorolására használ.
Három üzenetsor létezik: magas prioritású értesítések, normál értesítések és rendszeres bejárások. A magas prioritású üzenetsor az olyan értesítésekhez tartozik, amelyeket azonnal fel kell dolgozni. Ha például egy felhasználó módosítja egy elem címtulajdonságát a Windows Intézőben, a Windows Intéző nézetet a módosítás után azonnal frissíteni kell. A normál értesítési üzenetsor az összes fennmaradó változásértesítéshez tartozik. Az értesítési üzenetsorok feldolgozása a bejárási üzenetsor előtt történik, mert a módosított elemek nagyobb valószínűséggel érdeklik a felhasználót. Az adatgyűjtő minden sorban az URL-ekhez tartozó adatokat éri el, elsőként be, elsőként ki (FIFO) sorrendben.
A rangsorolásról és a Windows 7-ben bevezetett esemény api-król a Windows 7-ben Indexelés rangsorolása és a Sorhalmazesemények a Windows 7-bencímű témakörben talál további információt. A bejárási hatókörök kezelésével és értesítésekkel kapcsolatos további információkért lásd: Változásértesítések biztosítása és a Bejárási hatókörkezelőhasználatával.
2. szakasz: URL-címek bejárása
Az indexelés második szakaszában a gyűjtő végigjárja a sorokat, hozzáfér az adattárakhoz és beolvassa az elemstreameket. Először az adatgyűjtő megkeresi a megfelelő protokollkezelőt minden URL-címhez. Ezután az adatgyűjtő átadja az URL-címet a protokollkezelőnek. A protokollkezelő hozzáfér az elemhez, és visszaadja az elem metaadatait az adatgyűjtőnek. Az adatgyűjtő a metaadatok alapján azonosítja a megfelelő szűrőt.
Az alábbi ábrán az URL-bejárási folyamat magas szintű nézete látható. Ez a szakasz jelentős koordinációt és az összetevők közötti kommunikációt is magában foglalja.
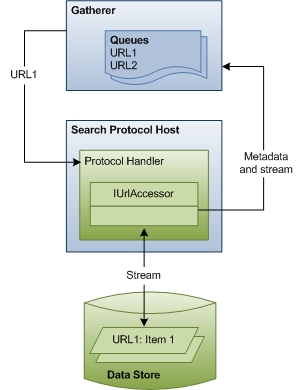 elérésének folyamatát bemutató diagram
A szakasz további része azt ismerteti, hogyan fér hozzá a Windows Search az indexeléshez szükséges elemekhez, és ismerteti az egyes érintett összetevők szerepköreit.
adatgyűjtő A 2. fázisban, a bejárás során, az adatgyűjtő feldolgozza a sorok URL-címeit, kezdve a magas prioritású sorral. Minden URL-címet megvizsgálunk a protokoll azonosításához. Az adatgyűjtő ezután megkeresi az adott protokollhoz regisztrált protokollkezelőt, és példányosítja azt a keresési protokoll gazdafolyamatában.
Keresési protokoll gazdagépe A keresési protokoll gazdagépe csupán egy dobozos gazdafolyamat a protokollkezelők számára. A Windows Search általában két ilyen gazdafolyamatot hoz létre: egyet, amely a rendszerbiztonsági környezetben fut, és egyet, amely a felhasználói biztonsági környezetben fut. Ez az elkülönítés biztosítja, hogy a felhasználóra vonatkozó adatok soha ne fussanak a rendszerkörnyezetben.
A Windows Search a gazdafolyamat használatával elkülöníti a protokollkezelő egy példányát más folyamatoktól vagy alkalmazásoktól. Így egyetlen külső alkalmazás sem férhet hozzá a protokollkezelő adott példányához, és ha a protokollkezelő váratlanul meghibásodik, csak az indexelési folyamat lesz érintett. Mivel a gazdafolyamat harmadik féltől származó kódot (protokollkezelőket) futtat, a Windows Search rendszeresen újrahasznosítja a folyamatot, hogy minimalizálja a sikeres támadás során a folyamat információinak kihasználásához szükséges időt. A keresési protokollt szolgáló gazdagép ezen túlmenően nem befolyásolja az URL-címek bejárását vagy az elemek indexelését.
protokollkezelők protokollkezelők hozzáférést biztosítanak az adattár elemeihez az adattár protokolljával. Az NTFS protokollkezelő például hozzáférést biztosít a helyi meghajtón lévő fájlokhoz a file:// protokoll használatával. A protokollkezelő tudja, hogyan lépkedhet be az adattárba, azonosíthatja az új vagy frissített elemeket, és értesítheti az adatgyűjtőt. Ezután a bejárás megkezdésekor a protokollkezelő egy IUrlAccessor objektumot biztosít az adatgyűjtőnek az elem mögöttes adatfolyamához való kötéshez, és visszaadja az elem metaadatait, például a biztonsági korlátozásokat és a legutóbb módosított időpontot.
Jegyzet
A protokollkezelők nem Windows Search-összetevők; ezek az adott protokoll és adattár összetevői, amelyeket hozzáférésre terveztek. Ha van egy egyéni adattára, amelyet indexelni szeretne, egy protokollkezelőt kell implementálnia. A protokollkezelőkről és azok implementálásáról további információt Protokollkezelők fejlesztésecímű témakörben talál.
Metaadatok és Stream A protokollkezelő IUrlAccessor objektum által visszaadott metaadatok használatával az adatgyűjtő azonosítja az URL-cím megfelelő szűrőjét. Az adatgyűjtő elemzi az elem fájlnévkiterjesztését, és megkeresi a bővítményhez regisztrált szűrőt. Ha az adatgyűjtő nem talál szűrőt, a Windows Search a metaadatok alapján minimális rendszertulajdonság-információkat (például System.ItemName) hoz létre, és frissíti az indexet. Ellenkező esetben, ha az adatgyűjtő megtalálja a szűrőt, megkezdődik az indexelés harmadik szakasza.
3. szakasz: az index frissítése
Az indexelés harmadik szakaszában az adatgyűjtő példányosítja az URL-cím megfelelő szűrőit, és inicializálja a szűrőt a IUrlAccessor objektumból származó adatfolyammal. A szűrő ezután hozzáfér az elemhez, és visszaadja az index tartalmát. Ha egyéni fájlformátummal rendelkezik, a Windows Search a szűrőre támaszkodva fér hozzá az URL-címekhez, és tartalmat és tulajdonságokat bocsát ki az indexeléshez.
Az alábbi ábrán az adatelérési folyamat magas szintű nézete látható. Ez a szakasz jelentős koordinációt és az összetevők közötti kommunikációt is magában foglalja.
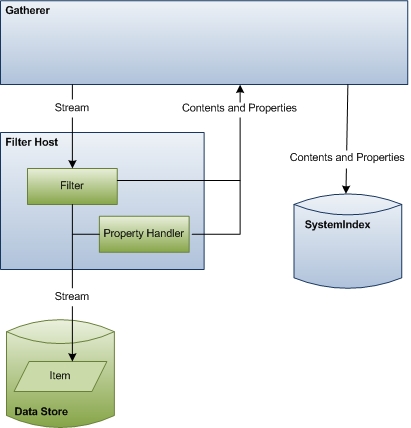
A szakasz további része azt ismerteti, hogyan fér hozzá a Windows Search az indexeléshez szükséges elemadatokhoz, és ismerteti az egyes érintett összetevők szerepköreit.
adatgyűjtő A szakasz elején az adatgyűjtő feladata az elem megfelelő szűrőjének példányosítása és az elemadatfolyam továbbítása. A szakasz végén az adatgyűjtő átveszi a szűrő és a tulajdonságkezelő által kibocsátott tartalmat és tulajdonságokat, és frissíti az indexet.
Szűrő gazda folyamat A szűrő gazda folyamat csupán a szűrők és tulajdonságkezelők gazdafolyamata, és hasonló szolgáltatást nyújt, mint a keresési protokoll gazda folyamata. A gazdafolyamat elkülöníti a szűrőket és a tulajdonságkezelőket a rendszer többi részétől ugyanazért a biztonsági és stabilitási okokért, amelyek miatt a keresési protokoll gazdagépe elkülöníti a protokollkezelőket. A gazdafolyamat minimális jogosultságokkal fut (még a fájlrendszerhez sem fér hozzá), és időnként újra hasznosítják a biztonsági támadások elleni védelem érdekében. A Windows Search az erőforrás-használatot is figyeli, így ha egy szűrő túl sok erőforrást használ fel, a gazdafolyamat újraindul.
Szűrők A szűrők az indexelési folyamat kritikus összetevői, amelyek elemadatokat bocsátanak ki a gyűjtő számára. A szűrők neve a megvalósítás során használt egyszerű felületről, az IFilter felületről van elnevezve, ezért néha IFilter-nek is nevezik. Kétféle szűrő létezik: az egyik az egyes elemekkel, például fájlokkal, a másik pedig a tárolókkal, például mappákkal kommunikál. Mindkettő adatokat szolgáltat az indexhez.
A protokollkezelő IUrlAccessor objektum által visszaadott metaadatok használatával az adatgyűjtő azonosítja egy adott URL-cím megfelelő szűrőjét, és továbbítja azt a streamnek. Az adatgyűjtő azonosítja a megfelelő szűrőt egy protokollkezelőn keresztül, vagy a fájlnévkiterjesztés, a MIME típusa vagy az osztályazonosító (CLSID) alapján. Ha az URL-cím egy tárolóra mutat, a szűrő a tároló tulajdonságait bocsátja ki, és számba adja a tároló elemeit (gyermek URL-címek). Ha az URL-cím egy elemre mutat, a szűrő a szöveges tartalmat adja vissza, amennyiben van ilyen; a tulajdonságok olvasása és kezelése összetettebb, mint a tulajdonságkezelők alkalmazása. Általában azt javasoljuk, hogy a szűrők elemtartalmat bocsátanak ki, míg a tulajdonságkezelők elemtulajdonságokat bocsátanak ki. Ha azonban a szűrőnek olyan régebbi alkalmazásokkal kell dolgoznia, amelyek nem ismerik fel a tulajdonságkezelőket, a szűrőt a tulajdonságok kibocsátásához is implementálhatja.
Jegyzet
A szűrők nem Windows Search-összetevők; ezek az adott fájlformátumhoz vagy tárolóhoz kapcsolódó összetevők, amelyeket hozzáférésre terveztek. További információért a szűrők alkalmazásáról és azok egyéni fájlformátumokhoz vagy tárolókhoz való implementálásáról nézze meg a Ajánlott eljárások a szűrőkezelők Windows Searchben való létrehozásáhozdokumentumot.
Az alábbi táblázat felsorolja azokat az eredményeket, amelyeket az adatgyűjtő egy szűrőtől (IFilter) és tulajdonságkezelőtől (IPropertyStore) fogad az indexelési folyamat során.
| IFilter | IPropertyStore | |
|---|---|---|
| Írás engedélyezése | Nem | Igen |
| Tartalom és tulajdonságok keverése | Igen | Nem |
| többnyelvű | Igen | Nem |
| Hivatkozások küldése | Igen | Nem |
| MIME | Igen | Nem |
| szöveghatárok | Mondat, bekezdés, fejezet | Egyik sem |
| ügyfél/ kiszolgáló | Mindkettő | Ügyfél |
| Megvalósítás | Összetett | Egyszerű |
Tulajdonságkezelők Tulajdonságkezelők olyan összetevők, amelyek egy adott fájlformátumhoz tartozó tulajdonságokat olvasnak és írnak. Ugyanúgy férnek hozzá az elemekhez, és tulajdonságokat bocsátanak ki az adatgyűjtő számára, mint a szűrők a tartalom esetében. A tulajdonságkezelők egyszerűbben implementálhatóak, mint a szűrők. Ha egy szövegalapú fájlformátum nagyon egyszerű, vagy a fájlok várhatóan nagyon kicsik lesznek, a tulajdonságkezelő tulajdonságokat és tartalmakat is képes kibocsátani.
Jegyzet
A tulajdonságkezelők nem Windows Search-összetevők; ezek az adott fájlformátumhoz kapcsolódó összetevők, amelyeket a hozzáférésre terveztek. A tulajdonságkezelőkről és az egyéni fájlformátumok implementálásáról további információt A Windows Searchtulajdonságkezelőinek fejlesztése című témakörben talál.
Tulajdonságok A Windows Search egy tulajdonságrendszer- biztosít, amely számos tulajdonságtárat tartalmaz. Bármely tulajdonság bármely elemen megjelenhet a szűrő vagy a tulajdonságkezelő által meghatározott módon. Ha egyéni fájlformátummal rendelkezik, a fájlformátum tulajdonságait ezekre a rendszertulajdonságokra képezheti le, és új egyéni tulajdonságokat is létrehozhat. Amikor a szűrő vagy a tulajdonságkezelő kibocsátja ezeket a tulajdonságokat, az adatgyűjtő frissíti az indexet, hogy a felhasználók a tulajdonságok alapján kereshessenek. Az egyéni tulajdonságok fájlformátumhoz való létrehozásáról és regisztrálásáról további információt a Tulajdonságrendszercímű témakörben talál.
SystemIndex A SystemIndex nevű index index indexelt adatokat tárol, és egy tulajdonságtárolóból és az elemtulajdonságok tulajdonságaira és tartalmára vonatkozó indexekből, valamint a szöveges tartalom és tulajdonságok invertált indexéből áll. Miután az adatgyűjtő frissítette az indexet, a Windows Search és más alkalmazások lekérdezhetik az indexet. Az index lekérdezésének módjairól további információt Az index programozott lekérdezésecímű témakörben talál.
Jegyzet
Ne feledje, hogy a séma újbóli regisztrálásakor előfordulhat, hogy az indexelő nem tartja tiszteletben a korábban definiált tulajdonságok attribútumainak módosításait. A megoldás vagy az index újraépítése, vagy új tulajdonságok bevezetése, amelyek a régiek frissítése helyett a változásokat tükrözik (nem ajánlott). További információért lásd a Megjegyzés a megvalósítók számára című részt a Tulajdonságok rendszerének áttekintése-ban.
Az indexelés ütemezése
Amikor a Windows Search először van telepítve, teljesen indexeli a bejárási hatókört, és szünetel magas I/O- és felhasználói tevékenységek idején. Az alapértelmezett bejárási hatókör az alapértelmezett tárhelyekből áll, például Dokumentumok, Zene, Képekés Videók. Az értesítések feldolgozása még azelőtt történik, hogy a kezdeti bejárás befejeződne. Időnként az adatgyűjtő bejárja az URL-címeket a teljes bejárási hatókörből. Ezek a teljes bejárások biztosítják, hogy az index adatai frissek legyenek. Ha például egy értesítésszolgáltató nem küld értesítéseket, vagy ha a Windows Search szolgáltatás váratlanul leáll, az adatgyűjtő nem tud új vagy módosított elemekről, és nem indexelné ezeket az elemeket. Kétféle forrás létezik: értesítés kizárólag és értesítés engedélyezett. Mindkét forrásban az adatgyűjtő először bejárja az indexet. A kezdeti bejárás után a csak értesítéseket küldő források soha nem végeznek teljes bejárást, hacsak nem történik hiba, például ha a USN változásnapló kifut. Az értesítés-kompatibilis források növekményes bejárást végeznek az indexelő indításakor, majd figyelik az értesítéseket futás közben. Az NTFS és a Microsoft Outlook csak értesítési módban vannak. Az Internet Explorer és a FAT értesítés engedélyezve van.
Megjegyzések a megvalósítók számára
Az indexben lévő adatok minősége és az indexelési folyamat hatékonysága nagyban függ a szűrő és a tulajdonságkezelő implementációjától. Mivel a szűrőt minden alkalommal meghívják, amikor egy URL azonosítja a fájlformátumot, az indexelési folyamat jelentősen lelassulhat, ha a szűrő nem hatékony. Ha a tulajdonságkezelő nem felelteti meg megfelelően az összes fájltulajdonságot a rendszertulajdonságoknak, vagy nem adja ki helyesen ezeket a tulajdonságokat, az indexben lévő adatok helytelenek lesznek, és a tulajdonságok későbbi keresése helytelen eredményeket ad vissza. Ha a szűrő vagy a tulajdonságkezelő meghibásodik, az indexelő nem fogja tudni indexelni az adatokat.
A Windows Searchen kívüli alkalmazások és folyamatok protokollkezelőkre, szűrőkre és tulajdonságkezelőkre támaszkodnak. Implementációi olyan módon befolyásolhatják ezeket az alkalmazásokat, amelyeket nem várna. A Windows keresési fejlesztési útmutatója tanácsokat nyújt a tervezési döntésekhez és az egyes összetevők teszteléséhez.
Kapcsolódó témakörök
Indexelés, lekérdezés és értesítések a Windows Search
Lekérdezési Folyamat a Windows Searchben