Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Feljegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Az Azure AI Keresés minden vektormezőhöz létrehoz egy belső vektorindexet a mezőben megadott algoritmusparaméterek használatával. Mivel az Azure AI Keresés kvótákat ír elő a vektorindexek méretére, ismernie kell a vektorméret becslését és monitorozását, hogy a korlátok alatt maradjon.
A keresési indexek fizikai adatstruktúrái belsőleg a következők:
- Nyers tartalom (olyan lekérési mintákhoz használatos, amelyek nem módosított tartalmat igényelnek)
- Invertált indexek (kereshető szövegmezőkhöz használatos)
- Vektorindexek (kereshető vektormezőkhöz használatos)
Ez a cikk az egyes vektormezők belső vektorindexeinek korlátait ismerteti.
Tipp.
A vektoroptimalizálási technikák általánosan elérhetők. Használjon olyan képességeket, mint a keskeny adattípusok, a skaláris és bináris kvantálás, valamint a redundáns tárolás megszüntetése a vektorkvóta és a tárkvóta használatának csökkentése érdekében.
A kvóta és a vektorindex méretének főbb pontjai
A vektorindex mérete bájtban van mérve.
A szolgáltatás teljes tárterülete tartalmazza az összes vektorindexfájlt. Az Azure AI Keresés különböző célokra kezeli a vektorindexfájlok különböző másolatait. Más lehetőségeket is kínálunk a vektorindexek tárolási többletterhelésének csökkentésére ezen másolatok némelyikének eltávolításával.
A vektorkvóták a keresési szolgáltatás egészére vannak kényszerítve partíciónként. Partíciók hozzáadása esetén a vektorkvóta is nő. A partíciónkénti vektorkvóták magasabbak az újabb szolgáltatásoknál. További információkért lásd a vektorindex méretkorlátait.
Nem minden algoritmus használ vektorindex-méretkvótát. A vektorkvóták a közelítő szomszéd (ANN) keresés memóriakövetelményei alapján jönnek létre. A hierarchikus Navigable Small World (HNSW) algoritmussal létrehozott vektormezőknek a gráfalapú bejárások véletlenszerű hozzáférésű jellege miatt a memóriában kell elhelyezkedniük a lekérdezés végrehajtása során. A teljes K-Legközelebbi szomszédok (KNN) algoritmust használó vektormezők dinamikusan töltődnek be a memóriába a lekérdezés végrehajtása során az oldalakba, így nem használnak vektorkvótát.
Partíció méretének és mennyiségének ellenőrzése
Ha nem biztos abban, hogy mik a keresési szolgáltatás korlátai, az alábbi két módon szerezheti be ezeket az információkat:
Az Azure Portal keresési szolgáltatás áttekintési lapján a Tulajdonságok lap és a Használat lap is megjeleníti a partíció méretét és a tárterületet, valamint a vektorkvóta és a vektorindex méretét.
Az Azure Portal Méretezés lapján áttekintheti a partíciók számát és méretét.
A vektorkorlát a szolgáltatás létrehozásának dátumától függően változik.
Vektorindex méretének ellenőrzése
A vektormetrikák kérése egy adatforgalmi művelet. Az Azure Portal, a REST API-k vagy az Azure SDK-k használatával szolgáltatásstatisztikákon és egyéni indexeken keresztül kaphat vektorhasználatot a szolgáltatás szintjén.
Vektorméret indexenként
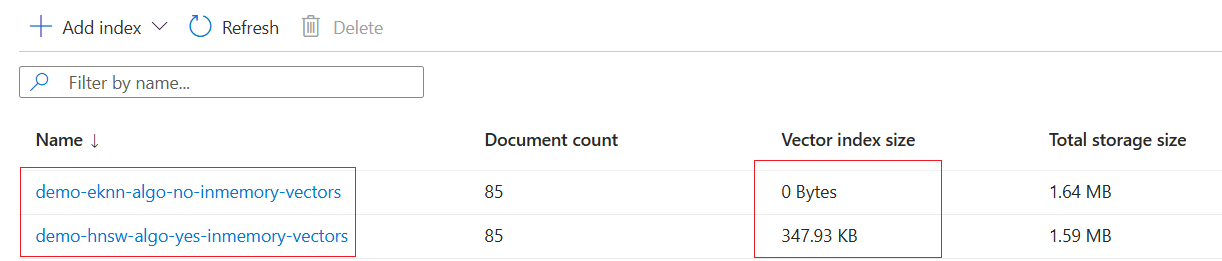
A vektorindex indexenkénti méretének lekéréséhez válassza a Kereséskezelési>indexek lehetőséget az indexek és a dokumentumszám, a memóriabeli vektorindexek méretének és a lemezen tárolt teljes indexméretnek a megtekintéséhez.
Ne feledje, hogy a vektorkvóta memóriakorlátozásokon alapul. A HNSW algoritmussal létrehozott vektorindexek esetében az összes kereshető vektorindex véglegesen betöltődik a memóriába. A teljes KNN-algoritmussal létrehozott indexek esetében a vektorindexek tömbökbe vannak betöltve, sorrendben, a lekérdezési idő alatt. A teljes KNN-indexekhez nincs memóriahelyre vonatkozó követelmény. A memóriában betöltött lapok élettartama hasonló a szöveges kereséshez, és a teljes tárterületen kívül más metrikák nem alkalmazhatók a teljes KNN-indexekre.
Az alábbi képernyőképen ugyanannak a vektorindexnek két verziója látható. Egy verzió HNSW algoritmussal jön létre, ahol a vektordiagram memóriabeli rezidens. Egy másik verziót teljes körű KNN-algoritmussal hozunk létre. A teljes KNN-vel nincs speciális memóriabeli vektorindex, így a portál 0 MB-ot jelenít meg a vektorindex méretéhez. Ezek a vektorok továbbra is léteznek, és a teljes tárterület méretében vannak megszámolva, de nem foglalják el azt a memóriabeli erőforrást, amelyet a vektorindex mérete metrika követ.
Vektorméret szolgáltatásonként
A keresési szolgáltatás egészének vektorindex-méretének lekéréséhez válassza az Áttekintés lap Használat lapját. A portáloldalak néhány percenként frissülnek, így ha nemrég frissített egy indexet, várjon egy kicsit az eredmények ellenőrzése előtt.
Az alábbi képernyőkép egy régebbi Standard 1 (S1) keresési szolgáltatáshoz készült, amely egy partícióhoz és egy replikához van konfigurálva.
A tárkvóta lemezkvótát jelent, amely magában foglalja a keresési szolgáltatás összes indexét (vektort és nonvektort).
A vektorindex-méretkvóta memóriakorlát. Ez a keresési szolgáltatás egyes vektormezőihez létrehozott összes belső vektorindex betöltéséhez szükséges memória mennyisége.
A képernyőkép azt jelzi, hogy az indexek (vektorok és nonvektorok) közel 460 megabájtnyi rendelkezésre álló lemeztárolót használnak fel. A vektorindexek szolgáltatásszinten közel 93 megabájt memóriát használnak fel.
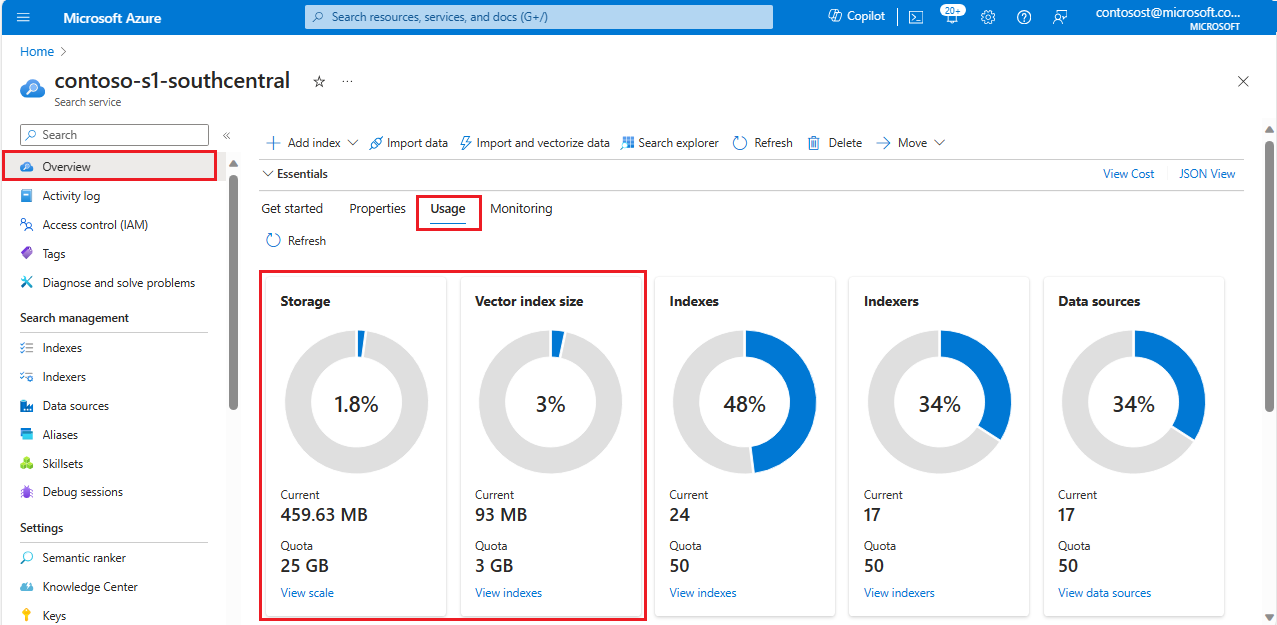
A partíciók hozzáadásakor vagy eltávolításakor mind a tárterület, mind a vektorindex méretének kvótái növekednek vagy csökkennek. Ha módosítja a partíciók számát, a csempe a tárterület és a vektorkvóta megfelelő változását jeleníti meg.
Feljegyzés
A lemezen a vektorindexek nem 93 megabájt. A lemez vektorindexei körülbelül háromszor több helyet foglalnak el, mint a memória vektorindexei. A részletekért tekintse meg, hogyan befolyásolják a vektormezők a lemeztárolót .
A vektorindex méretét befolyásoló tényezők
A belső vektorindex méretét három fő összetevő befolyásolja:
- Az adatok nyers mérete
- A kijelölt algoritmus többletterhelése
- Az indexen belüli dokumentumok törlésével vagy frissítésével kapcsolatos többletterhelés
Az adatok nyers mérete
Minden vektor általában egy egy pontosságú lebegőpontos számokat tartalmazó tömb egy típusmezőben Collection(Edm.Single).
A vektoros adatstruktúrák tárolást igényelnek, amely az alábbi számításban az adatok "nyers méreteként" jelenik meg. Ezzel a nyers mérettel megbecsülheti a vektormezők vektorindex-méretére vonatkozó követelményeket.
Egy vektor dimenziója határozza meg a tároló méretét. Szorozza meg egy vektor méretét a vektormezőt tartalmazó dokumentumok számával a nyers méret eléréséhez:
raw size = (number of documents) * (dimensions of vector field) * (size of data type)
| EDM-adattípus | Az adattípus mérete |
|---|---|
Collection(Edm.Single) |
4 bájt |
Collection(Edm.Half) |
2 bájt |
Collection(Edm.Int16) |
2 bájt |
Collection(Edm.SByte) |
1 bájt |
A kijelölt algoritmus memóriaterhelése
Minden ANN-algoritmus további adatstruktúrákat hoz létre a memóriában a hatékony keresés érdekében. Ezek a struktúrák extra helyet foglalnak el a memóriában.
A HNSW algoritmus esetében a memóriaterhelés 1% és 20% között mozog a tömörítetlen lebegőpontos32 (Edm.Single) vektorok esetében.
A dimenzió növekedésével a memória többletterhelése csökken. Ez azért fordul elő, mert a vektorok nyers mérete megnő, míg a gráfkapcsolati adatokat tároló többi adatstruktúra rögzített méretű maradnak egy adott m. Ennek eredményeképpen ezeknek a további adatstruktúráknak a relatív hatása csökken a teljes vektormérethez képest.
A memóriaterhelés a HNSW paraméter mnagyobb értékeivel nő, ami meghatározza az egyes új vektorokhoz az indexek felépítése során létrehozott kétirányú kapcsolatok számát. Ez azért fordul elő, mert minden hivatkozás körülbelül 8–10 bájttal járul hozzá dokumentumonként, és a teljes többletterhelés arányosan skálázódik m.
Az alábbi táblázat a tömörítetlen vektormezők belső tesztjeiben megfigyelt többletterhelési százalékokat foglalja össze:
| Dimenziók | HNSW paraméter (m) | Többletterhelés százalékos aránya |
|---|---|---|
| 96 | 4 | 20% |
| 200 | 4 | 8% |
| 768 | 4 | 2% |
| 1536 | 4 | 1% |
| 3072 | 4 | 0,5% |
Ezek az eredmények a dimenziók, a HNSW paraméter més a HNSW-algoritmus memóriaterhelése közötti kapcsolatot mutatják be.
A tömörítési technikákat ( például skaláris vagy bináris kvantálást) használó vektormezők esetében a többletterhelési százalék a teljes vektorindex méretének nagyobb százalékát használja fel. Ahogy csökken az adatok mérete, a gráfkapcsolati adatok tárolására használt rögzített méretű adatstruktúrák relatív hatása is jelentősebbé válik.
Az indexen belüli dokumentumok törlésével vagy frissítésével kapcsolatos többletterhelés
Ha egy vektormezővel rendelkező dokumentumot törölnek vagy frissítenek (a frissítések belsőleg törlési és beszúrási műveletként jelennek meg), az alapul szolgáló dokumentumot töröltként jelöli meg, és a későbbi lekérdezések során kihagyja. Az új dokumentumok indexelése és a belső vektorindex növekedésével a rendszer megtisztítja ezeket a törölt dokumentumokat, és visszanyeri az erőforrásokat. Ez azt jelenti, hogy valószínűleg késés tapasztalható a dokumentumok törlése és a felszabadított mögöttes erőforrások között.
Ezt a törölt dokumentumok arányának tekintjük. Mivel a törölt dokumentumok aránya a szolgáltatás indexelési jellemzőitől függ, nincs univerzális heurisztikus paraméter ennek a paraméternek a becsléséhez, és nincs olyan API vagy szkript, amely visszaadja a szolgáltatásra érvényes arányt. Megfigyeltük, hogy ügyfeleink fele 10%-nál kisebb törölt dokumentumokkal rendelkezik. Ha általában nagy gyakoriságú törléseket vagy frissítéseket végez, akkor előfordulhat, hogy magasabb a törölt dokumentumok aránya.
Ez egy másik tényező, amely befolyásolja a vektorindex méretét. Sajnos nincs mechanizmusunk a törölt dokumentumok aktuális arányának felszínre hozására.
A memóriában lévő adatok teljes méretének becslése
A korábban ismertetett tényezők figyelembevételével a vektorindex teljes méretének becsléséhez használja a következő számítást:
(raw_size) * (1 + algorithm_overhead (in percent)) * (1 + deleted_docs_ratio (in percent))
A raw_size kiszámításához tegyük fel például, hogy egy népszerű Azure OpenAI-modellt text-embedding-ada-002 használ 1536 dimenzióval. Ez azt jelenti, hogy egy dokumentum 1536 Edm.Single (lebegőpontos) vagy 6144 bájtot használna fel, mivel mindegyik Edm.Single 4 bájt. 1 000 dokumentum, amely egyetlen, 1 536 dimenziós vektormezőt tartalmaz, összesen 1 000 dokumentum x 1 536 lebegőpontos szám/dokumentum = 1 536 000 lebegőpontos számot, vagyis 6 144 000 bájtot fogyasztana.
Ha több vektormezővel rendelkezik, ezt a számítást az index minden egyes vektormezőjéhez el kell végeznie, és össze kell adnia őket. Például 1000 dokumentum esetén, amelyeknek két darab 1536 dimenziós vektormezőjük van, az erőforrásigény: 1000 dokumentum x 2 mező x 1536 lebegőpontos érték/dokumentum x 4 bájt/érték = 12 288 000 bájt.
A vektorindex méretének megállapításához szorozza meg ezt a raw_size értéket az algoritmus többlettel és a törölt dokumentumarány. Ha a választott HNSW-paraméterek algoritmusterhelése 10%, a törölt dokumentum aránya pedig 10%, akkor a következőt kapjuk: 6.144 MB * (1 + 0.10) * (1 + 0.10) = 7.434 MB.
A vektormezők hatása a lemeztárolóra
A cikk nagy része a memória vektorainak méretéről nyújt tájékoztatást. A vektorindexek tárolási többletterheléséről további információt a nem kötelező vektorpéldányok kizárása a tárolóból című témakörben talál.