Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Nota
Búsqueda de Azure AI está disponible a través del portal de Azure, las API REST y los SDK de Azure. También respalda Foundry IQ, la capa de conocimiento administrada que transforma el contenido empresarial en bases de conocimiento reutilizables y compatibles con permisos para agentes en el portal de Microsoft Foundry.
La búsqueda de texto completo es un enfoque en la recuperación de información que coincide con el texto sin formato almacenado en un índice. Por ejemplo, dada una cadena de consulta "hotels in San Diego on the beach", el motor de búsqueda busca cadenas tokenizadas basadas en esos términos. Para que los exámenes sean más eficaces, las cadenas de consulta se someten a un análisis léxico: minúsculas de todos los términos, quitando palabras irrelevantes como los artículos y reduciendo términos a formularios raíz primitivos. Cuando se encuentran términos coincidentes, el motor de búsqueda recupera documentos, los clasifica en orden de relevancia y devuelve los resultados principales.
La ejecución de consultas puede ser compleja. Este artículo es para desarrolladores que necesitan una comprensión más profunda de cómo funciona la búsqueda de texto completo en Búsqueda de Azure AI. En el caso de las consultas de texto, Búsqueda de Azure AI entrega sin problemas los resultados esperados en la mayoría de los escenarios, pero en ocasiones, puede obtenerse un resultado que parece "fuera de lugar" de alguna manera. En estas situaciones, tener un fondo en las cuatro fases de ejecución de consultas de Lucene (análisis de consultas, análisis léxico, coincidencia de documentos y puntuación) puede ayudarle a identificar cambios específicos en los parámetros de consulta o la configuración de índice que producen el resultado deseado.
Nota
Búsqueda de Azure AI usa Apache Lucene para la búsqueda de texto completo, pero la integración de Lucene no es exhaustiva. Exponemos y amplíamos selectivamente la funcionalidad de Lucene para habilitar los escenarios importantes para Búsqueda de Azure AI.
Introducción a la arquitectura y diagrama
La ejecución de consultas tiene cuatro etapas.
- Análisis de consultas
- Análisis léxico
- Recuperación de documentos
- Puntuación
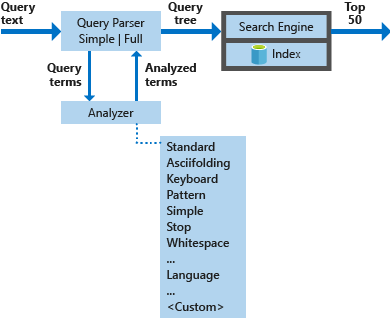
Una consulta de búsqueda de texto completo comienza por analizar el texto de la consulta para extraer los términos y operadores de búsqueda. Hay dos analizadores para que pueda elegir entre velocidad y complejidad. Una fase de análisis es la siguiente, donde los términos de consulta individuales a veces se dividen y se reconstituyen en nuevas formas. Este paso ayuda a convertir una red más amplia sobre lo que podría considerarse una coincidencia potencial. A continuación, el motor de búsqueda examina el índice para encontrar documentos con términos coincidentes y asigna una puntuación a cada coincidencia. A continuación, un conjunto de resultados se ordena por una puntuación de relevancia asignada a cada documento coincidente individual. Los que se encuentran en la parte superior de la lista de clasificación se devuelven a la aplicación que realiza la llamada.
En el diagrama siguiente se muestran los componentes usados para procesar una solicitud de búsqueda:
| Componentes clave | Descripción funcional |
|---|---|
| Analizadores de consultas | Separe los términos de consulta de los operadores de consulta y cree la estructura de consulta (un árbol de consulta) que se enviará al motor de búsqueda. |
| Analizadores | Realice un análisis léxico en términos de consulta. Este proceso puede implicar la transformación, eliminación o expansión de términos de consulta. |
| Índice | Estructura de datos eficaz que se usa para almacenar y organizar los términos que se pueden buscar extraídos de documentos indexados. |
| Motor de búsqueda | Recupera y puntúa los documentos coincidentes en función del contenido del índice invertido. |
Anatomía de una solicitud de búsqueda
Una solicitud de búsqueda es una especificación completa de lo que se debe devolver en un conjunto de resultados. En su forma más sencilla, es una consulta vacía sin criterios de ningún tipo. Un ejemplo más realista incluye parámetros, varios términos de consulta, quizás con ámbito a determinados campos, con posiblemente una expresión de filtro y reglas de ordenación.
En el ejemplo siguiente se muestra una solicitud de búsqueda que puede enviar a Búsqueda de Azure AI mediante la API REST:
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
Para esta solicitud, el motor de búsqueda realiza las siguientes operaciones:
Busca documentos en los que el precio es de al menos $60 y menos de $300.
Ejecuta la consulta. En este ejemplo, la consulta de búsqueda consta de frases y términos:
"Spacious, air-condition* +\"Ocean view\""(Los usuarios normalmente no escriben signos de puntuación, pero al incluirla en el ejemplo, podemos explicar cómo lo controlan los analizadores).Para esta consulta, el motor de búsqueda examina los campos de descripción y título especificados en "searchFields" para los documentos que contienen
"Ocean view", y además en el término"spacious", o en términos que comienzan por el prefijo"air-condition". El parámetro "searchMode" se usa para buscar coincidencias en cualquier término (valor predeterminado) o en todos ellos, en los casos en los que un término no es necesario explícitamente (+).Ordena el conjunto resultante de hoteles por proximidad a una ubicación geográfica determinada y, a continuación, devuelve los resultados a la aplicación que realiza la llamada.
La mayoría de este artículo trata sobre el procesamiento de la consulta de búsqueda: "Spacious, air-condition* +\"Ocean view\"". El filtrado y la ordenación están fuera del ámbito. Para más información, consulte la documentación de referencia de Search API.
Fase 1: Análisis de consultas
Como se indicó, la cadena de consulta es la primera línea de la solicitud:
"search": "Spacious, air-condition* +\"Ocean view\"",
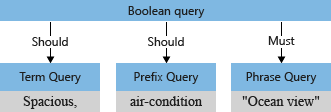
El analizador de consultas separa los operadores (como * y + en el ejemplo) de los términos de búsqueda y deconstruye la consulta de búsqueda en subconsultas de un tipo admitido:
- consulta de término para términos independiente (como "espacioso")
- búsqueda de frases para términos entre comillas (como vista al océano)
-
consulta de prefijo para términos seguidos de un operador
*de prefijo (como aire acondicionado)
Para obtener una lista completa de los tipos de consulta admitidos, consulte Sintaxis de consulta de Lucene.
Los operadores asociados a una subconsulta determinan si la consulta "debe ser" o "puede cumplirse" para que un documento se considere una coincidencia. Por ejemplo, +"Ocean view" es obligatorio debido al operador +.
El analizador de consultas reestructura las subconsultas en un árbol de consulta (una estructura interna que representa la consulta), que pasa al motor de búsqueda. En la primera fase del análisis de consultas, el árbol de consultas tiene el siguiente aspecto:
Analizadores admitidos: versión simple y completa de Lucene
Búsqueda de Azure AI expone dos lenguajes de consulta diferentes: simple (valor predeterminado) y full. Al establecer el parámetro con la queryType solicitud de búsqueda, se indica al analizador de consultas qué lenguaje de consulta elija para que sepa cómo interpretar los operadores y la sintaxis.
El lenguaje de consulta simple es intuitivo y sólido, a menudo adecuado para interpretar la entrada del usuario as-is sin procesamiento del lado cliente. Admite operadores de consulta conocidos de los motores de búsqueda web.
El lenguaje de consulta Full Lucene, que se obtiene estableciendo
queryType=full, amplía el lenguaje de consulta simple predeterminado agregando compatibilidad con más operadores y tipos de consulta, como caracteres comodín, consultas difusas, expresiones regulares y consultas delimitadas por campo. Por ejemplo, una expresión regular enviada en sintaxis de consulta simple se interpretaría como una cadena de consulta y no una expresión. En este artículo, la solicitud de ejemplo utiliza el lenguaje de consulta completo de Lucene.
Impacto de searchMode en el analizador
Otro parámetro de solicitud de búsqueda que afecta al análisis es el parámetro "searchMode". Controla el operador predeterminado para las consultas booleanas: cualquier (valor predeterminado) o todo.
Cuando "searchMode=any", que es el valor predeterminado, el delimitador de espacio entre espacioso y aire acondicionado es OR (||), lo que hace que el texto de consulta de ejemplo sea equivalente a:
Spacious,||air-condition*+"Ocean view"
Los operadores explícitos, como + en +"Ocean view", son inequívocas en la construcción de consultas booleanas (el término debe coincidir). Menos obvio es cómo interpretar los términos restantes: espacioso y aire acondicionado. ¿El motor de búsqueda debería encontrar coincidencias en "vistas al mar" y "espacioso" y "post-vacacional"? ¿O debe encontrar "vistas al mar" además de alguno de los términos restantes?
De forma predeterminada ("searchMode=any"), el motor de búsqueda asume la interpretación más amplia. Cualquiera de los campos debe coincidir, reflejando la semántica "o". El árbol de consulta inicial que se ilustra anteriormente, con las dos operaciones "should", muestra el valor predeterminado.
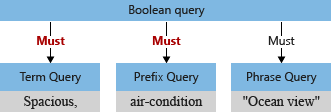
Supongamos que ahora establecemos "searchMode=all". En este caso, el espacio se interpreta como una operación lógica "AND". Los términos restantes deben estar presentes en el documento para considerarse una coincidencia. La consulta de ejemplo resultante se interpretaría de la siguiente manera:
+Spacious,+air-condition*+"Ocean view"
Un árbol de consulta modificado para esta consulta, donde un documento coincidente es la intersección de las tres subconsultas, tendría este aspecto:
Nota
Elegir "searchMode=any" en "searchMode=all" es una decisión mejor tomada mediante la ejecución de consultas representativas. Los usuarios que suelen incluir operadores (algo común cuando se busca en almacenes de documentos) pueden encontrar resultados más intuitivos si "searchMode=all" informa de construcciones de consultas booleanas. Para obtener más información sobre la interacción entre "searchMode" y los operadores, vea Sintaxis de consulta simple.
Fase 2: Análisis léxico
Los analizadores léxicos procesan consultas de términos y consultas de frases después de estructurar el árbol de consultas. Un analizador acepta las entradas de texto que le proporciona el analizador, procesa el texto y, a continuación, devuelve los términos tokenizados que se van a incorporar en el árbol de consulta.
La forma más común de análisis léxico es el análisis lingüístico, que transforma los términos de consulta en función de las reglas específicas de un lenguaje determinado. Esto implica:
- Reducir un término de consulta a la forma raíz de una palabra.
- Eliminar palabras no esenciales (palabras vacías, como "the" o "and" en inglés).
- Dividir una palabra compuesta en partes de componente.
- Uso de minúsculas en una palabra con mayúsculas.
Todas estas operaciones tienden a borrar las diferencias entre la entrada de texto proporcionada por el usuario y los términos almacenados en el índice. Estas operaciones van más allá del procesamiento de texto y requieren conocimientos detallados del propio lenguaje. Para agregar esta capa de reconocimiento lingüístico, Búsqueda de Azure AI admite una larga lista de analizadores language tanto de Lucene como de Microsoft.
Nota
En función de su escenario, los requisitos de análisis pueden variar de mínimo a elaborado. Puede controlar la complejidad del análisis léxico seleccionando uno de los analizadores predefinidos o creando su propio analizador custom analyzer. Los analizadores tienen como ámbito campos que se pueden buscar y se especifican como parte de una definición de campo. Esto le permite variar el análisis léxico por campo. Si no se especifica, se usa el analizador de Lucene estándar .
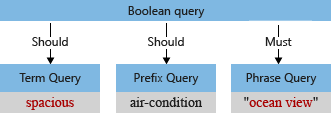
En nuestro ejemplo, antes del análisis, el árbol de consulta inicial tiene el término "Espacioso", con una "S" mayúscula y una coma que el analizador de consultas interpreta como parte del término de consulta (una coma no se considera un operador de lenguaje de consulta).
Cuando el analizador predeterminado procesa el término, convertirá en minúsculas "vista del océano" y "espacioso" y eliminará el carácter de coma. El árbol de consulta modificado tiene este aspecto:
Pruebas de comportamientos del analizador
El comportamiento de un analizador se puede probar mediante analyze API. Proporcione el texto que desea analizar para ver los términos que genera el analizador especificado. Por ejemplo, para ver cómo el analizador estándar procesaría el texto "air-condition", puede emitir la siguiente solicitud:
{
    "text": "air-condition",
    "analyzer": "standard"
}
El analizador estándar divide el texto de entrada en los siguientes dos tokens, anotándolos con atributos como desplazamientos de inicio y final (utilizados para resultados destacados), así como su posición (que se usa para la coincidencia de frase):
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
Excepciones al análisis léxico
El análisis léxico solo se aplica a los tipos de consulta que requieren términos completos, ya sea una consulta de términos o una consulta de frase. No se aplica a los tipos de consulta con términos incompletos (consulta de prefijo, consulta comodín y consulta regex) o a una consulta aproximada. Esos tipos de consulta, incluida la consulta de prefijo con el término air-condition* en nuestro ejemplo, se agregan directamente al árbol de consulta, pasando la fase de análisis. La única transformación realizada en los términos de consulta de esos tipos es el establecimiento de minúsculas.
Fase 3: Recuperación de documentos
La recuperación de documentos hace referencia a buscar documentos con términos coincidentes en el índice. Esta fase se entiende mejor a través de un ejemplo. Comencemos con un índice de hoteles que tiene el siguiente esquema simple:
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
Supongamos además que este índice contiene los cuatro documentos siguientes:
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
Cómo se indexan los términos
Para comprender la recuperación, ayuda a conocer algunos aspectos básicos sobre la indexación. La unidad de almacenamiento es un índice invertido, uno para cada campo que se puede buscar. Dentro de un índice invertido hay una lista ordenada de todos los términos de todos los documentos. Cada término se asigna a la lista de documentos en los que se produce, como se muestra en el ejemplo siguiente.
Para generar los términos en un índice invertido, el motor de búsqueda realiza un análisis léxico sobre el contenido de los documentos, de forma similar a lo que sucede durante el procesamiento de consultas:
- Las entradas de texto pasan al analizador, en minúsculas, en minúsculas, con una puntuación fragmentada y así sucesivamente, dependiendo de la configuración del analizador.
- Los tokens son la salida del análisis léxico.
- Los términos se agregan al índice.
Es habitual, pero no necesario, usar los mismos analizadores para las operaciones de búsqueda e indexación para que los términos de consulta sean más parecidos a los términos dentro del índice.
Nota
Búsqueda de Azure AI permite especificar diferentes analizadores para la indexación y búsqueda a través de parámetros de campo adicionales analyzer propiedad se usa para la indexación y la búsqueda.
Índice invertido para documentos de ejemplo
Volviendo al ejemplo, para el campo de título , el índice invertido tiene este aspecto:
| Término | Lista de documentos |
|---|---|
| atman | 1 |
| playa | 2 |
| hotel | 1, 3 |
| océano | 4 |
| playa | 3 |
| resort | 2 |
| retiro | 4 |
En el campo de título, solo el hotel aparece en dos documentos: 1 y 3.
Para el campo de descripción , el índice tiene el siguiente aspecto:
| Término | Lista de documentos |
|---|---|
| aire | 3 |
| y | 4 |
| playa | 1 |
| vacacional | 3 |
| cómodo | 3 |
| distancia | 1 |
| isla | 2 |
| kauaʻi | 2 |
| ubicado | 2 |
| norte | 2 |
| océano | 1, 2, 3 |
| de | 2 |
| activado | 2 |
| silencioso | 4 |
| habitaciones | 1, 3 |
| aislado | 4 |
| costa | 2 |
| espacioso | 1 |
| el | 1, 2 |
| to | 1 |
| ver | 1, 2, 3 |
| caminar | 1 |
| con | 3 |
Coincidencia de términos de consulta con términos indexados
Dados los índices invertidos anteriores, vamos a volver a la consulta de ejemplo y ver cómo se encuentran los documentos coincidentes para nuestra consulta de ejemplo. Recuerde que el árbol de consulta final tiene este aspecto:
Durante la ejecución de la consulta, las consultas individuales se ejecutan en los campos que se pueden buscar de forma independiente.
TermQuery, "espacioso", coincide con el documento 1 (Hotel Atman).
PrefixQuery, "air-condition*", no coincide con ningún documento.
Este comportamiento a veces confunde a los desarrolladores. Aunque el término "aire acondicionado" aparece en el documento, el analizador predeterminado lo divide en dos términos. Recuerde que las consultas de prefijo, que contienen términos parciales, no se analizan. Por lo tanto, los términos con el prefijo "air-condition" se buscan en el índice invertido y no se encuentran.
PhraseQuery, "ocean view", busca los términos "ocean" y "view" y comprueba la proximidad de términos en el documento original. Los documentos 1, 2 y 3 coinciden con esta consulta en el campo de descripción. Observe que el documento 4 tiene el término "océano" en el título, pero no se considera una coincidencia, ya que estamos buscando la frase "vista del océano" en lugar de palabras individuales.
Nota
Una consulta de búsqueda se ejecuta de forma independiente en todos los campos que se pueden buscar en el índice Búsqueda de Azure AI, a menos que limite los campos establecidos con el parámetro searchFields, como se muestra en la solicitud de búsqueda de ejemplo. Se devuelven documentos que coinciden con cualquiera de los campos seleccionados.
En su conjunto, para la consulta en cuestión, los documentos que coinciden son 1, 2 y 3.
Fase 4: Puntuación
A cada documento de un conjunto de resultados de búsqueda se le asigna una puntuación de relevancia. La función de la puntuación de relevancia es clasificar los documentos más altos que mejor respondan a una pregunta del usuario, tal como se expresa en la consulta de búsqueda. La puntuación se calcula en función de las propiedades estadísticas de los términos que coinciden. En el núcleo de la fórmula de puntuación se encuentra la frecuencia del término – frecuencia inversa del documento (TF/IDF). En las consultas que contienen términos poco frecuentes y comunes, TF/IDF promueve los resultados que contienen el término poco frecuente. Por ejemplo, en un índice hipotético con todos los artículos de Wikipedia, de los documentos que coinciden con la consulta the president, los documentos que coinciden con president se consideran más relevantes que los documentos que coinciden con el.
Ejemplo de puntuación
Recuerde los tres documentos que coinciden con nuestra consulta de ejemplo:
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
El documento 1 coincide mejor con la consulta porque tanto el término espacioso como la frase requerida vista del océano aparecen en el campo de descripción. Los dos documentos siguientes coinciden solo con la frase "vista al océano". Es posible que se sorprenda de que las puntuaciones de relevancia de los documentos 2 y 3 son diferentes, aunque coincidan con la consulta de la misma manera. Esto se debe a que la fórmula de puntuación tiene más componentes que solo TF/IDF. En este caso, al documento 3 se le asignó una puntuación ligeramente mayor porque su descripción es más corta. Obtenga información sobre la fórmula de puntuación práctica de Lucene para comprender cómo la longitud del campo y otros factores pueden influir en la puntuación de relevancia.
Algunos tipos de consulta (comodín, prefijo y regex) siempre aportan una puntuación constante a la puntuación total del documento. Esto permite que las coincidencias encontradas a través de la expansión de consultas se incluyan en los resultados sin afectar a la clasificación.
Un ejemplo ilustra por qué esto importa. Las búsquedas con caracteres comodín, incluidas las búsquedas de prefijo, son ambiguas por definición porque la entrada es una cadena parcial con posibles coincidencias en un número muy grande de términos dispares. Considere una entrada de "tour*", con coincidencias encontradas en "tours", "tourettes" y "tourmaline". Dada la naturaleza de estos resultados, no hay manera de deducir razonablemente qué términos son más valiosos que otros. Por este motivo, se omiten las frecuencias de términos al puntuar los resultados en consultas de tipos comodín, prefijo y regex. En una solicitud de búsqueda de varias partes que incluye términos parciales y completos, los resultados de la entrada parcial se incorporan con una puntuación constante para evitar sesgos hacia coincidencias potencialmente inesperadas.
Optimización de relevancia
Hay dos maneras de ajustar las puntuaciones de relevancia en Búsqueda de Azure AI:
Los perfiles de puntuación favorecen a los documentos de la lista de clasificación basados en un conjunto de reglas. En nuestro ejemplo, podríamos considerar los documentos que coinciden con el campo de título más relevantes que los documentos que coinciden en el campo de descripción. Además, si nuestro índice tuviera un campo de precios para cada hotel, podríamos promover documentos con precios más bajos. Obtenga más información sobre cómo agregar perfiles de puntuación a un índice de búsqueda.
El aumento de términos (disponible solo en la sintaxis de consulta completa de Lucene) proporciona un operador
^de potenciación que se puede aplicar a cualquier parte del árbol de consulta. En nuestro ejemplo, en lugar de buscar en el prefijo air-condition*, puede buscar el término exacto post-vacacional o el prefijo, pero los documentos que coinciden con el término exacto se clasifican en una posición superior aplicando la priorización a la consulta de término: post-vacacional^2||post-vacacional*. Más información sobre la priorización de términos de una consulta.
Puntuación en un índice distribuido
Todos los índices de Búsqueda de Azure AI se dividen automáticamente en varias particiones, lo que nos permite distribuir rápidamente el índice entre varios nodos durante el escalado o reducción vertical del servicio. Cuando se emite una solicitud de búsqueda, se emite de forma independiente en cada partición. Los resultados de cada partición se fusionan y se ordenan según la puntuación (si no se define ninguna otra ordenación). Es importante saber que la función de puntuación mide la frecuencia del término de consulta con la frecuencia inversa del documento en todos los documentos dentro de la partición, no en todas las particiones.
Esto significa que una puntuación de relevancia podría ser diferente para documentos idénticos si residen en particiones diferentes. Afortunadamente, estas diferencias tienden a desaparecer a medida que crece el número de documentos del índice debido a una distribución de términos más uniforme. No es posible suponer en qué partición se colocará ningún documento determinado. Sin embargo, suponiendo que una clave de documento no cambie, siempre se asigna a la misma partición.
En general, la puntuación del documento no es el mejor atributo para ordenar documentos si es importante la estabilidad del orden. Por ejemplo, dados dos documentos con una puntuación idéntica, no hay ninguna garantía de que uno de ellos aparezca primero en ejecuciones posteriores de la misma consulta. La puntuación del documento solo debe dar una idea general de la relevancia del documento en relación con otros documentos del conjunto de resultados.
Conclusión
El éxito de los motores de búsqueda comercial ha generado expectativas para la búsqueda de texto completo a través de datos privados. Para casi cualquier tipo de experiencia de búsqueda, ahora esperamos que el motor comprenda nuestra intención, incluso cuando los términos están mal escritos o incompletos. Incluso podríamos esperar coincidencias basadas en términos o sinónimos casi equivalentes que nunca especificómos.
Desde el punto de vista técnico, la búsqueda de texto completo es muy compleja, lo que requiere un análisis lingüístico sofisticado y un enfoque sistemático para procesar de maneras que destilan, expanden y transforman los términos de consulta para ofrecer un resultado relevante. Dadas las complejidades inherentes, hay muchos factores que pueden afectar al resultado de una consulta. Por esta razón, invertir el tiempo para comprender la mecánica de la búsqueda de texto completo ofrece ventajas tangibles al intentar trabajar con resultados inesperados.
En este artículo se ha explorado la búsqueda de texto completo en el contexto de Búsqueda de Azure AI. Esperamos que le proporcione suficiente experiencia para reconocer posibles causas y resoluciones para abordar problemas comunes de consulta.
Pasos siguientes
Compile el índice de ejemplo, pruebe consultas diferentes y revise los resultados. Para obtener instrucciones, consulte Build y consulte un índice en el portal de Azure.
Pruebe otras sintaxis de consulta de la sección de ejemplo Search Documents o de la Sintaxis de consulta simple en el Explorador de búsqueda del portal de Azure.
Revise los perfiles de puntuación si desea ajustar la clasificación en la aplicación de búsqueda.
Configure analizadores personalizados para un procesamiento mínimo o un procesamiento especializado en campos específicos.