Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Nota:
Búsqueda de Azure AI está disponible a través del portal de Azure, las API REST y los SDK de Azure. También respalda Foundry IQ, la capa de conocimiento administrada que transforma el contenido empresarial en bases de conocimiento reutilizables y compatibles con permisos para agentes en el portal de Microsoft Foundry.
De vez en cuando, los indexadores se encuentran con problemas que no generan errores o que ocurren en otros servicios de Azure, como durante la autenticación o al conectarse. Este artículo se centra en cómo solucionar los problemas del indexador cuando no hay mensajes que sirvan de guía para hacerlo. También muestra soluciones a errores que proceden de recursos que no son de búsqueda usados durante la indexación.
Nota:
Si desea investigar un error de Búsqueda de Azure AI, consulte Solución de errores y advertencias comunes en el indexador en su lugar.
procedimientos recomendados
Estos son algunos procedimientos recomendados y recomendaciones al trabajar con indexadores:
Los indexadores están diseñados para ejecutarse según una programación
- Para una indexación confiable, configure los indexadores para que se ejecuten según una programación normal. Las ejecuciones programadas recogen automáticamente los documentos que faltan en las ejecuciones anteriores debido a errores transitorios, interrupciones de red o problemas de servicio temporales. Este enfoque ayuda a mantener la coherencia de los datos y minimiza la necesidad de intervención manual.
- Para orígenes de datos grandes, la enumeración inicial y la indexación pueden tardar horas o incluso días. Ejecutar el indexador según una programación permite que el progreso continúe y los errores se reintenten automáticamente. Evite confiar únicamente en ejecuciones manuales o a petición del indexador, ya que estas opciones no proporcionan la misma confiabilidad ni recuperación de errores transitorios.
Los indexadores proporcionan una indexación de mejor esfuerzo a lo largo del tiempo
- Los indexadores integrados procesan documentos sin errores permanentes y vuelven a intentarlo en ejecuciones programadas. Ofrecen una forma cómoda de código bajo o sin código para indexar datos en escenarios comunes, lo que permite un desarrollo más rápido y un mantenimiento más sencillo. Cuando un indexador ejecuta un conjunto de aptitudes, cada ejecución tiene un límite de tiempo de ejecución fijo. Los indexadores que se ejecutan en el entorno de ejecución multiinquilino tienen un tiempo de ejecución máximo de dos horas. Este límite es el caso más común, que se usa cuando los conjuntos de aptitudes no requieren vínculos privados compartidos. Los indexadores configurados para usar vínculos privados compartidos se ejecutan en un entorno de ejecución privado con un máximo de 24 horas. Para obtener la tabla completa, consulte Límites del indexador. Si el procesamiento del conjunto de aptitudes por documento impide que el indexador finalice antes del límite de tiempo, se detiene y deja los documentos restantes sin procesar. No se garantiza el procesamiento completo cuando el volumen del documento, el tamaño de archivo, la complejidad del conjunto de aptitudes o el entorno de ejecución impiden que el indexador finalice dentro de su tiempo de ejecución máximo. Particionar el origen de datos puede reducir este riesgo, pero no lo elimina, especialmente si más adelante añade grandes volúmenes de archivos a una partición. Se espera este comportamiento. Para obtener estrategias para administrar grandes conjuntos de datos y admitir la recuperación incremental, consulte Indexación de grandes conjuntos de datos y indexadores de programación. Si tu solución requiere un control estricto sobre cuándo el indexador procesa los documentos, utiliza la alternativa de la API Push que se describe en este artículo.
- Si su solución requiere un control estricto sobre los plazos de indexación, utilice las API de inserción, como la API REST de indexación de documentos o el método IndexDocuments (SDK de Azure para .NET). Estas opciones le proporcionan control total de la canalización de indexación.
- Los indizadores pueden quedarse ocasionalmente fuera del horario. Aunque esta condición es poco común y existen mecanismos de recuperación automática, la recuperación puede tardar tiempo. Se espera este comportamiento.
Solución de problemas de conexiones a recursos restringidos
En el caso de los orígenes de datos en la seguridad de red de Azure, los indexadores tienen limitaciones en cuanto a la realización de la conexión. Actualmente, los indizadores pueden acceder a orígenes de datos restringidos detrás de un firewall de IP, o bien en una red virtual a través de un punto de conexión privado mediante un vínculo privado compartido.
Error al conectarse a un recurso de Microsoft Foundry en una conexión privada
Si recibe el código de error 403 con el mensaje siguiente, es posible que tenga un problema con la forma en que se especifica el punto de conexión del recurso en un conjunto de aptitudes:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
Este error se produce si configuró un vínculo privado compartido para las conexiones a un recurso de Azure Foundry y el punto de conexión falta un subdominio personalizado. Un subdominio personalizado es la primera parte del punto de conexión (por ejemplo, http://my-custom-subdomain.services.ai.azure.com). Es posible que falte un dominio personalizado si creó el recurso en el portal de Foundry en lugar de Azure Portal.
Si el recurso Foundry no está en la misma región que Búsqueda de Azure AI, use una conexión sin clave para asociar el recurso.
Error al usar un vínculo privado compartido
Si recibe el código de error 403 con el mensaje siguiente, es posible que el indexador se conecte a través del punto de conexión público en lugar de un vínculo privado compartido aprobado:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
Este error puede producirse cuando el indexador no está configurado para usar el entorno de ejecución privado. Confirme que el enlace privado compartido esté aprobado, establezca la propiedad del indexador executionEnvironment en private y compruebe que la conexión usa el extremo de recurso correcto y el identificador de grupo.
Reglas de firewall
Azure Storage, Azure Cosmos DB y Azure SQL proporcionan un firewall configurable. No aparece ningún mensaje de error específico cuando el firewall está habilitado. Por lo general, los errores de firewall son genéricos. Estos son algunos de los errores comunes:
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
Para permitir que los indexadores accedan a estos recursos, use una de las siguientes opciones:
Configure tanto una regla de entrada para la dirección IP del servicio de búsqueda como el intervalo de direcciones IP de la
AzureCognitiveSearchetiqueta de servicio. Para más información sobre cómo configurar restricciones de intervalo de direcciones IP para cada tipo de origen de datos, consulte los vínculos siguientes:Como último recurso o a modo de medida temporal, deshabilite el firewall, lo que permite el acceso desde todas las redes.
Limitación: las restricciones del intervalo de direcciones IP solo funcionan si el servicio de búsqueda y la cuenta de almacenamiento están en regiones diferentes.
Además de la recuperación de datos, los indizadores también envían solicitudes salientes mediante conjuntos de aptitudes y aptitudes personalizadas. En el caso de las aptitudes personalizadas basadas en una función de Azure, tenga en cuenta que las funciones de Azure también tienen restricciones de direcciones IP. La lista de direcciones IP que se van a permitir mediante la ejecución de aptitudes personalizadas incluye la dirección IP del servicio de búsqueda y el intervalo de direcciones IP de la etiqueta de servicio AzureCognitiveSearch.
Reglas del grupo de seguridad de red (NSG)
Cuando un indexador accede a los datos de una instancia administrada de SQL o cuando se usa una máquina virtual de Azure como identificador URI del servicio web para una aptitud personalizada, el grupo de seguridad de red determina si se permiten solicitudes.
En el caso de los recursos externos que residen en una red virtual, configure las reglas de NSG entrantes para la etiqueta de servicio AzureCognitiveSearch.
Para obtener más información sobre cómo conectarse a una máquina virtual, vea Configuración de una conexión a SQL Server en una máquina virtual de Azure.
Errores de red
Normalmente, los errores de red son genéricos. Estos son algunos de los errores comunes:
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
Cuando reciba cualquiera de estos errores:
- Asegúrese de que puede acceder al origen intentando conectarse directamente a él y no a través del servicio de búsqueda.
- Compruebe el recurso en el portal de Azure para ver si hay errores o interrupciones actuales.
- Compruebe si hay interrupciones de red en Azure Status.
- Compruebe que usa un DNS público para la resolución de nombres y no un Azure DNS privado.
Indexación de Azure SQL Database sin servidor (código de error 40613)
Si la base de datos SQL está en un nivel de proceso sin servidor, asegúrese de que la base de datos se esté ejecutando (y no en pausa) cuando el indexador se conecta a ella.
Si la base de datos está en pausa, el primer inicio de sesión del servicio de búsqueda reanuda automáticamente la base de datos, pero, en su lugar, devuelve un error que indica que la base de datos no está disponible, lo que proporciona el código de error 40613. Cuando se haya ejecutado la base de datos, vuelva a intentar el inicio de sesión para establecer la conectividad.
Directivas de acceso condicional de Microsoft Entra
Al crear un indexador de SharePoint, debe iniciar sesión en la aplicación de Microsoft Entra después de proporcionar un código de dispositivo. Si recibe un mensaje que indica "Your sign-in was successful but your admin requires the device requesting access to be managed", es probable que una directiva de acceso condicional bloquee el indexador desde la biblioteca de documentos de SharePoint.
Para actualizar la directiva y permitir el acceso del indizador a la biblioteca de documentos:
Abra Azure Portal y busque Acceso condicional de Microsoft Entra.
En el menú izquierdo, seleccione Directivas. Si no tiene acceso para ver esta página, debe buscar a alguien que tenga acceso u obtener acceso.
Determine qué directiva impide que el indexador de SharePoint acceda a la biblioteca de documentos. La directiva que podría bloquear el indexador incluye la cuenta de usuario que usó para autenticarse durante el paso de creación del indexador en la sección Usuarios y grupos . Es posible que la directiva también tenga condiciones que:
- Restrinjan las plataformas Windows.
- Restrinjan aplicaciones móviles y equipos cliente de escritorio.
- Establezca Estado del dispositivo en Sí.
Una vez que confirme qué directiva está bloqueando el indexador, realice una exención para el indexador. Para empezar, recupere la dirección IP del servicio de búsqueda.
En primer lugar, obtenga el nombre de dominio completo (FQDN) del servicio de búsqueda. El FQDN es similar a
<your-search-service-name>.search.windows.net. Puede encontrarlo en Azure Portal.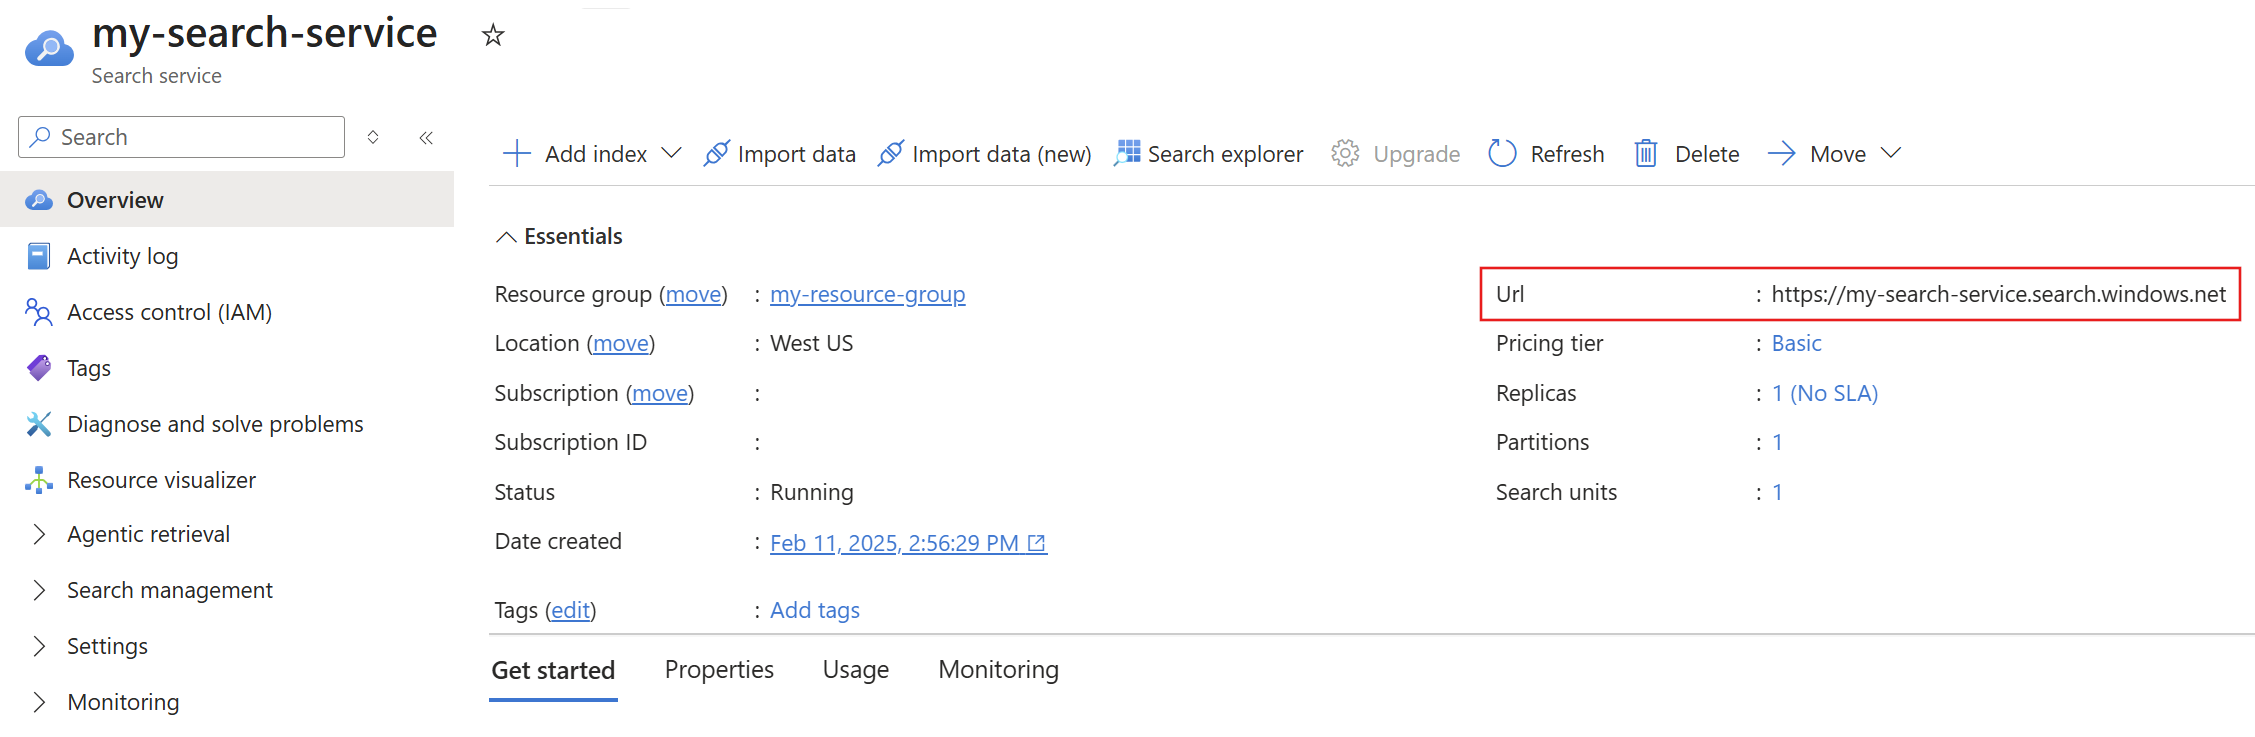
Una vez que tenga el nombre, obtenga la dirección IP del servicio de búsqueda, para lo que debe realizar una operación
nslookup(oping) del nombre de dominio completo. En el ejemplo siguiente, agregará150.0.0.1a una regla de entrada en el firewall de Azure Storage. La configuración del firewall puede tardar hasta 15 minutos en actualizarse para que el indexador del servicio de búsqueda acceda a la cuenta de Azure Storage.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netObtenga los intervalos de direcciones IP del entorno de ejecución del indexador de su región.
Se usan direcciones IP adicionales para las solicitudes que se originan en el entorno de ejecución multiinquilino del indizador. Puede obtener este intervalo de direcciones IP de la etiqueta de servicio.
Puede obtener los intervalos de direcciones IP de la etiqueta de
AzureCognitiveSearchservicio a través de la API de detección o el archivo JSON descargable.En este ejercicio, suponiendo que el servicio de búsqueda es la nube pública Azure, descargue el archivo JSON público Azure.
En el archivo JSON, suponiendo que el servicio de búsqueda se encuentra en Centro-oeste de EE. UU., se muestra la lista de direcciones IP del entorno de ejecución de indizador multiinquilino.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
Vuelva a la página Acceso condicional de Azure Portal, seleccione Ubicaciones con nombre en el menú de la izquierda y después + Ubicación de los intervalos de direcciones IP. Asigne un nombre a la nueva ubicación con nombre y agregue los intervalos de direcciones IP del servicio de búsqueda y los entornos de ejecución del indexador que recopiló en los dos últimos pasos. 1
- En el caso de la dirección IP del servicio de búsqueda, es posible que tenga que agregar "/32" al final de la dirección IP, ya que solo acepta intervalos IP válidos.
- Recuerde que en el caso de los intervalos IP del entorno de ejecución del indexador, solo tiene que agregar los intervalos IP de la región en la que se encuentra el servicio de búsqueda.
Excluya la nueva ubicación con nombre de la directiva:
- En el menú izquierdo, seleccione Directivas.
- Seleccione la directiva que bloquea al indexador.
- Seleccione Condiciones.
- Seleccione Ubicaciones.
- Seleccione Excluir y agregue la nueva ubicación con nombre.
- Guarde los cambios.
Espere unos minutos a que la directiva se actualice y aplique las nuevas reglas de directiva.
Intente volver a crear el indexador:
- Envíe una solicitud de actualización del objeto de origen de datos que creó.
- Vuelva a enviar la solicitud de creación del indexador. Use el nuevo código para iniciar sesión y, después, envíe otra solicitud de creación del indizador.
Indexación de tipos de documentos no admitidos
Si indexa contenido de Azure Blob Storage y el contenedor incluye blobs de un tipo de contenido no admitido, el indexador omite ese documento. En otros casos, es posible que surjan problemas con documentos individuales.
En esta situación, puede establecer opciones de configuración para permitir que el procesamiento del indexador continúe si hay problemas con documentos individuales.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Documentos faltantes
Los indexadores extraen documentos o filas de un origen de datos externo y crean documentos de búsqueda, que indexa el servicio de búsqueda. En ocasiones, un documento que existe en el origen de datos no aparece en un índice de búsqueda. Este resultado inesperado puede producirse por los motivos siguientes:
- Ha actualizado el documento después de que se ejecutó el indexador. Si el indizador sigue una programación, a la larga se vuelve a ejecutar y recoge el documento.
- El indizador ha agotado el tiempo de espera antes de que se pudiera ingerir el documento. Hay límites de tiempo de procesamiento máximos después de los cuales no se procesa ningún documento. Puede comprobar el estado del indexador en Azure Portal o llamando a Obtener estado del indexador (API de REST).
- Las asignaciones de campo o el enriquecimiento con IA cambiaron el documento y la forma en que se representa en el índice de búsqueda es diferente de lo esperado.
- Los valores de seguimiento de cambios son erróneos o faltan requisitos previos. Si el valor del límite máximo es una fecha establecida en el futuro, el indexador omite cualquier documento que tenga una fecha anterior. Puede determinar el estado del seguimiento de cambios del indexador mediante los campos
initialTrackingStateyfinalTrackingStateen el estado del indexador. Los indizadores de Azure SQL y MySQL deben tener un índice en la columna de límite máximo de la tabla de origen, o las consultas que usa el indizador hayan podrían agotar el tiempo de espera.
Sugerencia
Si faltan documentos, compruebe el consulta está usando para asegurarse de que no está excluyendo el documento en cuestión. Para consultar un documento específico, use la API REST de búsqueda de documentos.
Falta de contenido de Blob Storage
El indizador de blobs busca y extrae texto de los blobs de un contenedor. Algunos problemas con la extracción de texto son los siguientes:
El documento solo contiene imágenes escaneadas. Los blobs de PDF que tienen contenido no textual, como imágenes escaneadas (JPG), no generan resultados en una canalización de indexación de blobs estándar. Si tiene contenido de imagen con elementos de texto, puede usar OCR o el análisis de imágenes para buscar y extraer el texto.
El indizador de blobs está configurado para indexar solo metadatos. Para extraer contenido, debe configurar el indexador de blobs para extraer tanto contenido como metadatos:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Falta de contenido de Azure Cosmos DB
Búsqueda de Azure AI tiene una dependencia implícita del indexado de Azure Cosmos DB. Si desactiva el indexado automático en Azure Cosmos DB, Búsqueda de Azure AI devuelve un estado correcto, pero no puede indexar el contenido del contenedor. Para instrucciones sobre cómo establecer y activar el indexado, consulte Administración automática en Azure Cosmos DB.
Discrepancia en el número de documentos entre el origen de datos y el índice
Un indizador puede mostrar un número de documentos diferente al del origen de datos, al del propio índice o al del código. Estos son algunos de los motivos por los que se puede producir este comportamiento:
- El índice puede retardar en mostrar el recuento real de documentos, especialmente en Azure Portal.
- El indexador tiene una directiva de documento eliminados. El indizador cuenta los documentos que se han eliminado si se indexan antes de eliminarlos.
- Si la columna id. del origen de datos no es única. Esta condición se aplica a los orígenes de datos que tienen el concepto de columnas, como Azure Cosmos DB.
- Si la definición del origen de datos tiene una consulta diferente a la que usa para calcular el número de registros. Por ejemplo, en la base de datos, está consultando el recuento de registros de la base de datos, mientras que en la consulta de definición del origen de datos, podría seleccionar solo un subconjunto de registros para indexar.
- Los recuentos se comprueban a intervalos diferentes para cada componente de la canalización: origen de datos, indexador e índice.
- El origen de datos tiene un archivo que está asignado a muchos documentos. Esta condición puede producirse cuando se realiza la indexación de los blob y "parsingMode" se establece en
jsonArrayyjsonLines.
Documentos procesados varias veces
Los indexadores usan una estrategia de almacenamiento en búfer conservadora para asegurarse de que todos los documentos nuevos y modificados del origen de datos se recogen durante la indexación. En determinadas situaciones, estos búferes se pueden superponer, lo que hace que un indexador indexe un documento dos o más veces. Como resultado, el recuento de documentos procesados es mayor que el número real de documentos del origen de datos. Este comportamiento no afecta a los datos almacenados en el índice, como la duplicación de documentos, solo que puede tardar más tiempo en alcanzar la coherencia final. Esto es especialmente frecuente si se cumple cualquiera de los siguientes criterios:
- Las solicitudes del indexador a petición se emiten en sucesión rápida.
- La topología del origen de datos incluye varias réplicas y particiones, como la topología descrita en Niveles de coherencia en Azure Cosmos DB.
- El origen de datos es una base de datos de Azure SQL y la columna elegida como "high water mark" es de tipo
datetime2.
Los indizadores no están diseñados para que se invoquen varias veces en una sucesión rápida. Si necesita actualizaciones rápidamente, el enfoque admitido es insertar actualizaciones en el índice mientras actualiza simultáneamente el origen de datos. Para el procesamiento bajo demanda, espacie sus solicitudes en intervalos de cinco minutos o más y ejecute el indexador según una programación definida.
Ejemplo de procesamiento de documentos duplicados con búfer de 30 segundos
En la escala de tiempo siguiente se explican las condiciones en las que se procesa un documento dos veces. Toma nota de cada acción y contraacción. En la escala de tiempo siguiente se muestra el problema:
| Escala de tiempo (hh:mm:ss) | Evento | Límite superior del indexador | Comentario |
|---|---|---|---|
| 00:01:00 | Escriba doc1 en el origen de datos con coherencia final |
null |
La marca de tiempo del documento es 00:01:00. |
| 00:01:05 | Escriba doc2 en el origen de datos con coherencia final |
null |
La marca de tiempo del documento es 00:01:05. |
| 00:01:10 | Se inicia el indexador | null |
|
| 00:01:11 | El indexador consulta todos los cambios antes de las 00:01:10. La réplica que consulta el indexador solo detecta doc2 y solo se recupera doc2. |
null |
El indexador solicita todos los cambios antes de iniciar la marca de tiempo, pero recibe realmente un subconjunto. Este comportamiento necesita el período de búfer de retroceso. |
| 00:01:12 | El indexador procesa doc2 por primera vez |
null |
|
| 00:01:13 | Finaliza el indexador | 00:01:10 | El límite superior se actualiza a la marca de tiempo inicial de la ejecución actual del indexador. |
| 00:01:20 | Se inicia el indexador | 00:01:10 | |
| 00:01:21 | El indexador consulta todos los cambios entre las 00:00:40 y las 00:01:20. La réplica que consulta el indexador detecta doc1 y doc2, y recupera doc1 y doc2. |
00:01:10 | El indexador solicita todos los cambios entre la marca del límite superior actual menos el búfer de 30 segundos y la marca de tiempo inicial de la ejecución actual del indexador. |
| 00:01:22 | El indexador procesa doc1 por primera vez |
00:01:10 | |
| 00:01:23 | El indexador procesa doc2 por segunda vez |
00:01:10 | |
| 00:01:24 | Finaliza el indexador | 00:01:20 | El límite superior se actualiza a la marca de tiempo inicial de la ejecución actual del indexador. |
| 00:01:32 | Se inicia el indexador | 00:01:20 | |
| 00:01:33 | El indexador consulta todos los cambios entre las 00:00:50 y las 00:01:32, y recupera doc1 y doc2. |
00:01:20 | El indexador solicita todos los cambios entre la marca del límite superior actual menos el búfer de 30 segundos y la marca de tiempo inicial de la ejecución actual del indexador. |
| 00:01:34 | El indexador procesa doc1 por segunda vez |
00:01:20 | |
| 00:01:35 | El indexador procesa doc2 por tercera vez |
00:01:20 | |
| 00:01:36 | Finaliza el indexador | 00:01:32 | El límite superior se actualiza a la marca de tiempo inicial de la ejecución actual del indexador. |
| 00:01:40 | Se inicia el indexador | 00:01:32 | |
| 00:01:41 | El indexador consulta todos los cambios entre las 00:01:02 y las 00:01:40, y recupera doc2. |
00:01:32 | El indexador solicita todos los cambios entre la marca del límite superior actual menos el búfer de 30 segundos y la marca de tiempo inicial de la ejecución actual del indexador. |
| 00:01:42 | El indexador procesa doc2 por cuarta vez |
00:01:32 | |
| 00:01:43 | Finaliza el indexador | 00:01:40 | Observe que esta ejecución del indexador se inició más de 30 segundos después de la última escritura en el origen de datos y también procesó doc2. Este es el comportamiento esperado porque si se eliminan todas las ejecuciones del indexador anteriores a las 00:01:35, se convierte en la primera y única ejecución para procesar doc1 y doc2. |
En la práctica, este escenario solo se produce cuando se ejecutan manualmente indexadores a demanda con pocos minutos de diferencia entre sí, para determinados orígenes de datos. Puede dar lugar a números no coincidentes (como que el indexador procesó un total de 345 documentos según las estadísticas de ejecución del indexador, pero solo hay 340 documentos en el origen de datos y el índice) o una facturación potencialmente mayor si ejecuta las mismas aptitudes para el mismo documento varias veces. La recomendación preferida es ejecutar un indexador mediante una programación.
Indexación en paralelo
Cuando se ejecutan varios indexadores al mismo tiempo, algunos suelen entrar en una cola y esperar a que haya recursos disponibles antes de iniciarse. Varios factores determinan cuántos indexadores pueden ejecutarse simultáneamente. Si los indexadores no se vinculan a conjuntos de aptitudes, el número de réplicas y particiones en el servicio de búsqueda de IA determina cuántos indexadores se pueden ejecutar en paralelo.
Si asocia un indexador a un conjunto de aptitudes, se ejecuta dentro de los clústeres internos de AI Search. La complejidad del conjunto de aptitudes y si otros conjuntos de aptitudes se ejecutan al mismo tiempo determinan cuántos indexadores se pueden ejecutar simultáneamente. Los indexadores integrados extraen datos de forma confiable del origen, por lo que no se pierden datos si se ejecutan según una programación. Sin embargo, los procesos del indexador para la paralelización y el escalado horizontal necesitan algo de tiempo para completarse.
Indexación de documentos con etiquetas de confidencialidad
Si establece etiquetas de confidencialidad en documentos, es posible que no pueda indexarlas. Si obtiene errores, quite las etiquetas antes de indexar.