Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Hinweis
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
Foundry IQ (Azure KI-Suche) akzeptiert ein flaches Rowset als Eingabe für die Indizierungspipeline. Wenn Ihre Quelldaten aus verknüpften Tabellen in einer SQL Server relationalen Datenbank stammen, wird in diesem Artikel erläutert, wie Sie das Rowset erstellen und wie Sie eine Beziehung zwischen übergeordneten und untergeordneten Elementen in einem Foundry IQ-Index modellieren.
Zur Veranschaulichung verwenden wir eine hypothetische Hoteldatenbank, die auf Demodaten basiert. Angenommen, die Datenbank besteht aus einer Tabelle Hotels$ mit 50 Hotels und einer Tabelle Rooms$ mit insgesamt 750 Zimmern unterschiedlicher Typen, Preise und Ausstattungen. Zwischen den Tabellen besteht eine 1:n-Beziehung. In unserem Ansatz stellt eine Sicht die Abfrage bereit, die 50 Zeilen zurückgibt, eine Zeile pro Hotel, wobei zugeordnete Zimmerdetails in die einzelnen Zeilen eingebettet sind.
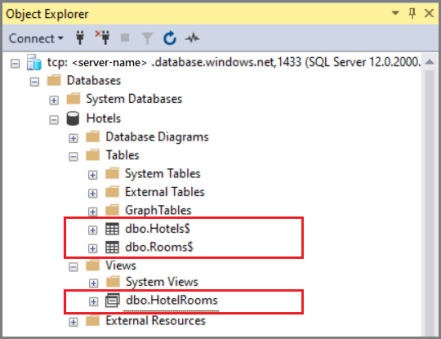
Das Problem denormalisierter Daten
Eine der Herausforderungen beim Arbeiten mit 1:n-Beziehungen besteht darin, dass standardabfragen, die auf verknüpften Tabellen basieren, denormalisierte Daten zurückgeben, was in einem Findry IQ-Szenario nicht gut funktioniert. Sehen Sie sich das folgende Beispiel an, das Hotels und Räume verknüpft.
SELECT * FROM Hotels$
INNER JOIN Rooms$
ON Rooms$.HotelID = Hotels$.HotelID
Als Ergebnis dieser Abfrage werden alle Hotel-Felder zurückgegeben, gefolgt von allen Room-Feldern, wobei sich grundlegende Hotelinformationen für jeden Room-Wert wiederholen.
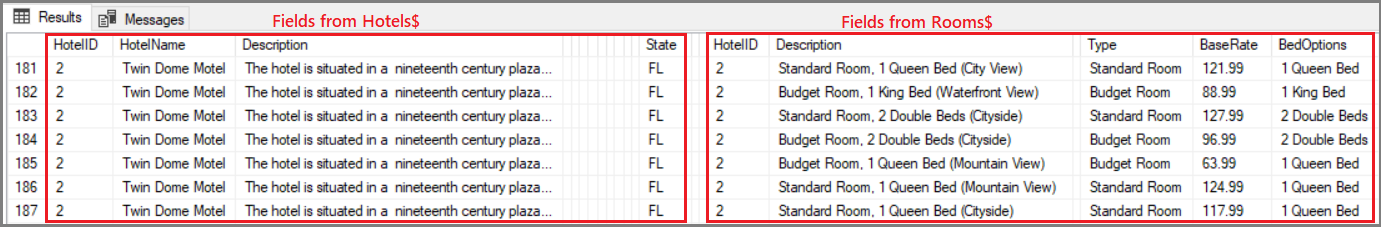
Diese Abfrage ist zwar oberflächlich erfolgreich (alle Daten werden in einem vereinfachten Rowset bereitgestellt), kann aber nicht die richtige Dokumentstruktur für die erwartete Sucherfahrung bereitstellen. Während der Indizierung erstellt Foundry IQ ein Suchdokument für jede aufgenommene Zeile. Wenn Ihre Suchergebnisse wie die oben aufgeführten Resultate aussähen, hätten Sie Duplikate wahrgenommen – allein für das Old Century Hotel sieben separate Dokumente. Eine Abfrage nach „Hotels in Florida“ würde sieben Ergebnisse nur für das Old Century Hotel zurückgeben, wodurch weitere relevante Hotels in den Suchergebnissen weiter nach unten rücken.
Um die erwartete Darstellung eines Dokuments pro Hotel zu erhalten, sollte ein Rowset mit der richtigen Granularität, jedoch mit umfassenden Informationen bereitgestellt werden. Die Vorgehensweise wird in diesem Artikel erläutert.
Definieren einer Abfrage, die eingebetteten JSON-Code zurückgibt
Um die erwartete Sucherfahrung bereitzustellen, sollte Ihr Datensatz aus einer Zeile für jedes Suchdokument in Foundry IQ bestehen. In unserem Beispiel möchten wir eine Zeile für jedes Hotel bereitstellen, aber die Benutzer sollen auch in der Lage sein, nach anderen zimmerbezogenen Feldern zu suchen, die für sie wichtig sind, wie z.B. Preis pro Nacht, Größe und Anzahl der Betten oder Strandblick – allen Informationen, die Teil der Zimmerdetails sind.
Die Lösung besteht darin, die Zimmerdetails als geschachtelten JSON-Code zu erfassen und die JSON-Struktur dann in ein Feld in einer Sicht einzufügen, wie im zweiten Schritt gezeigt.
Angenommen, Sie verfügen über zwei verknüpfte Tabellen,
Hotels$undRooms$, die Details über 50 Hotels und 750 Zimmer enthalten und über das Feld „HotelID“ verknüpft sind. Diese Tabellen enthalten einzeln 50 Hotels bzw. 750 zugehörige Zimmer.CREATE TABLE [dbo].[Hotels$]( [HotelID] [nchar](10) NOT NULL, [HotelName] [nvarchar](255) NULL, [Description] [nvarchar](max) NULL, [Description_fr] [nvarchar](max) NULL, [Category] [nvarchar](255) NULL, [Tags] [nvarchar](255) NULL, [ParkingIncluded] [float] NULL, [SmokingAllowed] [float] NULL, [LastRenovationDate] [smalldatetime] NULL, [Rating] [float] NULL, [StreetAddress] [nvarchar](255) NULL, [City] [nvarchar](255) NULL, [State] [nvarchar](255) NULL, [ZipCode] [nvarchar](255) NULL, [GeoCoordinates] [nvarchar](255) NULL ) ON [PRIMARY] TEXTIMAGE_ON [PRIMARY] GO CREATE TABLE [dbo].[Rooms$]( [HotelID] [nchar](10) NULL, [Description] [nvarchar](255) NULL, [Description_fr] [nvarchar](255) NULL, [Type] [nvarchar](255) NULL, [BaseRate] [float] NULL, [BedOptions] [nvarchar](255) NULL, [SleepsCount] [float] NULL, [SmokingAllowed] [float] NULL, [Tags] [nvarchar](255) NULL ) ON [PRIMARY] GOErstellen Sie eine Sicht die alle Felder in der übergeordneten Tabelle (
SELECT * from dbo.Hotels$) enthält, und fügen Sie ein neues Rooms-Feld hinzu, das die Ausgabe einer geschachtelten Abfrage enthält. Eine FOR JSON AUTO-Klausel fürSELECT * from dbo.Rooms$strukturiert die Ausgabe als JSON.CREATE VIEW [dbo].[HotelRooms] AS SELECT *, (SELECT * FROM dbo.Rooms$ WHERE dbo.Rooms$.HotelID = dbo.Hotels$.HotelID FOR JSON AUTO) AS Rooms FROM dbo.Hotels$ GODer folgende Screenshot zeigt die resultierende Sicht mit dem nvarchar-Feld Rooms unten. Das Feld Rooms ist nur in der Sicht „HotelRooms“ vorhanden.
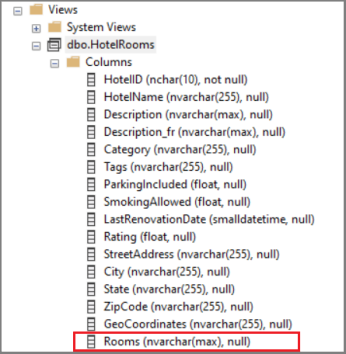
Führen Sie
SELECT * FROM dbo.HotelRoomsaus, um das Rowset abzurufen. Diese Abfrage gibt 50 Zeilen, eine pro Hotel, mit zugeordneten Zimmerinformationen als JSON-Sammlung zurück.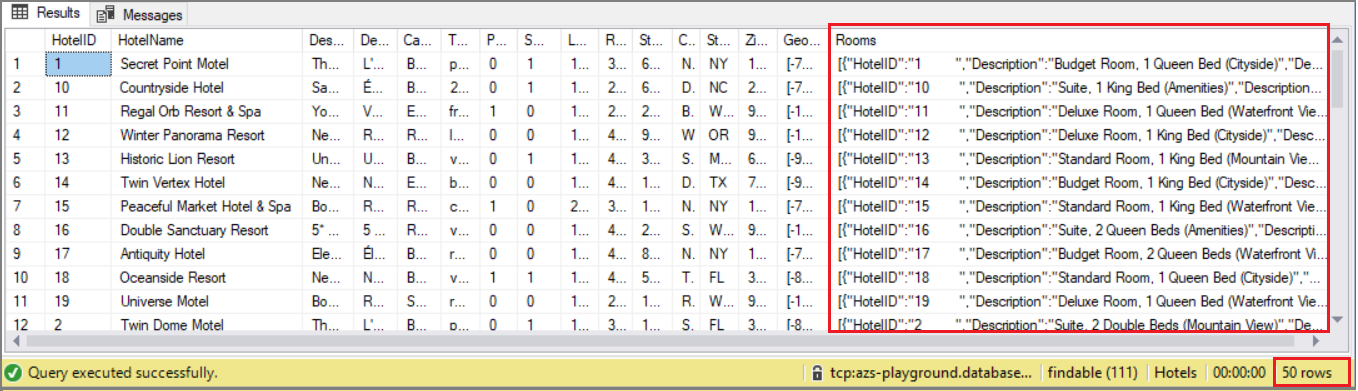
Dieses Rowset ist jetzt bereit für den Import in Foundry IQ.
Hinweis
Bei dieser Vorgehensweise wird davon ausgegangen, dass eingebetteter JSON-Code die maximalen Spaltengrößenbeschränkungen von SQL Server nicht überschreitet.
Verwenden einer komplexen Sammlung für die „n“-Seite einer 1: n-Beziehung
Erstellen Sie auf der Foundry IQ-Seite ein Indexschema, das die 1:n-Beziehung mithilfe geschachtelter JSON-Daten modelliert. Das Resultset, das Sie im vorherigen Abschnitt erstellt haben, entspricht im Allgemeinen dem folgenden Indexschema (aus Platzgründen haben wir einige Felder gekürzt).
Das folgende Beispiel ähnelt dem Beispiel in Modellieren komplexer Datentypen. Die Rooms-Struktur, die im Mittelpunkt dieses Artikels steht, befindet sich in der Feldsammlung eines Indexes namens Hotels. Dieses Beispiel zeigt auch einen komplexen Typ für Address, der sich von Rooms darin unterscheidet, dass er aus einem festgelegten Satz von Elementen besteht, im Gegensatz zu der in einer Sammlung zulässigen beliebigen Anzahl von Elementen.
{
  "name": "hotels",
  "fields": [
    { "name": "HotelId", "type": "Edm.String", "key": true, "filterable": true },
    { "name": "HotelName", "type": "Edm.String", "searchable": true, "filterable": false },
    { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
    { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
    { "name": "Category", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": true },
    { "name": "ParkingIncluded", "type": "Edm.Boolean", "filterable": true, "facetable": true },
    { "name": "Tags", "type": "Collection(Edm.String)", "searchable": true, "filterable": true, "facetable": true },
    { "name": "Address", "type": "Edm.ComplexType",
      "fields": [
        { "name": "StreetAddress", "type": "Edm.String", "filterable": false, "sortable": false, "facetable": false, "searchable": true },
        { "name": "City", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true },
        { "name": "StateProvince", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true }
      ]
    },
    { "name": "Rooms", "type": "Collection(Edm.ComplexType)",
      "fields": [
        { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
        { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
        { "name": "Type", "type": "Edm.String", "searchable": true },
        { "name": "BaseRate", "type": "Edm.Double", "filterable": true, "facetable": true },
        { "name": "BedOptions", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": false },
        { "name": "SleepsCount", "type": "Edm.Int32", "filterable": true, "facetable": true },
        { "name": "SmokingAllowed", "type": "Edm.Boolean", "filterable": true, "facetable": false},
        { "name": "Tags", "type": "Edm.Collection", "searchable": true }
      ]
    }
  ]
}
Mit dem vorherigen Resultset und dem oben aufgeführten Indexschema verfügen Sie über alle erforderlichen Komponenten für einen erfolgreichen Indizierungsvorgang. Das vereinfachte Dataset erfüllt die Indizierungsanforderungen, behält jedoch Detailinformationen bei. Im Foundry IQ Index fallen Suchergebnisse leicht in hotelbasierte Entitäten, wobei der Kontext einzelner Räume und deren Attribute erhalten bleibt.
Facetverhalten für komplexe Unterfelder des Typs
Felder mit einem übergeordneten Element, z. B. die Felder unter „Address“ und „Rooms“, werden als Unterfelderbezeichnet. Obwohl Sie einem Unterfeld ein "facetable"-Attribut zuweisen können, wird die Anzahl der Facetten immer für das Hauptdokument berechnet.
Bei komplexen Typen wie Adresse, bei denen im Dokument nur eine "Address/City" oder "Address/stateProvince" vorhanden ist, funktioniert das Facettenverhalten wie erwartet. Im Fall von „Rooms“, bei denen es für jedes Hauptdokument mehrere Unterdokumente gibt, kann die Anzahl der Facetten jedoch irreführend sein.
Wie beim Modellieren komplexer Typen erwähnt: Die in den Facettenergebnissen zurückgegebene Anzahl von Dokumenten wird für das übergeordnete Dokument (ein Hotel) berechnet, nicht für die untergeordneten Dokumente in einer komplexen Sammlung (Rooms). Beispiel: Ein Hotel hat 20 Zimmer vom Typ „suite“. Angesichts dieses Facetparameters facet=Rooms/Type ist die Facetanzahl für das Hotel eins, nicht 20 für die Zimmer."
Nächste Schritte
Mit Ihrem eigenen Dataset können Sie den Datenimport-Assistenten verwenden, um den Index zu erstellen und zu laden. Der Assistent erkennt die eingebettete JSON-Sammlung, z.B. die in Rooms enthaltene Sammlung, und leitet ein Indexschema ab, das eine Sammlung komplexer Typen enthält.
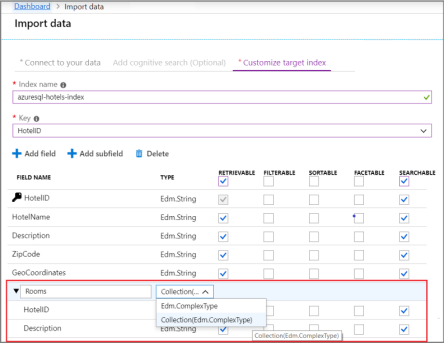
Probieren Sie die folgende Schnellstartanleitung aus, um die grundlegenden Schritte des Assistenten zum Importieren von Daten kennenzulernen.