Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
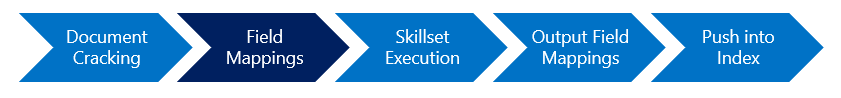
Tento článek vysvětluje, jak nastavit explicitní mapování polí, která vytvářejí cestu k datům mezi zdrojovými poli v podporovaném zdroji dat a cílovými poli v indexu vyhledávání.
Kdy nastavit mapování polí
Když indexer Azure AI Vyhledávač načte index vyhledávání, určí cestu k datům pomocí mapování polí zdrojového do cíle. Implicitní mapování polí jsou interní a dochází k nim, když jsou názvy polí a datové typy kompatibilní mezi zdrojem a cílem. Pokud se vstupy a výstupy neshodují, můžete definovat explicitní mapování polí pro nastavení cesty k datům, jak je popsáno v tomto článku.
Mapování polí lze také použít pro převody dat s lehkou hmotností, jako je kódování nebo dekódování, prostřednictvím mapovacích funkcí. Pokud je potřeba další zpracování, zvažte použití Azure Data Factory k překlenutí mezery.
Mapování polí platí pro:
Fyzické datové struktury na obou stranách cesty k datům. Logické datové struktury vytvořené dovednostmi se nacházejí pouze v paměti. Pomocí outputFieldMappings namapovat uzly v paměti na výstupní pole v indexu vyhledávání.
Pouze hlavní indexy vyhledávání AI V případě sekundárních indexů s podřízenými dokumenty nebo bloky dat se podívejte na pokročilé scénáře mapování polí.
Pouze vyhledávací pole nejvyšší úrovně, kde
targetFieldNameje buď jednoduché pole, nebo kolekce. Cílové pole nemůže být komplexní typ.
Podporované scénáře
Ujistěte se, že používáte podporovaný zdroj dat pro indexování řízené indexerem.
| Případ použití | Popis |
|---|---|
| Nesrovnalosti v názvu | Předpokládejme, že váš zdroj dat má pole s názvem _city. Vzhledem k tomu, že Azure AI Vyhledávač nepovoluje, aby názvy polí začínaly podtržítkem, mapování polí vám umožňuje efektivně namapovat "_city" na "city". Pokud vaše požadavky na indexování zahrnují načtení obsahu z více zdrojů dat, kde se názvy polí mezi zdroji liší, můžete k objasnění cesty použít mapování polí. |
| Nesrovnalosti typu | Předpokládejme, že chcete, aby zdrojové celočíselné pole bylo typu Edm.String , aby bylo možné ho prohledávat v indexu vyhledávání. Vzhledem k tomu, že se typy liší, je potřeba definovat mapování polí, aby cesta k datům byla úspěšná. Všimněte si, že Azure AI Vyhledávač má menší sadu podporovaných datových typů než mnoho zdrojů dat. Pokud importujete data SQL, mapování polí umožňuje namapovat požadovaný datový typ SQL v indexu vyhledávání. |
| Jednocestné datové toky | Do indexu můžete naplnit více polí obsahem ze stejného zdrojového pole. Můžete například chtít pro každé pole použít různé analyzátory, které podporují různé případy použití v klientské aplikaci. |
| Kódování a dekódování | Funkce mapování můžete použít pro podporu kódování Base64 nebo dekódování dat během indexování. |
| Převedení řetězců nebo přetvořených polí do kolekcí | Funkce mapování můžete použít k rozdělení řetězce, který obsahuje oddělovač, nebo k odeslání pole JSON do vyhledávacího pole typu Collection(Edm.String). |
Poznámka
Pokud nejsou k dispozici žádná mapování polí, indexery předpokládají, že pole zdroje dat by se měla mapovat na pole indexu se stejným názvem. Přidání mapování polí přepíše výchozí mapování polí pro zdrojové a cílové pole. Některé indexery, jako je indexer úložiště blob, přidávají výchozí mapování polí pro pole klíčů indexu automaticky.
V mapování polí nejsou podporovaná složitá pole. Zdrojová struktura (vnořené nebo hierarchické struktury) musí přesně odpovídat komplexnímu typu v indexu, aby výchozí mapování fungovalo. Další informace najdete v tutoriálu: Indexování vnořených JSON blobů. Pokud se zobrazí chyba podobná "Field mapping specifies target field 'Address/city' that doesn't exist in the index", je to proto, že mapování cílových polí nemůže být složitým typem.
Volitelně můžete chtít ve složité struktuře jenom několik uzlů. Pokud chcete získat jednotlivé uzly, můžete zploštět příchozí data do kolekce řetězců (viz outputFieldMappings pro toto alternativní řešení).
Definujte mapování polí
Tato část vysvětluje kroky pro nastavení mapování polí.
Použijte Create Indexer nebo Create nebo Update Indexer nebo ekvivalentní metodu v Azure SDK. Tady je příklad definice indexeru.
{
   "name": "myindexer",
   "description": null,
   "dataSourceName": "mydatasource",
   "targetIndexName": "myindex",
   "schedule": { },
   "parameters": { },
   "fieldMappings": [],
   "disabled": false,
   "encryptionKey": { }
 }
Vyplňte
fieldMappingspole a určete mapování. Mapování polí se skládá ze tří částí."fieldMappings": [ { "sourceFieldName": "_city", "targetFieldName": "city", "mappingFunction": null } ]Vlastnost Popis sourceFieldName Požadované. Představuje pole ve zdroji dat. cílovýNázevPole Volitelné. Představuje pole v indexu vyhledávání. Pokud je vynecháno, předpokládá se hodnota sourceFieldNamepro cíl. Cílová pole musí být jednoduchá pole nejvyšší úrovně hierarchie nebo kolekce. Nemůže se jednat o komplexní typ ani kolekci. Pokud řešíte problém s datovým typem, je datový typ pole zadaný v definici indexu. Mapování polí musí mít jenom název pole.mapovací funkce Volitelné. Skládá se z předdefinovaných funkcí , které transformují data.
Příklad: Nesrovnalosti v názvu nebo typu
Explicitní mapování polí vytváří cestu k datům pro případy, kdy název a typ nejsou identické.
Azure AI Vyhledávač k překladu názvů polí a funkcí v mapování polí používá porovnání nerozlišující malá a velká písmena. To je praktické (nemusíte mít všechna písmena správná), ale znamená to, že zdroj dat nebo index nemůžou mít pole, která se liší jenom v případě.
PUT https://[service name].search.windows.net/indexers/myindexer?api-version=[api-version]
Content-Type: application/json
api-key: [admin key]
{
    "dataSourceName" : "mydatasource",
    "targetIndexName" : "myindex",
    "fieldMappings" : [ { "sourceFieldName" : "_city", "targetFieldName" : "city" } ]
}
Příklad: Datové cesty jedna ku mnoha nebo větvené
Tento příklad mapuje jedno zdrojové pole na více cílových polí ("jedno-na-mnoho" mapování). Pole můžete "forknout", aby se stejný obsah zdrojového pole zkopíroval do dvou různých indexových polí, která se budou analyzovat nebo přičítat/přidělovat odlišně v indexu.
"fieldMappings" : [
    { "sourceFieldName" : "text", "targetFieldName" : "textStandardEnglishAnalyzer" },
    { "sourceFieldName" : "text", "targetFieldName" : "textSoundexAnalyzer" }
]
Podobný přístup můžete použít pro obsah vygenerovaný dovednostmi.
Mapování funkcí a příkladů
Funkce mapování polí před uložením v indexu transformuje obsah pole. V současné době se podporují následující funkce mapování:
- base64Encode
- base64Decode
- extractTokenAtPosition
- fixedLengthEncode
- jsonArrayToStringCollection
- toJson
- Urlencode
- urlDecode
Upozorňujeme, že tyto funkce jsou v tuto chvíli podporovány výhradně pro nadřazené indexy. Nejsou kompatibilní s mapováním bloků indexů, takže tyto funkce se nedají použít pro projekce indexů.
base64Encode – funkce
Provádí Base64 bezpečné pro URL kódování vstupního řetězce. Předpokládá, že vstup je kódován UTF-8.
Příklad: Kódování základního klíče dokumentu
V klíči dokumentu Azure AI Vyhledávač se mohou objevit pouze znaky bezpečné pro adresy URL (abyste mohli dokument zpřístupnit pomocí rozhraní API Lookup API). Pokud zdrojové pole klíče obsahuje nebezpečné znaky adresy URL, například - a \, použijte funkci k převodu base64Encode v době indexování.
Následující příklad určuje funkci base64Encode na metadata_storage_name pro zpracování nepodporovaných znaků.
PUT /indexers?api-version=2026-04-01
{
  "dataSourceName" : "my-blob-datasource ",
  "targetIndexName" : "my-search-index",
  "fieldMappings" : [
    {
        "sourceFieldName" : "metadata_storage_name",
        "targetFieldName" : "key",
        "mappingFunction" : {
            "name" : "base64Encode",
            "parameters" : { "useHttpServerUtilityUrlTokenEncode" : false }
        }
    }
  ]
}
Klíč dokumentu (před i po převodu) nesmí být delší než 1 024 znaků. Když načtete kódovaný klíč v době hledání, použijte base64Decode funkci k získání původní hodnoty klíče a použijte ji k načtení zdrojového dokumentu.
Příklad: Nastavení pole s kódováním base "prohledávatelné"
Existují chvíle, kdy potřebujete použít zakódovanou verzi pole, jako je metadata_storage_path pro klíč, ale také potřebujete nekódovanou verzi pro fulltextové vyhledávání. Pro podporu obou scénářů můžete mapovat metadata_storage_path na dvě pole: jedno pro klíč (kódované) a druhé pro pole cesty, které můžeme předpokládat, je přiřazeno jako searchable ve schématu indexu.
PUT /indexers/blob-indexer?api-version=2026-04-01
{
    "dataSourceName" : " blob-datasource ",
    "targetIndexName" : "my-target-index",
    "schedule" : { "interval" : "PT2H" },
    "fieldMappings" : [
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "key", "mappingFunction" : { "name" : "base64Encode" } },
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "path" }
      ]
}
Příklad – zachování původních hodnot
Indexer úložiště objektů blob automaticky přidá mapování polí z metadata_storage_pathidentifikátoru URI objektu blob do pole klíče indexu, pokud není zadáno žádné mapování polí. Tato hodnota je zakódovaná v Base64, takže je bezpečné ji používat jako klíč dokumentu Azure AI Vyhledávač. Následující příklad ukazuje, jak současně mapovat URL-bezpečnou base64 zakódovanou verzi na metadata_storage_path pole a zachovat původní hodnotu v index_key poli:
"fieldMappings": [
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "metadata_storage_path"
  },
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "index_key",
    "mappingFunction": {
       "name": "base64Encode"
    }
  }
]
Pokud pro funkci mapování nezadáte vlastnost parametrů, nastaví se jako výchozí hodnota {"useHttpServerUtilityUrlTokenEncode" : true}.
Azure AI Vyhledávač podporuje dvě různá kódování Base64. Při kódování a dekódování stejného pole byste měli použít stejné parametry. Další informace naleznete v tématu možnosti kódování base64, abyste se rozhodli, které parametry použít.
base64Decode – funkce
Provádí dekódování vstupního řetězce Base64. Předpokládá se, že vstupem je URL bezpečný Base64 kódovaný řetězec.
Příklad – dekódování metadat objektů blob nebo adres URL
Zdrojová data můžou obsahovat řetězce s kódováním Base64, jako jsou řetězce metadat objektů blob nebo webové adresy URL, které chcete prohledávat jako prostý text. Pomocí funkce můžete base64Decode při naplnění indexu vyhledávání převést zakódovaná data zpět na běžné řetězce.
"fieldMappings" : [
  {
    "sourceFieldName" : "Base64EncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "base64Decode",
      "parameters" : { "useHttpServerUtilityUrlTokenDecode" : false }
    }
  }
]
Pokud nezahrnete vlastnost parametrů, výchozí hodnota {"useHttpServerUtilityUrlTokenEncode" : true}je .
Azure AI Vyhledávač podporuje dvě různá kódování Base64. Při kódování a dekódování stejného pole byste měli použít stejné parametry. Další informace naleznete v tématu možnosti kódování base64, abyste se rozhodli, které parametry použít.
Možnosti kódování base64
Azure AI Vyhledávač podporuje kódování base64 bezpečné pro adresy URL a běžné kódování base64. Řetězec, který je během indexování kódován pomocí base64, by měl být později dekódován se stejnými možnostmi kódování, jinak nebude výsledek odpovídat původnímu.
useHttpServerUtilityUrlTokenEncode Pokud jsou parametry pro kódování a dekódování nastaveny na useHttpServerUtilityUrlTokenDecode, true chová se jako base64Encode a chová se jako base64Decode.
Upozornění
Pokud base64Encode se používá k vytváření hodnot klíče, useHttpServerUtilityUrlTokenEncode musí být nastavena na hodnotu true. Pro hodnoty klíčů je možné použít pouze kódování base64 bezpečné pro adresy URL. Úplnou sadu omezení pro znaky v hodnotách klíče najdete v pravidlech pojmenování .
Knihovny .NET v Azure AI Vyhledávač předpokládají úplný .NET Framework, který poskytuje integrované kódování.
useHttpServerUtilityUrlTokenEncode a useHttpServerUtilityUrlTokenDecode možnosti aplikují tuto vestavěnou funkčnost. Pokud používáte .NET Core nebo jiný framework, doporučujeme nastavit tyto možnosti na false a přímo volat funkce kódování a dekódování vašeho frameworku.
Následující tabulka porovnává různé kódování base64 řetězce 00>00?00. Pokud chcete určit požadované zpracování (pokud existuje) pro funkce base64, použijte funkci kódování knihovny na řetězec 00>00?00 a porovnejte výstup s očekávaným výstupem MDA-MDA_MDA.
| Encoding | Kódování výstupu base64 | Dodatečné zpracování po kódování knihovny | Dodatečné zpracování před dekódováním knihovny |
|---|---|---|---|
| Base64 s vyplňováním | MDA+MDA/MDA= |
Použijte znaky bezpečné pro URL a odstraňte doplňování | Použijte standardní znaky base64 a přidejte doplňkování |
| Base64 bez odsazení | MDA+MDA/MDA |
Použití znaků bezpečných pro adresu URL | Použití standardních znaků base64 |
| Base64 bezpečný pro adresy URL s odsazením | MDA-MDA_MDA= |
Odstranit výplň | Přidat odsazení |
| URL-bezpečný base64 bez výplně | MDA-MDA_MDA |
Žádný | Žádný |
extractTokenAtPosition – funkce
Rozdělí pole řetězce pomocí zadaného oddělovače a vybere token na zadané pozici ve výsledném rozdělení.
Tato funkce používá následující parametry:
-
delimiter: Řetězec, který se má použít jako oddělovač při rozdělení vstupního řetězce. -
position: Celočíselná nulová pozice tokenu, která se má vybrat po rozdělení vstupního řetězce.
Pokud je například vstup Jane Doe, delimiter je mezera a " " je 0, výsledek je position; pokud Jane je 1, výsledek je position. Pokud pozice odkazuje na token, který neexistuje, vrátí se chyba.
Příklad – extrakce názvu
Zdroj dat obsahuje PersonName pole a chcete ho indexovat jako dvě samostatná FirstName pole a LastName pole. Tuto funkci můžete použít k rozdělení vstupu pomocí znaku mezery jako oddělovače.
"fieldMappings" : [
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "FirstName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 0 } }
  },
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "LastName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 1 } }
  }]
funkce jsonArrayToStringCollection
Transformuje řetězec formátovaný jako pole JSON řetězců na pole řetězců, které lze použít k naplnění Collection(Edm.String) pole v indexu.
Pokud je ["red", "white", "blue"]například vstupní řetězec , bude cílové pole typu Collection(Edm.String) vyplněno třemi hodnotami red, whitea blue. U vstupních hodnot, které nelze analyzovat jako pole řetězců JSON, se vrátí chyba.
Příklad – naplnění kolekce z relačních dat
Azure SQL Database nemá integrovaný datový typ, který se přirozeně mapuje na pole Collection(Edm.String) v Azure AI Vyhledávač. Pokud chcete naplnit pole kolekce řetězců, můžete zdrojová data předzpracovat jako pole řetězců JSON a pak použít jsonArrayToStringCollection funkci mapování.
"fieldMappings" : [
  {
    "sourceFieldName" : "tags",
    "mappingFunction" : { "name" : "jsonArrayToStringCollection" }
  }]
urlEncode – funkce
Tuto funkci lze použít ke kódování řetězce tak, aby byla bezpečná pro adresu URL. Při použití s řetězcem, který obsahuje znaky, které nejsou povoleny v adrese URL, tato funkce převede tyto "nebezpečné" znaky na ekvivalenty znakové entity. Tato funkce používá formát kódování UTF-8.
Příklad – vyhledání klíče dokumentu
urlEncode funkci lze použít jako alternativu base64Encode k funkci, pokud se mají převést pouze nebezpečné znaky adresy URL a současně zachovat další znaky as-is.
Řekněme, že vstupní řetězec je <hello> – pak se cílové pole typu (Edm.String) naplní hodnotou. %3chello%3e
Když načtete kódovaný klíč v době hledání, můžete pomocí urlDecode funkce získat původní hodnotu klíče a použít ji k načtení zdrojového dokumentu.
"fieldMappings" : [
  {
    "sourceFieldName" : "SourceKey",
    "targetFieldName" : "IndexKey",
    "mappingFunction" : {
      "name" : "urlEncode"
    }
  }
]
Funkce urlDecode
Tato funkce převede řetězec kódovaný adresou URL na dekódovaný řetězec pomocí formátu kódování UTF-8.
Příklad – dekódování metadat objektů blob
Někteří klienti úložiště Azure automaticky zakódují metadata objektů BLOB, pokud obsahují jiné znaky než ASCII. Pokud ale chcete, aby byla taková metadata prohledávatelná (jako prostý text), můžete pomocí urlDecode funkce převést zakódovaná data zpět na běžné řetězce při naplnění indexu vyhledávání.
"fieldMappings" : [
  {
    "sourceFieldName" : "UrlEncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "urlDecode"
    }
  }
]
fixedLengthEncode – funkce
Tato funkce převede řetězec libovolné délky na řetězec s pevnou délkou.
Příklad – mapování klíčů dokumentu, které jsou příliš dlouhé
Pokud dojde k chybám souvisejícím s délkou klíče dokumentu větší než 1024 znaků, můžete tuto funkci použít ke zmenšení délky klíče dokumentu.
"fieldMappings" : [
 {
   "sourceFieldName" : "metadata_storage_path",
   "targetFieldName" : "your key field",
   "mappingFunction" : {
     "name" : "fixedLengthEncode"
   }
 }
]
funkce toJson
Tato funkce převede řetězec na formátovaný objekt JSON. To se dá použít ve scénářích, kdy zdroj dat, například Azure SQL, nativně nepodporuje složené nebo hierarchické datové typy a pak ho mapuje na složitá pole.
Příklad – mapování textového obsahu na komplexní pole
Předpokládejme, že existuje řádek SQL s řetězcem JSON, který je potřeba namapovat na komplexní pole v indexu, jež je odpovídajícím způsobem definované. Funkce toJson může být použita k dosažení tohoto cíle. Pokud například musí být komplexní pole v indexu naplněno následujícími daty:
{
    "id": "5",
    "info": {
        "name": "Jane",
        "surname": "Smith",
        "skills": [
            "SQL",
            "C#",
            "Azure"
        ],
        "dob": "2005-11-04T12:00:00"
    }
}
Toho lze dosáhnout pomocí funkce mapování toJson ve sloupci řetězce JSON na řádku SQL, který vypadá takto: {"id": 5, "info": {"name": "Jane", "surname": "Smith", "skills": ["SQL", "C#", "Azure"]}, "dob": "2005-11-04T12:00:00"}.
Mapování polí je potřeba zadat, jak je znázorněno níže.
"fieldMappings" : [
  {
    "sourceFieldName" : "content",
    "targetFieldName" : "complexField",
    "mappingFunction" : {
      "name" : "toJson"
    }
  }
]
Pokročilé scénáře mapování polí
Ve scénářích, kde máte relace dokumentů typu "jeden k mnoha", jako je například dělení nebo rozdělování dat, postupujte podle těchto pokynů pro mapování polí z nadřazených dokumentů na odvozené dokumenty (bloky dat).
1. Přeskočení indexování nadřazeného dokumentu
Pokud indexování nadřazených dokumentů přeskočíte (nastavením projectionMode v skipIndexingParentDocuments sadě indexProjectionsdovedností), použijte projekce indexů k mapování polí z nadřazených dokumentů na podřízené dokumenty.
2. Indexování nadřazených i podřízených dokumentů
Pokud indexujete nadřazené dokumenty i podřízené dokumenty:
- Pole přiřaďte pomocí mapování polí na nadřazené dokumenty.
- Pomocí projekcí indexu můžete mapovat pole na podřízené dokumenty.
3. Mapování hodnot transformovaných funkcí na nadřazené a/nebo podřízené dokumenty
Pokud pole v nadřazeném dokumentu vyžaduje transformaci (pomocí mapovacích funkcí , jako je kódování), a je potřeba je namapovat na nadřazené nebo podřízené dokumenty:
- Použijte transformaci pomocí funkcí mapování polí v indexeru.
- Pomocí projekce indexu ve skillsetu přiřaďte transformované pole k dokumentům "child".