Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka:
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Azure AI Vyhledávač přijímá jako vstup do kanálu indexování plochou sadu řádků. Pokud zdrojová data pocházejí z připojených tabulek v relační databázi SQL Serveru, tento článek vysvětluje, jak sestavit sadu řádků a jak modelovat relaci nadřazenosti a podřízenosti v indexu Azure AI Vyhledávač.
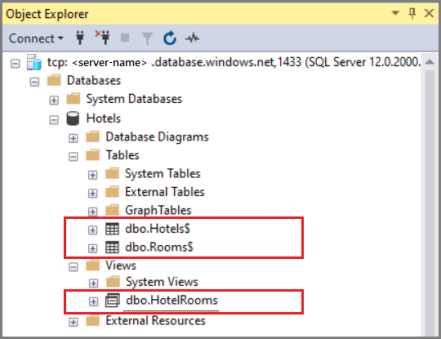
Jako příklad odkazujeme na hypotetickou databázi hotelů na základě ukázkových dat. Předpokládejme, že databáze se skládá z Hotels$ tabulky s 50 hotely a Rooms$ tabulka s místnostmi různých typů, sazeb a vybavení, celkem 750 místností. Mezi tabulkami je relace 1:N. V našem přístupu poskytuje zobrazení dotaz, který vrátí 50 řádků, přičemž každý řádek odpovídá jednomu hotelu a do každého jsou vloženy příslušné podrobnosti o pokoji.
Problém denormalizovaných dat
Jednou z výzev při práci s relacemi 1:N je to, že standardní dotazy založené na spojených tabulkách vracejí denormalizovaná data, která ve scénáři Azure AI Vyhledávač nefungují dobře. Podívejte se na následující příklad, který propojuje hotely a pokoje.
SELECT * FROM Hotels$
INNER JOIN Rooms$
ON Rooms$.HotelID = Hotels$.HotelID
Výsledky z tohoto dotazu vrátí všechna hotelová pole, následovaná všemi poli Pokojů, s předběžnými informacemi o hotelu, které se opakují pro každou hodnotu pokoje.
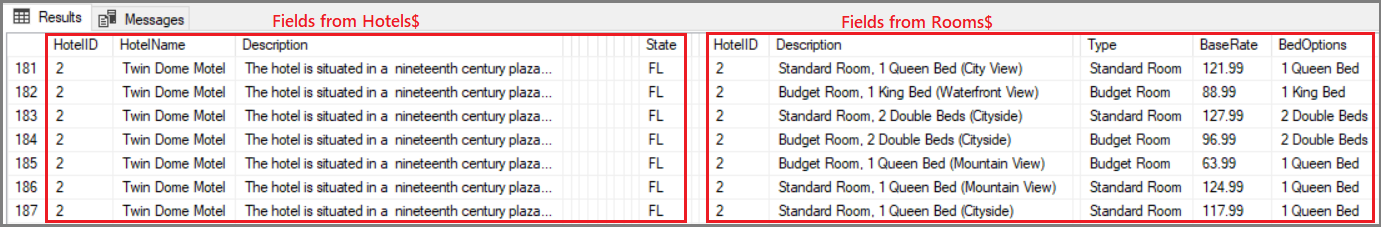
I když je tento dotaz na povrchu úspěšný (poskytuje všechna data v ploché sadě řádků), nedoručí správnou strukturu dokumentu pro očekávané vyhledávání. Během indexování azure AI Search vytvoří jeden vyhledávací dokument pro každý přijatý řádek. Pokud by vaše vyhledávací dokumenty vypadaly jako výše uvedené výsledky, měli byste vnímat duplicity - sedm samostatných dokumentů pro samotný Old Century Hotel. Dotaz na "hotely na Floridě" by vrátil sedm výsledků pouze pro Old Century Hotel, který do výsledků hledání tlačí další relevantní hotely.
Pokud chcete získat očekávané zkušenosti s jedním dokumentem na hotel, měli byste poskytnout sadu řádků ve správné členitosti, ale s úplnými informacemi. Tento článek vysvětluje, jak na to.
Definování dotazu, který vrací vložený JSON
Pro doručení očekávaného prostředí hledání by vaše datová sada měla obsahovat jeden řádek pro každý vyhledávací dokument ve službě Azure AI Vyhledávač. V našem příkladu chceme pro každý hotel jeden řádek, ale také chceme, aby naši uživatelé mohli hledat v jiných polích souvisejících s místnostmi, o která se zajímají, například noční sazbu, velikost a počet postelí nebo zobrazení pláže, z nichž všichni jsou součástí podrobností o místnosti.
Řešením je zachytit podrobnosti místnosti jako vnořený JSON a pak vložit strukturu JSON do pole v zobrazení, jak je znázorněno v druhém kroku.
Předpokládejme, že máte dvě spojené tabulky,
Hotels$kteréRooms$obsahují podrobnosti o 50 hotelech a 750 pokojích a jsou spojené v poli HotelID. Jednotlivé tabulky obsahují 50 hotelů a 750 souvisejících pokojů.CREATE TABLE [dbo].[Hotels$]( [HotelID] [nchar](10) NOT NULL, [HotelName] [nvarchar](255) NULL, [Description] [nvarchar](max) NULL, [Description_fr] [nvarchar](max) NULL, [Category] [nvarchar](255) NULL, [Tags] [nvarchar](255) NULL, [ParkingIncluded] [float] NULL, [SmokingAllowed] [float] NULL, [LastRenovationDate] [smalldatetime] NULL, [Rating] [float] NULL, [StreetAddress] [nvarchar](255) NULL, [City] [nvarchar](255) NULL, [State] [nvarchar](255) NULL, [ZipCode] [nvarchar](255) NULL, [GeoCoordinates] [nvarchar](255) NULL ) ON [PRIMARY] TEXTIMAGE_ON [PRIMARY] GO CREATE TABLE [dbo].[Rooms$]( [HotelID] [nchar](10) NULL, [Description] [nvarchar](255) NULL, [Description_fr] [nvarchar](255) NULL, [Type] [nvarchar](255) NULL, [BaseRate] [float] NULL, [BedOptions] [nvarchar](255) NULL, [SleepsCount] [float] NULL, [SmokingAllowed] [float] NULL, [Tags] [nvarchar](255) NULL ) ON [PRIMARY] GOVytvořte zobrazení složené ze všech polí v nadřazené tabulce (
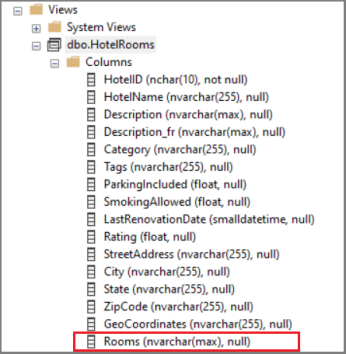
SELECT * from dbo.Hotels$) s přidáním nového pole Místnosti , které obsahuje výstup vnořeného dotazu. Klausule FOR JSON AUTOSELECT * from dbo.Rooms$strukturuje výstup jako JSON.CREATE VIEW [dbo].[HotelRooms] AS SELECT *, (SELECT * FROM dbo.Rooms$ WHERE dbo.Rooms$.HotelID = dbo.Hotels$.HotelID FOR JSON AUTO) AS Rooms FROM dbo.Hotels$ GONásledující snímek obrazovky ukazuje výsledné zobrazení s polem Místnosti nvarchar v dolní části. Pole Pokoje existuje pouze v zobrazení HotelRooms.
Spusťte
SELECT * FROM dbo.HotelRoomspro načtení sady řádků. Tento dotaz vrátí 50 řádků, jeden na hotel s přidruženými informacemi o místnosti jako kolekci JSON.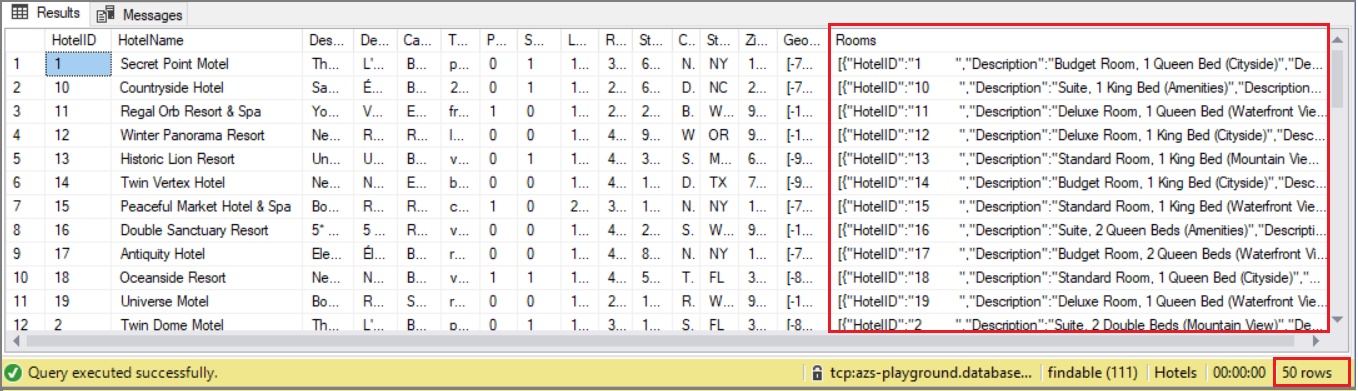
Tato sada řádků je teď připravená k importu do služby Azure AI Vyhledávač.
Poznámka:
Tento přístup předpokládá, že vložený JSON je pod maximálními omezeními velikosti sloupců SQL Serveru.
Použijte komplexní kolekci pro stranu 'mnoha' relace 1:N
Na straně služby Azure AI Vyhledávač vytvořte schéma indexu, které modeluje relaci 1:N pomocí vnořeného formátu JSON. Sada výsledků, kterou jste vytvořili v předchozí části, obecně odpovídá následujícímu schématu indexu (některá pole pro stručnost vyjmeme).
Následující příklad je podobný příkladu v postupu modelování složitých datových typů. Struktura Místností, na kterou se tento článek zaměřuje, je v kolekci polí indexu s názvem hotely. Tento příklad také ukazuje komplexní typ pro Address, který se liší od Rooms v tom, že se skládá z pevné sady položek, na rozdíl od libovolného počtu položek povolených v kolekci.
{
  "name": "hotels",
  "fields": [
    { "name": "HotelId", "type": "Edm.String", "key": true, "filterable": true },
    { "name": "HotelName", "type": "Edm.String", "searchable": true, "filterable": false },
    { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
    { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
    { "name": "Category", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": true },
    { "name": "ParkingIncluded", "type": "Edm.Boolean", "filterable": true, "facetable": true },
    { "name": "Tags", "type": "Collection(Edm.String)", "searchable": true, "filterable": true, "facetable": true },
    { "name": "Address", "type": "Edm.ComplexType",
      "fields": [
        { "name": "StreetAddress", "type": "Edm.String", "filterable": false, "sortable": false, "facetable": false, "searchable": true },
        { "name": "City", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true },
        { "name": "StateProvince", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true }
      ]
    },
    { "name": "Rooms", "type": "Collection(Edm.ComplexType)",
      "fields": [
        { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
        { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
        { "name": "Type", "type": "Edm.String", "searchable": true },
        { "name": "BaseRate", "type": "Edm.Double", "filterable": true, "facetable": true },
        { "name": "BedOptions", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": false },
        { "name": "SleepsCount", "type": "Edm.Int32", "filterable": true, "facetable": true },
        { "name": "SmokingAllowed", "type": "Edm.Boolean", "filterable": true, "facetable": false},
        { "name": "Tags", "type": "Edm.Collection", "searchable": true }
      ]
    }
  ]
}
Vzhledem k předchozí sadě výsledků a výše uvedenému schématu indexu máte všechny požadované součásti pro úspěšnou operaci indexování. Zploštěná datová sada splňuje požadavky indexování, ale zachovává podrobné informace. Výsledky hledání v indexu Azure AI Vyhledávač snadno spadají do hotelových entit a přitom zachovávají kontext jednotlivých místností a jejich atributů.
Chování aspektů dílčích polí komplexních typů
Pole, která mají nadřazené pole, jako jsou pole v sekci Adresa a Místnosti, se nazývají dílčí pole. I když můžete k dílčímu poli přiřadit atribut "facetable", počet facetu je vždy pro hlavní dokument.
U složitých typů, jako je Adresa, kde je v dokumentu jenom jedna Adresa/město nebo Adresa/státProvincie, funguje chování omezující vlastnosti podle očekávání. V případě místností, kde je pro každý hlavní dokument více vnořených dokumentů, mohou být počty aspektů zavádějící.
Jak je uvedeno v komplexních typech modelu: "Počty dokumentů vrácené ve výsledcích faetů se počítají pro nadřazený dokument (hotel), ne pro poddokumenty v komplexní kolekci (místnosti). Předpokládejme například, že hotel má 20 pokojů typu "suite". Vzhledem k tomuto parametru facet=Rooms/Type je počet parametrů pro hotel jeden, nikoli 20 pro pokoje.
Další kroky
Pomocí vlastní sady dat můžete pomocí Průvodce importem dat vytvořit a načíst index. Průvodce zjistí vloženou kolekci JSON, například kolekci obsaženou v místnostech, a odvodí schéma indexu, které zahrnuje kolekci komplexního typu.
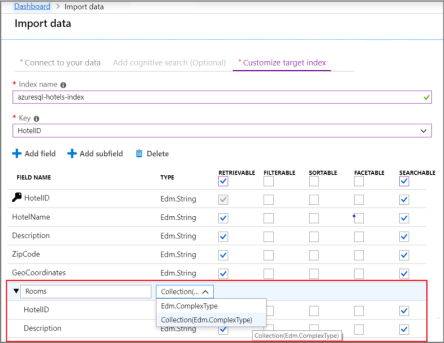
Vyzkoušejte následující rychlý start a seznamte se se základními kroky průvodce importem dat .