注意
Foundry IQ(Azure AI 搜尋服務)提供直接的索引與查詢 API,並搭配高階知識來源與知識庫 API 用於受控檢索。 使用 Azure 入口網站、REST API 或 Azure SDK 來設定這些功能,或將代理連線到 Microsoft Foundry 入口網站 中的知識庫。
Foundry IQ(Azure AI 搜尋服務)接受一個平面列集作為索引管線的輸入。 如果您的來源資料來自 SQL Server 關聯式資料庫中的連接資料表,本文將說明如何建構列集,以及如何在 Foundry IQ 索引中建模父子關係。
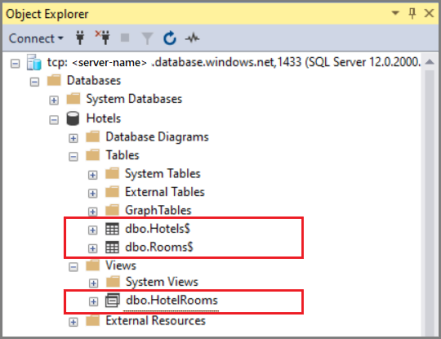
舉例來說,我們參考一個基於示範資料的假設酒店資料庫。 假設此資料庫包含具有 50 家旅館的 Hotels$ 資料表,以及具有各種類型、費率和設施的房間的 Rooms$ 資料表,總共有 750 個房間。 資料表之間有一對多關聯性。 在我們的方法中,視圖提供的查詢會傳回 50 個資料列,每家旅館對應一個資料列,並在每個資料列中內嵌相關的房間詳細資料。
反正規化資料的問題
處理一對多關係的挑戰之一是,建立在連接資料表上的標準查詢會回傳非正規化的資料,這在 Foundry IQ 的情境下並不理想。 請考慮下列聯結旅館和房間的範例。
SELECT * FROM Hotels$
INNER JOIN Rooms$
ON Rooms$.HotelID = Hotels$.HotelID
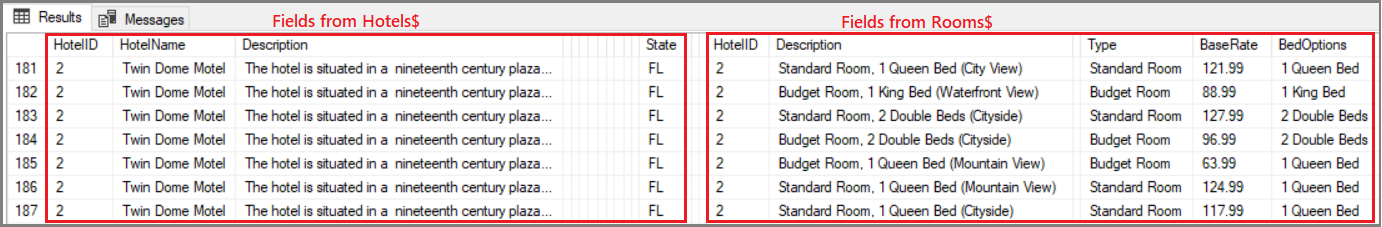
此查詢的結果會傳回所有旅館的欄位,接著是所有房間的欄位。隨著每個房間的數值,初步的旅館資訊會重複顯示。
 非 非
雖然此查詢在表面看似成功(提供平面行集中的所有數據),但在提供預期搜尋體驗所需的正確文件結構上卻失敗。 在索引過程中,Foundry IQ 會為每匯入的資料列建立一份搜尋文件。 如果您的搜尋檔看起來像上述結果,您就會注意到重複的文件 — 僅舊世紀酒店就有七個單獨的檔案。 對「佛羅里達酒店」的查詢將只傳回舊世紀酒店七個結果,將其他相關酒店深入搜尋結果。
若要獲得每家旅館一份文件的預期體驗,您應提供粒度正確且資訊完整的資料列集合。 本文說明執行方法。
定義可傳回內嵌 JSON 的查詢
為了提供預期的搜尋體驗,您的資料集應由 Foundry IQ 中每個搜尋文件的一列組成。 在我們的範例中,我們希望每家旅館有一個資料列,但我們也希望使用者能夠搜尋他們關心的其他房間相關欄位,例如每晚費率、房間大小和數量或海景,這些全都屬於房間詳細資料。
解決方案是將房間詳細資料擷取為巢狀 JSON,然後將 JSON 結構插入檢視中的欄位,如第二個步驟所示。
假設您有兩個已聯結的資料表 (
Hotels$和Rooms$),其中包含 50 家旅館和 750 個房間的詳細資料,並聯結在 HotelID 欄位上。 這些資料表個別包含 50 家旅館和 750 個相關房間。CREATE TABLE [dbo].[Hotels$]( [HotelID] [nchar](10) NOT NULL, [HotelName] [nvarchar](255) NULL, [Description] [nvarchar](max) NULL, [Description_fr] [nvarchar](max) NULL, [Category] [nvarchar](255) NULL, [Tags] [nvarchar](255) NULL, [ParkingIncluded] [float] NULL, [SmokingAllowed] [float] NULL, [LastRenovationDate] [smalldatetime] NULL, [Rating] [float] NULL, [StreetAddress] [nvarchar](255) NULL, [City] [nvarchar](255) NULL, [State] [nvarchar](255) NULL, [ZipCode] [nvarchar](255) NULL, [GeoCoordinates] [nvarchar](255) NULL ) ON [PRIMARY] TEXTIMAGE_ON [PRIMARY] GO CREATE TABLE [dbo].[Rooms$]( [HotelID] [nchar](10) NULL, [Description] [nvarchar](255) NULL, [Description_fr] [nvarchar](255) NULL, [Type] [nvarchar](255) NULL, [BaseRate] [float] NULL, [BedOptions] [nvarchar](255) NULL, [SleepsCount] [float] NULL, [SmokingAllowed] [float] NULL, [Tags] [nvarchar](255) NULL ) ON [PRIMARY] GO建立由父代資料表中的所有欄位所組成的檢視 (
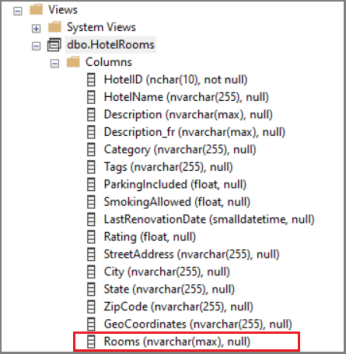
SELECT * from dbo.Hotels$),並新增包含巢狀查詢輸出的新 Rooms 欄位。 在 上使用SELECT * from dbo.Rooms$子句,可將輸出結構化為 JSON。CREATE VIEW [dbo].[HotelRooms] AS SELECT *, (SELECT * FROM dbo.Rooms$ WHERE dbo.Rooms$.HotelID = dbo.Hotels$.HotelID FOR JSON AUTO) AS Rooms FROM dbo.Hotels$ GO下列螢幕擷取畫面顯示所產生的檢視,其中 Rooms nvarchar 欄位位於底部。 Rooms 欄位只存在於 HotelRooms 檢視中。
執行
SELECT * FROM dbo.HotelRooms以擷取資料列集。 此查詢會傳回 50 個資料列,每個旅館一個資料列,還有相關聯的房間資訊做為 JSON 集合。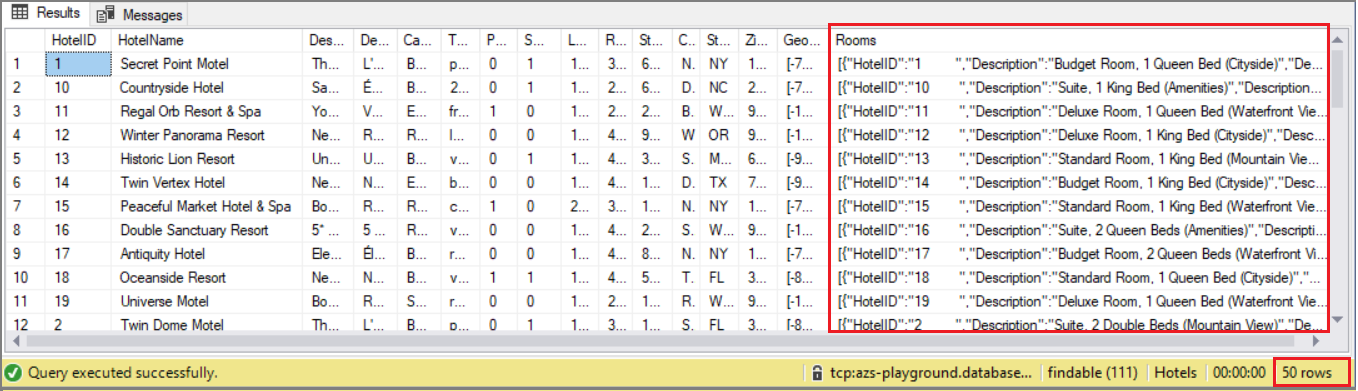
此列集現已準備好匯入 Foundry IQ。
注意
此方法假設內嵌的 JSON 在 SQL Server 的最大資料行大小限制之下。
針對一對多關聯中的「多」端使用複雜集合
在 Foundry IQ 端,建立一個索引結構,利用巢狀 JSON 來表示一對多關係。 您在上一節中建立的結果集通常會對應至接下來提供的索引結構描述 (我們會剪下一些欄位以求簡潔)。
下列範例類似於如何建立複雜資料類型的模型中的範例。 本文的重點是 Rooms 結構,其位於名為 hotels 的索引欄位集合中。 此範例也會針對 Address 顯示複雜類型,其與 Rooms 不同,因為它是由一組固定的項目所組成,而不是集合中允許的多個任意數的項目。
{
  "name": "hotels",
  "fields": [
    { "name": "HotelId", "type": "Edm.String", "key": true, "filterable": true },
    { "name": "HotelName", "type": "Edm.String", "searchable": true, "filterable": false },
    { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
    { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
    { "name": "Category", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": true },
    { "name": "ParkingIncluded", "type": "Edm.Boolean", "filterable": true, "facetable": true },
    { "name": "Tags", "type": "Collection(Edm.String)", "searchable": true, "filterable": true, "facetable": true },
    { "name": "Address", "type": "Edm.ComplexType",
      "fields": [
        { "name": "StreetAddress", "type": "Edm.String", "filterable": false, "sortable": false, "facetable": false, "searchable": true },
        { "name": "City", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true },
        { "name": "StateProvince", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true }
      ]
    },
    { "name": "Rooms", "type": "Collection(Edm.ComplexType)",
      "fields": [
        { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
        { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
        { "name": "Type", "type": "Edm.String", "searchable": true },
        { "name": "BaseRate", "type": "Edm.Double", "filterable": true, "facetable": true },
        { "name": "BedOptions", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": false },
        { "name": "SleepsCount", "type": "Edm.Int32", "filterable": true, "facetable": true },
        { "name": "SmokingAllowed", "type": "Edm.Boolean", "filterable": true, "facetable": false},
        { "name": "Tags", "type": "Edm.Collection", "searchable": true }
      ]
    }
  ]
}
假如使用先前的結果集和上述索引結構描述,您有成功編製索引作業所需的所有元件。 壓平合併的資料集符合索引編製需求,但仍會保留詳細資訊。 在 Foundry IQ 索引中,搜尋結果可輕鬆歸入以飯店為基礎的實體,同時保留個別房間及其屬性的脈絡。
複雜類型子欄位上的 Facet 行為
具有父代的欄位 (例如位址和會議室底下的欄位) 稱為「子欄位」。 雖然您可以將「facetable」屬性指派給子欄位,但 Facet 計數一律是以主要文件為準。
對於像 Address 這類複雜類型,由於文件中只有一個「Address/City」或「Address/stateProvince」,Facet 行為會如預期運作。 不過,在 Rooms 的情況下,由於每個主要文件有多個子文件,Facet 計數可能會造成誤導。
如模型複雜類型中所述:「Facet 結果中所傳回的文件計數是針對父文件 (飯店) 計算而來,而不是複雜集合中的子文件 (房間)。 例如,假設飯店有 20 間類型為「套房」的房間。 假設此 Facet 參數為 facet=Rooms/Type,Facet 計數對旅館而言是 1,而不是對房間而言的 20。」
下一步
你可以用自己的資料集,使用 匯入資料 精靈 來建立並載入索引。 此精靈會偵測內嵌的 JSON 集合,例如 Rooms 內含的 JSON 集合,並推斷包含複雜類型集合的索引結構描述。
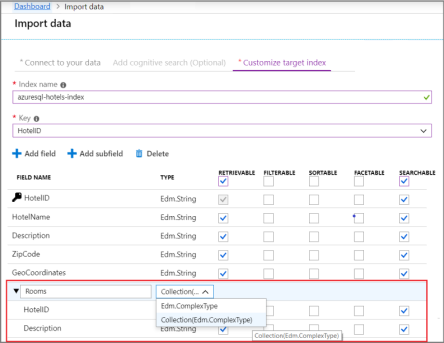
請試試以下快速入門,學習 匯入資料 精靈的基本步驟。