Note
Foundry IQ(Azure AI 搜尋服務)提供直接的索引與查詢 API,並搭配高階知識來源與知識庫 API 用於受控檢索。 使用 Azure 入口網站、REST API 或 Azure SDK 來設定這些功能,或將代理連線到 Microsoft Foundry 入口網站 中的知識庫。
重要
擴充快取目前為公開預覽,並受 Microsoft Azure 預覽版補充使用條款約束。
有關此功能專屬的預覽條款,請參閱 預覽功能。
本文說明如何在技能集流程中加入快取,讓您能在不必每次都完全重建的情況下,修改下游的資料豐富步驟。 擴充快取(預覽)需要使用 預覽版 REST API。 預設情況下,技能集是無狀態的,且更改其組合的任何部分都需要重新執行索引器。 使用 豐富快取時,索引器會根據技能組或索引器定義的變更,決定文件樹中哪些部分需要重新整理。 索引器會盡可能保存並重用現有處理過的輸出。
您可以使用自己提供的連接字串,將快取內容放在 Azure 儲存體中。 索引器執行時會建立這些物件。 請將擴充快取視為由您的 Foundry IQ(Azure AI 搜尋服務)服務所管理的內部元件,且不得修改。
重要
擴充快取不是技能輸出、索引子狀態或已編製索引文件的備份。 它不會追蹤哪些文件完成了處理。 對於大型資料來源,啟用快取前請先閱讀 限制 部分。
- 一個容器名為
ms-az-search-indexercache-<alpha-numeric-string> - 名為
MsAzSearchIndexerCacheIndex<alpha-numeric-string>的資料表
先決條件
僅適用於 blob 編製索引,如果您需要在從資料來源刪除 blob 時,同步從快取和索引中刪除文件,請在索引器中啟用 刪除原則。 沒有這項政策,快取中的文件刪除就不被支援。
你應該熟悉如何設定索引器和技能集。 先從 索引器概述 開始,然後繼續到 技能集,了解增強流程管道。
限制
注意事項
如果您使用 SharePoint 索引器,請避免增量豐富化。 在某些情況下,快取會失效。 要重新載入,請執行 索引器重置並完全重建。
大型資料來源還有額外的快取限制。
注意事項
對於大型資料來源,當出現長時間執行的技能、重複中斷或頻繁的技能失敗時,擴充快取可能會增加重新處理的總量。 索引器優先考量正確性而非最小化重處理,因此因反覆中斷而產生的快取積壓會放大重試行為。 這種行為是預期中的,不是錯誤。
為了從不斷增加的快取積壓中恢復,請將資料來源分割成較小的容器或虛擬資料夾。 然後使用指向同一索引的 平行索引器 。 要解除快取關聯,請在索引器上將屬性設 cache 為 null。 關於分割模式的指引,請參見 大型資料集索引 。
權限
Foundry IQ 身分識別需要具有 Azure 儲存體 的寫入權限:
- Storage Blob 資料貢獻者
- 儲存體資料表資料參與者
連接字串的語法決定使用系統指派或使用者指派的識別。 欲了解更多資訊,請參閱 使用受控識別連接到 Azure 儲存體。
設定快取屬性
此程序適用於新舊索引器。
在索引器的定義中,設 cache 為:
- (必備)
storageConnectionString設定為 Azure 儲存體 連接字串。 - (可選)
enableReprocessing(true預設情況下)。 將設定為false以暫時中止增量增強,隨後再切換回true。
在左側選擇 索引器。
選擇 新增索引器 以建立新的索引器,或在 JSON 編輯模式下開啟現有索引器。
啟用增量豐富功能,設定豐富快取的儲存體帳戶,然後儲存索引器設定。
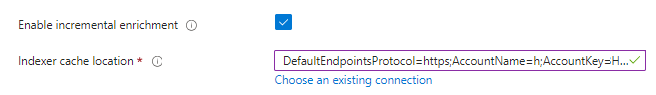
如果索引器已經存在,請重設它。
執行索引器。 這次一次性的完整重建會初始化快取。 載入後,後續執行會採用增量重用。