Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Observera
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Viktigt
Funktioner, funktioner eller egenskaper som har markerats (förhandsversion) omfattas inte av ett serviceavtal, rekommenderas inte för produktionsarbetsbelastningar och kan ändras eller begränsas innan de blir allmänt tillgängliga. Villkoren för Azure AI-sökning förhandsgranskning gäller för alla förhandsgranskningsfunktioner, oavsett om de är fristående eller en del av en allmänt tillgänglig funktion.
I Azure AI-sökning kan du använda ett filteruttryck för att lägga till inkluderings- eller exkluderingsvillkor i en vector-fråga. Du kan också ange ett filtreringsläge som tillämpar filtret:
- Före frågekörning, som kallas förfiltrering.
- Efter frågekörning, som kallas postfiltering.
- När de globala toppresultaten
khar identifierats kallas strikt postfiltering (förhandsversion).
Den här artikeln använder REST som illustration. Kodexempel på andra språk och lösningar från slutpunkt till slutpunkt som innehåller vektorfrågor finns i lagringsplatsen azure-search-vector-samples GitHub.
Du kan också använda Search Explorer i Azure-portalen för att fråga vektorinnehåll. I JSON-vyn kan du lägga till filter och ange filterläget.
Så här fungerar filtrering i vektorfrågor
Azure AI-sökning använder HNSW-algoritmen (Hierarchical Navigable Small World) för ann-sökning (Ungefärlig närmaste granne) och lagrar HNSW-grafer över flera shards. Varje shard innehåller en del av hela indexet.
Filter används för filterableicke-vektorfält, antingen stränga eller numeriska, för att inkludera eller exkludera sökdokument baserat på filtervillkor. Själva vektorfälten kan inte filtreras, men du kan använda filter på andra fält i samma index för att begränsa de dokument som beaktas vid vektorsökning. Om ditt index saknar lämplig text eller numeriska fält kontrollerar du om det finns dokumentmetadata som kan vara till hjälp vid filtrering, till exempel LastModified eller CreatedBy egenskaper.
Parametern vectorFilterMode styr var filteråtgärder tillämpas under sökfaserna, vilket påverkar hur resultaten filtreras till en delmängd av objekt (till exempel efter kategori, tagg eller andra attribut) och påverkar svarstid, återkallande och dataflöde. Det finns tre lägen:
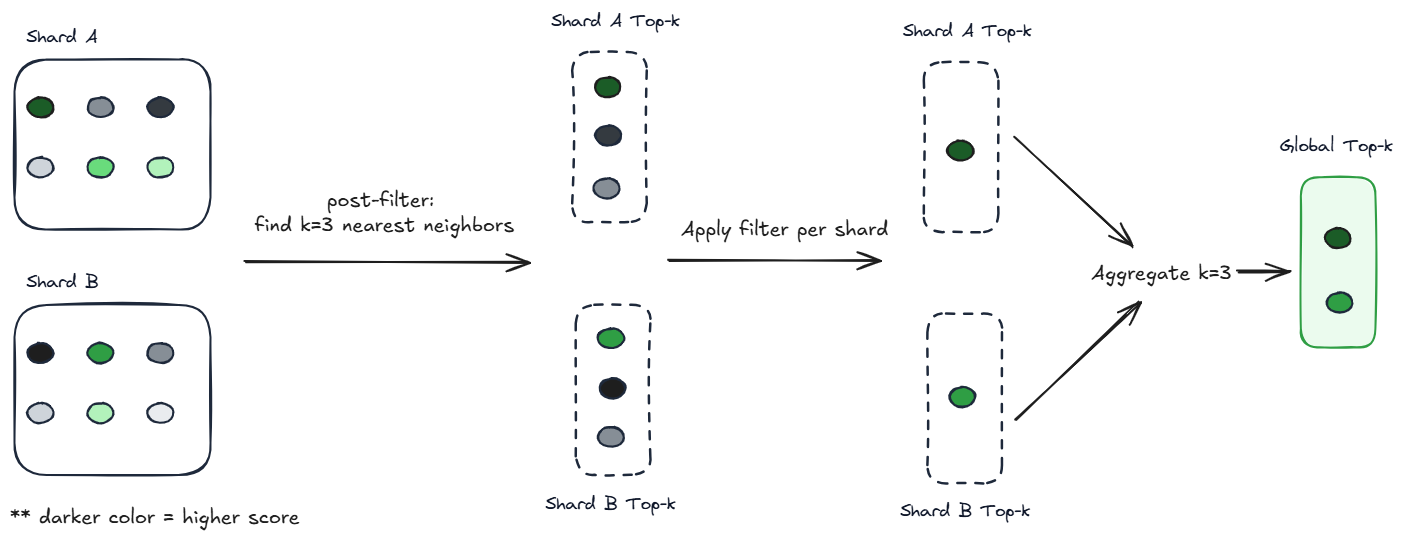
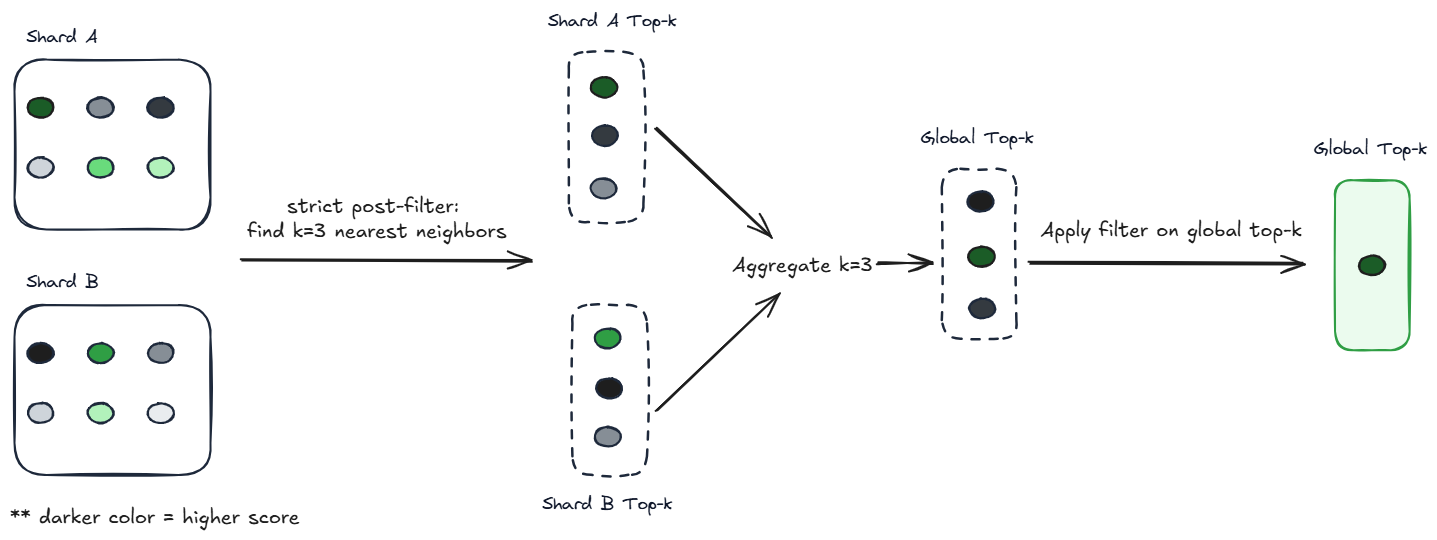
preFiltertillämpar filtret under HNSW-bläddering på varje shard. Det här läget maximerar återkallandet men kan gå igenom mer av grafen, vilket ökar processorn och svarstiden för mycket selektiva filter.postFilterkör HNSW-bläddring och filtrering på varje shard separat, korsar resultat på shardnivå och aggregerar sedan toppenkfrån varje shard till en global toppk. Det här läget kan skapa falska negativa värden för mycket selektiva filter eller småkvärden.strictPostFilter(förhandsversion) hittar den ofiltrerade globala toppenkinnan filtret används. Det här läget har den högsta risken att returnera falska negativa värden för mycket selektiva filter och småkvärden.
Mer information om dessa lägen finns i Ange filterläge.
Definiera ett filter
Filter bestämmer omfånget för vektorfrågor och definieras med Documents - Search Post (REST API). Om du inte vill använda en förhandsgranskningsfunktion använder du den senaste stabila versionen av REST-API:erna för söktjänsten för att formulera begäran.
Det här REST-API:et tillhandahåller:
-
filterför kriterierna. -
vectorFilterModeför att ange när filtret används under vektorfrågan. För lägen som stöds, se Ange filterläge.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
I det här exemplet riktar sig vektorbäddningen mot contentVector fältet och filtervillkoren gäller för categoryett filterbart textfält.
preFilter Eftersom läget används tillämpas filtret innan sökmotorn kör frågan, så endast dokument i Databases kategorin beaktas under vektorsökningen.
Ange filterläget
Parametern vectorFilterMode avgör när och hur filtret tillämpas i förhållande till körning av vektorfrågor. Du kan använda följande lägen:
-
preFilter(rekommenderas) postFilter-
strictPostFilter(förhandsversion)
Observera
preFilter är standardvärdet för index som skapats efter cirka 15 oktober 2023. För index som skapats före det här datumet postFilter är standardvärdet. Om du vill använda preFilter och andra avancerade vektorfunktioner, till exempel vektorkomprimering, måste du återskapa ditt index.
Du kan testa kompatibiliteten genom att skicka en vektorfråga med "vectorFilterMode": "preFilter" i 2023-10-01-preview REST API-versionen eller senare. Om frågan misslyckas, stöder ditt index inte preFilter.
Förfiltrering tillämpar filter före frågekörning, vilket minskar kandidatmängden för vektorsökningsalgoritmen. De överstak resultaten väljs sedan från den här filtrerade uppsättningen.
I en vektorfråga preFilter är standardläget eftersom det gynnar återkallande och kvalitet framför svarstid.
Så här fungerar det här läget
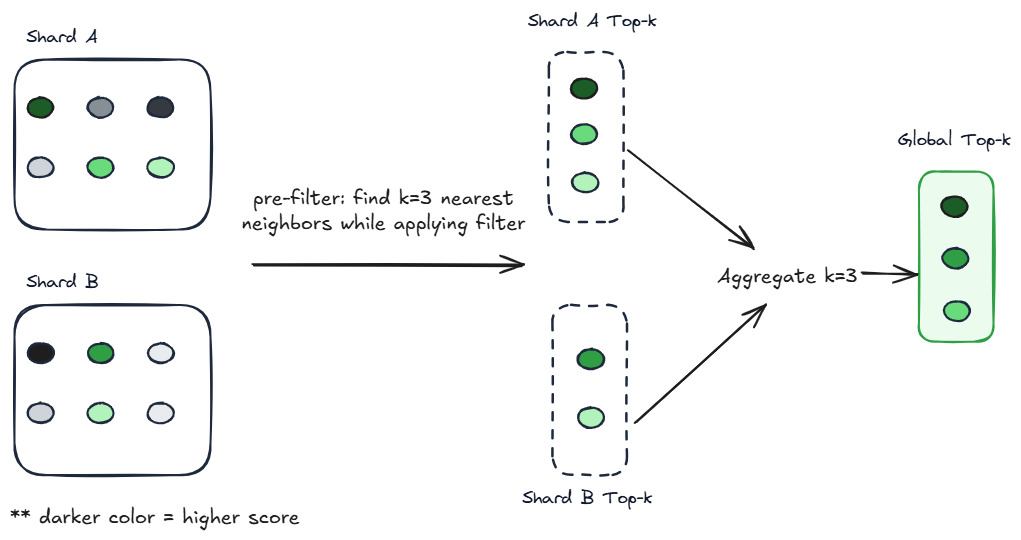
På varje fragment tillämpar du filterpredikatet under HNSW-traversering och expanderar grafen tills
kkandidater har hittats.Skapa de förfiltrerade lokala top-
k-resultaten per shard.Aggregera de filtrerade resultaten till en global toppresultatuppsättning
k.
Effekten av det här läget
Traversering expanderar sökytan för att hitta fler filtrerade kandidater, särskilt om filtret är selektivt. Detta ger de mest liknande toppresultatenk för alla shards. Varje shard identifierar de k resultat som uppfyller filterpredikatet.
Förfiltrering garanterar att k resultaten returneras om de finns i indexet. För mycket selektiva filter kan detta orsaka att en betydande del av grafen bläddras igenom, vilket ökar beräkningskostnaden och svarstiden samtidigt som dataflödet minskar. Om filtret är mycket selektivt (har mycket få matchningar) kan du överväga att använda exhaustive: true för att utföra fullständig sökning.
Jämförelsetabell
| Läge | Återkalla (filtrerade resultat) | Beräkningskostnad | Risk för falska negativa | När du ska använda |
|---|---|---|---|---|
preFilter |
Mycket hög | Högre (ökar med filterselektivitet och komplexitet) | Ingen risk |
Rekommenderad standard för alla scenarier, särskilt när återkallande är kritiskt (känsliga sökdomäner), när du använder selektiva filter eller när du använder små k. |
postFilter |
Medelhög till hög (minskar med filterselektivitet) | Liknar ofiltrerad men ökar med filterkomplexitet | Måttlig (kan missa matchningar per shard) | Ett alternativ för filter som inte är för selektiva och för mer avanceradek frågor. |
strictPostFilter |
Lägsta (minskar snabbast med filterselektivitet) | Liknar ofiltrerad | Högsta (kan returnera noll resultat för selektiva filter eller små k) |
Ett alternativ för fasettsökningar där fler resultat visas efter att filtret tillämpas påverkar användarupplevelsen mer än risken för falska negativ. Använd inte med liten k. |
Benchmark-testning av förfiltrering och postfilterering
Viktigt
Det här avsnittet gäller förfiltering och efterfiltrering, inte strikt efterfiltrering.
För att förstå under vilka förhållanden ett filterläge presterar bättre än det andra körde vi en serie tester för att utvärdera frågeresultat över små, medelstora och stora index.
- Små (100 000 dokument, 2,5 GB index, 1 536 dimensioner)
- Medel (1 miljon dokument, 25 GB index, 1 536 dimensioner)
- Stort (1 miljard dokument, 1,9 TB index, 96 dimensioner)
För de små och medelstora arbetsbelastningarna använde vi en Standard 2-tjänst (S2) med en partition och en replik. För den stora arbetsbelastningen använde vi en Standard 3-tjänst (S3) med 12 partitioner och en replik.
Index hade en identisk konstruktion: ett nyckelfält, ett vektorfält, ett textfält och ett numeriskt filterbart fält. Följande index definieras med hjälp av syntaxen 2023-11-01 .
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
I frågor använde vi ett identiskt filter för både förfilter- och postfilteråtgärder. Vi använde ett enkelt filter för att säkerställa att variationer i prestanda berodde på filtreringsläge, inte på att filtrera komplexitet.
Utfall mättes i frågor per sekund (QPS).
Slutsatser
Förfiltrering är nästan alltid långsammare än efterfiltrering, förutom för små index där prestandan är ungefär lika med.
För större datamängder är förfiltrering betydligt mycket långsammare.
Varför är förfilter standardvärdet om det nästan alltid är långsammare? Förfiltrering garanterar att
kresultaten returneras om de finns i indexet, där biasen gynnar återkallande och precision framför hastighet.Använd postfilter om du:
Prioritera hastighet över val (postfiltrering kan returnera färre än
kresultat).Använd filter som inte är alltför selektiva.
Ha indexer av tillräcklig storlek så att prestandan för förfiltrering är oacceptabel.
Detaljer
Givet en datamängd med 100 000 vektorer med 1 536 dimensioner:
Vid filtrering av mer än 30% av datamängden var förfiltrering och postfiltrering jämförbara.
Vid filtrering av mindre än 0,1% av datamängden var förfiltreringen cirka 50% långsammare än efterfiltrering.
Givet en datamängd med 1 miljon vektorer vid 1 536 dimensioner:
Vid filtrering av mer än 30% av datamängden var förfiltreringen cirka 30% långsammare.
Vid filtrering av mindre än 2% av datamängden var förfiltrering ungefär sju gånger långsammare.
Givet en datamängd med 1 miljard vektorer vid 96 dimensioner:
Vid filtrering av mer än 5% av datamängden var förfiltreringen cirka 50% långsammare.
Vid filtrering av mindre än 10% av datamängden var förfiltrering ungefär sju gånger långsammare.
Följande diagram visar förfilterrelativ QPS, beräknad som förfilter-QPS dividerat med postfilter-QPS.
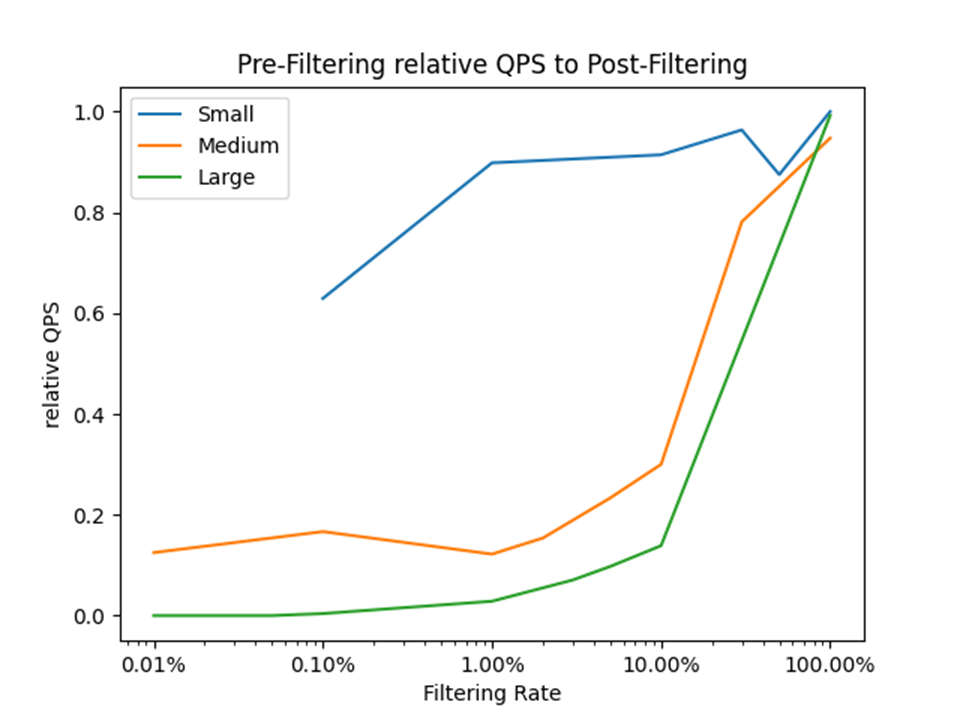
Den lodräta axeln representerar den relativa prestandan för förfiltrering jämfört med postfilter, uttryckt som ett förhållande mellan QPS (frågor per sekund). Till exempel:
- Värdet
0.0för innebär att förfiltrering är 100% långsammare än efterfiltrering. - Värdet
0.5för innebär att förfiltrering är 50% långsammare. - Värdet
1.0för innebär att förfiltrering och efterfiltrering är likvärdiga.
Den vågräta axeln representerar filtreringshastigheten eller procentandelen kandidatdokument efter att filtret har tillämpats. Till exempel innebär en andel 1.00% att filtervillkoren har valt en procent av sökkorpus.