Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Kommentar
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Ett program med flera klienter är ett program som tillhandahåller samma tjänster och funktioner till valfritt antal klienter som inte kan se eller dela data från någon annan klientorganisation. I den här artikeln beskrivs strategier för klientisolering för program med flera klienter som skapats med Azure AI-sökning.
Azure AI-sökning begrepp
Som en sök-som-en-tjänst-lösning gör Azure AI-sökning det möjligt för utvecklare att lägga till omfattande sökupplevelser i program utan att hantera någon infrastruktur eller bli expert på informationshämtning. Data laddas upp till tjänsten och lagras sedan i molnet. Med hjälp av enkla begäranden till Azure AI-sökning-API:et kan data sedan ändras och sökas igenom.
tjänsten Search, index, fält och dokument
Innan du diskuterar designmönster är det viktigt att förstå några grundläggande begrepp.
En Azure AI-sökning tjänst innehåller ett eller flera index. Varje index är en oberoende sökbar datastruktur med ett eget schema. Indexschemat definierar fälten och sökbeteendena för innehållet. Du läser in data i ett index som dokument som överensstämmer med indexets schema.
Indexerings- och frågeåtgärder riktar sig mot ett enda index. När ett program skickar en fråga söker Azure AI-sökning igenom det valda indexet och returnerar matchande dokument. Schemat använder de fältdatatyper som stöds av Azure AI-sökning. När klienter delar ett index måste deras dokument passa samma schema.
Skalbarhet och tjänsthanterad partitionering
I prismodellen Dedikerad skalas en Azure AI-sökning-tjänst i två dimensioner:
- Lägg till partitioner för att öka lagrings- och indexeringskapaciteten.
- Lägg till repliker för att öka frågedataflödet och tillgängligheten.
Azure AI-sökning distribuerar dokumenten i varje index över flera tjänstpartitioner. Tjänstpartitioner är kapacitetsenheter, inte gränser för tenantisolering. Du anger ingen anpassad partitionsnyckel eller styr placeringen av dokument på tjänstpartitioner. När du lägger till partitioner eller repliker ändrar du kapaciteten för hela tjänsten, som delas av alla index i den tjänsten.
Välj en prisnivå och kapacitet baserat på beräknad total lagring och lagring per klientorganisation, indexering och frågearbetsbelastningar. Nivån fastställer tjänst-, index-, dokument- och lagringsgränser. Mer information finns i Uppskatta och hantera kapacitet och Tjänstgränser i Azure AI-sökning.
För att en dedikerad tjänst ska kvalificera sig för tillgänglighets-SLA konfigurerar du minst två repliker för endast frågearbetsbelastningar eller tre repliker för arbetsbelastningar som inkluderar indexering. Partitioner påverkar inte berättigande till SLA.
Kommentar
Vägledningen för partitioner och repliker i den här artikeln gäller för den dedikerade prismodellen. Nivån Serverless Developer är i förhandsversion och hanterar kapaciteten automatiskt. Det tillhandahåller ingen SLA och rekommenderas inte för produktionsarbetsbelastningar.
Tjänst- och indexgränser i Azure AI-sökning
Azure AI-sökning erbjuder flera prisnivåer, med olika gränser och kvoter. Vissa gränser gäller för tjänsten, medan andra gäller för index eller partitioner.
S3 hög densitet
Standard 3 High Density (S3 HD) är ett värdbaseringsläge som lämpar sig för flerinnehavarscenarier som kräver många små index i en söktjänst. Det kan minska kostnaden per klientorganisation och den driftmässiga overheaden när en index-per-klientmodell hanterar ett stort antal mindre klienter.
S3 HD stöder betydligt fler index än andra dedikerade nivåer. Om du lägger till partitioner ökar antalet index som tjänsten kan hantera, men varje index har en fast maximal storlek. Granska de aktuella gränserna för S3 HD-index, funktion och indexerare innan du väljer det här läget. Mer information finns i Service-gränser i Azure AI-sökning.
Överväganden för program med flera klienter
Program med flera klienter måste effektivt distribuera resurser mellan klientorganisationer samtidigt som en viss sekretessnivå bevaras mellan de olika klientorganisationer. Det finns några saker att tänka på när du utformar arkitekturen för ett sådant program:
Klientisolering: Programutvecklare måste vidta lämpliga åtgärder för att säkerställa att inga klienter har obehörig eller oönskad åtkomst till andra klientorganisationers data. Utöver datasekretessen kräver strategier för klientisolering effektiv hantering av delade resurser och skydd från bullriga grannar.
Molnresurskostnad: Precis som med andra program måste programvarulösningar förbli kostnadskonkurrerande som en komponent i ett program med flera klientorganisationer.
Enkel användning: När du utvecklar en arkitektur för flera klienter är det viktigt att tänka på hur programmet fungerar och hur komplext det är. Azure AI-sökning har ett serviceavtal på 99,9 %.
Globalt fotavtryck: Program med flera klienter behöver ofta hantera klienter som är distribuerade över hela världen. Planera hur regional placering, datasynkronisering och routning av begäranden påverkar varje hyresgästmodell. Mer information finns i Distributioner i flera regioner i Azure AI-sökning.
Skalbarhet: Programutvecklare måste överväga hur de ska stämma av mellan att upprätthålla en tillräckligt låg nivå av programkomplexitet och att utforma programmet för skalning med antalet klienter och storleken på klientorganisationens data och arbetsbelastning.
Azure AI-sökning erbjuder några begränsningar som kan användas för att isolera hyresgästers data och arbetsbelastning.
Modellering av flera hyresgäster med Azure AI-sökning
I ett scenario med flera klienter använder programutvecklaren en eller flera söktjänster och delar upp sina klienter mellan tjänster, index eller båda. Azure AI-sökning har några vanliga mönster när du modellerar ett scenario med flera klientorganisationer:
Ett index per klientorganisation: Varje klientorganisation har ett eget index i en söktjänst som delas med andra klienter.
En tjänst per klientorganisation: Varje klientorganisation har sin egen dedikerade Azure AI-sökning-tjänst, vilka ger högsta nivå av data- och arbetsbelastningsavgränsning.
Blandning av båda: Större, mer aktiva klienter tilldelas dedikerade tjänster medan mindre klienter tilldelas enskilda index inom delade tjänster.
Ett index för flera klienter: Flera klienter delar ett index, och varje dokument innehåller en klientidentifierare som programmet använder för att filtrera resultat.
Modell 1: Ett index per klientorganisation
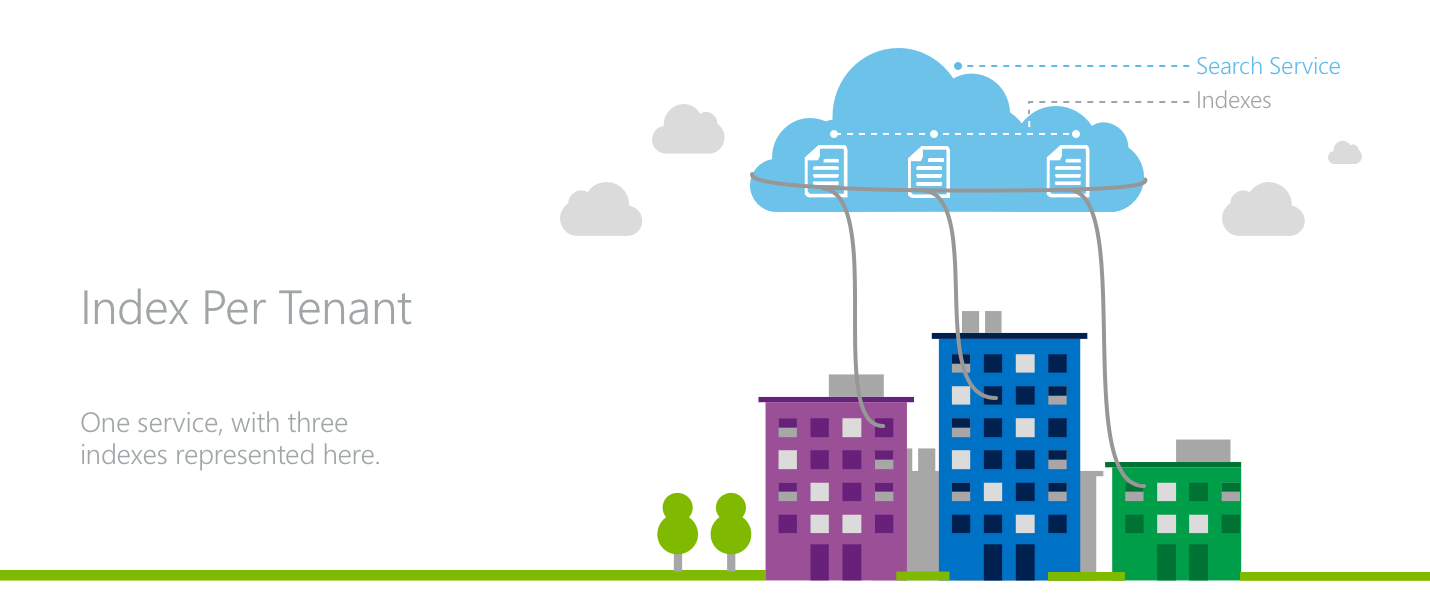
Diagrammet är märkt index per tenant. Tre hyreshus visas på den nedre halvan av bilden. En delad söktjänst visas ovanför dem och innehåller tre index. En separat anslutning sträcker sig från varje index till en klientbyggnad: det vänstra indexet ansluter till den vänstra klientbyggnaden, det mittersta indexet ansluter till den mittersta klientbyggnaden och det högra indexet ansluter till den högra klientbyggnaden. En förklaring i det övre högra hörnet anger att det yttre molnet är söktjänsten och att de tre dokumentsymbolerna i det är index.
I en index-per-hyresgästmodell delar flera hyresgäster på en enda Azure AI-sökning-tjänst där varje hyresgäst har ett eget index.
Alla sökbegäranden och dokumentåtgärder riktar sig mot ett index. Indexnamnet i en begäran är dock inte en auktoriseringsgräns. Om klienter ansluter direkt till Azure AI-sökning, ska du använda indexbegränsade roller för att begränsa varje klient till sitt eget index. Annars dirigerar du begäranden via ett betrott applikationsskikt som härleder klientorganisationens index från den autentiserade kontexten och förhindrar anropare från att välja en annan klientorganisations index. Ge inte hyresgäster API-nycklar för en delad tjänst eftersom API-nycklar beviljar åtkomst på tjänstnivå.
Ett nyckelattribut för index-per-klient-modellen är möjligheten för programutvecklaren att överprenumerera kapaciteten för en söktjänst bland programmets klientorganisationer. Om klientorganisationer har en ojämn fördelning av arbetsbelastningen kan den optimala kombinationen av klienter distribueras över en söktjänsts index för att hantera ett antal mycket aktiva, resursintensiva klientorganisationer samtidigt som de betjänar en lång svans av mindre aktiva klienter. Kompromissen är modellens oförmåga att hantera situationer där varje klientorganisation samtidigt är mycket aktiv.
Index-per-tenant-modellen utgör grunden för en variabel kostnadsmodell, där en hel Azure AI-tjänsten Search köps i förväg och sedan fylls med klienter. Detta gör att outnyttjad kapacitet kan tilldelas för utvärderingsversioner och kostnadsfria konton.
För program med ett globalt fotavtryck är index-per-klient-modellen kanske inte den mest effektiva. Om ett programs hyresgäster distribueras över hela världen kan du behöva en separat delad tjänstefunktion i varje region, som duplicerar kapacitet och ökar driftkomplexiteten. Mer information finns i Distributioner i flera regioner i Azure AI-sökning.
Med Azure AI-sökning kan både de enskilda indexen och det totala antalet index växa. Om en lämplig prisnivå väljs kan partitioner och repliker läggas till i hela söktjänsten när ett enskilt index i tjänsten blir för stort när det gäller lagring eller trafik.
Om det totala antalet index växer för stort för en enskild tjänst måste en annan tjänst etableras för att rymma de nya klienterna. Om index måste flyttas mellan söktjänster när nya tjänster läggs till måste data från indexet kopieras manuellt från ett index till ett annat eftersom Azure AI-sökning inte tillåter att ett index flyttas.
Modell 2: En tjänst per klientorganisation
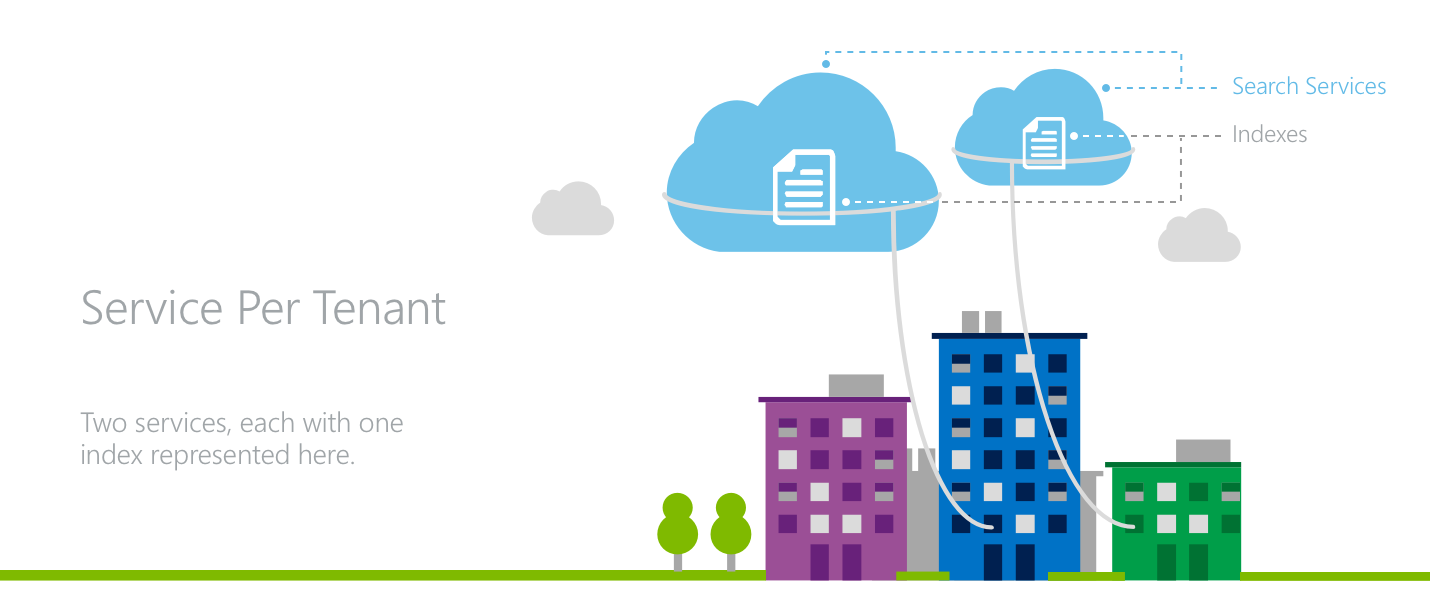
Diagrammet är märkt "Service Per Tenant". Tre hyreshus visas på den nedre halvan av bilden. Två söktjänster visas ovanför dem och varje tjänst innehåller ett index. En anslutning sträcker sig från den vänstra söktjänsten till den vänstra klientbyggnaden. Två anslutningar sträcker sig från den högra söktjänsten: en till den centrala hyresgästbyggnaden och en till den högra hyresgästbyggnaden. En förklaring i det övre högra hörnet identifierar molnen som söktjänster och dokumentsymbolerna i dem som index.
I en tjänst-per-klient-arkitektur har varje klientorganisation en egen söktjänst.
I den här modellen uppnår programmet maximal isoleringsnivå för sina klienter. Varje tjänst har dedikerad lagring och dataflöde för hantering av sökbegäranden. Använd Microsoft Entra autentisering och rollbaserad åtkomstkontroll för att auktorisera programkomponenter och operatorer. Om tenantanvändare får åtkomst till sökning via ett applikationsskikt behåller du autentiseringsuppgifterna för tjänsten i det skiktet och tillämpar routning från tenant till tjänst där. API-nycklar ger åtkomst på tjänstnivå och är inte hyresgästmedvetna auktoriseringsgränser.
Varje söktjänst räknas in i tjänstgränsen för dess nivå, prenumeration och region. Innan du inför den här modellen i stor skala bör du beräkna det antal tjänster som krävs och planera för kvotökningar, regional distribution eller flera Azure-prenumerationer.
För program där varje klientorganisation har ett stort fotavtryck eller arbetsbelastningen har liten variabilitet från klientorganisation till klient är modellen för tjänst per klient ett effektivt val eftersom resurser inte delas mellan olika klientorganisationers arbetsbelastningar.
En tjänst per hyresgästmodell erbjuder också fördelen med en förutsägbar, fast kostnadsmodell. Ingen förskottsinvestering krävs för en hel söktjänst förrän det finns en hyresgäst som kan fylla den, men kostnaden per hyresgäst är högre än en index-per-hyresgästmodell.
Tjänst-per-klient-modellen kan stödja applikationer med ett globalt fotavtryck eftersom varje klients tjänst kan placeras i en region som är lämplig för den klientorganisationen. En söktjänst är en resurs för en region, så använd separata regionala installationer om du också behöver motståndskraft mot ett regionalt avbrott. Mer information finns i Distributioner i flera regioner i Azure AI-sökning.
Utmaningarna med att skala det här mönstret uppstår när enskilda klientorganisationer utökar sin tjänst. Befintliga tjänster kan växla mellan nivåerna Basic och Standard S1, S2 och S3 om den aktuella konfigurationen passar inom målnivåns gränser och regionen har kapacitet. Om du vill flytta till en annan nivå skapar du en ny tjänst och läser in indexinnehållet på nytt eller kopierar det. Mer information finns i Ändra prisnivå.
Modell 3: Hybrid
Ett annat mönster för modellering av flera klientorganisationer är att blanda strategier för både index per klientorganisation och tjänst per klientorganisation.
Genom att kombinera de två mönstren kan en applikations största hyresgäster uppta dedikerade tjänster medan långsvansen av mindre aktiva, mindre hyresgäster kan dela utrymme i delade tjänster. Den här modellen säkerställer att större hyresgäster har stadig hög prestanda från tjänsten och samtidigt skyddar de mindre hyresgäster från eventuella bullriga grannar.
Implementeringen av den här strategin bygger dock på framsynthet när det gäller att förutsäga vilka klienter som kräver en dedikerad tjänst jämfört med ett index i en delad tjänst. Programkomplexiteten ökar med behovet av att hantera båda dessa multitenancy-modeller.
Underhåll en tenantplaceringskatalog som mappar varje tenant till sin söktjänst och sitt index. Använd katalogen för att dirigera begäranden och automatisera tjänst- och indexetablering. När du flyttar en klientorganisation samordnar du uppdateringar för datasynkronisering och routning och planerar hur inaktuella mappningar, misslyckade övergångar och återställning ska hanteras.
Modell 4: Ett index för flera hyresgäster
I en modell för delat index använder dokument från flera klienter samma index och schema. Den här modellen har den högsta hyresgästdensiteten, men den erbjuder mindre data- och prestandaisolering än de andra modellerna. Alla klientorganisationer delar indexkapacitet, schema och relevansbedömningsbeteende.
Om du vill isolera hyresgäster inom ett index lägger du till ett filterbart fält som identifierar den hyresgäst som äger varje dokument. Ett betrott programlager måste härleda tenantidentifieraren från autentiserad kontext och tillämpa motsvarande filter på varje fråga. Acceptera inte ett tenant-ID som tillhandahålls av en klient som inte är betrodd. För dokumentuppladdningar, uppdateringar och borttagningar kontrollerar du att åtgärden är auktoriserad för dokumentets tenant. Mer information finns i Säkerhetsfilter för att trimma resultat.
Använd den här modellen när tenanttäthet och kostnadseffektivitet är viktigare än tenantspecifika scheman eller stark arbetsbelastningsisolering, och när programmet på ett tillförlitligt sätt kan framtvinga tenantfilter för varje åtgärd.
Kommentar
När flera klienter delar ett index kan dokument från andra klienter påverka relevanspoängen eftersom bedömningsstatistiken inte är klientspecifik. Mer information finns i Relevans i nyckelordssökning.
Nästa steg
Azure AI-sökning är ett övertygande val för många program. När du utvärderar de olika designmönstren för program med flera klienter bör du överväga de olika prisnivåerna och respektive tjänstgränser för att skräddarsy Azure AI-sökning så att de passar programarbetsbelastningar och arkitekturer i alla storlekar.
Läs den här artikeln tillsammans med arkitekturmetoder för lagring och data i flerklientlösningar, som beskriver allmänna överväganden och metoder som gäller för datatjänster.