Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Note
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Important
Dessa funktioner stöder anslutningar till andra Microsoft-tjänster och tjänster från tredje part. Användningen av dessa tjänster omfattas av deras respektive villkor och kan resultera i databearbetning eller lagring utanför Azure efterlevnadsgräns, samt data som flödar till Azure efterlevnadsgräns.
Det är ditt ansvar att hantera om dina data kommer att flöda utanför organisationens efterlevnad och geografiska gränser och eventuella relaterade konsekvenser, och att lämpliga behörigheter, gränser och godkännanden etableras.
Du ansvarar för att noggrant granska och testa program som du skapar i samband med dina specifika användningsfall och fatta alla lämpliga beslut och anpassningar. Detta omfattar implementering av dina egna ansvarsfulla AI-åtgärder, till exempel metaprompter, innehållsfilter eller andra säkerhetssystem, och att se till att dina program uppfyller lämpliga kvalitets-, tillförlitlighets-, säkerhets- och tillförlitlighetsstandarder. Mer information finns i Azure AI-sökning Transparency Note.
Tips
Den här artikeln är avsedd för befintliga pipelines som använder Document Layout-färdigheten. För nya kompetensuppsättningar använder du kompetensen Azure Content Understanding. Den här färdigheten ger nyare funktioner, till exempel semantisk segmentering, AI-genererade bildbeskrivningar och förbättrad extrahering av dokumentinbäddade tabeller i en enda färdighet. Mer information finns i Segmentera och vektorisera innehåll med färdigheten Azure Content Understanding.
Strategier för segmentering av textdata spelar en viktig roll för att optimera RAG-svar och prestanda. Med hjälp av skickligheten Dokumentlayout kan du segmentera innehåll baserat på dokumentstruktur, samla in rubriker och segmentera innehållstexten baserat på semantisk sammanhållning, till exempel stycken och meningar. Delar bearbetas oberoende. Eftersom LLM:er fungerar med flera segment, när dessa segment är av högre kvalitet och semantiskt sammanhängande, förbättras frågans övergripande relevans.
Färdigheten för dokumentlayout i Foundry Tools anropar layoutmodellen från Azure Document Intelligence. Modellen artikulerar innehållsstrukturen i JSON med markdown-syntax (rubriker och innehåll), med fält för rubriker och innehåll som lagras i ett sökindex i Azure AI-sökning. Det sökbara innehållet som skapas från skickligheten Dokumentlayout är oformaterad text, men du kan använda integrerad vektorisering för att generera inbäddningar för alla fält i källdokumenten, inklusive bilder.
I den här artikeln lär du dig att:
- Använd kunskaper i dokumentlayout för att identifiera dokumentstrukturen
- Använd färdigheten Textdelning för att begränsa segmentstorleken till varje Markdown-avsnitt
- Generera inbäddningar för varje segment
- Använda indexprojektioner för att mappa inbäddningar till fält i ett sökindex
I illustrationssyfte använder den här artikeln exempel på hälsoplans-PDF:er som laddats upp till Azure Blob Storage och sedan indexerats med hjälp av guiden Importera data .
Förutsättningar
En indexerarbaserad indexeringspipeline med ett index som accepterar utdata. Indexet måste ha fält för att ta emot rubriker och innehåll.
En indexprognos för en-till-många-indexering.
En kompatibel datakälla med textinnehåll som du vill dela upp.
En kompetensuppsättning med dessa två färdigheter:
Kunskaper i dokumentlayout som delar upp dokument baserat på styckegränser. Om du använder nyckelbaserad fakturering, krävs det att Microsoft Foundry finns i samma region som Azure AI-sökning för AI-berikning. Regionkraven är avslappnade för nyckellös fakturering.
Azure OpenAI-inbäddningsfärdighet som genererar vektorinbäddningar. Den här färdigheten har inte regionkrav.
Förbereda datafiler
Du måste använda en datakälla som stöds för råindata, och filen måste vara i ett format som stöds av färdigheten Dokumentlayout.
Filformat som stöds är PDF, JPEG, JPG, PNG, BMP, TIFF, DOCX, XLSX, PPTX och HTML.
Indexerare som stöds är alla indexerare som kan hantera filformat som stöds. Dessa indexerare inkluderar Blob-indexerare, Microsoft OneLake-indexerare och Filindexerare (förhandsversion).
Regioner som stöds för portalfunktionen av denna funktion inkluderar Östra USA, Västra Europa och Norra Centrala USA. Om du konfigurerar din kompetensuppsättning programmatiskt kan du använda valfri Azure Document Intelligence-region som även tillhandahåller AI-berikandefunktionen i Azure AI-sökning. För mer information, se Regioner som stöds för funktionen Dokumentlayout.
Du kan använda Azure Portal, REST API:er eller ett Azure SDKs-paket för att skapa en datakälla.
Tips
Om du vill prova kunskaper om dokumentlayout och strukturmedveten segmentering i din egen söktjänst laddar du upp PDF-exempelfilerna för hälsoplan till din datakälla som stöds. Guiden Importera data är en enkel kodfri metod för att testa den här färdigheten. Se till att välja standardparsningsläget för att använda strukturmedveten segmentering. Annars används Markdown-parsningsläget .
Skapa ett index för en-till-många-indexering
I följande exempel visas ett enda sökdokument som är utformat runt segment. När du arbetar med segment behöver du ett segmentfält och ett överordnat fält som identifierar segmentets ursprung. I det här exemplet är överordnade fält fälten text_parent_id . Underordnade fält är vektor- och icke-vektorsegmenten i Markdown-avsnittet.
Färdigheten Dokumentlayout levererar rubriker och innehåll. I det här exemplet lagrar header_1 genom header_3 dokumentrubriker, som identifieras av funktionen. Annat innehåll, till exempel stycken, lagras i chunk. Fältet text_vector är en vektorrepresentation av segmentfältinnehållet.
Du kan använda guiden Importera data i Azure-portalen, REST-API:er eller en Azure SDKs för att skapa ett index. Följande index liknar det som guiden skapar som en standardinställning. Du kan ha fler fält om du lägger till bildvektorisering.
Om du inte använder guiden måste indexet finnas i söktjänsten innan du skapar kunskapsuppsättningen eller kör indexeraren.
{
  "name": "my_consolidated_index",
  "fields": [
    {
      "name": "chunk_id",
      "type": "Edm.String",
      "searchable": true,
      "filterable": false,
      "retrievable": true,
      "stored": true,
      "sortable": true,
      "facetable": false,
      "key": true,
      "analyzer": "keyword"
    },
    {
      "name": "text_parent_id",
      "type": "Edm.String",
      "searchable": false,
      "filterable": true,
      "retrievable": true,
      "stored": true,
      "sortable": false,
      "facetable": false,
      "key": false
    },
    {
      "name": "chunk",
      "type": "Edm.String",
      "searchable": true,
      "filterable": false,
      "retrievable": true,
      "stored": true,
      "sortable": false,
      "facetable": false,
      "key": false
    },
    {
      "name": "title",
      "type": "Edm.String",
      "searchable": true,
      "filterable": false,
      "retrievable": true,
      "stored": true,
      "sortable": false,
      "facetable": false,
      "key": false
    },
    {
      "name": "header_1",
      "type": "Edm.String",
      "searchable": true,
      "filterable": false,
      "retrievable": true,
      "stored": true,
      "sortable": false,
      "facetable": false,
      "key": false
    },
    {
      "name": "header_2",
      "type": "Edm.String",
      "searchable": true,
      "filterable": false,
      "retrievable": true,
      "stored": true,
      "sortable": false,
      "facetable": false,
      "key": false
    },
    {
      "name": "header_3",
      "type": "Edm.String",
      "searchable": true,
      "filterable": false,
      "retrievable": true,
      "stored": true,
      "sortable": false,
      "facetable": false,
      "key": false
    },
    {
      "name": "text_vector",
      "type": "Collection(Edm.Single)",
      "searchable": true,
      "filterable": false,
      "retrievable": true,
      "stored": true,
      "sortable": false,
      "facetable": false,
      "key": false,
      "dimensions": 1536,
      "stored": false,
      "vectorSearchProfile": "profile"
    }
  ],
  "vectorSearch": {
    "profiles": [
      {
        "name": "profile",
        "algorithm": "algorithm"
      }
    ],
    "algorithms": [
      {
        "name": "algorithm",
        "kind": "hnsw"
      }
    ]
  }
}
Definiera en kompetensuppsättning för strukturmedveten segmentering och vektorisering
I följande exempel visas en kompetensuppsättningsdefinition som projicerar enskilda Markdown-avsnitt, segment och deras vektorekvivalenter som fält i sökindexet. Den använder färdigheten Dokumentlayout för att identifiera rubriker och fylla i ett innehållsfält baserat på semantiskt sammanhängande stycken och meningar i källdokumentet. Den använder färdigheten Textdelning för att dela upp Markdown-innehållet i segment. Den använder Azure OpenAI-inbäddningsfärdigheten för att vektorisera segment och andra fält som du vill ha inbäddningar för.
Förutom färdigheter innehåller kompetensuppsättningen indexProjections och cognitiveServices.
indexProjectionsanvänds för index som innehåller segmenterade dokument. Projektionerna anger hur föräldra-barn-innehåll kopplas till fält i ett sökindex för en-till-många-indexering. Mer information finns i Definiera en indexprojektion.cognitiveServicesansluter en Microsoft Foundry-resurs i faktureringssyfte. Kunskapen "Document Layout" är tillgänglig genom Standardprissättning.
POST {endpoint}/skillsets?api-version=2026-04-01

{
  "name": "my_skillset",
  "description": "A skillset for structure-aware chunking and vectorization with an index projection around markdown section",
  "skills": [
    {
      "@odata.type": "#Microsoft.Skills.Util.DocumentIntelligenceLayoutSkill",
      "name": "my_document_intelligence_layout_skill",
      "context": "/document",
      "outputMode": "oneToMany",
      "inputs": [
        {
          "name": "file_data",
          "source": "/document/file_data"
        }
      ],
      "outputs": [
        {
          "name": "markdown_document",
          "targetName": "markdownDocument"
        }
      ],
      "markdownHeaderDepth": "h3"
    },
    {
      "@odata.type": "#Microsoft.Skills.Text.SplitSkill",
      "name": "my_markdown_section_split_skill",
      "description": "A skill that splits text into chunks",
      "context": "/document/markdownDocument/*",
      "inputs": [
        {
          "name": "text",
          "source": "/document/markdownDocument/*/content",
          "inputs": []
        }
      ],
      "outputs": [
        {
          "name": "textItems",
          "targetName": "pages"
        }
      ],
      "defaultLanguageCode": "en",
      "textSplitMode": "pages",
      "maximumPageLength": 2000,
      "pageOverlapLength": 500,
      "unit": "characters"
    },
    {
      "@odata.type": "#Microsoft.Skills.Text.AzureOpenAIEmbeddingSkill",
      "name": "my_azure_openai_embedding_skill",
      "context": "/document/markdownDocument/*/pages/*",
      "inputs": [
        {
          "name": "text",
          "source": "/document/markdownDocument/*/pages/*",
          "inputs": []
        }
      ],
      "outputs": [
        {
          "name": "embedding",
          "targetName": "text_vector"
        }
      ],
      "resourceUri": "https://<subdomain>.openai.azure.com",
      "deploymentId": "text-embedding-3-small",
      "apiKey": "<Azure OpenAI api key>",
      "modelName": "text-embedding-3-small"
    }
  ],
  "cognitiveServices": {
    "@odata.type": "#Microsoft.Azure.Search.CognitiveServicesByKey",
    "key": "<Cognitive Services api key>"
  },
  "indexProjections": {
    "selectors": [
      {
        "targetIndexName": "my_consolidated_index",
        "parentKeyFieldName": "text_parent_id",
        "sourceContext": "/document/markdownDocument/*/pages/*",
        "mappings": [
          {
            "name": "text_vector",
            "source": "/document/markdownDocument/*/pages/*/text_vector"
          },
          {
            "name": "chunk",
            "source": "/document/markdownDocument/*/pages/*"
          },
          {
            "name": "title",
            "source": "/document/title"
          },
          {
            "name": "header_1",
            "source": "/document/markdownDocument/*/sections/h1"
          },
          {
            "name": "header_2",
            "source": "/document/markdownDocument/*/sections/h2"
          },
          {
            "name": "header_3",
            "source": "/document/markdownDocument/*/sections/h3"
          }
        ]
      }
    ],
    "parameters": {
      "projectionMode": "skipIndexingParentDocuments"
    }
  }
}
Konfigurera och köra indexeraren
När du har skapat en datakälla, ett index och en kunskapsuppsättning skapar och kör du indexeraren. Sätter igång pipelinen för körning.
När du använder färdigheten Dokumentlayout anger du följande parametrar för indexerarens definition:
- Ange parametern
allowSkillsetToReadFileDatatilltrue. - Ange parametern
parsingModetilldefault.
Du behöver inte ange outputFieldMappings i det här scenariot eftersom indexProjections du hanterar källfältet för att söka efter fältassociationer. Indexprojektioner hanterar fältassociationer för kunskaper i dokumentlayout och även regelbunden segmentering med delningsfärdighet för importerade och vektoriserade dataarbetsbelastningar. Du behöver fortfarande utdatafältmappningar för transformeringar eller komplexa datamappningar med funktioner som gäller i andra fall. Men för n-segment per dokument hanterar indexprojektioner den här funktionen internt.
Här är ett exempel på en begäran om att skapa indexerare.
POST {endpoint}/indexers?api-version=2026-04-01

{
  "name": "my_indexer",
  "dataSourceName": "my_blob_datasource",
  "targetIndexName": "my_consolidated_index",
  "skillsetName": "my_skillset",
  "parameters": {
    "batchSize": 1,
    "configuration": {
        "dataToExtract": "contentAndMetadata",
        "parsingMode": "default",
        "allowSkillsetToReadFileData": true
    }
  },
  "fieldMappings": [
    {
      "sourceFieldName": "metadata_storage_path",
      "targetFieldName": "title"
    }
  ],
  "outputFieldMappings": []
}
När du skickar begäran till söktjänsten körs indexeraren.
Verifiera resultat
Du kan köra frågor mot ditt sökindex när bearbetningen har slutförts för att testa lösningen.
Kontrollera resultatet genom att köra en fråga mot indexet. Använd Search Explorer som en sökklient eller något verktyg som skickar HTTP-begäranden. Följande fråga väljer fält som innehåller utdata från Markdown-avsnittets icke-bevektorinnehåll och dess vektor.
För Sökutforskaren kan du kopiera bara JSON och klistra in den i JSON-vyn för körning av frågor.
POST /indexes/[index name]/docs/search?api-version=[api-version]
{
  "search": "copay for in-network providers",
  "count": true,
  "searchMode": "all",
  "vectorQueries": [
    {
      "kind": "text",
      "text": "*",
      "fields": "text_vector,image_vector"
    }
  ],
  "queryType": "semantic",
  "semanticConfiguration": "healthplan-doc-layout-test-semantic-configuration",
  "captions": "extractive",
  "answers": "extractive|count-3",
  "select": "header_1, header_2, header_3"
}
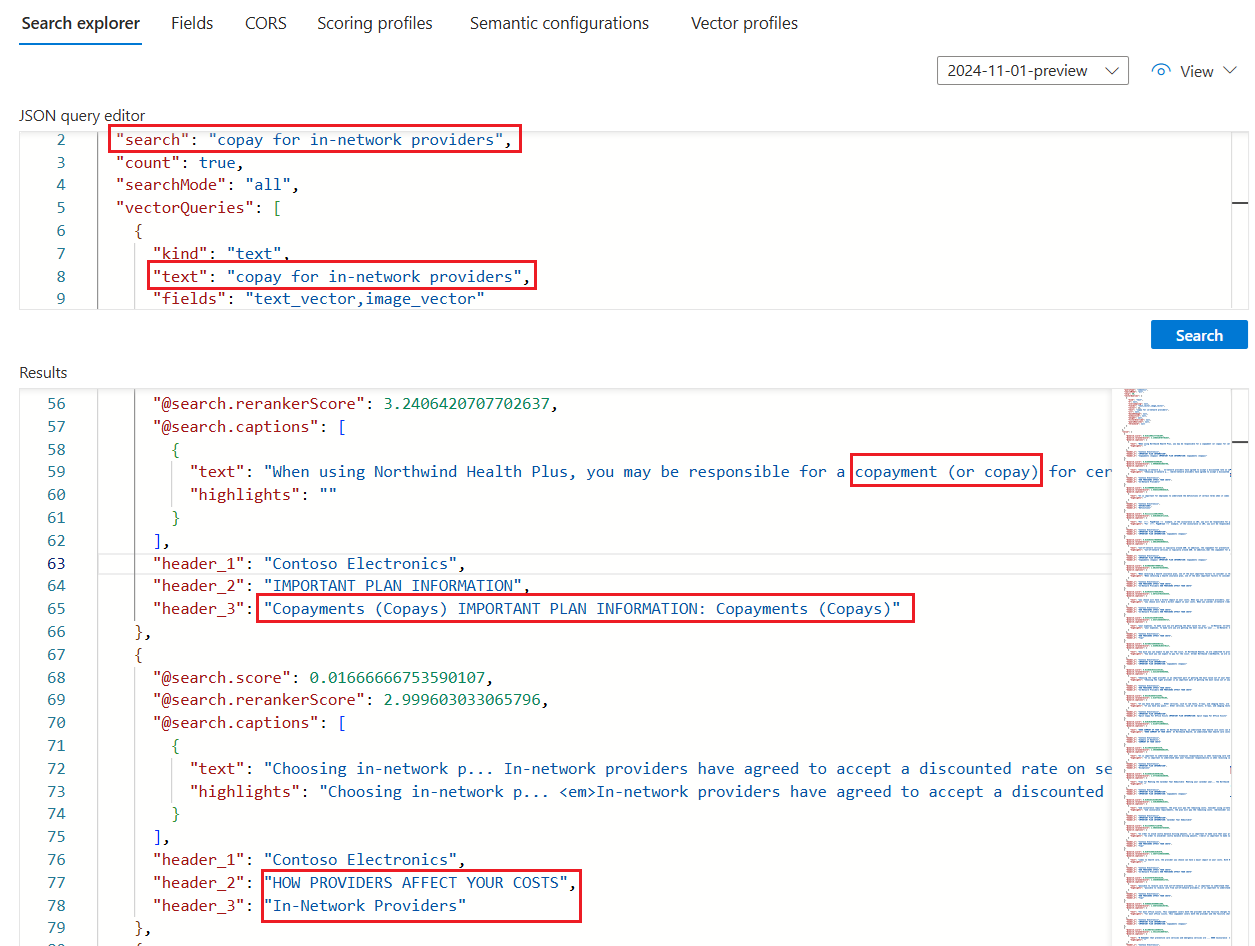
Om du använde pdf-filer för hälsoplan för att testa den här färdigheten bör sökresultaten i Sökutforskaren för exempelfrågan se ut ungefär som resultaten i följande skärmbild.
Frågan är en hybridfråga över text och vektorer, så du ser en
@search.rerankerScoreoch resultaten rangordnas efter den poängen.searchMode=allinnebär att alla frågetermer måste beaktas för en matchning (standardvärdet är alla).Frågan använder semantisk rangordning, så du ser
captions. Den haranswersockså , men de visas inte på skärmbilden. Resultaten är de mest semantiskt relevanta för frågeindata, enligt semantisk rankning.-instruktionen
select(visas inte på skärmbilden) anger de rubrikfält som dokumentlayouten identifierar och fyller i. Du kan lägga till fler fält i select-satsen för att granska innehållet i segment, rubrik eller något annat läsbart fält.