Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Note
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
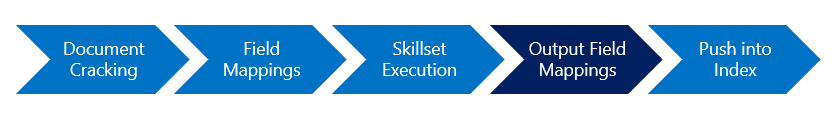
Den här artikeln beskriver hur du konfigurerar mappningar för utdatafält, som definierar en datasökväg mellan minnesintern data som genereras under bearbetning av kompetensuppsättningar och målfält i ett sökindex. Under indexeringskörningen finns kunskapsgenererad information endast i minnet. Om du vill spara den här informationen i ett sökindex måste du tala om för indexeraren var data ska skickas.
En mappning av utdatafält definieras i en indexerare och har följande element:
"outputFieldMappings": [
  {
    "sourceFieldName": "document/path-to-a-node-in-an-enriched-document",
    "targetFieldName": "some-search-field-in-an-index",
    "mappingFunction": null
  }
],
Till skillnad från en fieldMappings definition som mappar en sökväg mellan ordagranna källfält och indexfält mappar en outputFieldMappings definition minnesintern berikning till fält i ett sökindex.
Förutsättningar
Indexerare, index, datakälla och kompetensuppsättning.
Indexfält måste vara enkla eller överordnade fält. Du kan inte mata ut till en komplex typ. Men om du har en komplex typ kan du använda en utdatafältdefinition för att platta ut delar av den komplexa typen och skicka dem till en samling i ett sökindex.
När du ska använda en mappning av utdatafält
Utdatafältmappningar krävs om indexeraren har en bifogad kompetensuppsättning som skapar ny information som du vill ha i ditt index. Exempel:
- Vektorer från färdigheter för inbäddning.
- OCR-text (Optisk teckenigenkänning) från bildkunskaper.
- Platser, organisationer eller personer från funktioner för entitetsigenkänning.
Utdatafältmappningar kan också användas för att:
Skapa flera kopior av ditt genererade innehåll (en-till-många-utdatafältmappningar).
Platta ut ett källdokuments komplexa typ. Anta till exempel att källdokument har en komplex typ, till exempel en adress för flera delar, och att du bara vill ha staden. Du kan använda en utdatafältmappning för att platta ut en kapslad datastruktur och sedan använda en mappning av utdatafält för att skicka utdata till en strängsamling i sökindexet.
Mappningar av utdatafält gäller endast för sökindex. Om du fyller i ett kunskapslager använder du projektioner för konfiguration av datasökväg.
Definiera en mappning av utdatafält
Utdatafältmappningar läggs till i matrisen outputFieldMappings i en indexeraredefinition, som vanligtvis placeras efter matrisen fieldMappings . En mappning av utdatafält består av tre delar.
Du kan använda REST-API:et eller en Azure SDKs för att definiera mappningar för utdatafält.
Tips
Indexerare som skapats av guiden Importera data innehåller mappningar av utdatafält som genereras av guiden. Om du behöver exempel kör du guiden över datakällan för att se utdatafältmappningarna i indexeraren.
Använd Create Indexer eller Create or Update Indexer eller en motsvarande metod i en Azure SDKs. Här är ett exempel på en indexeraredefinition.
{
   "name": "myindexer",
   "description": null,
   "dataSourceName": "mydatasource",
   "targetIndexName": "myindex",
   "schedule": { },
   "parameters": { },
   "fieldMappings": [],
   "outputFieldMappings": [],
   "disabled": false,
   "encryptionKey": { }
 }
Fyll i matrisen
outputFieldMappingsför att ange mappningarna. En fältmappning består av tre delar."outputFieldMappings": [ { "sourceFieldName": "/document/path-to-a-node-in-an-enriched-document", "targetFieldName": "some-search-field-in-an-index", "mappingFunction": null } ]
| Egenskap | beskrivning |
|---|---|
| källaFältnamn | Obligatoriskt. Anger en sökväg till berikat innehåll. Ett exempel kan vara /document/content. Se Referensanrikningar i en Azure AI-sökning-kompetensuppsättning för sökvägssyntax och exempel. |
| målfältnamn | Valfritt. Anger sökfältet som tar emot det berikade innehållet. Målfält måste vara enkla fält eller samlingar på den översta nivån. Det kan inte vara en sökväg till ett underfält i en komplex typ. Om du vill hämta specifika noder i en komplex struktur kan du platta ut enskilda noder i minnet och sedan skicka utdata till en strängsamling i ditt index. |
| kartläggningsfunktion | Valfritt. Lägger till extra bearbetning som tillhandahålls av mappningsfunktioner som stöds av indexerare. För berikande noder är kodning och avkodning de vanligaste funktionerna. |
targetFieldNameär alltid namnet på fältet i sökindexet.sourceFieldNameär en sökväg till en nod i det berikade dokumentet. Det är resultatet av en färdighet. Sökvägen börjar alltid med /document, och om du indexerar från en blob är sökvägens andra element /content. Det tredje elementet är värdet som genereras av färdigheten. Mer information och exempel finns i Referensberikningar i en Azure AI-sökning-kompetensuppsättning.Det här exemplet lägger till entiteter och sentimentetiketter som extraherats från en blobs innehållsegenskap till fält i ett sökindex.
{
    "name": "myIndexer",
    "dataSourceName": "myDataSource",
    "targetIndexName": "myIndex",
    "skillsetName": "myFirstSkillSet",
    "fieldMappings": [],
    "outputFieldMappings": [
        {
            "sourceFieldName": "/document/content/organizations/*/description",
            "targetFieldName": "descriptions",
            "mappingFunction": {
                "name": "base64Decode"
            }
        },
        {
            "sourceFieldName": "/document/content/organizations",
            "targetFieldName": "orgNames"
        },
        {
            "sourceFieldName": "/document/content/sentiment",
            "targetFieldName": "sentiment"
        }
    ]
}
Tilldela eventuella mappningsfunktioner som behövs för att transformera innehållet i ett fält innan det lagras i indexet. För berikande noder är kodning och avkodning de vanligaste funktionerna.
Mappning av ett-till-många-utdatafält
Du kan använda en mappning av utdatafält för att dirigera ett enda källfält till flera fält i ett sökindex. Du kan göra detta för jämförelsetestning eller om du vill ha fält med olika attribut.
Anta en kompetensuppsättning som genererar inbäddningar för ett vektorfält och ett index som har flera vektorfält som varierar beroende på algoritm- och komprimeringsinställningar. I indexeraren mappar du inbäddningsfärdighetens utdata till vart och ett av de flera vektorfälten i ett sökindex.
"outputFieldMappings": [
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_hnsw" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_eknn" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_narrow" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_no_stored" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_scalar" }
  ]
Källfältsökvägen är kunskapsutdata. I det här exemplet är resultatet text_vector. Målnamnet är en valfri egenskap. Om du inte ger utdatamappningen ett målnamn kommer sökvägen att vara embedding eller mer exakt, /document/content/embedding.
{
  "name": "test-vector-size-ss",
  "description": "Generate embeddings using Azure OpenAI in Foundry Models",
  "skills": [
    {
      "@odata.type": "#Microsoft.Skills.Text.AzureOpenAIEmbeddingSkill",
      "name": "#1",
      "description": null,
      "context": "/document/content",
      "resourceUri": "https://my-demo-eastus.openai.azure.com",
      "apiKey": null,
      "deploymentId": "text-embedding-ada-002",
      "dimensions": 1536,
      "modelName": "text-embedding-ada-002",
      "inputs": [
        {
          "name": "text",
          "source": "/document/content"
        }
      ],
      "outputs": [
        {
          "name": "embedding",
          "targetName": "text_vector"
        }
      ],
      "authIdentity": null
    }
  ]
}
Platta ut komplexa strukturer till en strängsamling
Om dina källdata består av kapslad eller hierarkisk JSON kan du inte använda fältmappningar för att konfigurera datasökvägarna. I stället måste ditt sökindex spegla källdatastrukturen för på varje nivå för en fullständig import.
Det här avsnittet beskriver en importprocess som skapar en en-till-en-återspegling av ett komplext dokument på både käll- och målsidan. Därefter använder den samma källdokument för att visa hur man hämtar och plattar ut enskilda noder till strängsamlingar.
Här är ett exempel på ett dokument i Azure Cosmos DB med kapslad JSON:
{
   "palette":"primary colors",
   "colors":[
      {
         "name":"blue",
         "medium":[
            "acrylic",
            "oil",
            "pastel"
         ]
      },
      {
         "name":"red",
         "medium":[
            "acrylic",
            "pastel",
            "watercolor"
         ]
      },
      {
         "name":"yellow",
         "medium":[
            "acrylic",
            "watercolor"
         ]
      }
   ]
}
Om du vill indexeras fullständigt i det här källdokumentet skapar du en indexdefinition där fältnamnen, nivåerna och typerna återspeglas som en komplex typ. Eftersom fältmappningar inte stöds för komplexa typer i sökindexet måste indexdefinitionen spegla källdokumentet.
{
  "name": "my-test-index",
  "defaultScoringProfile": "",
  "fields": [
    { "name": "id", "type": "Edm.String", "searchable": false, "retrievable": true, "key": true},
    { "name": "palette", "type": "Edm.String", "searchable": true, "retrievable": true },
    { "name": "colors", "type": "Collection(Edm.ComplexType)",
      "fields": [
        {
          "name": "name",
          "type": "Edm.String",
          "searchable": true,
          "retrievable": true
        },
        {
          "name": "medium",
          "type": "Collection(Edm.String)",
          "searchable": true,
          "retrievable": true,
        }
      ]
    }
  ]
}
Här är en exempelindexerardefinition som kör importen. Observera att det inte finns några fältmappningar och ingen kompetensuppsättning.
{
  "name": "my-test-indexer",
  "dataSourceName": "my-test-ds",
  "skillsetName": null,
  "targetIndexName": "my-test-index",

  "fieldMappings": [],
  "outputFieldMappings": []
}
Resultatet är följande exempelsökningsdokument som liknar originalet i Azure Cosmos DB.
{
  "value": [
    {
      "@search.score": 1,
      "id": "11bb11bb-cc22-dd33-ee44-55ff55ff55ff",
      "palette": "primary colors",
      "colors": [
        {
          "name": "blue",
          "medium": [
            "acrylic",
            "oil",
            "pastel"
          ]
        },
        {
          "name": "red",
          "medium": [
            "acrylic",
            "pastel",
            "watercolor"
          ]
        },
        {
          "name": "yellow",
          "medium": [
            "acrylic",
            "watercolor"
          ]
        }
      ]
    }
  ]
}
En alternativ återgivning i ett sökindex är att platta ut enskilda noder i källans kapslade struktur till en strängsamling i ett sökindex.
För att utföra den här uppgiften behöver du en outputFieldMappings som mappar en minnesintern nod till en strängsamling i indexet. Även om mappningar av utdatafält främst gäller för kunskapsutdata, kan du även använda dem för att adressera noder efter dokumentsprickor där indexeraren öppnar ett källdokument och läser det i minnet.
Följande exempelindexdefinition använder strängsamlingar för att ta emot utdata som är utplattade:
{
  "name": "my-new-flattened-index",
  "defaultScoringProfile": "",
  "fields": [
    { "name": "id", "type": "Edm.String", "searchable": false, "retrievable": true, "key": true },
    { "name": "palette", "type": "Edm.String", "searchable": true, "retrievable": true },
    { "name": "color_names", "type": "Collection(Edm.String)", "searchable": true, "retrievable": true },
    { "name": "color_mediums", "type": "Collection(Edm.String)", "searchable": true, "retrievable": true}
  ]
}
Här är exempelindexeringsdefinitionen som används outputFieldMappings för att associera den kapslade JSON:en med strängsamlingsfälten. Källfältet använder sökvägssyntaxen för berikningsnoder, även om det inte finns någon kunskapsuppsättning. Berikade dokument skapas i systemet under dokumentbearbetning, vilket innebär att du kan komma åt noder i varje dokumentträd så länge dessa noder finns när dokumentet bryts upp.
{
  "name": "my-test-indexer",
  "dataSourceName": "my-test-ds",
  "skillsetName": null,
  "targetIndexName": "my-new-flattened-index",
  "parameters": {  },
  "fieldMappings": [   ],
  "outputFieldMappings": [
    {
       "sourceFieldName": "/document/colors/*/name",
       "targetFieldName": "color_names"
    },
    {
       "sourceFieldName": "/document/colors/*/medium",
       "targetFieldName": "color_mediums"
    }
  ]
}
Resultatet från definitionen är följande. Om du förenklar strukturen förloras kontexten i det här fallet. Det finns inte längre några associationer mellan en viss färg och de medier som den är tillgänglig i. Beroende på ditt scenario kan ett resultat som liknar följande exempel dock vara exakt vad du behöver.
{
  "value": [
    {
      "@search.score": 1,
      "id": "11bb11bb-cc22-dd33-ee44-55ff55ff55ff",
      "palette": "primary colors",
      "color_names": [
        "blue",
        "red",
        "yellow"
      ],
      "color_mediums": [
        "[\"acrylic\",\"oil\",\"pastel\"]",
        "[\"acrylic\",\"pastel\",\"watercolor\"]",
        "[\"acrylic\",\"watercolor\"]"
      ]
    }
  ]
}