Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Примечание.
Поиск с использованием ИИ Azure доступна через портал Azure, REST API и Azure SDKs. Он также лежит в основе Foundry IQ — управляемого слоя знаний, который преобразует корпоративный контент в многократно используемые базы знаний с учетом разрешений доступа для агентов на портале Microsoft Foundry.
Поиск ИИ Azure принимает плоский набор строк в качестве входных данных в конвейер индексирования. В этой статье объясняется, как создать набор строк и как моделировать отношения родитель-потомок в индексе поиска Azure AI, если исходные данные исходят из присоединенных таблиц в реляционной базе данных SQL Server.
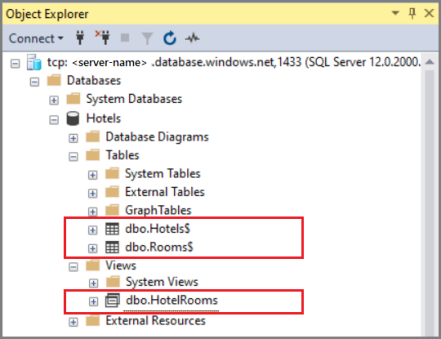
В качестве иллюстрации, мы приводим в пример гипотетическую базу данных отелей на основе демонстрационных данных. Предположим, что база данных состоит из Hotels$ таблицы с 50 отелями, и из Rooms$ таблицы с номерами различных типов, тарифами и удобствами, в общей сложности 750 номеров. Между таблицами существует связь "один ко многим". В нашем подходе представление предоставляет запрос, возвращающий 50 строк, по одной строке для каждого отеля, со связанными сведениями о комнате, внедренными в каждую строку.
Проблема c денормализацией данных
Одна из проблем при работе с отношениями "один ко многим" заключается в том, что стандартные запросы, созданные на основе присоединенных таблиц, возвращают денормализованные данные, которые не работают хорошо в сценарии поиска ИИ Azure. Давайте рассмотрим следующий пример, который объединяет отели и номера.
SELECT * FROM Hotels$
INNER JOIN Rooms$
ON Rooms$.HotelID = Hotels$.HotelID
Результаты этого запроса возвращают все поля отелей и все поля номеров, причем предварительная информация об отелях повторяется для каждого значения номера.
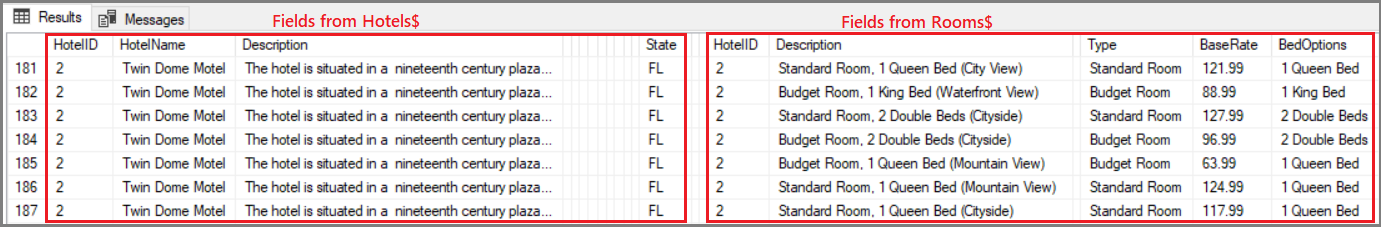
Хотя этот запрос успешно выполняется на поверхности (предоставляя все данные в плоском наборе строк), он не обеспечивает правильной структуры документов для ожидаемого опыта поиска. Во время индексирования Поиск с использованием ИИ Azure создает один поисковый документ для каждой строки данных. Если ваши документы поиска выглядели как приведенные выше результаты, вы бы воспринимали дубликаты — семь отдельных документов только для отеля "Old Century". Запрос на "отели во Флориде" вернет семь результатов только для старого отеля Century, толкая другие соответствующие отели глубоко в результаты поиска.
Чтобы, как ожидается, получить по одному документу на каждую гостиницу, нужно предоставить набор данных с полной информацией на нужном уровне детализации. В этой статье описано, как это сделать.
Определение запроса, который возвращает внедренный код JSON
Чтобы обеспечить ожидаемый интерфейс поиска, набор данных должен состоять из одной строки для каждого документа поиска в службе "Поиск ИИ Azure". В нашем примере это означает одну строку для каждой гостиницы. Но нам важно, чтобы пользователи могли выполнять поиск по другим полям с информацией о номерах, например по стоимости за одну ночь, о размере и количестве кроватей или о наличии вида на пляж. Все эти сведения входят в информацию о номере.
Решение состоит в том, чтобы получить сведения о комнате в формате вложенных данных JSON и поместить эту структуру JSON в поле в представлении, что мы и сделаем на втором шаге.
Предположим, что у вас есть две объединенные таблицы,
Hotels$иRooms$, содержащие сведения о 50 отелях и 750 номерах, которые присоединены по полю HotelID. По отдельности, в этих таблицах содержатся 50 гостиниц и 750 соответствующих номеров.CREATE TABLE [dbo].[Hotels$]( [HotelID] [nchar](10) NOT NULL, [HotelName] [nvarchar](255) NULL, [Description] [nvarchar](max) NULL, [Description_fr] [nvarchar](max) NULL, [Category] [nvarchar](255) NULL, [Tags] [nvarchar](255) NULL, [ParkingIncluded] [float] NULL, [SmokingAllowed] [float] NULL, [LastRenovationDate] [smalldatetime] NULL, [Rating] [float] NULL, [StreetAddress] [nvarchar](255) NULL, [City] [nvarchar](255) NULL, [State] [nvarchar](255) NULL, [ZipCode] [nvarchar](255) NULL, [GeoCoordinates] [nvarchar](255) NULL ) ON [PRIMARY] TEXTIMAGE_ON [PRIMARY] GO CREATE TABLE [dbo].[Rooms$]( [HotelID] [nchar](10) NULL, [Description] [nvarchar](255) NULL, [Description_fr] [nvarchar](255) NULL, [Type] [nvarchar](255) NULL, [BaseRate] [float] NULL, [BedOptions] [nvarchar](255) NULL, [SleepsCount] [float] NULL, [SmokingAllowed] [float] NULL, [Tags] [nvarchar](255) NULL ) ON [PRIMARY] GOСоздайте представление, которое включает все поля из родительской таблицы (
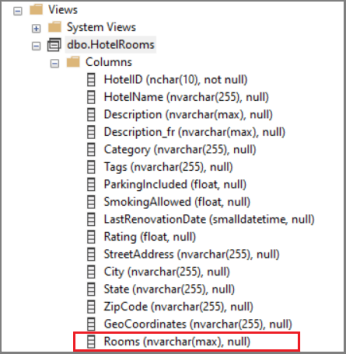
SELECT * from dbo.Hotels$) с одним дополнительным полем Rooms для выходных данных вложенного запроса. Предложение FOR JSON AUTO дляSELECT * from dbo.Rooms$форматирует выходные данные в код JSON.CREATE VIEW [dbo].[HotelRooms] AS SELECT *, (SELECT * FROM dbo.Rooms$ WHERE dbo.Rooms$.HotelID = dbo.Hotels$.HotelID FOR JSON AUTO) AS Rooms FROM dbo.Hotels$ GOНа следующем снимке экрана демонстрируется итоговое представление с полем Rooms типа nvarchar в самом низу. Поле Rooms существует только в представлении HotelRooms.
Выполните команду
SELECT * FROM dbo.HotelRooms, чтобы получить этот набор строк. Запрос возвращает 50 строк, то есть по одной на гостиницу, с информацией о номерах в формате коллекции JSON.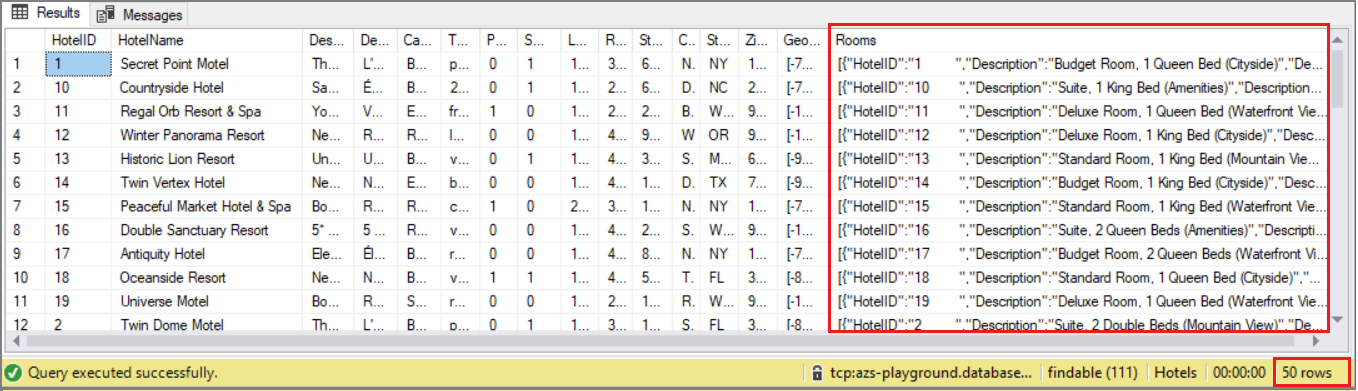
Теперь этот набор строк готов к импорту в поиск ИИ Azure.
Примечание.
При таком подходе предполагается, что внедренный код JSON не превышает ограничение на размер столбца в SQL Server.
Используйте сложную коллекцию для стороны "многие" в связи "один ко многим"
В поисковой службе Azure AI создайте индексную схему, которая моделирует отношение "один ко многим" с помощью вложенного JSON. Результирующий набор, созданный в предыдущем разделе, обычно соответствует схеме индекса, предоставленной далее (мы вырезаем некоторые поля для краткости).
Следующий пример аналогичен примеру из статьи Моделирование сложных типов данных. Структура Rooms, с которой мы имели дело в этой статье, располагается в коллекции полей индекса с названием hotels. В этом примере также показан сложный тип для Address, который отличается от комнат в том, что он состоит из фиксированного набора элементов, в отличие от нескольких произвольных элементов, разрешенных в коллекции.
{
  "name": "hotels",
  "fields": [
    { "name": "HotelId", "type": "Edm.String", "key": true, "filterable": true },
    { "name": "HotelName", "type": "Edm.String", "searchable": true, "filterable": false },
    { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
    { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
    { "name": "Category", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": true },
    { "name": "ParkingIncluded", "type": "Edm.Boolean", "filterable": true, "facetable": true },
    { "name": "Tags", "type": "Collection(Edm.String)", "searchable": true, "filterable": true, "facetable": true },
    { "name": "Address", "type": "Edm.ComplexType",
      "fields": [
        { "name": "StreetAddress", "type": "Edm.String", "filterable": false, "sortable": false, "facetable": false, "searchable": true },
        { "name": "City", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true },
        { "name": "StateProvince", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true }
      ]
    },
    { "name": "Rooms", "type": "Collection(Edm.ComplexType)",
      "fields": [
        { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
        { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
        { "name": "Type", "type": "Edm.String", "searchable": true },
        { "name": "BaseRate", "type": "Edm.Double", "filterable": true, "facetable": true },
        { "name": "BedOptions", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": false },
        { "name": "SleepsCount", "type": "Edm.Int32", "filterable": true, "facetable": true },
        { "name": "SmokingAllowed", "type": "Edm.Boolean", "filterable": true, "facetable": false},
        { "name": "Tags", "type": "Edm.Collection", "searchable": true }
      ]
    }
  ]
}
На основе созданного выше набора результатов и этой схемы индекса вы можете успешно выполнить операцию индексирования. Преобразованный в плоскую структуру набор данных соответствует требованиям к индексированию и при этом сохраняет подробные сведения. В индексе поиска Azure AI результаты поиска легко классифицируются по сущностям, связанным с отелями, при этом сохраняется контекст отдельных комнат и их характеристик.
Фасетное поведение в подполях сложного типа
Поля, имеющие родителя, такие как поля под Адресом и Комнатами, называются подполями. Хотя атрибут "facetable" можно назначить подполю, количество фасетов всегда относится к основному документу.
Для сложных типов, таких как Address, где в документе есть только один "Address/City" или "Address/stateProvince", поведение фасетов работает должным образом. Однако в случае с Комнатами, в которых существует несколько поддокументов для каждого основного документа, количество фасетов может быть вводящим в заблуждение.
Как отмечалось в модельных сложных типах: "Количество документов, возвращаемых в фасетных результатах, рассчитывается для родительского документа (отель), а не поддокументов в комплексной коллекции (номера). Например, предположим, что в гостинице 20 номеров типа "люкс". Учитывая этот параметр фасета, фасет=Номера/Тип, число фасетов равно одному для отеля, а не 20 для комнат.
Следующие шаги
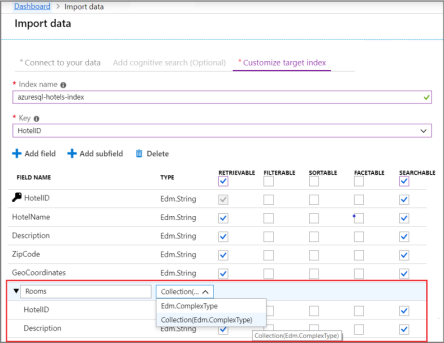
С помощью собственного набора данных можно использовать мастер импорта данных для создания и загрузки индекса. Этот мастер обнаруживает встроенную коллекцию JSON, такую как та, что содержится в Rooms, и выводит схему индекса, включающую коллекцию сложного типа.
Ознакомьтесь со следующим кратким руководством, чтобы узнать, как выполнить основные действия мастера импорта данных .