Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Observação
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
Um aplicativo multilocatário é aquele que fornece os mesmos serviços e as mesmas funcionalidades para qualquer número de locatários que não conseguem ver nem compartilhar os dados de qualquer outro locatário. Este artigo discute estratégias de isolamento de inquilinos para aplicativos multilocatários desenvolvidos com o Pesquisa de IA do Azure .
Conceitos do Pesquisa de IA do Azure
Como uma solução de pesquisa como serviço, o Pesquisa de IA do Azure permite aos desenvolvedores adicionar experiências de pesquisa avançada para aplicativos sem gerenciar nenhuma infraestrutura ou se tornar um especialista em pesquisa. Os dados são carregados para o serviço e, em seguida, são armazenados na nuvem. Usando solicitações simples para a API do Pesquisa de IA do Azure , os dados podem então ser modificados e pesquisados.
Serviços de Pesquisa, índices, campos e documentos
Antes de discutir os padrões de design, é importante compreender alguns conceitos básicos.
Ao usar o Pesquisa de IA do Azure , alguém assina um serviço de pesquisa. Como os dados são carregados no Pesquisa de IA do Azure , eles são armazenados em um índice dentro do serviço de pesquisa. Pode haver um número de índices em um único serviço. Para usar os conceitos familiares de bancos de dados, o serviço de pesquisa pode ser comparado a um banco de dados, enquanto os índices dentro de um serviço podem ser comparados a tabelas em um banco de dados.
Cada índice dentro de um serviço de pesquisa tem seu próprio esquema, que é definido por um número de campospersonalizáveis. Os dados são adicionados a um índice do Pesquisa de IA do Azure na forma de documentos individuais. Cada documento deve ser carregado em um índice específico e deve se ajustar ao esquema do índice. Ao pesquisar dados usando o Pesquisa de IA do Azure , as consultas de pesquisa de texto completo são emitidas em relação a um índice específico. Para comparar esses conceitos àqueles de um banco de dados, os campos podem ser comparados a colunas em uma tabela e os documentos podem ser comparados a linhas.
Escalabilidade
Qualquer serviço do Pesquisa de IA do Azure no tipo de preço Standard pode ser dimensionado em duas dimensões: armazenamento e disponibilidade.
- Partições podem ser adicionadas para aumentar o armazenamento de um serviço de pesquisa.
- Réplicas podem ser adicionados a um serviço para aumentar a taxa de solicitações que pode lidar com um serviço de pesquisa.
Adicionar e remover partições e réplicas permitirá que a capacidade do serviço de pesquisa cresça de acordo com a quantidade de dados e tráfego que o aplicativo exige. Para que um serviço de pesquisa obtenha um SLAde leitura, ele requer duas réplicas. Para que um serviço de pesquisa obtenha um SLAde leitura/gravação, ele requer três réplicas.
Limites de serviço e índice no Pesquisa de IA do Azure
Há alguns tipos de preço diferentes no AI Azure Search, cada um dos tipos tem limites e cotas diferentes. Alguns desses limites estão no nível de serviço, alguns estão no nível do índice e alguns estão no nível da partição.
S3 Alta Densidade
No tipo de preço S3 do Pesquisa de IA do Azure , há uma opção para o modo HD (alta densidade) desenvolvido especificamente para cenários de multilocatários. Em muitos casos, é necessário dar suporte a um grande número de locatários menores em um só serviço para obter os benefícios de simplicidade e redução de custos.
S3 HD permite que os muitos índices pequenos sejam agrupados sob o gerenciamento de um único serviço de pesquisa, substituindo a capacidade de escalar os índices usando partições pela capacidade de hospedar mais índices em um único serviço.
Um serviço S3 é designado para hospedar um número fixo de índices (máximo de 200) e permitir que cada índice seja dimensionado horizontalmente conforme novas partições são adicionadas ao serviço. A adição de partições em serviços S3 HD aumenta o número máximo de índices que o serviço pode hospedar. O tamanho máximo ideal para um índice S3HD individual é de cerca de 50 a 80 GB, embora não haja limite de tamanho rígido em cada índice imposto pelo sistema.
Considerações para aplicativos multilocatários
Aplicativos multilocatários devem distribuir efetivamente recursos entre locatários preservando algum nível de privacidade entre os vários locatários. Há algumas considerações ao criar a arquitetura para esse aplicativo:
Isolamento de locatários: os desenvolvedores de aplicativos precisam tomar as medidas apropriadas para garantir que nenhum locatário tenha acesso não autorizado ou indesejado aos dados de outros locatários. Além da perspectiva de privacidade de dados, estratégias de isolamento de locatários requerem um gerenciamento eficiente de recursos compartilhados e a proteção de vizinhos com ruídos.
Custo de recursos de nuvem: como com qualquer outro aplicativo, as soluções de software devem permanecer competitivas em termos de custo como um componente de um aplicativo multilocatário.
Facilidade de operações: ao desenvolver uma arquitetura de multilocatários, o impacto sobre as operações e a complexidade do aplicativo é uma consideração importante. O Pesquisa de IA do Azure tem um SLA de 99,9%.
Presença global: geralmente, os aplicativos de multilocação precisam atender aos inquilinos distribuídos em todo o mundo.
Escalabilidade: os desenvolvedores de aplicativos precisam considerar como eles reconciliam entre manter um nível suficientemente baixo de complexidade do aplicativo e criar o aplicativo para dimensionar com número de locatários e o tamanho dos dados e a carga de trabalho de locatários.
O Pesquisa de IA do Azure oferece alguns limites que podem ser usados para isolar dados e carga de trabalho de locatários.
Modelagem de multilocação com o Pesquisa de IA do Azure
No caso de um cenário de multilocatário, o desenvolvedor do aplicativo consome um ou mais serviços de pesquisa e divide os locatários entre os serviços, os índices ou entre ambos. O Pesquisa de IA do Azure tem alguns padrões comuns ao modelar um cenário de multilocatário:
Um índice por locatário: cada locatário tem o próprio índice dentro de um serviço de pesquisa que é compartilhado com outros locatários.
Um serviço por locatário: cada locatário tem seu próprio serviço do Pesquisa de IA do Azure dedicado, oferecendo o nível mais alto de separação de dados e a carga de trabalho.
Mistura de ambos: locatários maiores e mais ativos são atribuídos a serviços dedicados enquanto locatários menores são atribuídos a índices individuais dentro de serviços compartilhados.
Modelo 1: um índice por locatário
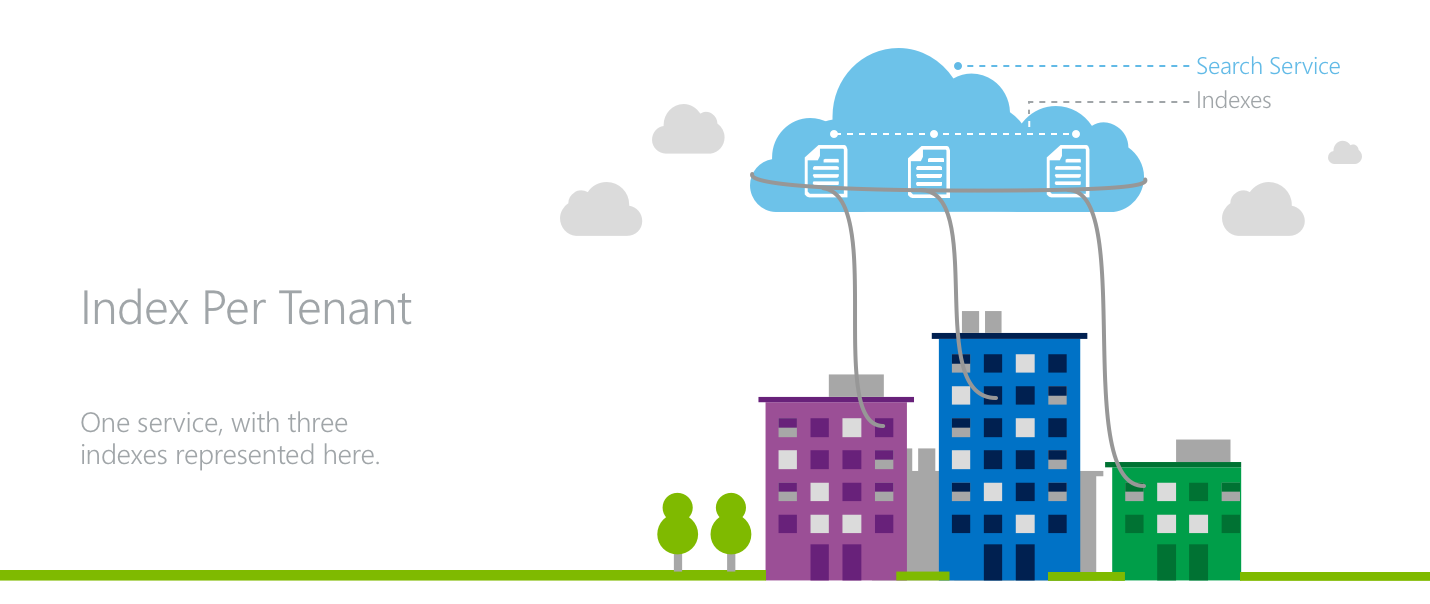
Em um modelo de índice por locatário, vários locatários ocupam um único serviço do Pesquisa de IA do Azure , em que cada locatário tem seu próprio índice.
Essa abordagem funciona porque todas as solicitações de pesquisa e operações de documento são emitidas em um nível de índice no Pesquisa de IA do Azure . Na camada de aplicativo, há o reconhecimento da necessidade de direcionar o tráfego de vários locatários para os índices certos, gerenciando os recursos no serviço em todos os locatários.
Um atributo de chave do modelo de índice por locatário é a capacidade do desenvolvedor do aplicativo de subscrever a capacidade de um serviço de pesquisa entre locatários do aplicativo. Se os locatários têm uma distribuição desigual de carga de trabalho, a combinação ideal de locatários pode ser distribuída em índices de um serviço de pesquisa para acomodar inúmeros locatários altamente ativos e com uso intensivo de recursos, ao mesmo tempo em que atende uma cauda longa de locatários menos ativos. A desvantagem é a incapacidade do modelo de lidar com situações em que cada locatário é altamente ativo simultaneamente.
O modelo de índice por locatário fornece a base para um modelo de custo variável, em que um serviço inteiro do Pesquisa de IA do Azure é comprado antecipado e, em seguida, preenchido com locatários. Isso permite que a capacidade não utilizada seja designada para contas gratuitas e de avaliação.
Para aplicativos com presença global, é possível que o modelo de índice por tenant não seja o mais eficiente. Se os locatários de um aplicativo forem distribuídos em todo o mundo, um serviço separado poderá ser necessário para cada região, duplicando os custos em cada um deles.
O Pesquisa de IA do Azure permite aumentar tanto a escala de índices individuais quanto o número total de índices. Se um tipo de preço apropriado for escolhido, partições e réplicas poderão ser adicionadas ao serviço de pesquisa inteiro quando um índice individual dentro do serviço se tornar muito extenso em termos de armazenamento ou tráfego.
Se o número total de índices aumentar muito para um único serviço, outro serviço deve ser provisionado para acomodar os novos usuários. Se os índices precisarem ser movidos entre os serviços de pesquisa à medida que novos serviços forem adicionados, os dados do índice deverão ser copiados manualmente de um índice para o outro, pois o Pesquisa de IA do Azure não permite a movimentação de um índice.
Modelo 2: um serviço por locatário
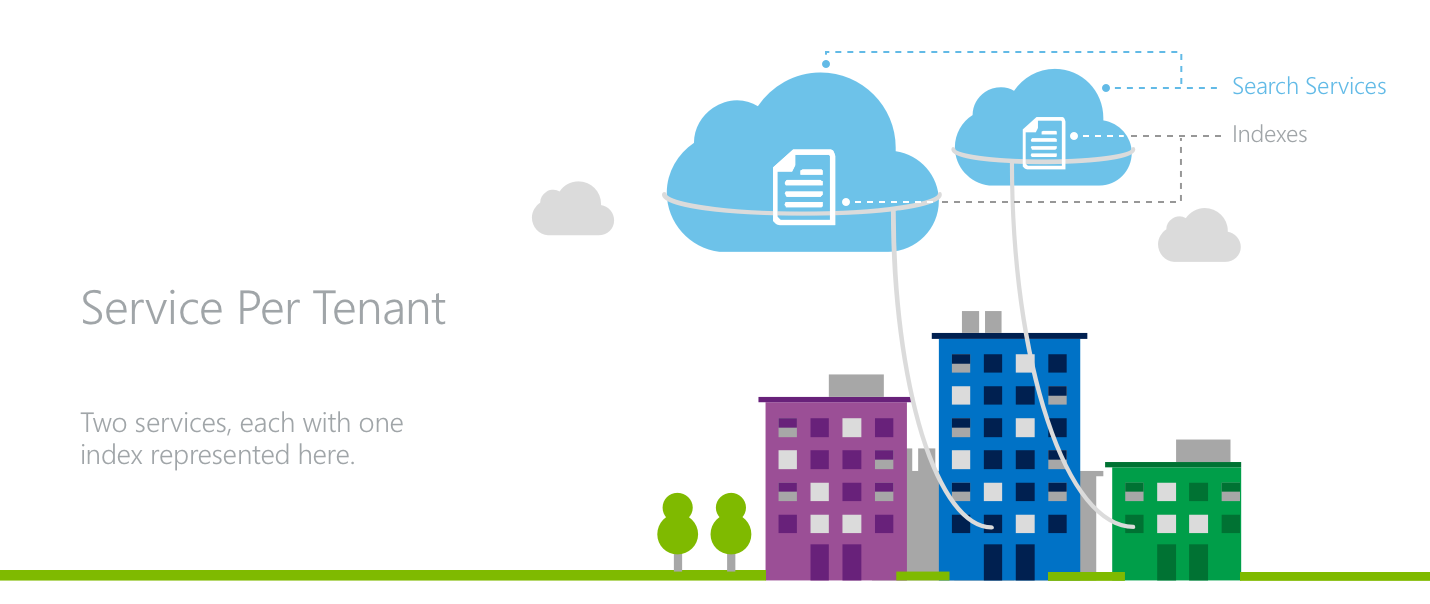
Em uma arquitetura de serviço por locatário, cada locatário tem seu próprio serviço de pesquisa.
Nesse modelo, o aplicativo atinge o nível máximo de isolamento para seus locatários. Cada serviço tem armazenamento dedicado e taxa de transferência dedicada para processar as solicitações de pesquisa. Cada locatário tem a propriedade individual das chaves de API.
Para os aplicativos nos quais cada locatário tem um volume grande ou a carga de trabalho tem menos variabilidade de locatário para locatário, o modelo de serviço por locatário é uma opção efetiva, pois os recursos não são compartilhados entre as cargas de trabalho de vários locatários.
Um modelo de serviço por locatário também oferece o benefício de um modelo de custo fixo e previsível. Não há nenhum investimento antecipado em um serviço de pesquisa inteiro até que haja um locatário para preenchê-lo. No entanto, o custo por locatário é maior do que um modelo de índice por locatário.
O modelo de serviço por locatário é uma opção eficiente para aplicativos com uma superfície global. Com os locatários distribuídos geograficamente, é fácil ter o serviço de cada locatário na região apropriada.
Os desafios de dimensionamento desse padrão surgem quando locatários individuais excedem o serviço. Atualmente, o Pesquisa de IA do Azure não dá suporte à atualização do tipo de preço de um serviço de pesquisa, ou seja, todos os dados precisam ser copiados manualmente para um novo serviço.
Modelo 3: híbrido
Outro padrão para modelar a multilocação é misturar estratégias de índice por locatário e de serviço por locatário.
Combinando os dois padrões, locatários maiores do aplicativo podem ocupar serviços dedicados, enquanto a cauda longa de locatários menores, menos ativos pode ocupar índices em um serviço compartilhado. Esse modelo garante que os locatários maiores tenham consistentemente alto desempenho do serviço, ajudando a proteger os locatários menores de vizinhos com ruídos.
No entanto, implementar essa estratégia depende da antecipação para prever quais locatários exigirão um serviço dedicado em vez de um índice em um serviço compartilhado. A complexidade do aplicativo aumenta com a necessidade de gerenciar esses dois modelos de multitenancy.
Como obter granularidade ainda maior
Os padrões de design acima para modelar cenários de multilocatários no Pesquisa de IA do Azure assumem um escopo uniforme, em que cada inquilino representa uma instância completa de um aplicativo. No entanto, às vezes, os aplicativos podem manipular vários escopos menores.
Se os modelos de serviço por locatário e de índice por locatário não são escopos suficientemente pequenos, é possível modelar um índice para atingir um nível ainda maior de granularidade.
Para que um único índice se comporte de modo diferente para diferentes pontos de extremidade de cliente, é possível adicionar um campo ao índice, que designa um certo valor para cada cliente possível. Cada vez que um cliente chama o Pesquisa de IA do Azure para consultar ou modificar um índice, o código do aplicativo cliente especifica o valor apropriado para o campo usando a funcionalidade de filtro do Pesquisa de IA do Azure no momento da consulta.
Esse método pode ser usado para obter uma funcionalidade de contas de usuário separadas, níveis de permissão separados e até mesmo aplicativos completamente separados.
Observação
Usar a abordagem descrita acima para configurar um único índice para atender a vários locatários afeta a relevância dos resultados da pesquisa. Pontuações de relevância de pesquisa são calculadas em um escopo no nível do índice, não no nível do locatário, para que dados de todos os locatários sejam incorporados às estatísticas subjacentes das pontuações de relevância, tal como frequência de termo.
Próximas etapas
O Pesquisa de IA do Azure é uma escolha atraente para muitos aplicativos. Ao avaliar os vários padrões de design para aplicativos multilocatários, considere os vários tipos de preços e os respectivos limites de serviço para melhor personalizar o Pesquisa de IA do Azure para ajustar cargas de trabalho do aplicativo e arquiteturas de todos os tamanhos.