Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Uwaga
Wyszukiwanie AI platformy Azure jest dostępna za pośrednictwem portalu Azure, interfejsów API REST i Azure SDKs. Jest także podstawą Foundry IQ — zarządzanej warstwy wiedzy, która przekształca treści przedsiębiorstwa w bazy wiedzy wielokrotnego użytku z uwzględnieniem uprawnień dla agentów w portalu Microsoft Foundry.
Wyszukiwanie pełnotekstowe to metoda pobierania informacji zgodna z tekstem zwykłym przechowywanym w indeksie. Na przykład, biorąc pod uwagę ciąg zapytania "hotels in San Diego on the beach", wyszukiwarka szuka tokenizowanych ciągów na podstawie tych terminów. Aby zwiększyć wydajność skanowania, ciągi zapytań są poddawane analizie leksykalnej: wszystkie terminy są przekształcane na małe litery, usuwanie słów przestankowych, takich jak 'the' (czyli 'tego'), i sprowadzenie terminów do ich pierwotnych form podstawowych. Po znalezieniu pasujących terminów wyszukiwarka pobiera dokumenty, klasyfikuje je w kolejności istotności i zwraca najlepsze wyniki.
Wykonywanie zapytań może być złożone. Ten artykuł jest przeznaczony dla deweloperów, którzy potrzebują dokładniejszego zrozumienia sposobu działania wyszukiwania pełnotekstowego w Wyszukiwanie AI platformy Azure. W przypadku zapytań tekstowych Wyszukiwanie AI platformy Azure bezproblemowo dostarcza oczekiwane wyniki w większości scenariuszy, ale czasami możesz uzyskać wynik, który wydaje się jakoś "wyłączony". W takich sytuacjach posiadanie wiedzy o czterech etapach wykonywania zapytań Lucene (analizowanie zapytań, analiza leksykalna, dopasowywanie dokumentów i ocenianie) może pomóc zidentyfikować określone zmiany w parametrach zapytania lub konfiguracji indeksu, które prowadzą do pożądanego wyniku.
Uwaga
Wyszukiwanie AI platformy Azure używa Apache Lucene do wyszukiwania pełnotekstowego, ale integracja Lucene nie jest wyczerpująca. Selektywnie ujawniamy i rozszerzamy funkcjonalność Lucene, aby zrealizować scenariusze ważne dla Wyszukiwanie AI platformy Azure.
Omówienie architektury i diagram
Wykonywanie zapytania ma cztery etapy:
- Analizowanie zapytań
- Analiza leksykalna
- Pobieranie dokumentu
- Ocena
Zapytanie wyszukiwania pełnotekstowego rozpoczyna się od analizowania tekstu zapytania w celu wyodrębnienia terminów wyszukiwania i operatorów. Istnieją dwa analizatory, dzięki którym można wybrać szybkość i złożoność. Następna faza analizy polega na tym, że poszczególne terminy zapytania są czasami podzielone i ponownie tworzone w nowych formularzach. Ten krok pomaga rzutować szerszą siatkę na to, co można uznać za potencjalny mecz. Następnie wyszukiwarka skanuje indeks w celu znalezienia dokumentów ze zgodnymi terminami i przydziela oceny każdemu dopasowaniu. Zestaw wyników jest następnie sortowany według wyniku istotności przypisanego do każdego indywidualnego zgodnego dokumentu. Osoby w górnej części listy sklasyfikowanej są zwracane do aplikacji wywołującej.
Na poniższym diagramie przedstawiono składniki używane do przetwarzania żądania wyszukiwania:
Diagram architektury zapytań Lucene w Wyszukiwanie AI platformy Azure.
| Kluczowe składniki | Opis funkcjonalny |
|---|---|
| Analizatory zapytań | Oddziel terminy zapytania od operatorów zapytań i utwórz strukturę zapytań (drzewo zapytań) do wysłania do aparatu wyszukiwania. |
| Analizatory | Wykonywanie analizy leksykalnej na terminach zapytania. Ten proces może obejmować przekształcanie, usuwanie lub rozszerzanie terminów zapytania. |
| Indeks | Wydajna struktura danych używana do przechowywania i organizowania terminów z możliwością wyszukiwania wyodrębnionych z indeksowanych dokumentów. |
| Wyszukiwarki | Pobiera i ocenia pasujące dokumenty na podstawie zawartości odwróconego indeksu. |
Anatomia żądania wyszukiwania
Żądanie wyszukiwania to pełna specyfikacja elementów, które powinny być zwracane w zestawie wyników. W najprostszej formie jest to puste zapytanie bez kryteriów jakiegokolwiek rodzaju. Bardziej realistyczny przykład obejmuje parametry, kilka terminów zapytania, być może zakres określonych pól, z ewentualnie wyrażeniem filtru i regułami porządkowania.
Poniższy przykład to żądanie wyszukiwania, które można wysłać do Wyszukiwanie AI platformy Azure przy użyciu interfejsu API REST:
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
W przypadku tego żądania wyszukiwarka wykonuje następujące operacje:
Znajduje dokumenty, w których cena wynosi co najmniej $60 i mniej niż $300.
Wykonuje zapytanie. W tym przykładzie zapytanie wyszukiwania składa się z fraz i terminów:
"Spacious, air-condition* +\"Ocean view\""(Użytkownicy zazwyczaj nie wprowadzają interpunkcji, ale w tym przykładzie możemy wyjaśnić, jak analizatory go obsługują).W przypadku tego zapytania wyszukiwarka skanuje pola "searchFields" dla dokumentów, które zawierają
"Ocean view"oraz dodatkowo dla terminu"spacious", bądź terminów rozpoczynających się od prefiksu"air-condition". Parametr "searchMode" jest używany do dopasowania dowolnego terminu (co jest ustawieniem domyślnym) lub wszystkich terminów, w przypadkach, gdy termin nie jest jawnie wymagany (+).Porządkuje wynikowy zestaw hoteli w pobliżu danej lokalizacji geograficznej, a następnie zwraca wyniki do aplikacji wywołującej.
Większość tego artykułu dotyczy przetwarzania zapytania wyszukiwania: "Spacious, air-condition* +\"Ocean view\"". Filtrowanie i sortowanie są poza zakresem. Aby uzyskać więcej informacji, zobacz dokumentację referencyjną interfejsu API wyszukiwania.
Etap 1. Analizowanie zapytań
Jak wspomniano, ciąg zapytania jest pierwszym wierszem żądania:
"search": "Spacious, air-condition* +\"Ocean view\"",
Analizator zapytań oddziela operatory (takie jak * i + w przykładzie) od terminów wyszukiwania i rozbiera zapytanie wyszukiwania na podzapytania obsługiwanego typu:
- zapytanie dla terminów dla samodzielnych terminów (na przykład spacious)
- zapytanie frazowe dla cytowanych terminów (takich jak widok oceanu)
-
zapytanie prefiksu dla terminów, po którym następuje operator
*prefiksu (na przykład klimatyzator)
Aby uzyskać pełną listę obsługiwanych typów zapytań, zobacz Składnia zapytań Lucene.
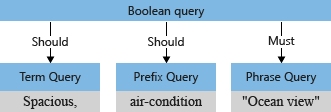
Operatory skojarzone z podzapytaniem określają, czy zapytanie "musi być" lub "powinno" być spełnione, aby dokument był traktowany jako dopasowanie. Na przykład "+"Ocean view"" jest koniecznością z powodu operatora "+".
Analizator zapytań zmienia strukturę podzapytania na drzewo zapytań (wewnętrzną strukturę reprezentującą zapytanie), które przekazuje do aparatu wyszukiwania. W pierwszym etapie analizowania zapytań drzewo zapytań wygląda następująco:
Obsługiwane analizatory: Prosty analizator Lucene i Pełny analizator Lucene
Wyszukiwanie AI platformy Azure uwidacznia dwa różne języki zapytań: simple (ustawienie domyślne) i full. Poprzez ustawienie parametru queryType w zapytaniu wyszukiwania, informujesz analizator zapytań, jaki język zapytań wybierasz, żeby wiedział, jak interpretować operatory i składnię.
Język prostych zapytań jest intuicyjny i niezawodny, często odpowiedni do interpretowania danych wejściowych użytkownika as-is bez przetwarzania po stronie klienta. Obsługuje ona operatory zapytań znane z wyszukiwarek internetowych.
Język zapytań Full Lucene, który można uzyskać, ustawiając
queryType=full, rozszerza domyślny prosty język zapytań, dodając obsługę większej liczby operatorów i typów zapytań, takich jak symbol wieloznaczny, rozmyty, regex i zapytania w zakresie pól. Na przykład wyrażenie regularne wysyłane w składni prostego zapytania będzie interpretowane jako ciąg zapytania, a nie wyrażenie. Przykładowe żądanie w tym artykule używa języka zapytań Full Lucene.
Wpływ funkcji searchMode na analizator
Innym parametrem żądania wyszukiwania, który ma wpływ na analizowanie, jest parametr "searchMode". Steruje on operatorem domyślnym dla zapytań logicznych: dowolny (domyślny) lub wszystkie.
Gdy parametr "searchMode=any", który jest domyślnym ogranicznikiem przestrzeni między przestronnym a klimatyzatorem jest OR (||), co powoduje, że przykładowy tekst zapytania jest odpowiednikiem:
Spacious,||air-condition*+"Ocean view"
Jawne operatory, takie jak + w +"Ocean view", są jednoznaczne w konstrukcji zapytania boole'owskiego (termin musi pasować). Mniej oczywiste jest, jak interpretować pozostałe terminy: przestronny i klimatyzujący. Czy wyszukiwarka powinna znaleźć dopasowania z widokiem na ocean i przestronnym i klimatyzowanym pokojem? A może znaleźć widok oceanu plus którykolwiek z pozostałych terminów?
Domyślnie ("searchMode=any"), wyszukiwarka przyjmuje szerszą interpretację. Należy dopasować któreś z pól, odzwierciedlając semantykę "lub". Początkowe drzewo zapytań zilustrowane wcześniej z dwiema operacjami "powinna" pokazuje wartość domyślną.
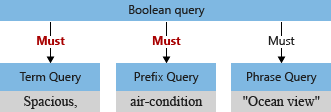
Załóżmy, że teraz ustawiliśmy wartość "searchMode=all". W tym przypadku spacja jest interpretowana jako operacja "i". Oba pozostałe terminy muszą być obecne w dokumencie, aby być uznane za zgodne. Wynikowe przykładowe zapytanie zostanie zinterpretowane w następujący sposób:
+Spacious,+air-condition*+"Ocean view"
Zmodyfikowane drzewo zapytań dla tego zapytania, w którym pasujący dokument jest skrzyżowaniem wszystkich trzech podzapytania, wygląda następująco:
Uwaga
Wybranie opcji "searchMode=any" zamiast "searchMode=all" jest decyzją, którą najlepiej podjąć po uruchomieniu reprezentatywnych zapytań. Użytkownicy, którzy mogą stosować operatory (co jest typowe podczas przeszukiwania magazynów dokumentów), mogą uznać wyniki za bardziej intuicyjne, jeśli "searchMode=all" wpływa na logiczne konstrukcje zapytań. Aby uzyskać więcej informacji na temat współdziałania między "searchMode" a operatorami, zobacz Prosta składnia zapytań.
Etap 2. Analiza leksykalna
Analizatory leksykalne przetwarzają zapytania terminów i zapytania frazowe po zbudowaniu drzewa zapytań. Analizator akceptuje dane wejściowe tekstu podane przez parser, przetwarza tekst, a następnie wysyła tokenizowane terminy do uwzględnienia w drzewie zapytań.
Najczęstszą formą analizy leksykalnej jest analiza językowa, która przekształca terminy zapytań na podstawie reguł specyficznych dla danego języka. Obejmuje to:
- Zmniejszenie terminu zapytania do głównej formy wyrazu.
- Usuwanie nieistotnych słów (stopwords, takich jak "the" lub "and" w języku angielskim).
- Dzielenie wyrazu złożonego na części składników.
- Zamiana wyrazów z wielkich liter na małe litery.
Wszystkie te operacje mają tendencję do wymazania różnic między wprowadzaniem tekstu dostarczonym przez użytkownika a terminami przechowywanymi w indeksie. Takie operacje wykraczają poza przetwarzanie tekstu i wymagają dogłębnej wiedzy na temat samego języka. Aby dodać tę warstwę świadomości językowej, Wyszukiwanie AI platformy Azure obsługuje długą listę analizatorów językowych zarówno z Lucene, jak i Microsoft.
Uwaga
W zależności od scenariusza wymagania dotyczące analizy mogą wahać się od minimalnych do skomplikowanych. Złożoność analizy leksykalnej można kontrolować, wybierając jeden ze wstępnie zdefiniowanych analizatorów lub tworząc własny analizator custom analyzer. Analizatory są ograniczone do pól z możliwością wyszukiwania i są określane jako część definicji pola. Umożliwia to różnice w analizie leksykalnej dla poszczególnych pól. Jeśli nie określono, używany jest standardowy analizator Lucene.
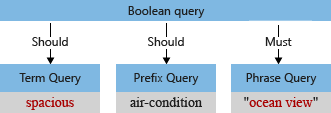
W naszym przykładzie, przed analizą, pierwotne drzewo zapytań zawiera termin "Przestronny", z wielką literą "S" i przecinkiem. Analizator zapytań interpretuje przecinek jako część terminu zapytania (przecinek nie jest uważany za operator języka zapytań).
Gdy analizator domyślny przetwarza termin, zmieni na małe litery "widok oceanu" oraz "przestronny" oraz usunie znak przecinka. Zmodyfikowane drzewo zapytań wygląda następująco:
Testowanie zachowań analizatora
Zachowanie analizatora można przetestować przy użyciu interfejsu API analizowania. Podaj tekst, który chcesz przeanalizować, aby zobaczyć, jakie terminy generuje dany analizator. Aby na przykład zobaczyć, jak standardowy analizator przetworzy tekst "klimatyzator", możesz wydać następujące żądanie:
{
    "text": "air-condition",
    "analyzer": "standard"
}
Analizator standardowy dzieli tekst wejściowy na następujące dwa tokeny, dodając do nich adnotacje z atrybutami takimi jak przesunięcia początkowe i końcowe (używane do wyróżniania trafień), a także ich pozycja (używana do dopasowywania fraz):
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
Wyjątki od analizy leksykalnej
Analiza leksykalna ma zastosowanie tylko do typów zapytań, które wymagają pełnych terminów, zapytania terminowego lub zapytania frazy. Nie dotyczy typów zapytań z niepełnymi terminami — zapytania prefiksowego, zapytania z wieloznacznikiem, zapytania regex — ani zapytania rozmytego. Typy zapytań takie jak zapytanie z prefiksem z terminem air-condition* na przykład są dodawane bezpośrednio do drzewa zapytań, z pominięciem etapu analizy. Jedyną transformacją wykonywaną na terminach zapytania tych typów jest zamiana na małe litery.
Etap 3. Pobieranie dokumentu
Pobieranie dokumentu odnosi się do znajdowania dokumentów ze zgodnymi terminami w indeksie. Ten etap najlepiej rozumie się za pomocą przykładu. Zacznijmy od indeksu hoteli, który ma następujący prosty schemat:
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
Ponadto przyjęto założenie, że ten indeks zawiera następujące cztery dokumenty:
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
Jak są indeksowane terminy
Aby zrozumieć pobieranie, warto zapoznać się z kilkoma podstawowymi informacjami na temat indeksowania. Jednostka przechowywania jest odwróconym indeksem, po jednym dla każdego przeszukiwalnego pola. W indeksie odwróconym jest posortowana lista wszystkich terminów ze wszystkich dokumentów. Każdy termin jest mapowany na listę dokumentów, w których występuje, co widać w poniższym przykładzie.
Aby utworzyć terminy w indeksie odwróconym, wyszukiwarka wykonuje analizę leksykalną nad zawartością dokumentów, podobnie jak w przypadku przetwarzania zapytań:
- Dane wejściowe tekstu są przekazywane do analizatora, gdzie są konwertowane na małe litery, pozbawione znaków interpunkcyjnych, itd., w zależności od konfiguracji analizatora.
- Tokeny to dane wyjściowe analizy leksykalnej.
- Terminy są dodawane do indeksu.
Często zdarza się, ale nie jest to wymagane, aby używać tych samych analizatorów do operacji wyszukiwania i indeksowania, aby terminy zapytania wyglądały bardziej jak terminy wewnątrz indeksu.
Uwaga
Wyszukiwanie AI platformy Azure umożliwia określenie różnych analizatorów indeksowania i wyszukiwania za pośrednictwem dodatkowych parametrów pól indexAnalyzer i searchAnalyzer. Jeśli nie określono, analizator ustawiony z właściwością analyzer jest używany zarówno do indeksowania, jak i wyszukiwania.
Odwrócony indeks dla przykładowych dokumentów
Wracając do naszego przykładu, w polu tytułu odwrócony indeks wygląda następująco:
| Termin | Lista dokumentów |
|---|---|
| Atman | 1 |
| plaża | 2 |
| Hotel | 1, 3 |
| ocean | 4 |
| Playa | 3 |
| Kurort | 2 |
| wycofanie się | 4 |
W polu tytułu tylko hotel jest wyświetlany w dwóch dokumentach: 1 i 3.
W polu opisu indeks wygląda następująco:
| Termin | Lista dokumentów |
|---|---|
| Powietrze | 3 |
| I | 4 |
| plaża | 1 |
| Uwarunkowane | 3 |
| Komfortowe | 3 |
| Odległość | 1 |
| Wyspa | 2 |
| kauaʻi | 2 |
| Znajdujące się | 2 |
| północ | 2 |
| ocean | 1, 2, 3 |
| z | 2 |
| Na | 2 |
| cichy | 4 |
| Pokoje | 1, 3 |
| Zaciszne | 4 |
| brzeg | 2 |
| Przestronne | 1 |
| Tthe | 1, 2 |
| do | 1 |
| widok | 1, 2, 3 |
| Chodzenie | 1 |
| Z | 3 |
Dopasowywanie terminów zapytania względem indeksowanych terminów
Biorąc pod uwagę odwrócone indeksy powyżej, wróćmy do przykładowego zapytania i zobaczmy, jak pasujące dokumenty znajdują się w naszym przykładowym zapytaniu. Przypomnij sobie, że końcowe drzewo zapytań wygląda następująco:
Podczas wykonywania zapytania poszczególne zapytania są wykonywane niezależnie względem pól z możliwością wyszukiwania.
TermQuery, „spacious”, dopasowuje się do dokumentu 1 (Hotel Atman).
Zapytanie o prefiks "air-condition*" nie pasuje do żadnych dokumentów.
Takie zachowanie czasami wprowadza w błąd deweloperów. Mimo że termin klimatyzowany istnieje w dokumencie, jest on podzielony na dwa terminy przez domyślny analizator. Pamiętaj, że zapytania prefiksów, które zawierają częściowe terminy, nie są analizowane. W związku z tym terminy z prefiksem "klimatyzator" są sprawdzane w indeksie odwróconym i nie można go odnaleźć.
Query frazowe, "widok oceanu", wyszukuje terminy "ocean" i "widok" oraz sprawdza bliskość terminów w oryginalnym dokumencie. Dokumenty 1, 2 i 3 pasują do tego zapytania w polu opisu. Zwróć uwagę, że dokument 4 zawiera termin "ocean" w tytule, ale nie jest uznawany za dopasowanie, ponieważ szukamy frazy "widok oceanu", a nie pojedynczych słów.
Uwaga
Zapytanie wyszukiwania jest wykonywane niezależnie względem wszystkich pól z możliwością wyszukiwania w indeksie Wyszukiwanie AI platformy Azure, chyba że ograniczysz pola ustawione za pomocą parametru searchFields, jak pokazano w przykładowym żądaniu wyszukiwania. Zwracane są dokumenty zgodne z dowolnymi wybranymi polami.
Ogólnie rzecz biorąc, dla danego zapytania pasujące dokumenty to 1, 2 i 3.
Etap 4. Ocenianie
Każdy dokument w zestawie wyników wyszukiwania ma przypisany wynik istotności. Funkcja oceny istotności polega na wyższej klasyfikacji tych dokumentów, które najlepiej odpowiadają na pytanie użytkownika wyrażone przez zapytanie wyszukiwania. Wynik jest obliczany na podstawie właściwości statystycznych terminów, które są zgodne. Podstawą formuły oceniania jest częstość występowania terminu–odwrotna częstość dokumentów (TF/IDF). W zapytaniach zawierających rzadkie i typowe terminy tf/IDF promuje wyniki zawierające rzadki termin. Na przykład w hipotetycznym indeksie zawierającym wszystkie artykuły Wikipedii, dokumenty pasujące do zapytania prezydent są uważane za bardziej istotne niż te pasujące do tego.
Przykład oceniania
Przypomnij sobie trzy dokumenty pasujące do naszego przykładowego zapytania:
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
Dokument 1 najlepiej pasuje do zapytania, ponieważ w polu opisu występuje zarówno termin przestronny, jak i wymagana fraza widok oceanu. Dwa następne dokumenty pasują tylko do frazy widok oceanu. Może być zaskoczeniem, że wyniki istotności dokumentów 2 i 3 są różne, mimo że pasują do zapytania w taki sam sposób. Wynika to z faktu, że formuła oceniania ma więcej składników niż tylko tf/IDF. W tym przypadku do dokumentu 3 przypisano nieco wyższy wynik, ponieważ jego opis jest krótszy. Dowiedz się więcej o praktycznej formule oceniania Lucene, aby zrozumieć, jak długość pola i inne czynniki mogą wpływać na ocenę istotności.
Niektóre typy zapytań (symbol wieloznaczny, prefiks i regex) zawsze przyczyniają się do stałego wyniku dla ogólnego wyniku dokumentu. Umożliwia to uwzględnianie dopasowań za pomocą rozszerzenia zapytania w wynikach bez wpływu na klasyfikację.
Przykład ilustruje, dlaczego ma to znaczenie. Wyszukiwania symboli wieloznacznych, w tym wyszukiwania prefiksów, są niejednoznaczne według definicji, ponieważ dane wejściowe są ciągiem częściowym z potencjalnymi dopasowaniami w bardzo dużej liczbie różnych terminów. Weź pod uwagę dane wejściowe "tour*", z dopasowaniami znalezionymi w "tours", "tourettes" i "tourmaline". Biorąc pod uwagę charakter tych wyników, nie ma sposobu, aby rozsądnie wywnioskować, które terminy są cenniejsze niż inne. Z tego powodu ignorujemy częstotliwości terminów podczas oceniania wyników w zapytaniach z symbolami wieloznacznymi, prefiksami i wyrażeniami regularnymi. W wieloczęściowym żądaniu wyszukiwania zawierającym częściowe i kompletne terminy, wyniki z częściowych danych wejściowych są uwzględniane ze stałą wartością punktową, aby uniknąć tendencji do potencjalnie nieoczekiwanych dopasowań.
Dostrajanie istotności
Istnieją dwa sposoby dostosowywania wyników istotności w Wyszukiwanie AI platformy Azure:
Profile rankingowe awansują dokumenty w uporządkowanej liście wyników na podstawie zestawu reguł. W naszym przykładzie możemy rozważyć dokumenty pasujące do pola tytułu bardziej istotne niż dokumenty pasujące do pola opisu. Ponadto, jeśli nasz indeks miał pole cenowe dla każdego hotelu, możemy promować dokumenty o niższych cenach. Dowiedz się więcej o dodawaniu profilów oceniania do indeksu wyszukiwania.
Wzmocnienie wyszukiwania terminu (dostępne tylko w składni pełnej kwerendy Lucene) udostępnia operator
^wzmocnienia, który można zastosować do dowolnej części drzewa zapytań. W naszym przykładzie, zamiast wyszukiwać na prefiksie klimatyzacji*, można wyszukać albo dokładny termin klimatyzacja albo prefiks, ale dokumenty pasujące do dokładnego terminu są klasyfikowane wyżej poprzez zastosowanie zwiększenia wartości zapytania terminu: klimatyzacja^2||klimatyzacja*. Dowiedz się więcej na temat zwiększania terminów w zapytaniu.
Ocenianie w indeksie rozproszonym
Wszystkie indeksy w Wyszukiwanie AI platformy Azure są automatycznie podzielone na wiele fragmentów, co pozwala nam szybko dystrybuować indeks między wiele węzłów podczas skalowania usługi w górę lub w dół. Gdy zostanie wysłane żądanie wyszukiwania, jest ono realizowane niezależnie dla każdego shardu. Wyniki z każdego fragmentu są następnie scalane i uporządkowane według wyniku (jeśli nie zdefiniowano żadnej innej kolejności). Warto wiedzieć, że funkcja oceniania waży częstotliwość terminu zapytania w stosunku do odwrotnej częstości dokumentu we wszystkich dokumentach w obrębie segmentu danych, a nie we wszystkich segmentach!
Oznacza to, że ocena istotności może być inna w przypadku identycznych dokumentów, jeśli znajdują się na różnych fragmentach. Na szczęście takie różnice zwykle znikają, ponieważ liczba dokumentów w indeksie rośnie z powodu bardziej równomiernego rozkładu terminów. Nie można założyć, na którym fragment zostanie umieszczony dowolny dany dokument. Jednak przy założeniu, że klucz dokumentu nie ulegnie zmianie, zawsze jest przypisany do tego samego fragmentu.
Ogólnie rzecz biorąc, ocena dokumentu nie jest najlepszym atrybutem do sortowania dokumentów, jeśli stabilność kolejności jest ważna. Na przykład, biorąc pod uwagę dwa dokumenty o identycznym wyniku, nie ma gwarancji, że jeden z nich pojawia się jako pierwszy w kolejnych uruchomieniach tego samego zapytania. Wynik dokumentu powinien tylko dawać ogólne pojęcie o istotności dokumentu na tle innych dokumentów w zestawie wyników.
Wniosku
Sukces komercyjnych wyszukiwarek wzbudził oczekiwania dotyczące pełnotekstowego wyszukiwania danych prywatnych. W przypadku niemal każdego rodzaju środowiska wyszukiwania oczekujemy, że aparat zrozumie naszą intencję, nawet jeśli terminy są błędnie napisane lub niekompletne. Możemy nawet spodziewać się dopasowań opartych na niemal równoważnych terminach lub synonimach, które nigdy nie zostały przez nas określone.
Z punktu widzenia technicznego wyszukiwanie pełnotekstowe jest wysoce złożone, wymagające zaawansowanej analizy językowej i systematycznego podejścia do przetwarzania w sposób destylowania, rozszerzania i przekształcania terminów zapytania w celu dostarczenia odpowiedniego wyniku. Biorąc pod uwagę nieodłączne złożoność, istnieje wiele czynników, które mogą mieć wpływ na wynik zapytania. Z tego powodu inwestowanie czasu, aby zrozumieć mechanikę wyszukiwania pełnotekstowego, oferuje namacalne korzyści podczas próby pracy z nieoczekiwanymi wynikami.
W tym artykule omówiono wyszukiwanie pełnotekstowe w kontekście Wyszukiwanie AI platformy Azure. Mamy nadzieję, że zapewnia wystarczające doświadczenie do rozpoznawania potencjalnych przyczyn i rozwiązań dotyczących rozwiązywania typowych problemów z zapytaniami.
Następne kroki
Skompiluj przykładowy indeks, wypróbuj różne zapytania i przejrzyj wyniki. Aby uzyskać instrukcje, zobacz Build i wykonaj zapytanie dotyczące indeksu w portalu Azure.
Wypróbuj inną składnię zapytań z sekcji przykłady Search Documents lub z prostej składni zapytań Simple query syntax w Eksploratorze wyszukiwania w portalu Azure.
Przejrzyj profile punktacji, jeśli chcesz dostosować klasyfikację w aplikacji wyszukiwania.
Stosowanie analizatorów leksykalnych specyficznych dla języka.
Skonfiguruj analizatory niestandardowe pod kątem minimalnego przetwarzania lub wyspecjalizowanego przetwarzania w określonych polach.