Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Uwaga
Foundry IQ (Wyszukiwanie AI platformy Azure) udostępnia bezpośrednie interfejsy API indeksowania i zapytań, a także interfejsy API wyższego poziomu dla źródeł wiedzy i baz wiedzy do zarządzanego pobierania. Użyj portalu Azure, interfejsów API REST lub Azure SDKs, aby skonfigurować te możliwości lub połączyć agentów z bazami wiedzy w portalu Microsoft Foundry.
Foundry IQ (Wyszukiwanie AI platformy Azure) akceptuje prosty zestaw wierszy jako dane wejściowe do potoku indeksowania. Jeśli dane źródłowe pochodzą z tabel sprzężonych w SQL Server relacyjnej bazie danych, w tym artykule wyjaśniono, jak utworzyć zestaw wierszy oraz jak modelować relację nadrzędny-podrzędny w indeksie IQ usługi Foundry.
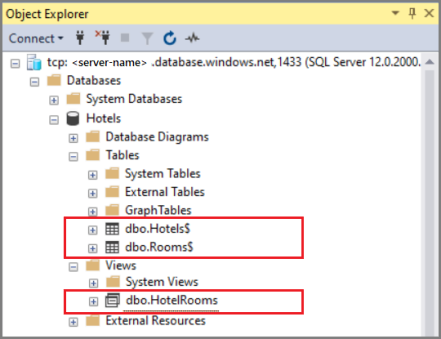
Jako przykład odnosimy się do hipotetycznej bazy danych hoteli, opartej na danych demonstracyjnych. Załóżmy, że baza danych składa się z Hotels$ tabeli z 50 hotelami i Rooms$ tabelą z pokojami o różnych typach, stawkach i udogodnieniach, w sumie 750 pokoi. Istnieje relacja jeden do wielu między tabelami. W naszym podejściu widok generuje zapytanie, które zwraca 50 wierszy, jeden wiersz na hotel, z osadzonymi szczegółowymi informacjami o pokojach w każdym wierszu.
Problem z zdenormalizowanymi danymi
Jednym z wyzwań związanych z pracą z relacjami "jeden do wielu" jest to, że standardowe zapytania oparte na tabelach sprzężonych zwracają zdenormalizowane dane, które nie działają dobrze w scenariuszu IQ rozwiązania Foundry. Rozważmy następujący przykład, który łączy hotele i pokoje.
SELECT * FROM Hotels$
INNER JOIN Rooms$
ON Rooms$.HotelID = Hotels$.HotelID
Wyniki tego zapytania zwracają wszystkie pola dotyczące hotelu, a następnie wszystkie pola dotyczące pokoju, przy czym wstępne informacje o hotelu są powtarzane dla każdej wartości pokoju.
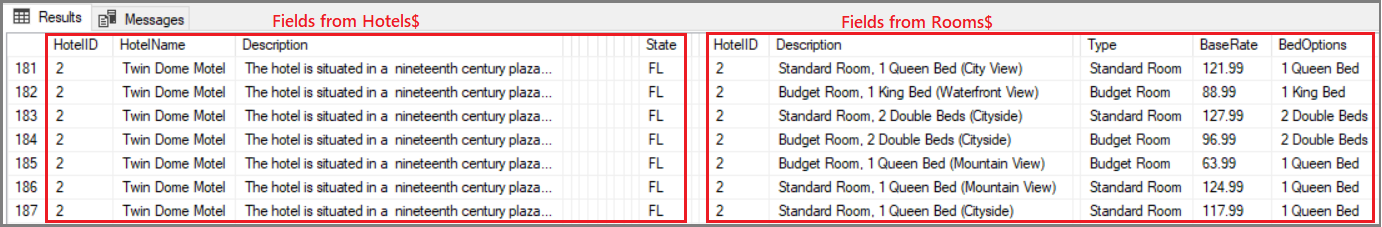
Chociaż to zapytanie na pierwszy rzut oka wydaje się udane (dostarczając wszystkie dane w prostym zbiorze wierszy), kończy się niepowodzeniem w zapewnieniu właściwej struktury dokumentu dla oczekiwanego środowiska wyszukiwania. Podczas indeksowania usługa Foundry IQ tworzy jeden dokument wyszukiwania dla każdego pozyskanego wiersza. Jeśli twoje dokumenty wyszukiwania wyglądałyby jak powyższe wyniki, zauważyłbyś duplikaty — siedem różnych dokumentów dotyczących tylko hotelu Old Century. Zapytanie dotyczące "hoteli na Florydzie" zwróci siedem wyników dla tylko Old Century Hotel, pchając inne odpowiednie hotele głęboko do wyników wyszukiwania.
Aby uzyskać oczekiwane efekty jednego dokumentu na hotel, należy podać zestaw wierszy o odpowiednią szczegółowością, ale z pełnymi informacjami. W tym artykule wyjaśniono, jak to zrobić.
Definiowanie zapytania zwracającego osadzony kod JSON
Aby zapewnić oczekiwane wrażenia z wyszukiwania, zestaw danych powinien składać się z jednego wiersza dla każdego dokumentu wyszukiwania w Foundry IQ. W naszym przykładzie chcemy mieć jeden wiersz dla każdego hotelu, ale chcemy, aby nasi użytkownicy mogli wyszukiwać w innych polach związanych z pokojem, na których im zależy, takich jak stawka za noc, wielkość i liczba łóżek lub widok na plażę, które wszystkie są częścią szczegółów pokoju.
Rozwiązaniem jest przechwycenie szczegółów pomieszczenia jako zagnieżdżonego kodu JSON, a następnie wstawienie struktury JSON do pola w widoku, jak pokazano w drugim kroku.
Załóżmy, że masz dwie tabele
Hotels$iRooms$, które zawierają szczegóły dla 50 hoteli i 750 pokoi oraz są połączone na polu HotelID. Indywidualnie te tabele zawierają 50 hoteli i 750 powiązanych pokoi.CREATE TABLE [dbo].[Hotels$]( [HotelID] [nchar](10) NOT NULL, [HotelName] [nvarchar](255) NULL, [Description] [nvarchar](max) NULL, [Description_fr] [nvarchar](max) NULL, [Category] [nvarchar](255) NULL, [Tags] [nvarchar](255) NULL, [ParkingIncluded] [float] NULL, [SmokingAllowed] [float] NULL, [LastRenovationDate] [smalldatetime] NULL, [Rating] [float] NULL, [StreetAddress] [nvarchar](255) NULL, [City] [nvarchar](255) NULL, [State] [nvarchar](255) NULL, [ZipCode] [nvarchar](255) NULL, [GeoCoordinates] [nvarchar](255) NULL ) ON [PRIMARY] TEXTIMAGE_ON [PRIMARY] GO CREATE TABLE [dbo].[Rooms$]( [HotelID] [nchar](10) NULL, [Description] [nvarchar](255) NULL, [Description_fr] [nvarchar](255) NULL, [Type] [nvarchar](255) NULL, [BaseRate] [float] NULL, [BedOptions] [nvarchar](255) NULL, [SleepsCount] [float] NULL, [SmokingAllowed] [float] NULL, [Tags] [nvarchar](255) NULL ) ON [PRIMARY] GOUtwórz widok składający się ze wszystkich pól w tabeli nadrzędnej (
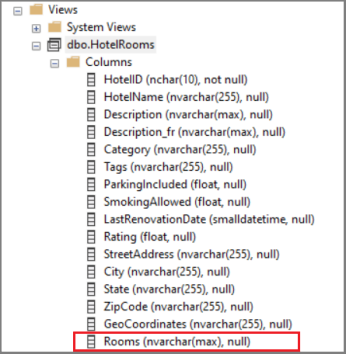
SELECT * from dbo.Hotels$), z dodatkiem nowego pola Rooms zawierającego dane wyjściowe zagnieżdżonego zapytania. Klauzula FOR JSON AUTO strukturyzuje wynik jako JSON.CREATE VIEW [dbo].[HotelRooms] AS SELECT *, (SELECT * FROM dbo.Rooms$ WHERE dbo.Rooms$.HotelID = dbo.Hotels$.HotelID FOR JSON AUTO) AS Rooms FROM dbo.Hotels$ GOPoniższy zrzut ekranu przedstawia wynikowy widok z polem Rooms nvarchar u dołu. Pole Pokoje istnieje tylko w widoku HotelRooms.
Uruchom polecenie
SELECT * FROM dbo.HotelRooms, aby pobrać zestaw wierszy. Zapytanie zwraca 50 wierszy, po jednym na hotel, z powiązanymi informacjami o pokoju w formie kolekcji JSON.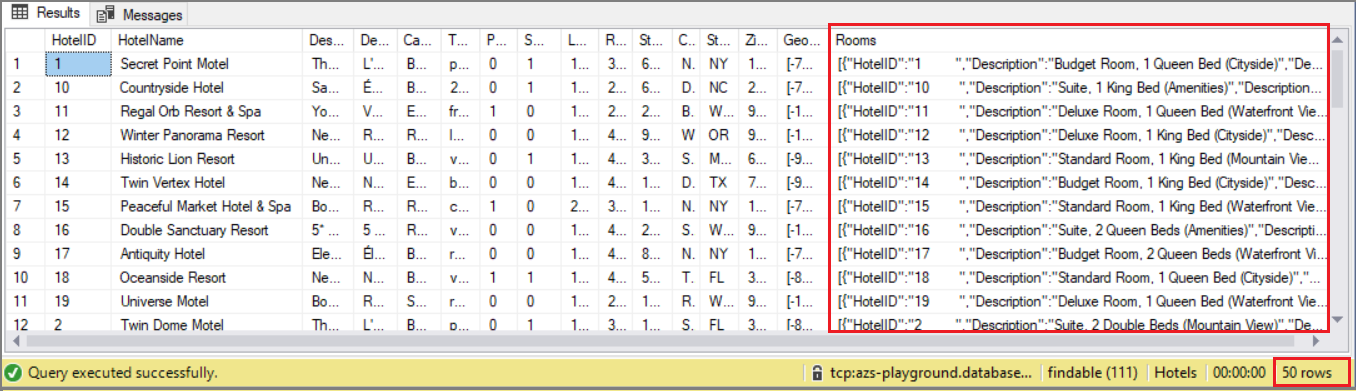
Ten zestaw wierszy jest teraz gotowy do zaimportowania do Foundry IQ.
Uwaga
W tym podejściu przyjęto założenie, że osadzony kod JSON jest w granicach maksymalnego rozmiaru kolumn programu SQL Server.
Użyj złożonej kolekcji dla strony 'wiele' relacji jeden do wielu
Po stronie IQ usługi Foundry utwórz schemat indeksu, który modeluje relację jeden do wielu przy użyciu zagnieżdżonego kodu JSON. Zestaw wyników utworzony w poprzedniej sekcji zazwyczaj odpowiada podanemu schematowi indeksu (wycinamy niektóre pola w celu zwięzłości).
Poniższy przykład jest podobny do przykładu w temacie Jak modelować złożone typy danych. Struktura Rooms , która koncentruje się na tym artykule, znajduje się w kolekcji pól indeksu o nazwie hotels. W tym przykładzie przedstawiono również złożony typ dla Address, który różni się od Rooms tym, że składa się z ustalonego zestawu elementów, w przeciwieństwie do wielu, dowolnej liczby elementów dozwolonych w kolekcji.
{
  "name": "hotels",
  "fields": [
    { "name": "HotelId", "type": "Edm.String", "key": true, "filterable": true },
    { "name": "HotelName", "type": "Edm.String", "searchable": true, "filterable": false },
    { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
    { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
    { "name": "Category", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": true },
    { "name": "ParkingIncluded", "type": "Edm.Boolean", "filterable": true, "facetable": true },
    { "name": "Tags", "type": "Collection(Edm.String)", "searchable": true, "filterable": true, "facetable": true },
    { "name": "Address", "type": "Edm.ComplexType",
      "fields": [
        { "name": "StreetAddress", "type": "Edm.String", "filterable": false, "sortable": false, "facetable": false, "searchable": true },
        { "name": "City", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true },
        { "name": "StateProvince", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true }
      ]
    },
    { "name": "Rooms", "type": "Collection(Edm.ComplexType)",
      "fields": [
        { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
        { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
        { "name": "Type", "type": "Edm.String", "searchable": true },
        { "name": "BaseRate", "type": "Edm.Double", "filterable": true, "facetable": true },
        { "name": "BedOptions", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": false },
        { "name": "SleepsCount", "type": "Edm.Int32", "filterable": true, "facetable": true },
        { "name": "SmokingAllowed", "type": "Edm.Boolean", "filterable": true, "facetable": false},
        { "name": "Tags", "type": "Edm.Collection", "searchable": true }
      ]
    }
  ]
}
Biorąc pod uwagę poprzedni zestaw wyników i powyższy schemat indeksu, masz wszystkie wymagane składniki dla pomyślnej operacji indeksowania. Spłaszczone zestaw danych spełnia wymagania dotyczące indeksowania, ale zachowuje szczegółowe informacje. W indeksie IQ usługi Foundry wyniki wyszukiwania można łatwo podzielić na jednostki hotelowe, zachowując kontekst poszczególnych pomieszczeń i ich atrybutów.
Zachowanie faset w polach podrzędnych typu złożonego
Pola, które mają obiekt nadrzędny, takie jak pola w obszarze Adres i Pokoje, są nazywane polami podrzędnymi. Chociaż można przypisać atrybut "facetable" do pola podrzędnego, liczba aspektów jest zawsze dla dokumentu głównego.
W przypadku typów złożonych, takich jak Adres, gdzie w dokumencie występuje tylko jeden "Adres/miasto" lub "Adres/stan/prowincja", zachowanie facetu działa zgodnie z oczekiwaniami. Jednak w przypadku pomieszczeń, w których istnieje wiele dokumentów podrzędnych dla każdego dokumentu głównego, liczby aspektów mogą być mylące.
Jak wspomniano w Modelu typów złożonych: "liczba dokumentów zwracanych w wynikach fasetowych jest obliczana dla dokumentu głównego (hotel), a nie dla dokumentów podrzędnych w złożonej kolekcji (pokoje). Załóżmy na przykład, że hotel ma 20 pokoi typu "suite". Biorąc pod uwagę ten parametr facet=Rooms/Type, liczba facetu wynosi jeden dla hotelu, a nie 20 dla pokoi.
Następne kroki
Korzystając z własnego zestawu danych, możesz użyć Kreatora importu danych, aby utworzyć i załadować indeks. Kreator wykrywa osadzoną kolekcję JSON, taką jak ta zawarta w Rooms, i wywnioskuje schemat indeksu, który zawiera kolekcję typów złożonych.
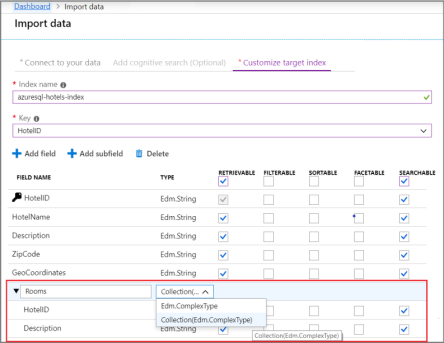
Wypróbuj poniższy przewodnik Szybki start, aby poznać podstawowe kroki kreatora importowania danych .