Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Opmerking
Azure AI Zoeken is beschikbaar via de Azure-portal, REST API's en Azure-SDK's. Het vormt ook een basis voor Foundry IQ, de beheerde kennislaag die bedrijfsinhoud transformeert in herbruikbare, machtigingsbewuste knowledge bases voor agents in de Microsoft Foundry-portal.
Belangrijk
Functies, mogelijkheden of eigenschappen die zijn gemarkeerd (preview) vallen niet onder een service level agreement, worden niet aanbevolen voor productieworkloads en kunnen worden gewijzigd of beperkt voordat ze algemeen beschikbaar worden. De Azure AI Zoeken preview-voorwaarden zijn van toepassing op alle preview-functionaliteit, ongeacht of deze zelfstandig is of deel uitmaakt van een algemeen beschikbare functie.
In Azure AI Zoeken kunt u een filterexpressie gebruiken om insluitings- of uitsluitingscriteria toe te voegen aan een vectorquery. U kunt ook een filtermodus opgeven waarmee het filter wordt toegepast:
- Voordat de query wordt uitgevoerd, ook wel prefiltering genoemd.
- Na het uitvoeren van query's, ook wel postfiltering genoemd.
- Nadat de globale topresultaten
kzijn geïdentificeerd, bekend als strikt postfiltering (preview).
In dit artikel wordt REST gebruikt voor illustratie. Zie de opslagplaats azure-search-vector-samples GitHub voor codevoorbeelden in andere talen en end-to-end-oplossingen die vectorquery's bevatten.
U kunt ook Search Explorer in de Azure-portal gebruiken om query's uit te voeren op vectorinhoud. In de JSON-weergave kunt u filters toevoegen en de filtermodus opgeven.
Hoe filteren werkt in vectorqueries
Azure AI Zoeken maakt gebruik van het HNSW-algoritme (Hierarchical Navigable Small World) voor het zoeken naar geschatte dichtstbijzijnde buren (ANN), en slaat u HNSW-grafieken op over meerdere shards. Elke shard bevat een gedeelte van de hele index.
Filters zijn van toepassing op filterableniet-vectorvelden, zowel tekenreeks als numeriek, om zoekdocumenten op te nemen of uit te sluiten op basis van filtercriteria. Vectorvelden zelf zijn niet filterbaar, maar u kunt filters op andere velden in dezelfde index gebruiken om de documenten te beperken die worden beschouwd voor vectorzoekopdrachten. Als uw index geen geschikte tekst of numerieke velden bevat, controleert u op metagegevens van documenten die kunnen helpen bij het filteren, zoals LastModified of CreatedBy eigenschappen.
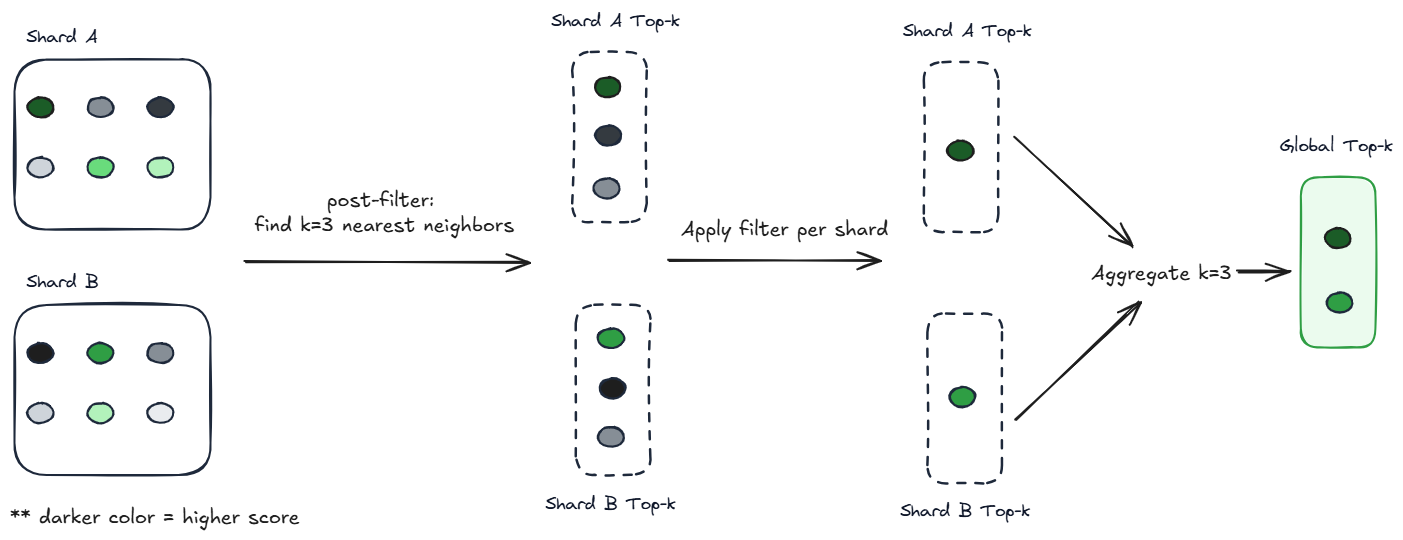
De vectorFilterMode parameter bepaalt waar filterbewerkingen worden toegepast tijdens de fasen van de zoekopdracht, die beïnvloeden hoe de resultaten worden gefilterd op een subset van items (zoals per categorie, tag of andere kenmerken) en invloed heeft op latentie, terugvinding en doorvoer. Er zijn drie modi:
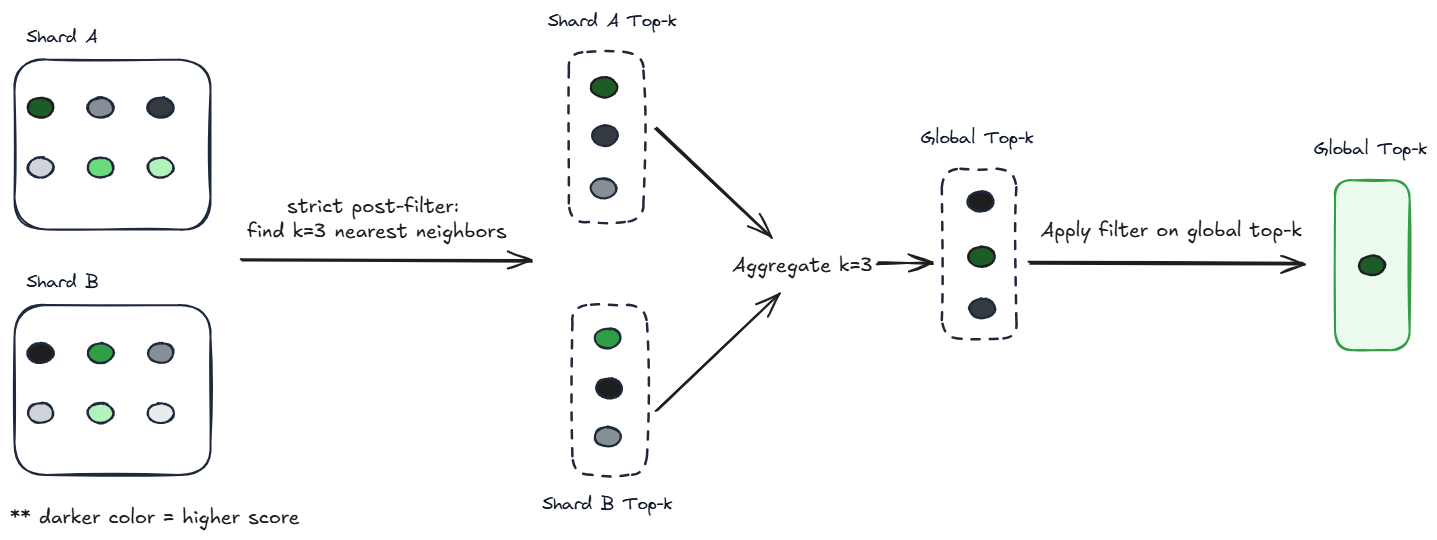
preFilterpast het filter toe tijdens de HNSW-traversal op elke shard. Deze modus maximaliseert de herinnering, maar kan meer van de graaf doorlopen, wat de CPU- en latency-belasting voor zeer selectieve filters kan verhogen.postFiltervoert HNSW-traversal uit en filtert op elke shard onafhankelijk, kruist resultaten op shardniveau en aggregert vervolgens de bovenkantkvan elke shard in een globale topk. Deze modus kan valse negatieven veroorzaken voor zeer selectieve filters of kleinekwaarden.strictPostFilter(preview) vindt de niet-gefilterde globale topkvoordat u het filter toepast. Deze modus heeft het hoogste risico om fout-negatieven te retourneren voor zeer selectieve filters en kleinekwaarden.
Zie De filtermodus instellen voor meer informatie over deze modi.
Een filter definiëren
Filters bepalen de reikwijdte van vectorquery's en worden gedefinieerd via Documents - Search Post (REST API). Tenzij u een preview-functie wilt gebruiken, gebruikt u de nieuwste stabiele versie van de REST API's van de Search Service om de aanvraag te formuleren.
Deze REST API biedt:
-
filtervoor de criteria. -
vectorFilterModeom op te geven wanneer het filter wordt toegepast tijdens de vectorquery. Zie De filtermodus instellen voor ondersteunde modi.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
In dit voorbeeld is het insluiten van vectoren gericht op het contentVector veld en zijn de filtercriteria van toepassing op category, een filterbaar tekstveld. Omdat de preFilter modus wordt gebruikt, wordt het filter toegepast voordat de zoekmachine de query uitvoert, zodat alleen documenten in de Databases categorie worden overwogen tijdens de vectorzoekopdracht.
De filtermodus instellen
De vectorFilterMode parameter bepaalt wanneer en hoe het filter wordt toegepast ten opzichte van de uitvoering van vectorquery's. U kunt de volgende modi gebruiken:
-
preFilter(aanbevolen) postFilter-
strictPostFilter(voorbeeld)
Opmerking
preFilter is de standaardwaarde voor indexen die na ongeveer 15 oktober 2023 zijn gemaakt. Voor indexen die vóór deze datum zijn gemaakt, postFilter is dit de standaardinstelling. Als u geavanceerde vectorfuncties, zoals vectorcompressie, wilt gebruiken preFilter , moet u de index opnieuw maken.
U kunt compatibiliteit testen door een vectorquery te verzenden met "vectorFilterMode": "preFilter" de 2023-10-01-preview REST API-versie of hoger. Als de query mislukt, ondersteunt uw index preFilter niet.
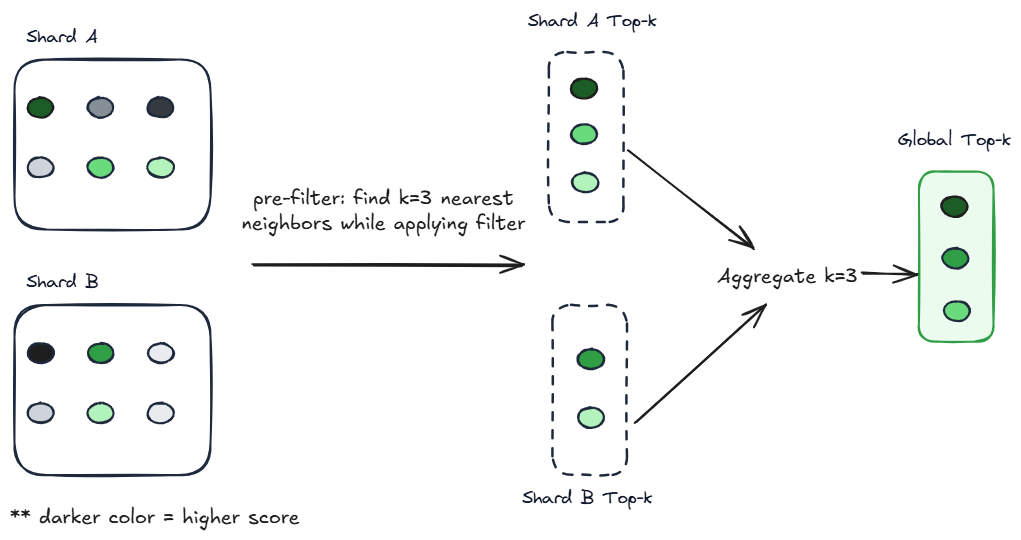
Met voorfiltering worden filters toegepast voordat query's worden uitgevoerd, waardoor de kandidaat die is ingesteld voor het vectorzoekalgoritmen wordt verminderd. De bovenstek resultaten worden vervolgens geselecteerd in deze gefilterde set.
In een vectorquery is preFilter de standaardmodus omdat het de voorkeur geeft aan ophalen en kwaliteit boven latentie.
Hoe deze modus werkt
Pas op elke shard het filterpredicaat toe tijdens het doorkruisen van HNSW en breid de grafiek uit totdat
kkandidaten zijn gevonden.De vooraf gefilterde lokale top-
kresultaten per shard produceren.De gefilterde resultaten samenvoegen in een globale top-
kresultatenset.
Effect van deze modus
Doorzoeken breidt het oppervlak van de zoekopdracht uit om meer gefilterde kandidaten te vinden, met name als het filter selectief is. Dit produceert de meest vergelijkbare topresultatenk voor alle shards. Elke shard identificeert de k resultaten die voldoen aan het filterpredicaat.
Voorfiltering garandeert dat k resultaten worden geretourneerd als ze aanwezig zijn in de index. Voor zeer selectieve filters kan dit ertoe leiden dat een aanzienlijk deel van de grafiek wordt doorkruist, waardoor de rekenkosten en latentie worden verhoogd terwijl de doorvoer wordt verminderd. Als uw filter zeer selectief is (zeer weinig overeenkomsten heeft), kunt u overwegen exhaustive: true om uitgebreide zoekopdrachten uit te voeren.
Vergelijkingstabel
| Modus | Ophalen (gefilterde resultaten) | Rekenkosten | Risico op valse negatieven | Wanneer gebruikt u |
|---|---|---|---|---|
preFilter |
Zeer hoog | Hoger (verhoogt met filterselectiviteit en complexiteit) | Geen risico |
Aanbevolen standaardinstelling voor alle scenario's, met name wanneer ophaalniveau essentieel is (delicate zoekdomeinen), bij het gebruik van selectieve filters of bij het gebruik van kleine k. |
postFilter |
Gemiddeld tot hoog (neemt af met de selectiviteit van het filter) | Vergelijkbaar met niet-gefilterd, maar neemt toe met filtercomplexiteit | Gemiddeld (kan overeenkomsten per shard missen) | Een optie voor filters die niet te selectief zijn en voor hogerek query's. |
strictPostFilter |
Laagste (vermindert het snelst met filterselectiviteit) | Vergelijkbaar met niet-gefilterd | Hoogste (kan mogelijk geen resultaten retourneren voor selectieve filters of klein k) |
Een optie voor facetzoektoepassingen waarbij het tonen van meer resultaten na het toepassen van filters meer invloed op de gebruikerservaring heeft dan het risico op fout-negatieven. Niet gebruiken met kleine k. |
Benchmarktests van prefiltering en postfiltering
Belangrijk
Deze sectie is van toepassing op voorfiltering en postfiltering, niet op strikte postfiltering.
Om inzicht te krijgen in de voorwaarden waaronder de ene filtermodus beter presteert dan de andere, hebben we een reeks tests uitgevoerd om queryresultaten te evalueren ten opzichte van kleine, middelgrote en grote indexen.
- Klein (100.000 documenten, 2,5 GB index, 1536 dimensies)
- Gemiddeld (1 miljoen documenten, index van 25 GB, 1536 dimensies)
- Groot (1 miljard documenten, index van 1,9 TB, 96 dimensies)
Voor de kleine en middelgrote workloads hebben we een Standard 2-service (S2) gebruikt met één partitie en één replica. Voor de grote workload hebben we een Standard 3-service (S3) gebruikt met 12 partities en één replica.
Indexen hadden een identieke constructie: één sleutelveld, één vectorveld, één tekstveld en één numeriek filterbaar veld. De volgende index wordt gedefinieerd met behulp van de 2023-11-01 syntaxis.
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
In query's hebben we een identiek filter gebruikt voor zowel prefilter- als postfilterbewerkingen. We hebben een eenvoudig filter gebruikt om ervoor te zorgen dat variaties in de prestaties te wijten waren aan de filtermodus, niet door filtercomplexiteit.
Resultaten zijn gemeten als queries per seconde (QPS).
Conclusies
Voorfiltering is bijna altijd langzamer dan postfiltering, behalve bij kleine indexen waarbij de prestaties ongeveer gelijk zijn.
Bij grotere gegevenssets is prefiltering ordes van grootte langzamer.
Waarom wordt de standaardinstelling vooraf gefilterd als deze bijna altijd langzamer is? Voorfiltering garandeert dat
kresultaten worden geretourneerd als ze aanwezig zijn in de index, waarbij de voorkeur wordt gegeven aan terugroepwaarde en precisie boven snelheid.Gebruik postfiltering als u:
Waardesnelheid ten opzichte van selectie (postfiltering kan minder dan
kresultaten retourneren).Gebruik filters die niet te selectief zijn.
Indexen van voldoende grootte hebben, zodat voorfilteringsprestaties onaanvaardbaar zijn.
Details
Gegeven een gegevensset met 100.000 vectoren bij 1536 dimensies:
Bij het filteren van meer dan 30% van de gegevensset waren prefiltering en postfiltering vergelijkbaar.
Bij het filteren van minder dan 0,1% van de gegevensset, was prefiltering ongeveer 50% trager dan postfiltering.
Gegeven een gegevensset met 1 miljoen vectoren bij 1536 dimensies:
Bij het filteren van meer dan 30% van de gegevensset was prefiltering ongeveer 30% langzamer.
Bij het filteren van minder dan 2% van de gegevensset was prefiltering ongeveer zeven keer trager.
Gegeven een gegevensset met 1 miljard vectoren bij 96 dimensies:
Bij het filteren van meer dan 5% van de gegevensset was prefiltering ongeveer 50% langzamer.
Bij het filteren van minder dan 10% van de gegevensset was prefiltering ongeveer zeven keer langzamer.
In de volgende grafiek zien we de relatieve voorfilter QPS, berekend als prefilter QPS gedeeld door postfilter QPS.
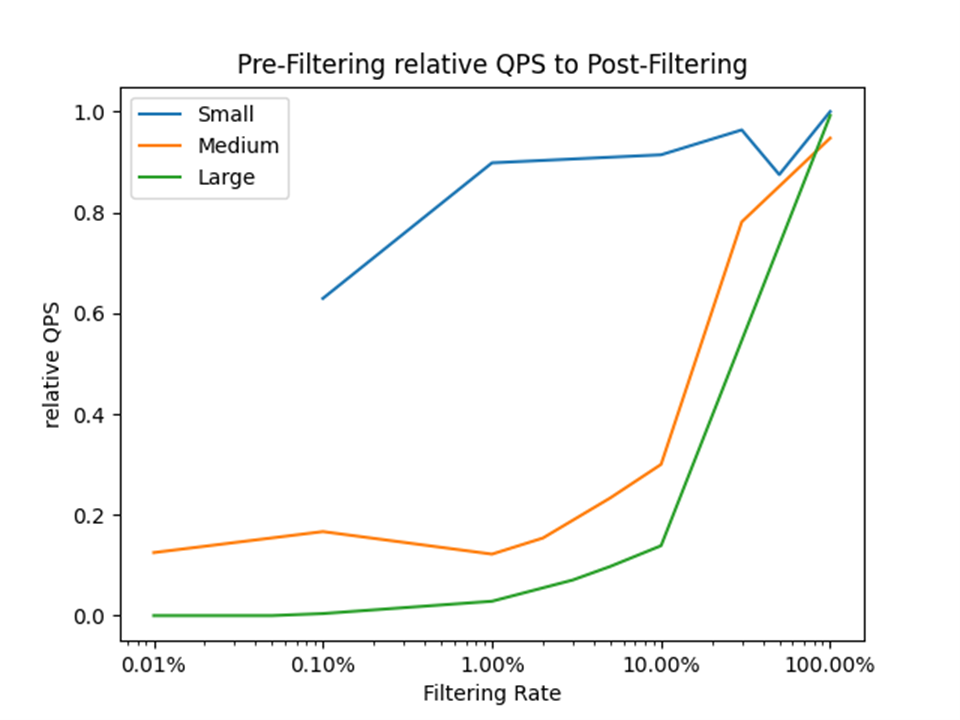
De verticale as vertegenwoordigt de relatieve prestaties van voorfiltering vergeleken met postfiltering, uitgedrukt als een verhouding van QPS (query's per seconde). Bijvoorbeeld:
- Een waarde van
0.0voorfiltering is 100% langzamer dan postfiltering. - Een waarde van
0.5betekent dat de voorfiltering 50% langzamer is. - Een waarde van
1.0betekent dat voorfiltering en postfiltering gelijkwaardig zijn.
De horizontale as vertegenwoordigt de filtersnelheid of het percentage kandidaatdocumenten na het toepassen van het filter. Een percentage 1.00% betekent bijvoorbeeld dat de filtercriteria één procent van het zoeklichaam hebben geselecteerd.