참고
Foundry IQ (Azure AI 검색)는 관리 검색을 위해 고급 수준의 지식 원본 및 지식 베이스 API와 함께 직접 인덱싱 및 쿼리 API를 제공합니다. Azure 포털, REST API 또는 Azure SDK 사용하여 이러한 기능을 구성하거나 Microsoft Foundry 포털의 기술 자료에 에이전트를 연결합니다.
경우에 따라 인덱서에는 오류가 생성되지 않거나 다른 Azure 서비스에서 발생하는 문제(예: 인증 중 또는 연결 중에)가 발생합니다. 이 문서에서는 안내해 주는 메시지가 없는 경우 인덱서 문제를 해결하는 데 중점을 둡니다. 또한 인덱싱 중에 사용되는 검색 대상이 아닌 리소스에서 발생하는 오류에 대한 문제 해결을 제공합니다.
참고
조사가 필요한 Foundry IQ(Azure AI 검색) 오류가 있는 경우에는 대신 일반적인 인덱서 오류 및 경고 문제 해결을 참조하세요.
모범 사례
다음은 인덱서로 작업할 때 몇 가지 모범 사례 및 권장 사항입니다.
인덱서는 일정에 따라 실행되도록 설계되었습니다.
- 신뢰할 수 있는 인덱싱의 경우 일반 일정에 따라 실행되도록 인덱서를 구성합니다. 예약된 실행은 일시적인 오류, 네트워크 중단 또는 임시 서비스 문제로 인해 이전 실행에서 누락된 문서를 자동으로 선택합니다. 이 방법은 데이터 일관성을 유지하고 수동 개입의 필요성을 최소화하는 데 도움이 됩니다.
- 큰 데이터 원본의 경우 초기 열거형 및 인덱싱에는 몇 시간 또는 며칠이 걸릴 수 있습니다. 일정에 따라 인덱서 실행하면 진행률이 계속되고 오류가 자동으로 다시 시도됩니다. 이러한 옵션은 동일한 안정성 또는 일시적인 오류 복구를 제공하지 않으므로 수동 또는 주문형 인덱서 실행에만 의존하지 마세요.
인덱서는 시간에 따른 최상의 인덱싱을 제공합니다.
- 기본 제공 인덱서는 영구 오류 없이 문서를 처리하고 예약된 실행에서 다시 시도합니다. 일반적인 시나리오를 위해 데이터를 인덱싱하는 편리하고 낮은 코드 또는 코드 없는 방법을 제공하므로 개발 속도가 빨라지고 유지 관리가 쉬워집니다. 인덱서가 기술 세트를 실행하는 경우 각 실행에는 고정 실행 시간 제한이 있습니다. 다중 테넌트 실행 환경에서 실행되는 인덱서는 최대 런타임이 2시간입니다. 이 제한은 기술 세트에 공유 프라이빗 링크가 필요하지 않은 경우에 사용되는 가장 일반적인 경우입니다. 공유 프라이빗 링크를 사용하도록 구성된 인덱서는 최대 24시간 동안 프라이빗 실행 환경에서 실행됩니다. 전체 테이블은 인덱서 제한을 참조하세요. 문서별 기술 세트 처리로 인해 인덱서가 시간 제한 이전에 완료되지 않으면 중지되고 나머지 문서는 처리되지 않습니다. 문서 볼륨, 파일 크기, 기술 세트 복잡성 또는 실행 환경에서 인덱서가 최대 실행 시간 내에 완료되지 않는 경우 완전한 처리가 보장되지 않습니다. 데이터 원본을 분할하면 이러한 위험을 줄일 수 있지만, 특히 나중에 파티션에 대량의 파일을 추가하는 경우 이러한 위험을 줄일 수는 없습니다. 이 동작은 예상된 것입니다. 큰 데이터 세트를 관리하고 증분 복구를 지원하는 전략은 큰 데이터 집합 인덱싱 및 인덱서 예약을 참조하세요. 인덱서가 문서를 처리하는 시기를 솔루션에 엄격하게 제어해야 하는 경우 이 문서의 Push API 대안을 사용합니다.
- 솔루션에서 인덱싱 타임라인을 엄격하게 제어해야 하는 경우 문서 인덱스 REST API 또는 IndexDocuments 메서드(.NET용 Azure SDK)와 같은 푸시 API를 대신 사용합니다. 이러한 옵션을 사용하면 인덱싱 파이프라인을 완전히 제어할 수 있습니다.
- 인덱서가 가끔 일정에서 벗어날 수 있습니다. 이 조건은 일반적이지 않으며 자동 복구 메커니즘이 존재하지만 복구에는 시간이 걸릴 수 있습니다. 이 동작은 예상된 것입니다.
실행 중 관리되는 ID 토큰이 만료됨
장기 실행 인덱서는 관리 ID 구성 및 역할 할당이 올바른 경우에도 유효하지 않거나 만료된 자격 증명을 보고할 수 있습니다. 인덱서가 원본 콘텐츠를 다운로드하거나 추출하는 동안 캐시된 토큰이 만료될 수 있습니다.
인덱서 실행이 시작되기 전에 Foundry IQ는 데이터 원본에 대해 캐시된 관리 ID 토큰을 확인합니다. 만료되기까지 60분 미만이 남아 있는 경우 Foundry IQ는 새 토큰을 요청합니다. 그렇지 않으면 캐시된 토큰을 다시 사용합니다. 이 자동 관리 새로 고침 검사는 일반적으로 콘텐츠 다운로드 또는 추출 중에 지속적으로 수행되지 않고 실행 전에 수행됩니다.
예를 들어, 캐시된 토큰은 실행이 시작될 때 유효 시간이 90분 남아 있어 Foundry IQ는 이를 재사용합니다. 인덱싱 작업이 90분이 지난 후에도 콘텐츠를 다운로드하거나 추출하고 있으면 토큰이 만료될 수 있습니다. 원본에 대한 다음 인증된 요청은 자격 증명이 유효하지 않거나 만료되었다는 메시지와 함께 실패할 수 있습니다.
구성 또는 권한 부여 문제와 이 일시적인 조건을 구분하십시오.
| Condition | 확인할 사항 |
|---|---|
| 장기 실행이 성공적으로 시작된 다음, 나중에 인증이 필요한 소스 요청에서 실패합니다. | 네트워크 및 원본 서비스 오류와 함께 토큰 만료를 고려합니다. 제네릭 자격 증명 메시지만으로는 원인을 알 수 없습니다. |
| 실행 시작 시를 포함하여 액세스가 일관되게 실패합니다. | 누락되거나 해지된 역할, 선택한 ID, 원본 리소스 ID, ID가 활성화되어 있는지 여부 및 데이터 원본 구성을 확인합니다. |
일시적인 토큰 만료를 확인한 후 다음과 같은 임시 완화를 고려합니다.
- 대규모 원본을 더 작은 워크로드로 분할합니다.
- 예약된 증분 실행을 사용하여 각 실행에 필요한 작업을 줄입니다.
- 실행당 다운로드되거나 추출된 콘텐츠의 양을 줄입니다.
- 일시적인 오류가 발생한 후 인덱서를 다시 실행합니다.
이러한 완화는 토큰 새로 고침 동작을 변경하거나 장기 실행 작업이 완료되도록 보장하지 않습니다. 중간 실행 오류에 만료된 자격 증명이 언급된다는 이유만으로 역할 할당을 확장하거나 유효한 자격 증명을 대체하지 마세요. 관리 ID 및 역할 구성에 대해서는 관리 ID 구성을 참조하세요.
실행 시간 제한이 종료된 후 수집이 완료되지 않음
콘텐츠 처리 실행이 실행 시간 할당량에 도달하고 처리 가능한 작업이 남아 있으면 검색은 연속 처리를 자동으로 대기열에 추가합니다. 큐 지연 자체는 실패한 연속 작업이 아니며, 지식 원본의 24시간 폴링 간격이 미완성 작업이 다음 일일 폴링까지 기다릴 필요가 없음을 의미합니다.
인덱서 상태 가져오기 및 실행 기록을 사용하여 할당량 중지 후 진행을 반복된 처리 실패와 구분합니다. 각 실행의 오류 메시지와 처리/실패한 항목 수를 확인합니다. 이후 실행만으로는 나머지 콘텐츠가 모두 인덱싱되었음을 입증하지는 않습니다.
반복 실행해도 진전이 없는 경우:
- 지속적인 소스 인증, 네트워크, 구문 분석 또는 스킬 오류를 확인합니다. 취소 및 구성 오류는 단순히 할당량 재개를 기다린다고 해서 복구되지 않습니다.
- 큰 문서나 비용이 많이 드는 기술이 실행 시간 한도를 반복적으로 소모하는지 확인합니다. 워크로드를 줄이거나 실제로 원본을 분할 합니다.
- S3 HD 및 서버리스의 경우 별도의 누적 런타임 할당량을 확인합니다. 계속은 이를 재정의하지 않습니다.
- 원본 및 구성을 수정한 후에도 설명할 수 없는 오류가 지속되면 지원 요청을 만듭니다.
향후 원본 변경에 필요한 되풀이 일정을 유지합니다. 계속을 가속화하기 위해 인덱서를 다시 설정하거나 주문형 실행을 반복적으로 제출하지 마세요.
제한된 리소스에 대한 연결 문제 해결
Azure 네트워크 보안이 적용되는 데이터 원본의 경우 인덱서는 연결 방법이 제한됩니다. 현재 인덱서는 공유 프라이빗 링크를 사용하여 IP 방화벽 뒤 또는 프라이빗 엔드포인트를 통해 가상 네트워크에서 제한된 데이터 원본에 액세스할 수 있습니다.
프라이빗 연결에서 Microsoft Foundry 리소스에 연결하는 동안 오류가 발생했습니다.
다음 메시지와 함께 오류 코드 403이 표시되면 기술 세트에 리소스 엔드포인트를 지정하는 방법에 문제가 있을 수 있습니다.
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
이 오류는 Azure Foundry 리소스에 연결하기 위해 공유 프라이빗 링크를 구성하고 엔드포인트에 사용자 지정 하위 도메인이 없는 경우에 발생합니다. 사용자 지정 하위 도메인은 엔드포인트의 첫 번째 부분입니다(예: http://my-custom-subdomain.services.ai.azure.com). Azure Portal 대신 Foundry 포털에서 리소스를 만든 경우 사용자 지정 도메인이 누락될 수 있습니다.
Foundry 리소스가 Foundry IQ와 동일한 지역에 없는 경우 키 없는 연결을 사용하여 리소스를 연결합니다.
공유 프라이빗 링크를 사용하는 동안 오류가 발생했습니다.
다음 메시지와 함께 오류 코드 403이 표시되면 인덱서가 승인된 공유 프라이빗 링크 대신 퍼블릭 엔드포인트를 통해 연결될 수 있습니다.
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
이 오류는 인덱서가 프라이빗 실행 환경을 사용하도록 구성되지 않은 경우에 발생할 수 있습니다. 공유 프라이빗 링크가 승인되었는지 확인하고, 인덱서의 executionEnvironmentprivate이름을 설정하고, 연결에서 올바른 리소스 엔드포인트 및 그룹 ID를 사용하는지 확인합니다.
방화벽 규칙
Azure Storage, Azure Cosmos DB 및 Azure SQL은 구성 가능한 방화벽을 제공합니다. 방화벽이 요청을 차단할 때 구체적인 오류 메시지는 없습니다. 일반적으로 방화벽 오류는 일반적입니다. 일반적인 오류는 다음과 같습니다.
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
인덱서가 이러한 리소스에 액세스할 수 있도록 하려면 다음 옵션 중 하나를 사용합니다.
Foundry IQ 서비스의 IP 주소 및
AzureCognitiveSearch의 IP 주소 범위에 대한 인바운드 규칙을 구성합니다. 각 데이터 원본 유형에 대한 IP 주소 범위 제한을 구성하는 방법에 대한 자세한 내용은 다음 링크를 참조하세요.최후의 수단으로 또는 임시 조치로, 모든 네트워크에서의 액세스를 허용하여 방화벽을 사용하지 않도록 설정합니다.
제한 사항: IP 주소 범위 제한은 Foundry IQ 서비스와 스토리지 계정이 다른 지역에 있는 경우에만 작동합니다.
인덱서는 데이터 검색 외에도 기술 세트 및 사용자 지정 기술을 통해 아웃바운드 요청을 보냅니다. Azure 함수를 기반으로 하는 사용자 지정 기술의 경우 Azure 함수에도 IP 주소 제한이 있다는 점에 유의하세요. 사용자 지정 기술 실행을 위해 허용할 IP 주소 목록에는 Foundry IQ 서비스의 IP 주소 및 AzureCognitiveSearch 서비스 태그의 IP 주소 범위가 포함됩니다.
NSG(네트워크 보안 그룹) 규칙
인덱서가 SQL 관리되는 인스턴스의 데이터에 액세스하거나 Azure VM이 사용자 지정 기술에 대한 웹 서비스 URI로 사용되는 경우 네트워크 보안 그룹은 요청이 허용되는지 여부를 결정합니다.
가상 네트워크 내에서 외부 리소스를 위해
가상 머신 연결에 대한 자세한 내용은 Azure VM에서 SQL Server 연결 구성을 참조하세요.
네트워크 오류
일반적으로 네트워크 오류는 일반적입니다. 일반적인 오류는 다음과 같습니다.
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
이러한 오류가 발생하면 다음을 수행합니다.
- Foundry IQ 서비스를 통해서가 아니라 직접 연결하여 소스에 액세스할 수 있는지 확인합니다.
- Azure 포털의 리소스에서 현재 오류 또는 중단이 있는지 확인합니다.
- Azure 상태의 네트워크 중단을 확인합니다.
- Azure 프라이빗 DNS 아닌 이름 확인에 공용 DNS를 사용하고 있는지 확인합니다.
레거시 공유 프라이빗 링크로 인해 S3 HD 서비스 업데이트가 실패함
공유 프라이빗 링크로 인해 서비스 업데이트가 유효성 검사에 실패하는 경우 SKU와 호스팅 모드를 모두 확인합니다. S3 HD(standard3 사용 hostingMode: HighDensity)는 이전 작업에서 리소스를 수락한 경우에도 아웃바운드 검색 공유 프라이빗 링크를 지원하지 않습니다. 관련 없는 크기 조정, ID, 태그, ARM 또는 Terraform 업데이트는 이 잘못된 레거시 상태를 노출할 수 있습니다.
변경하기 전에 검색 쪽 링크 및 종속 워크로드를 인벤토리로 작성합니다. 지원되는 대안을 식별하고, 중단을 평가하고, 레거시 S3 HD 공유 프라이빗 링크 수정을 따릅니다. 대상 쪽 프라이빗 엔드포인트 연결만 삭제하는 것만으로는 충분하지 않습니다. 리소스를 맹목적으로 삭제하거나 호스팅 모드를 변경하지 마세요.
Azure SQL 데이터베이스 서버리스 인덱싱(오류 코드 40613)
SQL 데이터베이스가 서버리스 컴퓨팅 계층에 있는 경우 인덱서가 연결될 때 데이터베이스가 실행 중이고 일시 중지되지 않았는지 확인합니다.
데이터베이스가 일시 중지된 경우 Foundry IQ 서비스의 첫 번째 로그인 시도는 데이터베이스를 자동으로 다시 시작하지만, 대신 데이터베이스를 사용할 수 없다는 오류가 반환되며 오류 코드 40613이 표시됩니다. 데이터베이스가 실행된 후 로그인을 다시 시도하여 연결을 설정합니다.
Microsoft Entra 조건부 액세스 정책
SharePoint 인덱서를 만들 때 디바이스 코드를 제공한 후 Microsoft Entra 앱에 로그인해야 합니다. 다음과 "Your sign-in was successful but your admin requires the device requesting access to be managed"같은 메시지가 표시되면 조건부 액세스 정책이 SharePoint 문서 라이브러리에서 인덱서를 차단할 수 있습니다.
정책을 업데이트하고 문서 라이브러리에 대한 인덱서 액세스를 허용하려면 다음을 수행합니다.
Azure Portal을 열고 Microsoft Entra 조건부 액세스를 검색합니다.
왼쪽 메뉴에서 정책을 선택합니다. 이 페이지를 볼 수 있는 액세스 권한이 없는 경우 액세스 권한이 있는 사용자를 찾거나 액세스 권한을 받아야 합니다.
SharePoint 인덱서가 문서 라이브러리에 액세스하지 못하도록 차단하는 정책을 결정합니다. 인덱서를 차단할 수 있는 정책에는 사용자 및 그룹 섹션의 인덱서 만들기 단계에서 인증하는 데 사용한 사용자 계정이 포함됩니다. 정책에는 다음과 같은 조건도 있을 수 있습니다.
- Windows 플랫폼을 제한합니다.
- 모바일 앱 및 데스크톱 클라이언트를 제한합니다.
- 디바이스 상태를예로 설정합니다.
인덱서가 차단되는 정책을 확인하면 인덱서에 대해 예외를 적용합니다. 먼저 Foundry IQ 서비스 IP 주소를 가져옵니다.
먼저 Foundry IQ 서비스의 FQDN(정규화된 도메인 이름)을 가져옵니다. FQDN은
<your-search-service-name>.search.windows.net과 같습니다. Azure Portal에서 FQDN을 찾을 수 있습니다.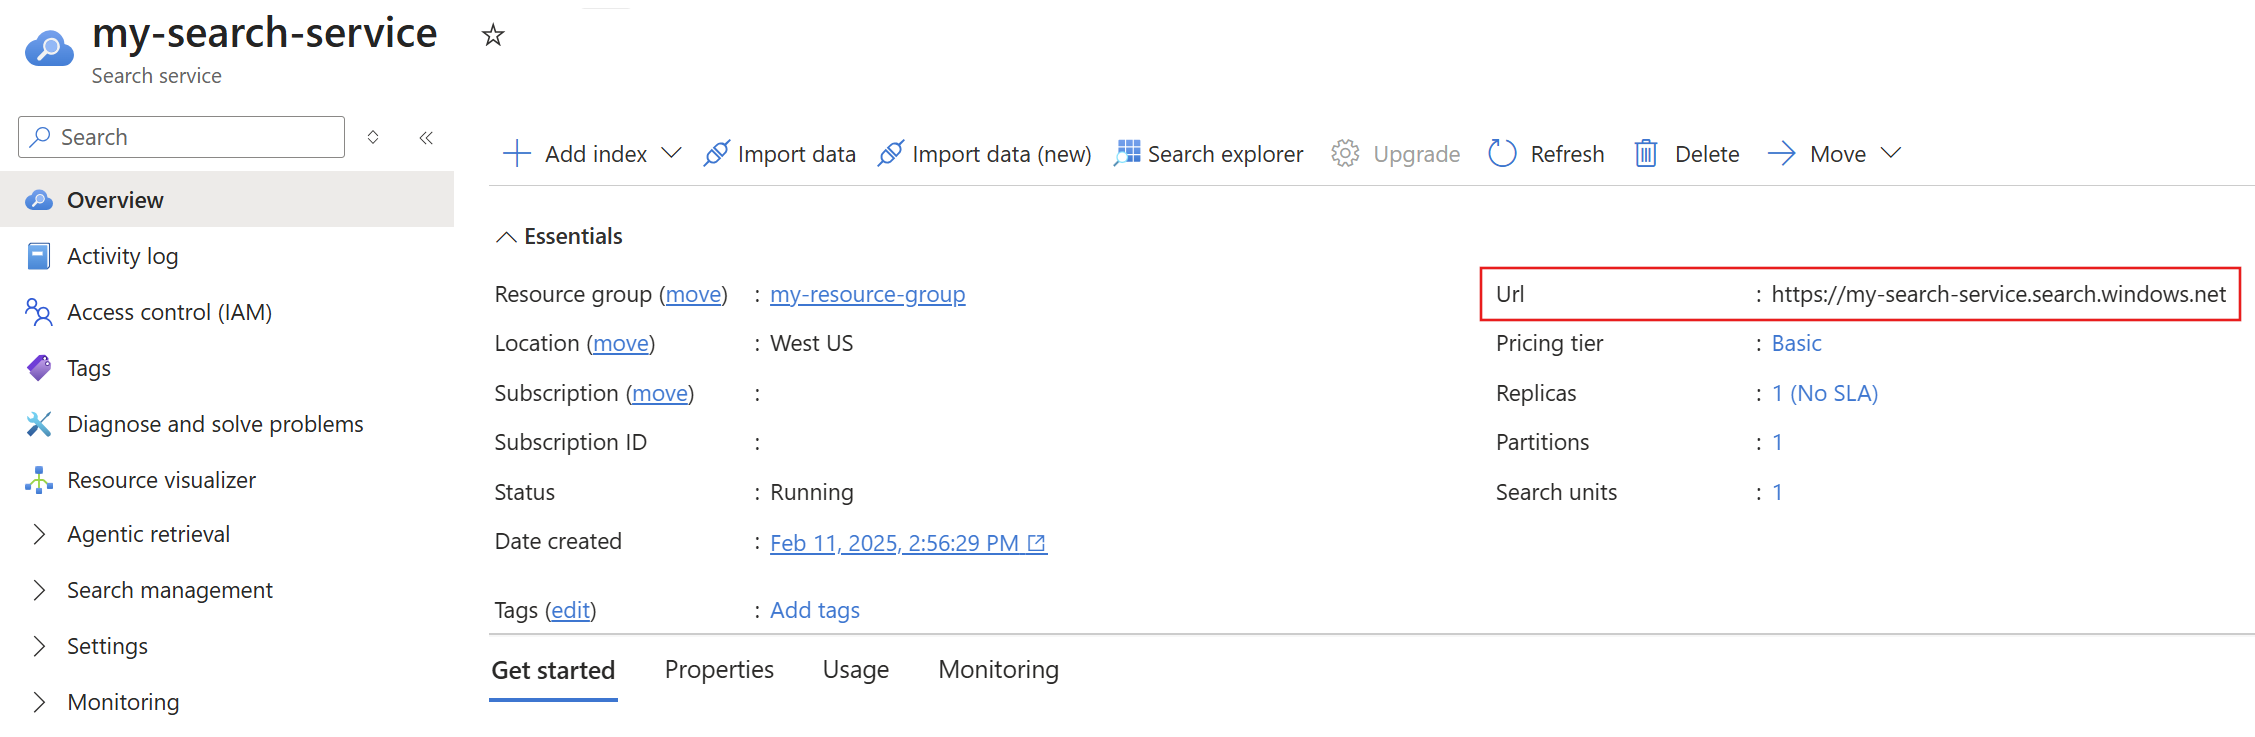
이제 FQDN이 있으므로 FQDN에 대해
ping(또는nslookup)를 수행하여 Foundry IQ 서비스의 IP 주소를 가져옵니다. 다음 예제에서는 Azure Storage 방화벽의 인바운드 규칙에150.0.0.1를 추가합니다. 방화벽 설정이 업데이트된 후 Foundry IQ 서비스 인덱서가 Azure Storage 계정에 액세스할 수 있게 되기까지 최대 15분이 걸릴 수 있습니다.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.net해당 지역의 인덱서 실행 환경에 대한 IP 주소 범위를 가져옵니다.
추가 IP 주소는 인덱서의 다중 테넌트 실행 환경에서 발생하는 요청에 사용됩니다. 이 IP 주소 범위는 서비스 태그에서 가져올 수 있습니다.
AzureCognitiveSearch또는 다운로드 가능한 JSON 파일을 통해 서비스 태그에 대한 IP 주소 범위를 가져올 수 있습니다.이 연습에서는 Foundry IQ 서비스가 Azure Public 클라우드에 있다고 가정하고 Azure Public JSON 파일을 다운로드합니다.
JSON 파일에서 Foundry IQ 서비스가 미국 중서부에 있다고 가정하면 다중 테넌트 인덱서 실행 환경의 IP 주소 목록이 나열됩니다.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
Azure Portal의 조건부 액세스 페이지로 돌아가서 왼쪽 메뉴에서 명명된 위치를 선택한 다음, + IP 범위 위치를 선택합니다. 명명된 새 위치에 이름을 지정하고 지난 두 단계에서 수집한 Foundry IQ 서비스 및 인덱서 실행 환경의 IP 범위를 추가합니다. 1
- Foundry IQ 서비스 IP 주소의 경우 유효한 IP 범위만 허용하므로 IP 주소의 끝에 "/32"를 추가해야 할 수 있습니다.
- 인덱서 실행 환경 IP 범위의 경우 Foundry IQ 서비스가 있는 지역의 IP 범위만 추가하면 됩니다.
정책에서 새 명명된 위치를 제외합니다.
- 왼쪽 메뉴에서 정책을 선택합니다.
- 인덱서를 차단하는 정책을 선택합니다.
- 조건을 선택합니다.
- 위치를 선택합니다.
- 제외를 선택한 다음, 새 명명된 위치를 추가합니다.
- 변경 내용을 저장하세요.
정책에서 새 정책 규칙을 업데이트하고 적용할 때까지 몇 분 정도 기다립니다.
인덱서 만들기를 다시 시도합니다.
- 만든 데이터 원본 개체에 대한 업데이트 요청을 보냅니다.
- 인덱서 만들기 요청을 다시 보냅니다. 새 코드를 사용하여 로그인한 다음, 다른 인덱서 만들기 요청을 보냅니다.
지원되지 않는 문서 형식 인덱싱
Azure Blob Storage 콘텐츠를 인덱싱하고 컨테이너에 지원되지 않는 콘텐츠 형식의 Blob이 포함된 경우 인덱서는 해당 문서를 건너뜁니다. 다른 경우에는 개별 문서에 문제가 있을 수 있습니다.
이 경우 개별 문서에 문제가 있는 경우 인덱서 처리를 계속할 수 있도록 구성 옵션을 설정할 수 있습니다.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Content Understanding 분석 시간 제한
Content Understanding 파이프라인에 누락된 청크가 있는 경우 인덱서의 스킬 수준 오류 및 경고를 검사합니다. 기본 8분 문서 분석 폴링 기간은 인덱서 런타임 제한과 별개입니다. 폴링 만료는 문서에 대한 분석 출력을 반환하지 않습니다. 나머지 파이프라인, 프로젝션 및 실패 임계값은 문서 또는 실행이 실패하는지 여부를 결정합니다.
보고된 스킬 시간 초과의 경우 Content Understanding 분석 폴링을 참조하세요. 추가 요금이 발생할 수 있는 작업을 다시 시도하기 전에 Content Understanding 분석 문제 해결을 사용하여 폴링 만료를 분석기 생성, 요청 실패 및 기타 원인과 구분합니다.
누락된 문서
인덱서는 외부 데이터 원본 에서 문서 또는 행을 추출하고 Foundry IQ 서비스가 인덱싱하는 검색 문서를 만듭니다. 경우에 따라 데이터 원본에 있는 문서가 검색 인덱스에 나타나지 않는 경우도 있습니다. 이 예기치 않은 결과는 다음과 같은 이유로 인해 발생할 수 있습니다.
- 인덱서가 실행된 후 문서를 업데이트했습니다. 인덱서가 일정에 따라 실행되는 경우, 결국 다시 실행되어 문서를 처리합니다.
- 문서가 처리되기 전에 인덱서가 타임아웃되었습니다. 최대 처리 시간 제한이 있으며 그 이후에는 문서가 처리되지 않습니다. Azure Portal에서 또는 REST API(인덱서 상태 가져오기)를 호출하여 인덱서 상태를 확인할 수 있습니다.
- 필드 매핑 또는 AI 보강으로 인해 문서가 변경되었으며 검색 인덱스에서의 표현이 예상과 다릅니다.
- 변경 추적 값이 잘못되거나 필수 구성 조건이 누락되었습니다. 상위 워터마크 값이 이후 시간으로 설정된 날짜인 경우 인덱서는 이전 날짜가 있는 모든 문서를 건너뜁니다. 인덱서 상태의 필드 및
initialTrackingState필드를 사용하여finalTrackingState인덱서의 변경 내용 추적 상태를 확인할 수 있습니다. Azure SQL과 MySQL용 인덱서가 제대로 작동하려면 원본 테이블의 높은 워터 마크 열에 인덱스가 필수적이며, 이를 설정하지 않으면 인덱서 쿼리가 시간 초과될 위험이 있습니다.
팁
문서가 누락된 경우 사용 중인 쿼리를 확인하여 해당 문서를 제외하지 않는지 확인합니다. 특정 문서를 쿼리하려면 문서 조회 REST API를 사용합니다.
Blob Storage에서 누락된 콘텐츠
Blob 인덱서는 컨테이너의 blob에서 텍스트를 찾아서 추출합니다. 텍스트 추출에 대한 몇 가지 문제는 다음과 같습니다.
문서에는 스캔된 이미지만 포함됩니다. 스캔된 이미지(JPG)와 같은 텍스트가 아닌 콘텐츠를 포함한 PDF Blob은 표준 Blob 인덱싱 파이프라인에서 결과를 생성하지 않습니다. 텍스트 요소가 포함된 이미지 콘텐츠가 있는 경우 OCR 또는 이미지 분석을 사용하여 텍스트를 찾고 추출할 수 있습니다.
Blob 인덱서는 메타데이터를 인덱스하도록 구성됩니다. 콘텐츠를 추출하려면 콘텐츠와 메타데이터를 모두 추출하도록 Blob 인덱서가 구성되어야 합니다.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Azure Cosmos DB에서 누락된 콘텐츠
Foundry IQ에는 Azure Cosmos DB 인덱싱에 대한 암시적 종속성이 있습니다. Azure Cosmos DB 자동 인덱싱을 해제하면 Foundry IQ는 성공적인 상태를 반환하지만 컨테이너 콘텐츠를 인덱싱하지 못합니다. 설정을 확인하고 인덱싱을 설정하는 방법에 대한 지침은 Azure Cosmos DB에서 인덱싱 관리를 참조하세요.
데이터 원본과 인덱스 간의 문서 수 불일치
인덱서는 데이터 원본, 인덱스 자체 또는 코드의 개수와 다른 문서 수를 표시할 수 있습니다. 이 동작이 발생할 수 있는 몇 가지 이유는 다음과 같습니다.
- 특히 Azure Portal에서 인덱스가 실제 문서 수를 표시하는 데 지연이 될 수 있습니다.
- 인덱서에 삭제된 문서 정책이 있습니다. 문서가 삭제되기 전에 인덱싱된 경우 삭제된 문서는 인덱서 개수에 포함됩니다.
- 데이터 원본의 ID 열이 고유하지 않은 경우. 이 조건은 열 개념이 있는 데이터 원본(예: Azure Cosmos DB)에 적용됩니다.
- 데이터 원본 정의에 레코드 수를 예측하는 데 사용하는 쿼리와 다른 쿼리가 있는 경우. 예를 들어 데이터베이스에서 데이터베이스 레코드 수를 쿼리하는 반면 데이터 원본 정의 쿼리에서는 인덱싱할 레코드의 하위 집합만 선택할 수 있습니다.
- 개수는 파이프라인의 각 구성 요소(데이터 원본, 인덱서 및 인덱스)에 대해 서로 다른 간격으로 확인됩니다.
- 데이터 원본에 여러 문서에 매핑된 파일이 있습니다. 이 조건은 Blob 인덱싱 및 “parsingMode”가
jsonArray및jsonLines로 설정된 경우에 발생할 수 있습니다.
여러 번 처리된 문서
인덱서는 보수적인 버퍼링 전략을 사용하여 데이터 원본의 모든 새 문서와 변경된 문서가 인덱싱 중에 선택되도록 합니다. 특정 상황에서는 이러한 버퍼가 겹쳐서 인덱서가 문서를 두 번 이상 인덱싱할 수 있습니다. 따라서 처리된 문서 수가 데이터 원본의 실제 문서 수보다 많은 경우 이 동작은 문서 복제와 같이 인덱스로 저장된 데이터에는 영향을 주지 않으며 최종 일관성에 도달하는 데 더 오래 걸릴 수 있습니다. 이 조건은 다음 조건 중 어느 것이라도 참인 경우에 특히 널리 퍼집니다.
- 주문형 인덱서 요청은 짧은 간격으로 연달아 전송됩니다.
- 데이터 원본의 토폴로지에는 Azure Cosmos DB 일관성 수준에 설명된 토폴로지와 같은 여러 복제본 및 파티션이 포함됩니다.
- 데이터 원본은 Azure SQL 데이터베이스이며 "상위 워터 마크"로 선택한 열은 형식
datetime2입니다.
인덱서는 빠르게 연속해서 여러 번 호출할 수 없습니다. 업데이트가 신속하게 필요한 경우 지원되는 방법은 데이터 원본을 동시에 업데이트하는 동안 인덱스에 업데이트를 푸시하는 것입니다. 주문형 처리의 경우 5분 간격 이상으로 요청을 가속화하고 일정에 따라 인덱서를 실행합니다.
30초 버퍼를 사용하는 중복 문서 처리의 예
다음 타임라인에서는 문서가 두 번 처리되는 조건을 설명합니다. 각 조치와 대응 조치를 기록합니다. 다음 타임라인은 이슈를 보여 줍니다.
| 타임라인(hh:mm:ss) | 이벤트 | 인덱서 상위 워터마크 | 설명 |
|---|---|---|---|
| 00:01:00 | 최종 일관성에 맞춰 doc1을 데이터 원본에 쓰기 |
null |
문서 타임스탬프는 00:01:00입니다. |
| 00:01:05 | 최종 일관성에 맞춰 doc2을 데이터 원본에 쓰기 |
null |
문서 타임스탬프는 00:01:05입니다. |
| 00:01:10 | 인덱서 시작 | null |
|
| 00:01:11 | 인덱서가 00:01:10 이전의 모든 변경 내용을 쿼리합니다. 인덱서가 쿼리하는 복제본은 doc2만 인식합니다. doc2만 검색됩니다. |
null |
인덱서는 타임스탬프를 시작하기 전에 모든 변경 내용을 요청하지만 실제로 하나의 하위 집합을 받습니다. 이 동작을 수행하려면 룩백(look back) 버퍼 기간이 필요합니다. |
| 00:01:12 | 인덱서가 처음으로 doc2를 처리함 |
null |
|
| 00:01:13 | 인덱서 종료 | 00:01:10 | 상위 워터마크는 현재 인덱서 실행의 시작 타임스탬프로 업데이트됩니다. |
| 00:01:20 | 인덱서 시작 | 00:01:10 | |
| 00:01:21 | 인덱서가 00:00:40에서 00:01:20 사이의 모든 변경 내용을 쿼리합니다. 인덱서가 쿼리하는 복제본은 doc1 및 doc2 모두를 인식하고, doc1 및 doc2를 검색합니다. |
00:01:10 | 인덱서는 현재 상위 워터마크에서 30초 버퍼를 뺀 모든 변경 내용과 현재 인덱서 실행의 시작 타임스탬프를 요청합니다. |
| 00:01:22 | 인덱서가 처음으로 doc1를 처리함 |
00:01:10 | |
| 00:01:23 | 인덱서가 두 번째로 doc2를 처리함 |
00:01:10 | |
| 00:01:24 | 인덱서 종료 | 00:01:20 | 상위 워터마크는 현재 인덱서 실행의 시작 타임스탬프로 업데이트됩니다. |
| 00:01:32 | 인덱서 시작 | 00:01:20 | |
| 00:01:33 | 인덱서가 00:00:50에서 00:01:32 사이의 모든 변경 내용을 쿼리하고, doc1 및 doc2를 검색합니다. |
00:01:20 | 인덱서는 현재 상위 워터마크에서 30초 버퍼를 뺀 모든 변경 내용과 현재 인덱서 실행의 시작 타임스탬프를 요청합니다. |
| 00:01:34 | 인덱서가 두 번째로 doc1를 처리함 |
00:01:20 | |
| 00:01:35 | 인덱서가 세 번째로 doc2를 처리함 |
00:01:20 | |
| 00:01:36 | 인덱서 종료 | 00:01:32 | 상위 워터마크는 현재 인덱서 실행의 시작 타임스탬프로 업데이트됩니다. |
| 00:01:40 | 인덱서 시작 | 00:01:32 | |
| 00:01:41 | 인덱서가 00:01:02에서 00:01:40 사이의 모든 변경 내용을 쿼리하고, doc2를 검색합니다. |
00:01:32 | 인덱서는 현재 상위 워터마크에서 30초 버퍼를 뺀 모든 변경 내용과 현재 인덱서 실행의 시작 타임스탬프를 요청합니다. |
| 00:01:42 | 인덱서가 네 번째로 doc2를 처리함 |
00:01:32 | |
| 00:01:43 | 인덱서 종료 | 00:01:40 | 이 인덱서 실행은 데이터 원본에 대한 마지막 쓰기 이후 30초 이상 지나서 시작되었으며 doc2도 처리했습니다. 이는 00:01:35 이전의 모든 인덱서 실행이 제거되면 경우 doc1 및 doc2를 처리하는 최초이자 유일한 실행이 되기 때문에 예상되는 동작입니다. |
실제로 이 시나리오는 특정 데이터 원본에 대해 몇 분 내에 주문형 인덱서를 수동으로 호출하는 경우에만 발생합니다. 인덱서가 인덱서 실행 통계에 따라 총 345개의 문서를 처리했지만 데이터 원본 및 인덱스에는 340개의 문서가 있는 경우처럼 숫자가 일치하지 않거나 동일한 문서에 대해 동일한 기술을 여러 번 실행하면 청구가 증가할 수 있습니다. 일정을 사용한 인덱서 실행이 권장됩니다.
병렬 인덱싱
여러 인덱서가 동시에 실행되는 경우 일부 인덱서는 일반적으로 큐에 들어가서 시작하기 전에 사용 가능한 리소스를 기다립니다. 여러 요인에 따라 동시에 실행할 수 있는 인덱서 수를 결정합니다. 인덱서가 기술 세트에 연결되지 않는 경우 Foundry IQ 서비스의 복제본 및 파티션 수는 병렬로 실행할 수 있는 인덱서 수를 결정합니다.
인덱서를 기술 세트와 연결하면 Foundry IQ 내부 클러스터 내에서 실행됩니다. 기술 세트의 복잡성과 다른 기술 세트가 동시에 실행되는지 여부는 동시에 실행할 수 있는 인덱서 수를 결정합니다. 기본 제공 인덱서는 원본에서 데이터를 안정적으로 추출하므로 일정에 따라 실행되는 경우 누락된 데이터가 없습니다. 그러나 병렬화 및 스케일 아웃을 위한 인덱서 프로세스는 완료하는 데 약간의 시간이 필요합니다.
민감도 레이블을 사용하여 문서 인덱싱
문서에 민감도 레이블을 설정하면 인덱싱할 수 없을 수도 있습니다. 오류가 발생하면 인덱싱하기 전에 레이블을 제거합니다.