참고
Foundry IQ(Azure AI 검색)는 관리형 검색을 위해 상위 수준의 지식 원본 및 지식 베이스 API와 함께 직접 인덱싱 및 쿼리 API를 제공합니다. Azure 포털, REST API 또는 Azure SDK 사용하여 이러한 기능을 구성하거나 Microsoft Foundry 포털의 기술 자료에 에이전트를 연결합니다.
중요
이 문서에서 표시된 기능 또는 기능(미리 보기)은 공개 미리 보기로 제공되며 Microsoft Azure 미리 보기에 대한 추가 사용 약관의 적용을 받습니다.
Foundry IQ (Azure AI 검색) 관련 미리 보기 약관은 미리 보기 기능을 참조하세요.
이 빠른 시작에서는 Azure 포털에서 에이전트형 검색을 사용하여 Foundry IQ(Azure AI 검색)에서 인덱싱된 문서와 Foundry Models의 Azure OpenAI가 제공하는 LLM(대규모 언어 모델)으로 구동되는 대화형 검색 환경을 구축합니다.
포털은 다음 개체를 만드는 과정을 안내합니다.
Azure Blob Storage 컨테이너를 참조하는 지식 소스입니다. Blob 지식 원본을 만들면 Foundry IQ는 에이전트형 검색을 위해 콘텐츠를 수집하고 보강할 수 있도록 인덱스와 다른 파이프라인 개체를 자동으로 생성합니다.
LLM 기반 쿼리 계획을 사용해 내재된 정보 요구를 추론하고, 하위 쿼리를 실행하며, 답변을 종합하여 자연어 답변을 작성하는 지식 베이스입니다.
그런 다음 여러 문서의 정보가 필요한 복잡한 쿼리를 제출하고 합성된 답변을 검토하여 기술 자료를 테스트합니다.
중요
모델 기반 쿼리 계획 및 답변 합성은 프로그래밍 방식 액세스를 통해 2026-10-01 REST API에서 정식으로 제공됩니다. 이 Azure 포털 워크플로는 해당 기능 집합에 2026-08-01-preview를 계속 사용합니다. 이전에 포털에서 에이전트 검색 개체를 만든 경우 해당 개체는 호환성이 손상되는 변경이 발생할 수 있습니다. 마이그레이션 지침은 에이전트 검색 코드를 최신 버전으로 마이그레이션을 참조하세요.
필수 구성 요소
활성 구독이 있는 Azure 계정입니다. 무료로 계정을 만듭니다.
Foundry IQ 서비스가 있는 에이전트형 검색을 제공하는 모든 지역. 이 빠른 시작에서는 관리 ID 지원을 위해 기본 계층 이상이 필요합니다.
Microsoft Foundry 프로젝트 및 리소스입니다. 프로젝트를 만들면 리소스가 자동으로 만들어집니다.
텍스트-벡터 변환 을 위해 프로젝트에 배포된 포함 모델입니다. 모든
text-embedding모델, 예를 들어text-embedding-3-large과 같은 모델을 사용할 수 있습니다.쿼리 계획 및 응답 생성 을 위해 프로젝트에 배포된 LLM입니다. 포털 지원 LLM을 사용할 수 있습니다.
지원되는 LLM
에이전트 검색은 프로그래밍 방식으로 다양한 LLM을 지원하지만, 현재 포털에서 지원하는 LLM은 다음과 같습니다.
gpt-4ogpt-4o-minigpt-5gpt-5-minigpt-5-nano
액세스 구성
시작하기 전에 콘텐츠 및 작업에 액세스할 수 있는 권한이 있는지 확인합니다. 이 빠른 시작에서는 인증에 Microsoft Entra ID 사용하고 권한 부여를 위한 역할 기반 액세스를 사용합니다. 역할을 할당하려면 소유자 또는 사용자 액세스 관리자 여야 합니다. 역할이 가능하지 않은 경우 대신 키 기반 인증 을 사용합니다.
이 빠른 시작에 대한 액세스를 구성하려면 다음을 수행합니다.
Azure 포털 로그인합니다.
Foundry IQ 서비스에서:
사용자 계정에 다음 역할을 할당합니다: 검색 서비스 참가자, 검색 인덱스 데이터 참가자 및 검색 인덱스 데이터 읽기 권한자.
Azure Blob Storage에서 Foundry IQ 서비스의 관리 ID에 Storage Blob 데이터 기여자를 할당합니다.
Microsoft Foundry 리소스에서 Foundry IQ 서비스의 관리형 ID에 Cognitive Services User 역할을 할당합니다.
중요
에이전트릭 리트리벌에는 두 가지 토큰 기반 과금 모델이 있습니다.
- 에이전트 검색을 위해 Foundry IQ에서 청구합니다.
- 쿼리 계획 및 응답 합성을 위해 Azure OpenAI에서 청구합니다.
자세한 내용은 지역 가용성, 제한 및 청구를 참조하세요.
샘플 데이터 준비
이 빠른 시작에서는 NASA의 어스 앳 나이트 전자책의 샘플 JSON 문서를 사용하지만 사용자 고유의 파일을 사용할 수도 있습니다. 문서는 우주에서 관찰 된 바와 같이 밤에 지구의 일반적인 과학 주제와 이미지를 설명합니다.
이 빠른 시작에 대한 샘플 데이터를 준비하려면 다음을 수행합니다.
Azure 포털 Azure Storage 계정으로 이동합니다.
왼쪽 창에서 데이터 스토리지>컨테이너를 선택합니다.
earth-at-night-data라는 컨테이너를 만듭니다.
샘플 JSON 문서 컨테이너에 업로드합니다.
기술 자료 만들기
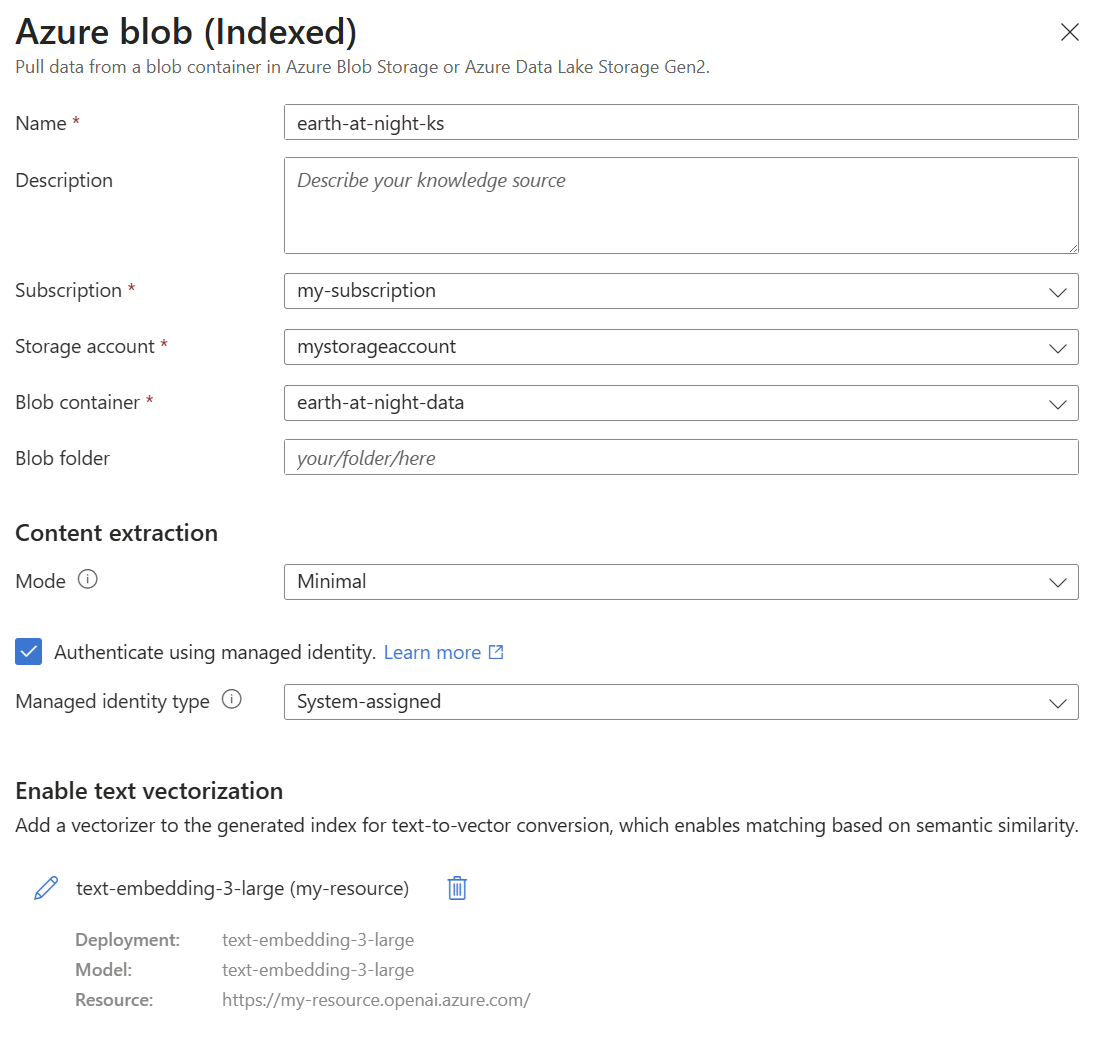
지식 원본은 원본 데이터에 대한 재사용 가능한 참조입니다. 이 섹션에서는 데이터 원본, 기술 세트, 인덱스 및 인덱서 생성을 트리거하여 데이터 인덱싱 및 보강을 자동화하는 Blob 기술 원본을 만듭니다. 이후 섹션에서 이러한 개체를 검토합니다.
또한 배포된 포함 모델을 사용하여 텍스트를 벡터로 변환하고 의미 체계 유사성에 따라 문서를 일치시키는 벡터 라이저를 구성합니다. 벡터라이저, 벡터 필드 및 벡터가 자동 생성된 인덱스에 추가됩니다.
이 빠른 시작에 대한 기술 자료를 만들려면 다음을 수행합니다.
Azure 포털에서 사용자의 Foundry IQ 서비스로 이동합니다.
왼쪽 창에서 에이전트 검색>지식 원본을 선택합니다.
"지식 소스 추가>지식 소스 추가를 선택합니다."
Azure Blob(인덱싱됨) 선택합니다.
이름으로 earth-at-night-ks를 입력한 다음, 샘플 데이터가 포함된 구독, 스토리지 계정 및 컨테이너를 선택합니다.
관리 ID를 사용하여 인증 확인란을 선택합니다. ID 형식을 시스템 할당으로 둡니다.
텍스트 벡터화 사용에서 벡터라이저 추가를 선택합니다.
종류에 대해 Microsoft Foundry를 선택한 다음, 구독, 프로젝트 및 포함 모델 배포를 선택합니다.
인증 유형에 대한 시스템 할당 ID 를 선택합니다.
벡터라이저를 저장합니다.
지식 원천을 만듭니다.
기술 자료 만들기
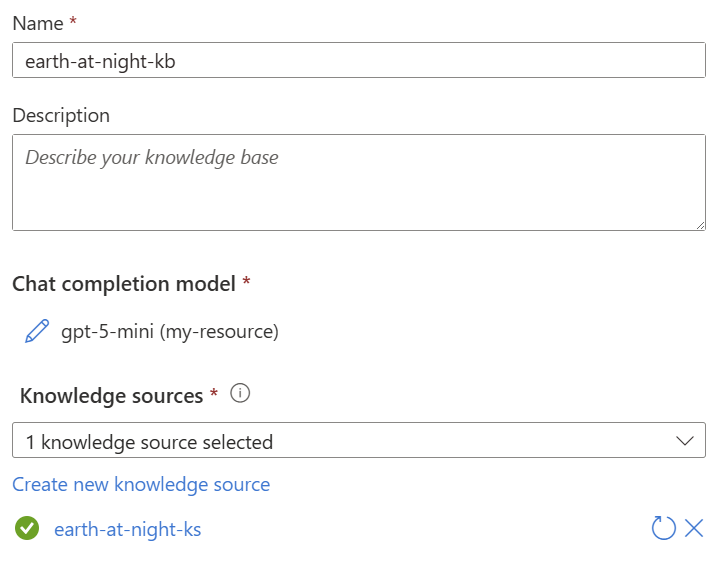
지식 기반은 지식 원천과 배포된 LLM을 사용하여 에이전트 기반 검색을 오케스트레이션합니다. 사용자가 복잡한 쿼리를 제출하면 LLM 기반 쿼리 계획은 지식 소스에 동시에 전송되는 하위 쿼리를 생성합니다. 그런 다음 Foundry IQ는 의미적 관련성을 기준으로 결과의 순위를 매기고, 최상의 결과를 하나의 통합된 응답으로 결합합니다.
출력 모드는 기술 자료에서 답변을 작성하는 방법을 결정합니다. 축자 콘텐츠에 추출 데이터를 사용하거나 자연어 응답 생성을 위한 응답 합성 을 사용할 수 있습니다. 기본적으로 포털은 응답 합성을 사용합니다.
이 빠른 시작에 대한 기술 자료를 만들려면 다음을 수행합니다.
왼쪽 창에서 에이전트 검색>기술 자료를 선택합니다.
기술 자료 추가>를 선택합니다.
이름 earth-at-night-kb 를 입력합니다.
채팅 완료 모델에서 모델 배포 추가를 선택합니다.
종류에 대해 Microsoft Foundry 선택한 다음, 구독, 프로젝트 및 LLM 배포를 선택합니다.
인증 유형에 대한 시스템 할당 ID 를 선택합니다.
모델 배포를 저장합니다.
지식 원본에서 earth-at-night-ks를 선택합니다.
지식 기반을 만듭니다.
자율적인 검색 테스트
포털은 기술 자료에 retrieve 요청을 제출할 수 있는 채팅 플레이그라운드를 제공합니다. 응답에는 정보 원본에 대한 참조 및 검색 프로세스에 대한 디버그 정보가 포함됩니다.
기술 자료를 쿼리하려면 다음을 수행합니다.
채팅 상자를 사용하여 다음 쿼리를 보냅니다.
Why do suburban belts display larger December brightening than urban cores even though absolute light levels are higher downtown? Why is the Phoenix nighttime street grid is so sharply visible from space, whereas large stretches of the interstate between midwestern cities remain comparatively dim?다음 예제와 유사해야 하는 합성된 인용 기반 답변을 검토합니다.
Suburban belts show larger December brightening in satellite nighttime lights than urban cores mainly because of relative (percentage) change effects and differences in how light is used and distributed. Areas with lower baseline light (suburbs, residential streets) can increase lighting use or reflect more light in winter and so show a bigger percent change, while bright urban cores are already near sensor saturation so their relative increase is small. The retrieved material explains that brightest lights are generally the most urbanized but not necessarily the most populated, and that poor or low‑light areas can have large populations but low availability or use of electric lights; thus lower‑light suburbs can exhibit larger relative changes when seasonal lighting rises.다음 JSON과 유사해야 하는 활동 로그를 검토하려면 디버그 아이콘을 선택합니다.
[
  {
    "type": "modelQueryPlanning",
    "id": 0,
    "inputTokens": 1518,
    "outputTokens": 284,
    "elapsedMs": 3001
  },
  {
    "type": "azureBlob",
    "id": 1,
    "knowledgeSourceName": "earth-at-night-ks",
    "queryTime": "2025-12-12T18:54:28.792Z",
    "count": 1,
    "elapsedMs": 456,
    "azureBlobArguments": {
      "search": "causes of December brightening in satellite nighttime lights suburban vs urban cores"
    }
  },
  {
    "type": "azureBlob",
    "id": 2,
    "knowledgeSourceName": "earth-at-night-ks",
    "queryTime": "2025-12-12T18:54:29.389Z",
    "count": 3,
    "elapsedMs": 596,
    "azureBlobArguments": {
      "search": "factors affecting seasonal variation in nighttime lights December winter brightening suburban belts urban cores"
    }
  },
  {
    "type": "azureBlob",
    "id": 3,
    "knowledgeSourceName": "earth-at-night-ks",
    "queryTime": "2025-12-12T18:54:29.862Z",
    "count": 6,
    "elapsedMs": 472,
    "azureBlobArguments": {
      "search": "why is Phoenix street grid highly visible at night from space compared to dim interstates in the Midwest reasons lighting patterns road lighting urban form"
    }
  },
  {
    "type": "agenticReasoning",
    "id": 4,
    "retrievalReasoningEffort": {
      "kind": "low"
    },
    "reasoningTokens": 111243
  },
  {
    "type": "modelAnswerSynthesis",
    "id": 5,
    "inputTokens": 7514,
    "outputTokens": 1058,
    "elapsedMs": 12334
  }
]
활동 로그는 쿼리 계획 및 실행, 의미 체계 순위 및 응답 합성을 포함하여 검색 중에 수행된 단계에 대한 인사이트를 제공합니다. 자세한 내용은 활동 배열 검토를 참조하세요.
생성된 개체 검토
Foundry IQ는 각 Blob 지식 원본에 대해 데이터 원본, 기술 세트, 인덱스 및 인덱서를 자동으로 생성합니다. 이러한 개체는 데이터 수집, 보강, 청크 및 벡터화를 위한 엔드투엔드 파이프라인을 형성합니다. 이러한 개체를 검토하여 에이전트 검색을 위해 데이터가 처리되는 방법을 알아볼 수 있습니다.
자동 생성된 개체를 검토하려면 다음을 수행합니다.
왼쪽 창에서 검색 관리를 선택합니다.
인덱서에서 성공 또는 실패 메시지를 확인합니다. 연결 또는 할당량 오류가 여기에 표시됩니다.
데이터 원본을 확인하여 Blob Storage 컨테이너에 대한 연결을 확인합니다.
당신의 스킬셋을 확인하여 임베딩 모델을 사용해 콘텐츠가 어떻게 청크화되고 벡터화되는 방식을 확인합니다.
검색 가능하고 필터링 가능한 필드와 유사성 검색을 위해 벡터를 저장하는 필드를 포함하여 검색을 위해 콘텐츠가 인덱싱되고 노출되는 방식을 확인하려면 인덱스를 확인합니다. 검색 탐색기를 사용하여 생성된 인덱스에 대해 쿼리를 실행합니다.
리소스 정리
사용자 고유의 구독에서 작업하는 경우 더 이상 필요하지 않은 리소스를 제거하여 프로젝트를 완료하는 것이 좋습니다. 계속 실행 중인 리소스는 비용이 들 수 있습니다.
Azure 포털의 왼쪽 창에서 모든 리소스 또는 리소스 그룹을 선택하여 리소스를 찾고 관리합니다. 리소스를 개별적으로 삭제하거나 리소스 그룹을 삭제하여 모든 리소스를 한 번에 제거할 수 있습니다.
해당 포털 페이지에서 지식 소스 및 지식 베이스를 삭제할 수도 있습니다. 기술 원본을 삭제하면 포털에서 연결된 데이터 원본, 기술 세트, 인덱스 및 인덱서 삭제를 묻는 메시지를 표시합니다.