注意
Azure AI 検索は、Azure ポータル、REST API、およびAzure SDKから使用できます。 また、Foundry IQ は、エンタープライズ コンテンツを、Microsoft Foundry ポータルのエージェントの再利用可能なアクセス許可に対応したナレッジ ベースに変換するマネージド ナレッジ レイヤーです。
Azure AI 検索 では、フラットな行セットをインデックス作成パイプラインへの入力として受け取ります。 ソース データが SQL Server リレーショナル データベース内の結合されたテーブルに由来する場合、この記事では、行セットを作成する方法と、Azure AI 検索 インデックスで親子のリレーションシップをモデル化する方法について説明します。
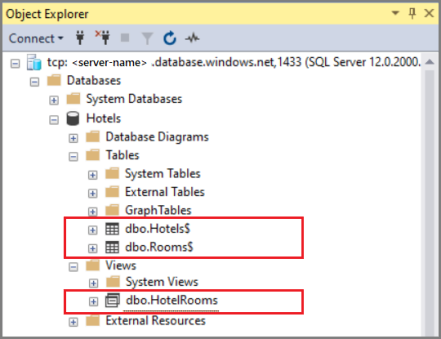
実例として、デモ データに基づく架空のホテル データベースについて説明します。 データベースは、50 軒のホテルを含む Hotels$ テーブルと、種類、料金、アメニティが異なる合計 750 室の客室を含む Rooms$ テーブルで構成されているとします。 テーブル間には一対多のリレーションシップがあります。 このアプローチでは、ビューにはホテルごとに 1 行で 50 行を返すクエリが表示され、関連する客室の詳細が各行に埋め込まれています。
非正規化されたデータの問題
一対多のリレーションシップを使用する場合の課題の 1 つは、結合されたテーブルに基づいて作成された標準クエリでは非正規化されたデータが返されますが、Azure AI 検索 シナリオではこれが適切に機能しないことです。 ホテルと客室を結合する次の例を考えてみましょう。
SELECT * FROM Hotels$
INNER JOIN Rooms$
ON Rooms$.HotelID = Hotels$.HotelID
このクエリの結果では、すべてのホテル フィールドが返され、その後にすべての Room フィールドが続き、客室の値ごとに予備的なホテル情報が繰り返されます。
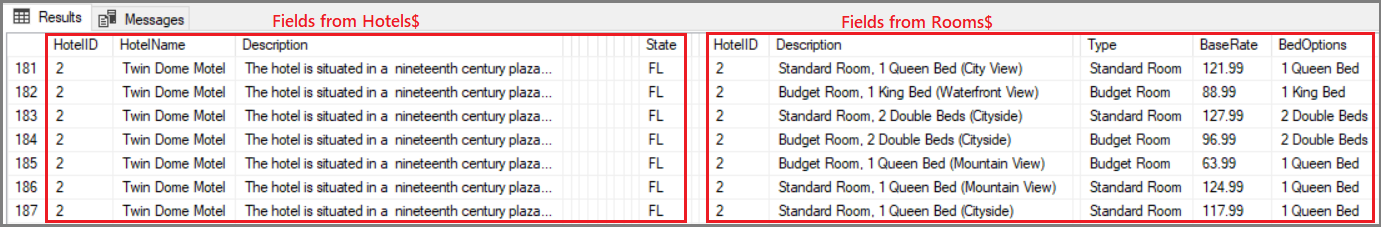
このクエリは表面的には成功しますが (フラットな行セットですべてのデータが提供されます)、想定される検索エクスペリエンスに適したドキュメント構造が提供されません。 インデックス作成中に、Azure AI 検索 では取り込まれた各行に 1 つの検索ドキュメントが作成されます。 検索ドキュメントが上記の結果のようになった場合は、Old Century ホテルだけで 7 つの別のドキュメントが表示されるという重複に気付くはずです。 "フロリダのホテル" に関するクエリでは、Old Century ホテルのみで 7 つの結果が返され、関連する他のホテルが検索結果の後の方に追いやられます。
ホテルごとに 1 つのドキュメントという想定されるエクスペリエンスを得るには、適切な粒度で、さらに完全な情報を含む行セットを指定する必要があります。 この記事では、その方法について説明します。
埋め込みの JSON を返すクエリを定義する
想定される検索エクスペリエンスを実現するには、データ セットは Azure AI 検索 内の各検索ドキュメントに対して 1 行で構成されている必要があります。 この例では、ホテルごとに 1 行が必要ですが、客室の詳細情報に含まれる夜間料金、ベッドのサイズと数、またはビーチのビューなど、関心が持たれる他の客室関連のフィールドをユーザーが検索できるようにする必要もあります。
このソリューションでは、2 番目の手順に示すように、入れ子になった JSON として客室の詳細情報をキャプチャし、ビューのフィールドに JSON 構造体を挿入します。
Hotels$とRooms$という 2 つの結合テーブルがあるとします。これらには 50 軒のホテルと 750 の客室に関する詳細情報が含まれ、HotelID フィールドで結合されています。 これらのテーブルには、個別に 50 軒のホテルと 750 室の関連する客室が含まれています。CREATE TABLE [dbo].[Hotels$]( [HotelID] [nchar](10) NOT NULL, [HotelName] [nvarchar](255) NULL, [Description] [nvarchar](max) NULL, [Description_fr] [nvarchar](max) NULL, [Category] [nvarchar](255) NULL, [Tags] [nvarchar](255) NULL, [ParkingIncluded] [float] NULL, [SmokingAllowed] [float] NULL, [LastRenovationDate] [smalldatetime] NULL, [Rating] [float] NULL, [StreetAddress] [nvarchar](255) NULL, [City] [nvarchar](255) NULL, [State] [nvarchar](255) NULL, [ZipCode] [nvarchar](255) NULL, [GeoCoordinates] [nvarchar](255) NULL ) ON [PRIMARY] TEXTIMAGE_ON [PRIMARY] GO CREATE TABLE [dbo].[Rooms$]( [HotelID] [nchar](10) NULL, [Description] [nvarchar](255) NULL, [Description_fr] [nvarchar](255) NULL, [Type] [nvarchar](255) NULL, [BaseRate] [float] NULL, [BedOptions] [nvarchar](255) NULL, [SleepsCount] [float] NULL, [SmokingAllowed] [float] NULL, [Tags] [nvarchar](255) NULL ) ON [PRIMARY] GO親テーブル (
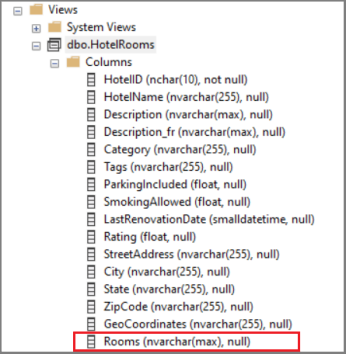
SELECT * from dbo.Hotels$) 内のすべてのフィールドで構成されるビューを作成し、新しい Rooms フィールドを追加します。このフィールドには入れ子クエリの出力が含まれます。 FOR JSON AUTO 句はSELECT * from dbo.Rooms$に対し、出力をJSONとして構築します。CREATE VIEW [dbo].[HotelRooms] AS SELECT *, (SELECT * FROM dbo.Rooms$ WHERE dbo.Rooms$.HotelID = dbo.Hotels$.HotelID FOR JSON AUTO) AS Rooms FROM dbo.Hotels$ GO次のスクリーンショットは、一番下に Rooms nvarchar フィールドがある結果のビューを示しています。 Rooms フィールドは HotelRooms ビューにのみ存在します。
SELECT * FROM dbo.HotelRoomsを実行して行セットを取得します。 このクエリでは、JSON コレクションとして客室情報が関連付けられた 50 行 (ホテルごとに 1 行) が返されます。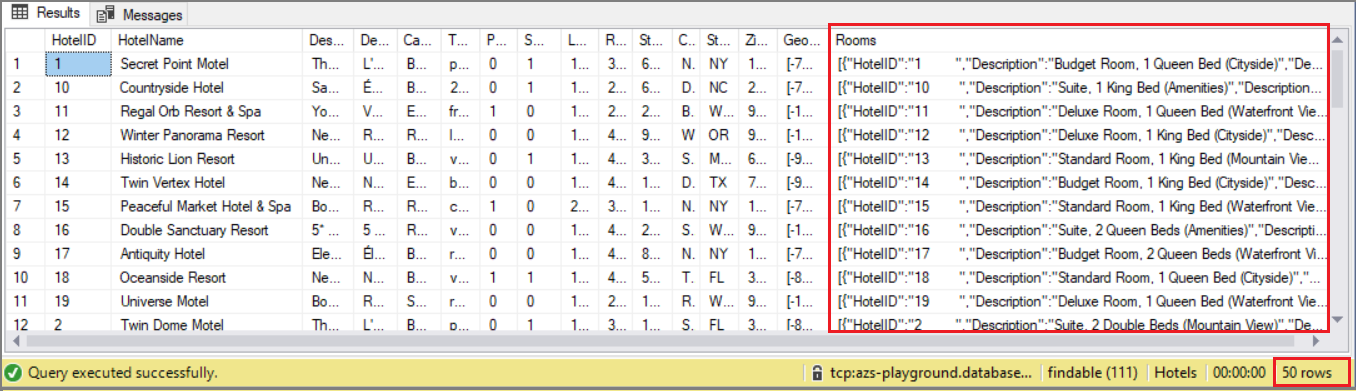
これで、この行セットを Azure AI 検索 にインポートする準備ができました。
注意
このアプローチでは、埋め込みの JSON が SQL Server の最大列サイズ制限を下回ることを前提としています。
一対多リレーションシップの "多" の側に複雑なコレクションを使用する
Azure AI 検索 側で、入れ子になった JSON を使用して一対多のリレーションシップをモデル化するインデックス スキーマを作成します。 次のセクションで作成した結果セットは、通常、次に示すインデックス スキーマに対応しています (簡潔にするために一部のフィールドを省略しています)。
次の例は、複合データ型をモデル化する方法の記事の例と似ています。 この記事で重点的に説明している Rooms 構造体は、hotels という名前のインデックスのフィールド コレクションに含まれています。 この例は、Address の複合型も示しています。これは、コレクションで許可されている複数の任意の数の項目ではなく、固定セットの項目で構成されている点で Rooms とは異なります。
{
  "name": "hotels",
  "fields": [
    { "name": "HotelId", "type": "Edm.String", "key": true, "filterable": true },
    { "name": "HotelName", "type": "Edm.String", "searchable": true, "filterable": false },
    { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
    { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
    { "name": "Category", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": true },
    { "name": "ParkingIncluded", "type": "Edm.Boolean", "filterable": true, "facetable": true },
    { "name": "Tags", "type": "Collection(Edm.String)", "searchable": true, "filterable": true, "facetable": true },
    { "name": "Address", "type": "Edm.ComplexType",
      "fields": [
        { "name": "StreetAddress", "type": "Edm.String", "filterable": false, "sortable": false, "facetable": false, "searchable": true },
        { "name": "City", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true },
        { "name": "StateProvince", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true }
      ]
    },
    { "name": "Rooms", "type": "Collection(Edm.ComplexType)",
      "fields": [
        { "name": "Description", "type": "Edm.String", "searchable": true, "analyzer": "en.lucene" },
        { "name": "Description_fr", "type": "Edm.String", "searchable": true, "analyzer": "fr.lucene" },
        { "name": "Type", "type": "Edm.String", "searchable": true },
        { "name": "BaseRate", "type": "Edm.Double", "filterable": true, "facetable": true },
        { "name": "BedOptions", "type": "Edm.String", "searchable": true, "filterable": true, "facetable": false },
        { "name": "SleepsCount", "type": "Edm.Int32", "filterable": true, "facetable": true },
        { "name": "SmokingAllowed", "type": "Edm.Boolean", "filterable": true, "facetable": false},
        { "name": "Tags", "type": "Edm.Collection", "searchable": true }
      ]
    }
  ]
}
前の結果セットと上記のインデックス スキーマがあれば、インデックス作成操作を成功させるために必要なすべてのコンポーネントが用意されています。 フラット化されたデータ セットはインデックス作成の要件を満たしていますが、詳細情報も保持されます。 Azure AI 検索インデックスによって検索結果がホテルベースのエンティティに簡単に分類され、さらに個々の客室とその属性のコンテキストが保持されます。
複合型サブフィールドでのファセットの動作
親を持つフィールド (Address や Rooms の下のフィールドなど) は、サブフィールドと呼ばれます。 サブフィールドに "facetable" 属性を割り当てることができますが、ファセットのカウントは常にメイン ドキュメントに対して行われます。
ドキュメントに "Address/City" または "Address/stateProvince" が 1 つだけ存在する Address などの複合型の場合、ファセットは想定どおりに動作します。 ただし、メイン ドキュメントごとに複数のサブ文書がある Rooms の場合、ファセット数は誤解を招くものになる可能性があります。
複合データ型に関する記事で説明されているように、「ファセットの結果で返されるドキュメント数は、複合コレクション (Rooms) のサブドキュメントではなく、親ドキュメント (Hotel) に対して計算されます。 たとえば、ホテルに 20 室の型 "suite" があるとします。 このファセット パラメーター facet=Rooms/Type を指定すると、ファセット数はホテルの 1 であり、部屋の 20 ではありません。」
次のステップ
独自のデータ セットを使用すると、データの インポート ウィザード を使用してインデックスを作成して読み込むことができます。 ウィザードによって、Rooms に含まれているものなど、埋め込み JSON コレクションが検出され、複合型コレクションを含むインデックス スキーマが推測されます。
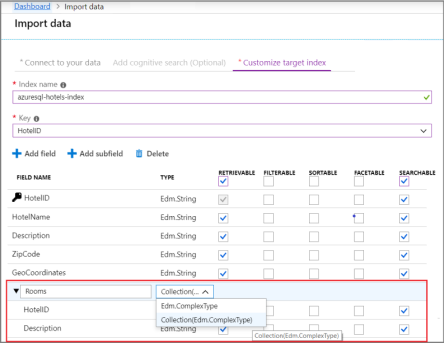
データのインポート ウィザードの基本的な手順については、次のクイック スタートを試してください。