Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Catatan
Pencarian Azure AI tersedia melalui portal Azure, REST API, dan Azure SDK. Ini juga mendukung Foundry IQ, lapisan pengetahuan terkelola yang mengubah konten perusahaan menjadi pangkalan pengetahuan yang dapat digunakan kembali dan sadar izin untuk agen di portal Microsoft Foundry.
Penting
Fitur, kemampuan, atau properti yang ditandai (pratinjau) tidak tercakup dalam perjanjian tingkat layanan, tidak disarankan untuk beban kerja produksi, dan mungkin berubah atau dibatasi sebelum tersedia secara umum. Ketentuan pratinjau Pencarian Azure AI berlaku untuk semua fungsionalitas pratinjau, baik itu mandiri atau bagian dari fitur yang tersedia secara umum.
Di Pencarian Azure AI, Anda bisa menggunakan ekspresi filter untuk menambahkan kriteria inklusi atau pengecualian ke kueri vector. Anda juga dapat menentukan mode pemfilteran yang menerapkan filter:
- Sebelum eksekusi kueri, dikenal sebagai prafilter.
- Setelah eksekusi kueri, dikenal sebagai postfiltering.
- Setelah hasil teratas
kglobal diidentifikasi, disebut sebagai penyaringan ketat (pratinjau).
Artikel ini menggunakan REST untuk ilustrasi. Untuk sampel kode dalam bahasa lain dan solusi end-to-end yang menyertakan kueri vektor, lihat repositori azure-search-vector-samples GitHub.
Anda juga dapat menggunakan Search Explorer di portal Azure untuk mengkueri konten vektor. Dalam tampilan JSON, Anda dapat menambahkan filter dan menentukan mode filter.
Cara kerja pemfilteran dalam kueri vektor
Pencarian Azure AI menggunakan algoritma Hierarkis Navigable Small World (HNSW) untuk pencarian Perkiraan Tetangga Terdekat (ANN), menyimpan grafik HNSW di beberapa shard. Setiap shard berisi sebagian dari seluruh indeks.
Filter berlaku untuk filterable bidang nonvektor, baik string atau numerik, untuk menyertakan atau mengecualikan dokumen pencarian berdasarkan kriteria filter. Bidang vektor itu sendiri tidak dapat difilter, tetapi Anda dapat menggunakan filter pada bidang lain dalam indeks yang sama untuk mempersempit dokumen yang dipertimbangkan untuk pencarian vektor. Jika indeks Anda tidak memiliki bidang teks atau numerik yang sesuai, periksa metadata dokumen yang mungkin membantu pemfilteran, seperti LastModified atau CreatedBy properti.
Parameter vectorFilterMode mengontrol tempat operasi filter diterapkan selama tahap pencarian, yang memengaruhi bagaimana hasil difilter ke subset item (seperti berdasarkan kategori, tag, atau atribut lainnya) dan memengaruhi latensi, pengenalan, dan throughput. Ada tiga mode:
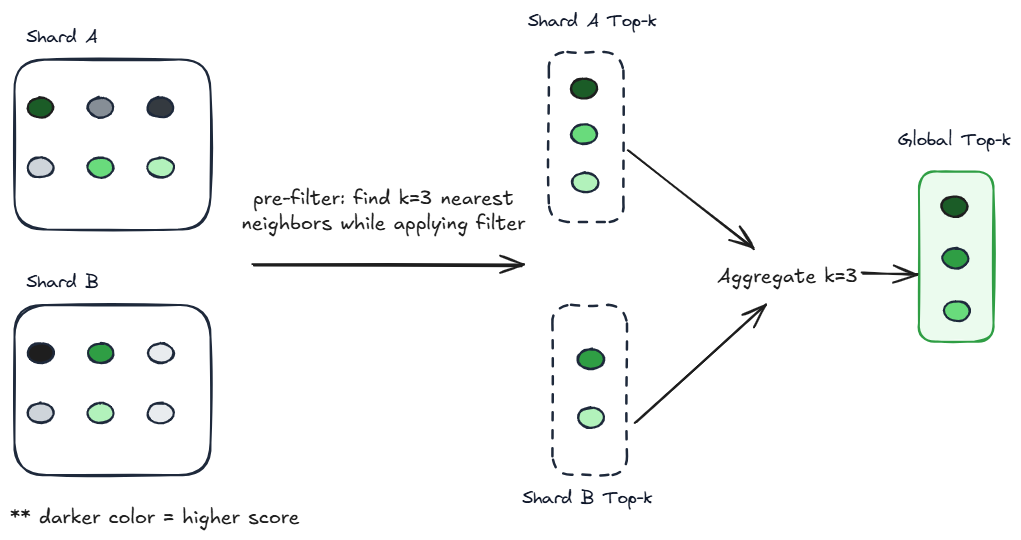
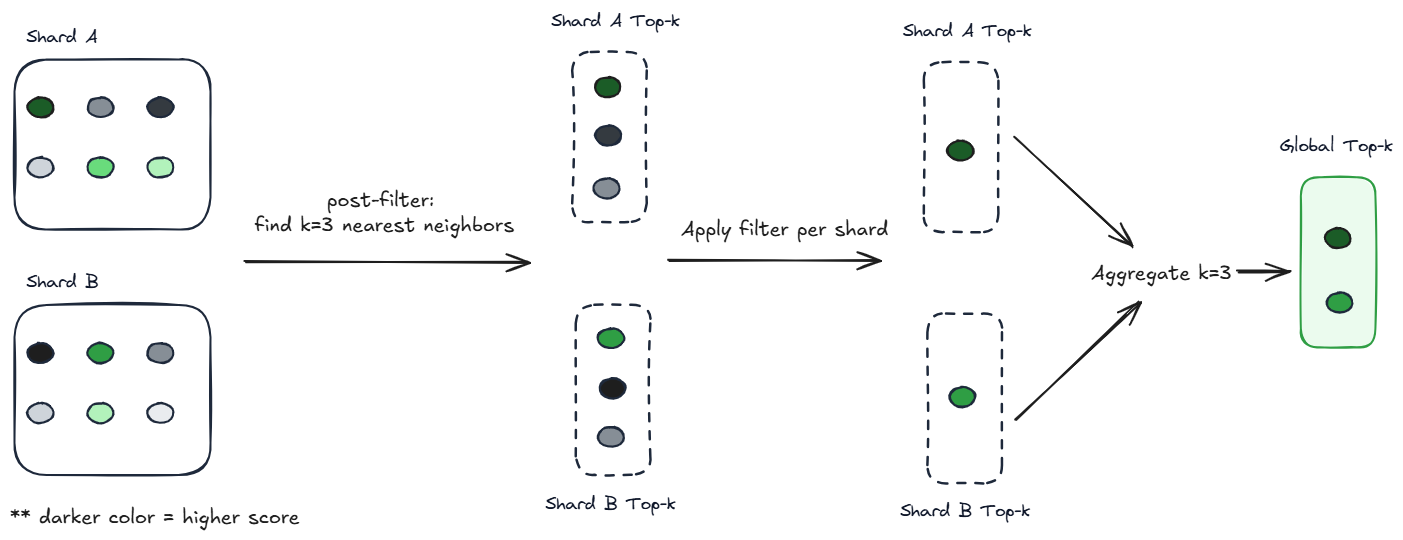
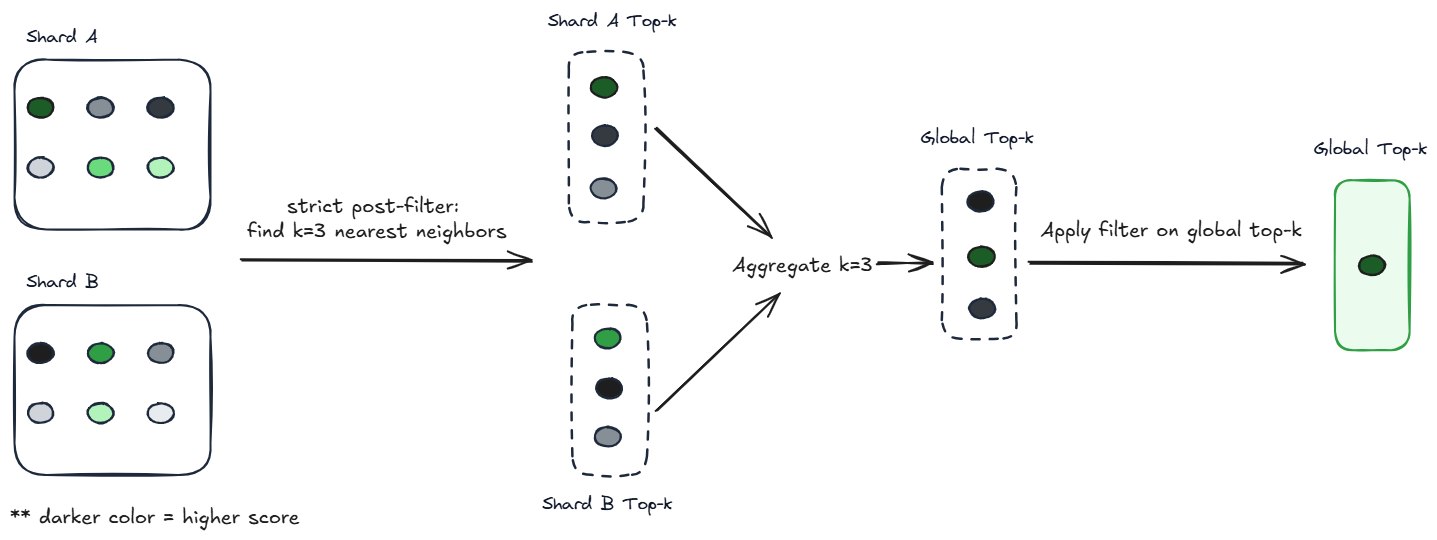
preFiltermenerapkan filter selama penelusuran HNSW pada setiap shard. Mode ini memaksimalkan pengenalan tetapi dapat melintasi lebih banyak grafik, meningkatkan CPU dan latensi untuk filter yang sangat selektif.postFiltermenjalankan traversal HNSW dan pemfilteran pada setiap shard secara mandiri, memotong hasil di tingkat shard, dan kemudian menggabungkan yang terataskdari setiap shard menjadi teratas globalk. Mode ini dapat menghasilkan hasil negatif palsu untuk filter yang sangat selektif atau nilaikyang kecil.strictPostFilter(pratinjau) menemukan peringkat teratas globalkyang belum difilter sebelum menerapkan filter. Mode ini memiliki risiko tertinggi mengembalikan hasil negatif palsu untuk filter yang sangat selektif dan nilaikyang kecil.
Untuk informasi selengkapnya tentang mode ini, lihat Mengatur mode filter.
Mendefinisikan filter
Filter menentukan cakupan kueri vektor dan didefinisikan menggunakan Dokumen - Pos Pencarian (REST API). Kecuali Anda ingin menggunakan fitur pratinjau, gunakan versi stabil terbaru DARI REST API Layanan Pencarian untuk merumuskan permintaan.
REST API ini menyediakan:
-
filteruntuk kriteria. -
vectorFilterModeuntuk menentukan kapan filter diterapkan selama kueri vektor. Untuk mode yang didukung, lihat Mengatur mode filter.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
Dalam contoh ini, penyematan vektor menargetkan contentVector bidang, dan kriteria filter berlaku untuk category, bidang teks yang dapat difilter. Karena mode ini digunakan, filter diterapkan sebelum mesin pencari menjalankan kueri, jadi hanya dokumen dalam kategori preFilter yang dipertimbangkan selama pencarian vektor.
Mengatur mode filter
Parameter vectorFilterMode menentukan kapan dan bagaimana filter diterapkan relatif terhadap eksekusi kueri vektor. Anda dapat menggunakan mode berikut:
-
preFilter(disarankan) postFilter-
strictPostFilter(pratinjau)
Catatan
preFilter adalah default untuk indeks yang dibuat setelah sekitar 15 Oktober 2023. Untuk indeks yang dibuat sebelum tanggal ini, postFilter adalah defaultnya. Untuk menggunakan preFilter dan fitur vektor tingkat lanjut lainnya, seperti kompresi vektor, Anda harus membuat ulang indeks Anda.
Anda dapat menguji kompatibilitas dengan mengirim kueri vektor dengan "vectorFilterMode": "preFilter" pada 2023-10-01-preview versi REST API atau yang lebih baru. Jika kueri gagal, indeks Anda tidak mendukung preFilter.
Prefiltering menerapkan filter sebelum eksekusi kueri, yang mengurangi himpunan kandidat untuk algoritma pencarian vektor. Hasil teratask kemudian dipilih dari set yang difilter ini.
Dalam kueri vektor, preFilter adalah mode default karena mendukung pengenalan dan kualitas atas latensi.
Cara kerja mode ini
Pada setiap shard, terapkan predikat filter selama traversal HNSW, perluas grafik hingga
kkandidat ditemukan.Menghasilkan hasil teratas
klokal yang telah difilter sebelumnya per pecahan data.Agregasikan hasil yang difilter ke dalam kumpulan hasil global teratas
k.
Efek dari mode ini
Traversal memperluas permukaan pencarian untuk menemukan kandidat yang lebih terfilter, terutama jika filter selektif. Ini menghasilkan hasil peringkat teratask yang paling mirip di semua partisi. Setiap shard mengidentifikasi hasil k yang memenuhi predikat filter.
Prefiltering menjamin bahwa hasil k dikembalikan jika mereka ada dalam indeks. Untuk filter yang sangat selektif, ini dapat menyebabkan sebagian besar grafik dilalui, meningkatkan biaya komputasi dan latensi sambil mengurangi throughput. Jika filter Anda sangat selektif (memiliki sangat sedikit kecocokan), pertimbangkan untuk menggunakan exhaustive: true untuk melakukan pencarian lengkap.
Tabel perbandingan
| Modus | Pencarian Kembali (hasil yang difilter) | Biaya komputasi | Risiko negatif palsu | Kapan harus menggunakan |
|---|---|---|---|---|
preFilter |
Sangat tinggi | Lebih tinggi (meningkat dengan selektivitas dan kompleksitas filter) | Tidak ada risiko |
Default yang disarankan untuk semua skenario, terutama ketika ingatan sangat penting (domain pencarian sensitif), saat menggunakan filter selektif, atau saat menggunakan k kecil. |
postFilter |
Sedang hingga tinggi (berkurang dengan selektifitas filter) | Mirip dengan tanpa filter tetapi meningkat dengan kompleksitas filter | Sedang (dapat melewatkan kecocokan per pecahan) | Opsi untuk filter yang tidak terlalu selektif dan untuk kueri yang lebih tinggik . |
strictPostFilter |
Terendah (berkurang paling cepat dengan selektivitas filter) | Mirip dengan unfiltered | Tertinggi (dapat mengembalikan hasil nol untuk filter selektif atau kecil k) |
Opsi untuk aplikasi pencarian berfasilitas di mana menampilkan lebih banyak hasil setelah penerapan filter lebih memengaruhi pengalaman pengguna daripada risiko false negative. Jangan gunakan untuk barang kecil k. |
Pengujian tolok ukur prafilter dan pascafilter
Penting
Bagian ini berlaku untuk prafilter dan pascafilter, bukan postfiltering yang ketat.
Untuk memahami kondisi di mana satu mode filter berkinerja lebih baik daripada yang lain, kami menjalankan serangkaian pengujian untuk mengevaluasi hasil kueri melalui indeks kecil, sedang, dan besar.
- Kecil (100.000 dokumen, indeks 2,5 GB, 1.536 dimensi)
- Sedang (1 juta dokumen, indeks 25 GB, 1.536 dimensi)
- Besar (1 miliar dokumen, indeks 1,9 TB, 96 dimensi)
Untuk beban kerja kecil dan menengah, kami menggunakan layanan Standar 2 (S2) dengan satu partisi dan satu replika. Untuk beban kerja besar, kami menggunakan layanan Standard 3 (S3) dengan 12 partisi dan satu replika.
Indeks memiliki konstruksi yang identik: satu bidang kunci, satu bidang vektor, satu bidang teks, dan satu bidang numerik yang dapat difilter. Indeks berikut didefinisikan menggunakan 2023-11-01 sintaks.
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
Dalam kueri, kami menggunakan filter yang identik untuk operasi prafilter dan pascafilter. Kami menggunakan filter sederhana untuk memastikan bahwa variasi performa disebabkan oleh mode pemfilteran, bukan kompleksitas filter.
Hasil diukur dalam kueri per detik (QPS).
Poin-poin Penting
Prafilter hampir selalu lebih lambat daripada postfiltering, kecuali pada indeks kecil di mana performanya kira-kira sama.
Pada himpunan data yang lebih besar, prapenyaringan jauh lebih lambat.
Mengapa prafilter default jika hampir selalu lebih lambat? Prefiltering menjamin bahwa
khasil dikembalikan jika ada dalam indeks, di mana preferensi mendukung daya ingat dan presisi daripada kecepatan.Gunakan postfiltering jika Anda:
Mengutamakan kecepatan dibandingkan pemilihan (postfiltering dapat mengembalikan lebih sedikit dari
khasil).Gunakan filter yang tidak terlalu selektif.
Memiliki indeks dengan ukuran yang memadai sehingga performa prafilter tidak dapat diterima.
Rincian
Mengingat himpunan data dengan 100.000 vektor pada 1.536 dimensi:
Saat memfilter lebih dari 30% himpunan data, prafilter dan postfilter dapat dibandingkan.
Saat memfilter kurang dari 0,1% himpunan data, prafilter sekitar 50% lebih lambat daripada postfiltering.
Mengingat himpunan data dengan 1 juta vektor pada 1.536 dimensi:
Saat memfilter lebih dari 30% himpunan data, prafilter sekitar 30% lebih lambat.
Saat memfilter kurang dari 2% himpunan data, prafilter sekitar tujuh kali lebih lambat.
Mengingat himpunan data dengan 1 miliar vektor pada 96 dimensi:
Saat memfilter lebih dari 5% himpunan data, prafilter sekitar 50% lebih lambat.
Saat memfilter kurang dari 10% himpunan data, prafilter sekitar tujuh kali lebih lambat.
Grafik berikut menunjukkan QPS relatif prafilter, dihitung sebagai QPS prafilter dibagi dengan QPS postfilter.
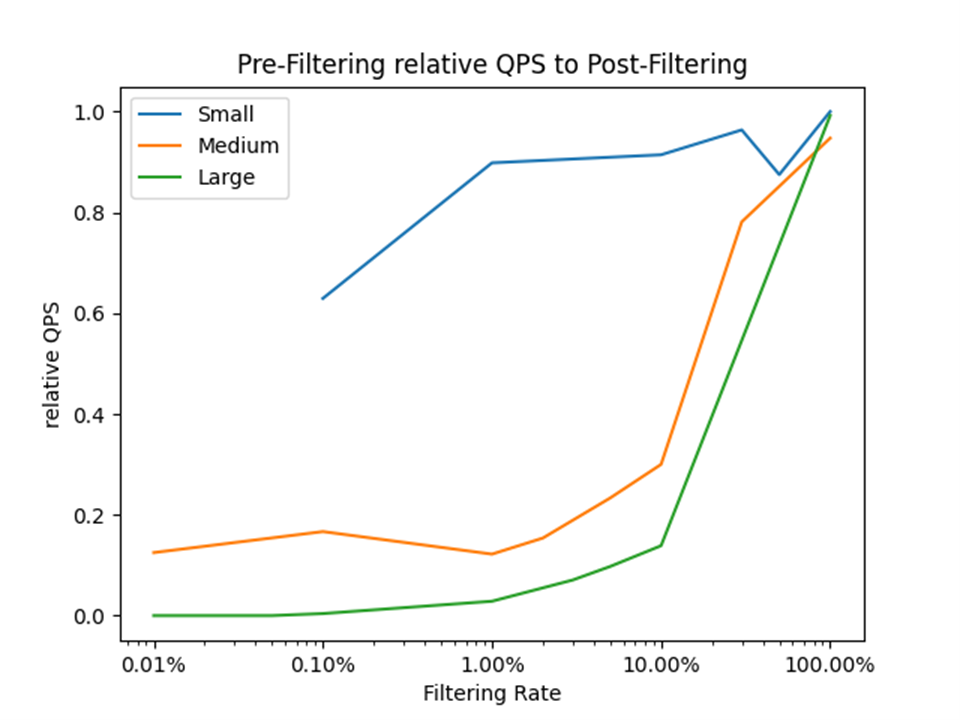
Sumbu vertikal mewakili performa relatif prafilter dibandingkan dengan postfiltering, yang dinyatakan sebagai rasio QPS (kueri per detik). Misalnya:
- Nilai
0.0berarti prafilter adalah 100% lebih lambat daripada postfiltering. - Nilai
0.5berarti prafilter adalah 50% lebih lambat. - Nilai
1.0berarti prafilter dan pemfilteran pasca setara.
Sumbu horizontal mewakili laju pemfilteran, atau persentase dokumen kandidat setelah menerapkan filter. Misalnya, tingkat 1.00% berarti kriteria filter memilih satu persen dari korpus pencarian.
Konten terkait
- Pencarian vektor di Pencarian Azure AI
- Membuat indeks vektor
- Membuat kueri vektor