Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Note
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
Dans Recherche Azure AI, semantic ranker est une fonctionnalité qui améliore de façon significative la pertinence de la recherche à l'aide des modèles de compréhension du langage de Microsoft pour reclasser les résultats de la recherche. Le classeur sémantique est également intégré à la récupération agentique. Cet article est une introduction générale pour vous aider à comprendre les comportements et les avantages du ranker sémantique.
Le ranker sémantique est une fonctionnalité Premium facturée par utilisation, mais vous pouvez l’utiliser gratuitement sous réserve de limites de service pour le niveau gratuit. Nous vous recommandons cet article en arrière-plan, mais si vous préférez commencer, procédez comme suit.
Qu’est-ce que le classement sémantique ?
Le ranker sémantique est une collection de fonctionnalités côté requête qui améliorent la qualité d’un résultat de recherche initial classé bm25 ou classé RRF pour les requêtes textuelles, la partie texte des requêtes vectorielles et les requêtes hybrides. Le classement sémantique étend le pipeline d’exécution de requête de trois façons :
Premièrement, il ajoute toujours un classement secondaire sur un ensemble de résultats initialement évalué à l’aide de BM25 ou de Reciprocal Rank Fusion (RRF). Ce classement secondaire utilise des modèles d’apprentissage profond multilingues adaptés de Microsoft Bing pour promouvoir les résultats les plus sémantiquement pertinents.
Ensuite, elle retourne des légendes et extrait éventuellement des réponses dans la réponse, que vous pouvez afficher sur une page de recherche pour améliorer l’expérience de recherche de l’utilisateur.
Troisièmement, si vous activez la réécriture de requête, elle développe une chaîne de requête initiale en plusieurs chaînes de requête sémantiquement similaires.
Le classement secondaire et les « réponses » s’appliquent à la réponse de requête. La réécriture de requête fait partie de la requête de recherche.
L’éditeur de classement sémantique a les fonctionnalités suivantes :
| Capacité | Description |
|---|---|
| Classement L2 | Utilise le contexte ou la signification sémantique d’une requête pour calculer un nouveau score de pertinence sur les résultats préclassés. |
| Légendes sémantiques et surlignages | Extrait les phrases détaillées et les expressions des champs qui résument le mieux le contenu, avec des surbrillances sur les passages clés pour faciliter l’analyse. Les légendes qui résument un résultat sont utiles lorsque les champs de contenu individuels sont trop denses pour la page des résultats de recherche. Le texte mis en surbrillance élève les termes et expressions les plus pertinents afin que les utilisateurs puissent rapidement déterminer pourquoi une correspondance a été considérée comme pertinente. |
| Réponses sémantiques | Sous-structure facultative et supplémentaire retournée à partir d’une requête sémantique. Il fournit une réponse directe à une requête qui ressemble à une question. Il exige qu’un document ait du texte avec les caractéristiques d’une réponse. |
| Réécriture de requête (préversion) | À l’aide de requêtes textuelles ou de la partie texte d’une requête vectorielle, le classificateur sémantique crée jusqu’à 10 variantes de la requête, corrigeant peut-être des fautes de frappe ou d’orthographe, ou reformulant une requête à l’aide de synonymes générés. La requête réécrite s’exécute sur le moteur de recherche. Les résultats sont évalués à l'aide du score BM25 ou RRF, puis rescórés par un classement sémantique. |
Fonctionnement de l’éditeur de classement sémantique
Le ranker sémantique prend une requête et des résultats, puis les envoie aux modèles de compréhension du langage hébergés par Microsoft. Elle recherche de meilleures correspondances.
L’illustration suivante explique le concept. Considérez le terme « capital ». Il a des significations différentes selon que le contexte est financier, droit, géographie ou grammaire. Grâce à la compréhension du langage, l’éditeur de classement sémantique détecte le contexte et promeut les résultats qui correspondent à l’intention de requête.
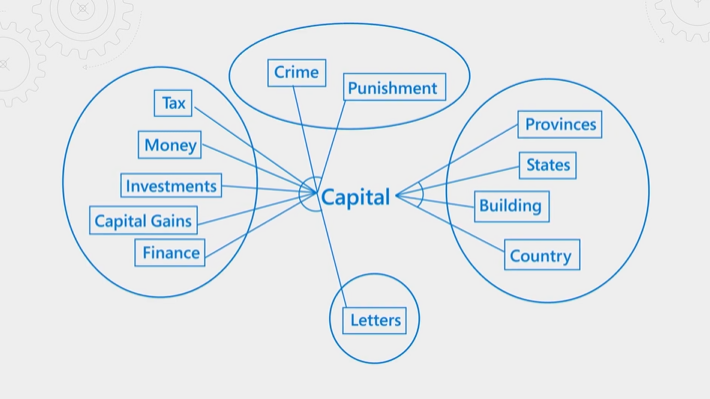
Le classement sémantique utilise beaucoup de ressources et de temps. Pour terminer le traitement dans la latence attendue d’une opération de requête, le système consolide et réduit les entrées au ranker sémantique. Cette approche permet d’effectuer l’étape de reclassement aussi rapidement que possible.
Le classement sémantique comporte trois étapes :
- Collecter et synthétiser les entrées
- Évaluer les résultats à l’aide du classeur sémantique
- Résultats de sortie réévalués, sous-titres et réponses
Comment le système collecte et récapitule les entrées
Dans le classement sémantique, le sous-système de requête transmet les résultats de recherche en tant qu’entrée aux modèles de synthèse et de classement. Étant donné que les modèles de classement ont des contraintes de taille d’entrée et qu’ils traitent de manière intensive, les résultats de recherche doivent être dimensionnés et structurés (résumés) pour une gestion efficace.
Le ranker sémantique commence par un résultat classé BM25 à partir d’une requête de texte ou d’un résultat classé par RRF à partir d’un vecteur ou d’une requête hybride. L’exercice de reclassement utilise uniquement du texte. Même si les résultats incluent plus de 50 résultats, seuls les 50 premiers résultats progressent vers le classement sémantique. En règle générale, le classement sémantique utilise des champs d’information et descriptifs.
Pour chaque document du résultat de recherche, le modèle de synthèse accepte jusqu’à 2 000 jetons, où un jeton est d’environ 10 caractères. Le modèle assemble les entrées des champs « title », « keywords » et « content » répertoriés dans la configuration sémantique.
Le système supprime des chaînes excessivement longues pour garantir que la longueur globale répond aux exigences d’entrée de l’étape de synthèse. Cet exercice de découpage est pourquoi il est important d’ajouter des champs à votre configuration sémantique dans l’ordre de priorité. Si vous avez des documents très volumineux avec des champs lourds de texte, le système ignore tout ce qui suit la limite maximale.
Champ sémantique Limite de tokens « titre » 128 jetons « mots clés » 128 jetons « contenu » jetons restants La sortie de synthèse est une chaîne récapitulative pour chaque document, composée des informations les plus pertinentes de chaque champ. Le système envoie des chaînes de résumé au ranker pour le scoring et aux modèles de compréhension en lecture automatique pour les légendes et les réponses.
Depuis novembre 2024, la longueur maximale de chaque chaîne de résumé générée transmise au semantic ranker est de 2 048 tokens. Auparavant, il s’agissait de 256 jetons.
Comment les résultats sont évalués
Le système évalue les résultats en fonction de la légende et de tout autre contenu de la chaîne de résumé qui complète la limite de 2 048 jetons.
Le système évalue les légendes pour la pertinence conceptuelle et sémantique, par rapport à la requête que vous fournissez.
Le système affecte un @search.rerankerScore à chaque document en fonction de la pertinence sémantique du document pour la requête donnée. Les scores varient de 4 à 0 (élevé à faible), où un score plus élevé indique une pertinence plus élevée.
Score Sens 4.0 Le document est très pertinent et répond complètement à la question, bien que le passage puisse contenir du texte supplémentaire non lié à la question. 3.0 Le document est pertinent, mais ne contient pas de détails qui le rendent complet. 2.0 Le document est quelque peu pertinent ; il répond à la question partiellement ou seulement à certains aspects de la question. 1.0 Le document est lié à la question, et il répond à une petite partie de celle-ci. 0.0 Le document n’est pas pertinent. Le système répertorie les correspondances dans l’ordre décroissant par score et les inclut dans la charge utile de réponse de requête. La charge utile inclut des réponses, du texte brut et des légendes en surbrillance, ainsi que tous les champs que vous avez marqués comme récupérables ou spécifiés dans une clause Select.
Note
Pour toute requête donnée, les distributions de @search.rerankerScore peuvent présenter de légères variations en raison de conditions au niveau de l’infrastructure. Les mises à jour du modèle de classement peuvent également affecter la distribution. Pour ces raisons, si vous écrivez du code personnalisé pour des seuils minimaux ou si vous définissez la propriété seuil pour les requêtes vectorielles et hybrides, ne définissez pas les limites trop granulaires.
Sorties du ranker sémantique
À partir de chaque chaîne récapitulative, les modèles de compréhension de lecture automatique trouvent des passages qui sont les plus représentatifs.
Les sorties sont les suivantes :
Légende sémantique du document. Chaque légende est disponible dans une version en texte brut et une version en surbrillance, et est fréquemment inférieure à 200 mots par document.
Une réponse sémantique facultative, en supposant que vous avez spécifié le
answersparamètre, la requête a été posée comme une question, et un passage se trouve dans la longue chaîne qui fournit une réponse probable à la question.
Les légendes et les réponses sont toujours en texte intégral à partir de votre index. Il n’existe aucun modèle d’IA générative dans ce flux de travail qui crée ou compose du nouveau contenu.
Fonctionnalités sémantiques et limitations
Que peut faire l’éditeur de classement sémantique :
Promouvoir les correspondances qui sont sémantiquement plus proches de l’intention de la requête d’origine.
Trouvez des chaînes de caractères à utiliser comme légendes et réponses. La réponse retourne des légendes et des réponses, que vous pouvez afficher sur une page de résultats de recherche.
Ce que le ranker sémantique ne peut pas faire est de réexécuter la requête sur l’ensemble du corpus pour rechercher des résultats sémantiquement pertinents. Le classement sémantique reclasse le jeu de résultats existant, composé des 50 premiers résultats, comme indiqué par l’algorithme de classement par défaut. En outre, le ranker sémantique ne peut pas créer de nouvelles informations ou chaînes. Les modèles linguistiques extraient des légendes et des réponses détaillées à partir de votre contenu. Par conséquent, si les résultats n’incluent pas de texte de type réponse, ils ne en produisent pas.
Bien que le classement sémantique ne soit pas avantageux dans chaque scénario, certains contenus peuvent tirer parti de ses fonctionnalités de manière significative. Les modèles de langage dans le classificateur sémantique fonctionnent mieux sur le contenu qui est riche en informations et structuré sous forme de prose. Une base de connaissances, une documentation en ligne ou des documents contenant du contenu descriptif voient les gains les plus importants des fonctionnalités de classement sémantique.
La technologie sous-jacente provient de Bing et Microsoft Research et est intégrée à l’infrastructure Recherche Azure AI en tant que fonctionnalité complémentaire. Pour plus d’informations sur les investissements de recherche et d’IA qui soutiennent le classement sémantique, consultez Comment l'IA de Bing alimente la recherche Azure AI (Microsoft Research Blog).
La vidéo suivante fournit une vue d’ensemble des fonctionnalités.
Comment le classificateur sémantique utilise les mappages de synonymes
Si vous activez la prise en charge des mappages de synonymes associés à un champ dans votre index de recherche et que vous incluez ce champ dans la configuration du ranker sémantique, le rankeur sémantique applique automatiquement les synonymes configurés pendant le processus de reclassement.
Disponibilité et tarification
L’éditeur de classement sémantique est disponible dans certaines régions. Il peut être utilisé en tant que fonctionnalité autonome ou en tant que composant intégré de la récupération agentique. Chaque fonctionnalité est facturée indépendamment.
Le classeur sémantique propose une offre gratuite (par défaut) avec une allocation mensuelle de requêtes gratuites, ainsi qu’une offre standard avec une tarification à l’usage une fois l’allocation gratuite consommée. Pour plus d’informations, consultez Activer ou désactiver la facturation de l’éditeur de classement sémantique.
Les frais de classement sémantique sont appliqués lorsque les demandes de requête incluent queryType=semantic et que la chaîne de recherche n’est pas vide (par exemple, search=pet friendly hotels in New York). Si votre chaîne de recherche est vide (search=*), vous n’êtes pas facturé, même si le queryType est défini sur sémantique.
Comment commencer
(Facultatif) Passez au plan de facturation standard pour l’utilisation au-delà du quota mensuel gratuit.
Configurez l’éditeur de classement sémantique dans un index de recherche.
Configurez des requêtes pour retourner des légendes sémantiques et des mises en surbrillance.
(Facultatif) Renvoyer des réponses sémantiques.