Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Note
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
Important
Features oder Funktionen, die in diesem Artikel als "Vorschau" gekennzeichnet sind, befinden sich in der öffentlichen Vorschau und unterliegen den ergänzenden Nutzungsbedingungen für Microsoft Azure Previews.
Vorschaubegriffe speziell für Foundry IQ (Azure KI-Suche) finden Sie unter Vorschaufunktionen.
Bewertungsprofile werden verwendet, um die Rangfolge von übereinstimmenden Dokumenten basierend auf benutzerdefinierten Kriterien zu erhöhen oder zu unterdrücken. In diesem Artikel erfahren Sie, wie Sie ein Bewertungsprofil angeben und zuweisen, das eine Suchbewertung basierend auf von Ihnen angegebenen Parametern erhöht. Sie können Bewertungsprofile erstellen basierend auf:
Gewichtete Textfelder, wobei das Boosting auf einer Übereinstimmung basiert, die in einem vordefinierten Feld gefunden wurde. Beispielsweise werden Übereinstimmungen, die in einem Feld "Betreff" gefunden wurden, als relevanter betrachtet als dieselbe Übereinstimmung, die in einem Feld "Beschreibung" gefunden wurde.
Funktionen für numerische Felder, einschließlich Datumsangaben und geografischen Koordinaten. Funktionen für numerische Inhalte unterstützen die Erhöhung der Entfernung (gilt für geografische Koordinaten), Aktualität (gilt für Datums-/Uhrzeitfelder), Bereich und Größe.
Funktionen für Zeichenfolgensammlungen (Tags). Eine Tags-Funktion erhöht die Suchbewertung eines Dokuments, wenn ein Element in der Auflistung von der Abfrage abgeglichen wird.
Eine Random-Funktion (Vorschau), die pseudozufällige Punktwerte zuweist, anstatt ein Feld zu boosten.
(Vorschau) Eine Aggregation unterschiedlicher Boosts. Innerhalb eines einzelnen Bewertungsprofils können Sie mehrere Bewertungsfunktionen angeben und dann festlegen
"functionAggregation": "product". Dokumente, die in allen Funktionen hoch bewertet werden, werden priorisiert, während diejenigen, die in einem oder mehreren Feldern schwach bewertet werden, unterdrückt werden.
Sie können einem Index ein Bewertungsprofil hinzufügen, indem Sie die JSON-Definition im Azure-Portal bearbeiten oder programmgesteuert über APIs wie Create or Update Index REST oder gleichwertige Indexupdate-APIs in einem beliebigen Azure SDK bearbeiten. Es gibt keine Indexneuerstellungsanforderungen, sodass Sie ein Bewertungsprofil ohne Auswirkungen auf indizierte Dokumente hinzufügen, ändern oder löschen können.
Am Ende dieses Artikels können Sie Bewertungsprofile erstellen und anwenden, um die Suchrelevanz basierend auf Feldgewichten, Aktualität, Entfernung oder benutzerdefinierten Kriterien zu erhöhen.
Prerequisites
Ein Azure-Abonnement. Erstellen Sie ein kostenloses Konto.
Ein Foundry IQ-Dienst (Azure KI-Suche). Erstellen Sie einen Dienst oder suchen Sie einen vorhandenen Dienst.
Ein Suchindex mit Text- oder numerischen Feldern (nicht vektorisiert).
Berechtigungen: In den Beispielen wird rollenbasierter Zugriff verwendet. Weisen Sie Search Service Contributor zu, um einen Index mit Bewertungsprofilen zu erstellen oder zu aktualisieren, Search Index Data Contributor zum Laden von Dokumenten und Search Index Data Reader, um mithilfe eines Bewertungsprofils Abfragen auszuführen. Weitere Informationen finden Sie unter "Verbinden mithilfe von Rollen".
Für die Zufallsfunktion verwenden Sie die REST-API-Version
2026-11-01-preview. Die zufällige Bewertung ist in2026-10-01nicht verfügbar.SDK-Installation (optional):
- Python:
pip install azure-search-documents azure-identity - C#:
dotnet add package Azure.Search.Documentsunddotnet add package Azure.Identity
- Python:
Tip
Für direkte Codebeispiele springen Sie zur Bewertungsprofildefinition.
Regeln für Bewertungsprofile
Sie können Bewertungsprofile in der Schlüsselwortsuche, Vektorsuche, Hybridsuche und mit semantischem Reranking verwenden. Feldbasierte Bewertungsprofile gelten für Nichtvektorfelder, sodass Ihr Index Text- oder numerische Felder benötigt, die Sie höher gewichten oder gewichten können. Die zufällige Funktion ist eine Ausnahme: Sie zielt nicht auf ein Feld ab und ersetzt die Ähnlichkeitswerte, anstatt sie zu erhöhen.
Sie können bis zu 100 Bewertungsprofile innerhalb eines Indexes haben (siehe Dienstbeschränkungen), aber Sie können nur jeweils ein Profil in einer beliebigen Abfrage angeben.
Sie können die semantische Rangfolge mit Bewertungsprofilen verwenden und ein Bewertungsprofil anwenden, nachdem die semantische Rangfolge erfolgt. Andernfalls ist die semantische Rangfolge der letzte Schritt, wenn mehrere Bewertungs- oder Relevanzfeatures ausgeführt werden. Wie die Suchbewertung funktioniert veranschaulicht die Reihenfolge der Vorgänge.
Zusätzliche Regeln gelten speziell für Funktionen.
Note
Sind Sie noch nicht mit Relevanzkonzepten vertraut? Besuchen Sie Relevanz und Bewertung in Foundry IQ für den Hintergrund. Sie können sich dieses Video-Segment auf YouTube ansehen, um Profile mit Ergebnissen über BM25-Rankings zu bewerten.
Bewertungsprofildefinition
Ein Bewertungsprofil wird in einem Indexschema definiert. Sie besteht aus gewichteten Feldern, Funktionen und Parametern.
Die folgende Definition zeigt ein einfaches Profil namens „geo“. Dieses Beispiel gewichtet Ergebnisse höher, die den Suchbegriff im Feld „hotelName“ enthalten. Darüber hinaus verwendet es die distance-Funktion, um Ergebnisse zu bevorzugen, die sich im Umkreis von zehn Kilometern um den aktuellen Standort befinden. Wenn jemand nach dem Begriff "inn" sucht und "inn" Teil des Hotelnamens ist, werden Dokumente, die Hotels mit "inn" innerhalb eines Radius von 10 Kilometern des aktuellen Standorts enthalten, in den Suchergebnissen höher angezeigt.
"scoringProfiles": [
  {
    "name":"geo",
    "text": {
      "weights": {
        "hotelName": 5
      }
    },
    "functions": [
      {
        "type": "distance",
        "boost": 5,
        "fieldName": "location",
        "interpolation": "logarithmic",
        "distance": {
          "referencePointParameter": "currentLocation",
          "boostingDistance": 10
        }
      }
    ]
  }
]
Referenz: scoringProfiles | scoringFunction | Abstandsfunktion
Weitere Szenarien finden Sie in den Beispielen für die Themen Aktualität und Entfernung sowie gewichteten Text und Funktionen in diesem Artikel.
Abfrage mit einem Bewertungsprofil
import os
from azure.identity import DefaultAzureCredential
from azure.search.documents import SearchClient

# Set up the client
endpoint = os.environ["AZURE_SEARCH_ENDPOINT"]
index_name = "hotels"
credential = DefaultAzureCredential()

client = SearchClient(endpoint=endpoint, index_name=index_name, credential=credential)

# Execute search with scoring profile
results = client.search(
    search_text="inn",
    scoring_profile="geo",
    scoring_parameters=["currentLocation--122.123,44.77233"],
    select=["HotelName", "Description", "Rating"]
)

for result in results:
    print(f"{result['HotelName']} (Score: {result['@search.score']})")
Referenz: SearchClient.search | scoring_profile Parameter
Hinzufügen eines Bewertungsprofils zu einem Suchindex
Beginnen Sie mit einer Indexdefinition. Sie können Bewertungsprofile für einen bestehenden Index hinzufügen und aktualisieren, ohne diesen neu erstellen zu müssen. Verwenden Sie Get Index, um einen bestehenden Index abzurufen, und verwenden Sie die Anfrage Create or Update Index, um eine Überarbeitung zu senden.
Fügen Sie die in diesem Artikel bereitgestellte Vorlage ein.
Geben Sie einen Namen an, der den Benennungskonventionen entspricht.
Geben Sie die Relevanzkriterien an. Ein einzelnes Profil kann textgewichtete Felder, Funktionen oder beides enthalten. Ein zufälliges Profil enthält nur eine zufällige Funktion ohne Textgewichtungen oder andere Funktionen.
Sie sollten iterativ arbeiten, indem Sie einen Datensatz verwenden, der Ihnen hilft, die Wirksamkeit eines bestimmten Profils zu beweisen oder zu widerlegen.
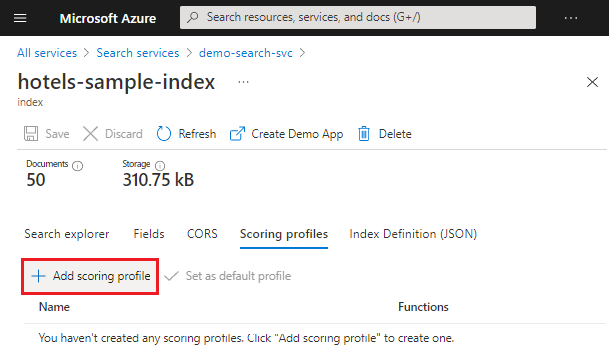
Bewertungsprofile können im Azure-Portal wie im folgenden Screenshot dargestellt oder programmgesteuert über REST-APIs oder in Azure SDKs definiert werden, z. B. die ScoringProfile-Klasse in .NET- oder Python-Clientbibliotheken.
Template
Diese Vorlage zeigt feldbasierte Bewertungsprofile. Die Zufallsfunktion verwendet eine andere Verlaufsform ohne fieldName oder boost; siehe Zufallsergebnisse (Vorschau). Eine Beschreibung der Eigenschaften finden Sie in der REST-API-Referenz.
"scoringProfiles": [
  {
    "name": "name of scoring profile",
    "text": (optional, only applies to searchable fields) {
      "weights": {
        "searchable_field_name": relative_weight_value (positive #'s),
        ...
      }
    },
    "functions": (optional) [
      {
        "type": "magnitude | freshness | distance | tag",
        "boost": # (positive number used as multiplier for raw score != 1),
        "fieldName": "(...)",
        "interpolation": "constant | linear (default) | quadratic | logarithmic",

        "magnitude": {
          "boostingRangeStart": #,
          "boostingRangeEnd": #,
          "constantBoostBeyondRange": true | false (default)
        }

        // ( - or -)

        "freshness": {
          "boostingDuration": "..." (value representing timespan over which boosting occurs)
        }

        // ( - or -)

        "distance": {
          "referencePointParameter": "...", (parameter to be passed in queries to use as reference location)
          "boostingDistance": # (the distance in kilometers from the reference location where the boosting range ends)
        }

        // ( - or -)

        "tag": {
          "tagsParameter":  "..."(parameter to be passed in queries to specify a list of tags to compare against target field)
        }
      }
    ],
    "functionAggregation": (optional, applies only when functions are specified) "sum (default) | average | minimum | maximum | firstMatching"
  }
],
"defaultScoringProfile": (optional) "...",
Verwenden von textgewichteten Feldern
Verwenden Sie textgewichtete Felder, wenn der Feldkontext wichtig ist und Abfragen searchable-Zeichenfolgenfelder enthalten. Wenn beispielsweise eine Abfrage den Begriff "Airport" enthält, können Sie "Airport" im Feld "HotelName" anstelle des Felds "Beschreibung" bevorzugen.
Gewichtete Felder sind Name-Wert-Paare und bestehen aus einem searchable Feld und einer positiven Zahl, die als Multiplikator verwendet wird. Wenn der ursprüngliche Feldscore von HotelName 3 lautet, entspricht der höher gewichtete Score dieses Felds 6, was zu einem höheren Gesamtscore des übergeordneten Dokuments beiträgt.
"scoringProfiles": [
    {
      "name": "boostSearchTerms",
      "text": {
        "weights": {
          "HotelName": 2,
          "Description": 5
        }
      }
    }
]
Verwenden von Funktionen
Verwenden Sie Funktionen, wenn einfache relative Gewichtungen nicht ausreichen oder sich nicht anwenden lassen. Dies ist z. B. bei „distance“ und „freshness“ der Fall, da es sich hier um Berechnungen für numerische Daten handelt. Mehrere Funktionen können dasselbe Profil gemeinsam nutzen, außer wenn das Profil eine zufällige Funktion enthält. Weitere Informationen zu den in Foundry IQ verwendeten EDM-Datentypen finden Sie unter Unterstützte Datentypen.
| Function | Description | Anwendungsfälle |
|---|---|---|
| distance | Höhere Gewichtung auf Basis der Nähe oder des geografischen Standorts. Diese Funktion kann nur mit Edm.GeographyPoint -Feldern verwendet werden. |
Verwenden Sie diese Option für Szenarien für „In meiner Nähe suchen“. |
| freshness | Erhöht um Werte in einem datetime-Feld (Edm.DateTimeOffset).
Legen Sie boostingDuration fest, um einen Wert anzugeben, der einen Zeitraum darstellt, über den die Verstärkung erfolgt. |
Verwenden Sie diese Option, wenn Sie kürzliche (neuere) Datumsangaben vorziehen möchten. Sie können auch Elemente, wie Kalenderereignisse mit zukünftigen Terminen, die näher an der Gegenwart liegen, hervorheben oder priorisieren, im Vergleich zu Elementen, die weiter in der Zukunft liegen. Ein Ende des Bereichs ist auf die aktuelle Uhrzeit festgelegt. |
| magnitude | Die Größe ist der berechnete Abstand zwischen dem Wert des Dokuments (z. B. einem Datum oder einer Position) und dem Referenzpunkt (z. B. "Jetzt" oder Zielspeicherort). Dies ist die Eingabe für die Bewertungsfunktion und bestimmt, wie viel Boost angewendet wird. Ändern Sie Rangfolgen basierend auf dem Wertebereich für ein numerisches Feld. Der Wert muss vom Typ „Integer“ oder „Gleitkomma“ sein. Für Sternbewertungen von 1 bis 4 wäre dies die 1. Für Gewinnspannen von über 50 % wäre dies die 50. Diese Funktion kann nur mit Edm.Double- und Edm.Int-Feldern verwendet werden. Für die magnitude-Funktion können Sie den Bereich umkehren, wenn Sie das umgekehrte Muster anwenden möchten (z. B. um preiswerteren Artikeln eine höhere Relevanz als teureren zuzuweisen). Legen Sie bei einer Preisspanne zwischen 100 € und 1 € boostingRangeStart auf 100 und boostingRangeEnd auf 1 fest, um preiswertere Artikeln zu fördern. |
Verwenden Sie diese Option, wenn Sie durch Gewinnspanne, Bewertungen, Clickthrough-Anzahl, Anzahl der Downloads, höchsten Preis, niedrigsten Preis oder eine Anzahl von Downloads steigern möchten. Wenn zwei Elemente relevant sind, wird das Element mit der höheren Bewertung zuerst angezeigt. |
| tag | Höhere Gewichtung auf Basis von Tags, die sowohl für Suchdokumente als auch für Abfragezeichenfolgen gebräuchlich sind. Tags werden als tagsParameter bereitgestellt. Diese Funktion kann nur mit Suchfeldern vom Typ Edm.String und Collection(Edm.String) verwendet werden. |
Verwenden Sie diese Funktion, wenn Sie Tagfelder haben. Wenn ein Tag in der Liste selbst eine durch Trennzeichen getrennte Liste ist, können Sie eine Textnormalisierungsfunktion in diesem Feld verwenden, um die Trennzeichen zur Abfragezeit zu entfernen (das Trennzeichen wird einem Leerzeichen zugeordnet). Damit wird die Liste vereinfacht und enthält alle Begriffe in einer einzigen, langen Zeichenfolge mit Trennzeichen. |
Die Zufallsfunktion (Vorschau) weist pseudo-zufällige Ergebnisse ohne Feldeingabe zu. Aktualitäts- und Entfernungsbewertungen sind spezielle Fälle einer größenbasierten Bewertung, bei der die Größe automatisch aus einem Datums- oder geografischen Feld berechnet wird.
Regeln für die Verwendung von Funktionen
- Wenden Sie feldbasierte Funktionen nur auf Felder an, die als
filterableattribuiert sind. DierandomFunktion gibt wederfieldNamenochboostan. - Verwenden Sie Kleinbuchstaben für Funktionstyp ("freshness", "magnitude", "distance", "tag", "random").
- Funktionen dürfen keine NULL-Werte oder leeren Werte enthalten.
- Feldbasierte Funktionen können nur ein Feld pro Funktionsdefinition aufweisen. Um zweimal im selben Profil zu verwenden
magnitude, stellen Sie zwei Definitionen vonmagnitude, eine für jedes Feld bereit. - Ein
randomProfil enthält höchstens einerandomFunktion, keine anderen Funktionstypen und keine Textstärken.
Ergebnisse zufällig anordnen (Vorschau)
Verwenden Sie type: "random", um übereinstimmenden Dokumenten Pseudozufallswerte zuzuweisen. Weglassen fieldName, boost und interpolation. Random unterstützt keine nicht standardmäßige Interpolation oder Kombinationen mit anderen Funktionen oder Schriftschnitten.
Important
Die zufällige Bewertungsfunktion befindet sich in der Vorschau in der REST-API-Version 2026-11-01-preview.
Legen Sie für wiederholbare Anforderungen random.seedParameter auf den Namen eines Abfragezeit-Bewertungsparameters fest. Der Name beginnt mit einem Buchstaben und enthält bis zu 16 Buchstaben oder Ziffern. Geben Sie genau eine signierte 64-Bit-Ganzzahl zur Abfragezeit an.
Der folgende schlüssellose Workflow erstellt einen Beispielindex, lädt vier Dokumente hoch und fragt ein zufälliges Bewertungsprofil mit dem Startwert 42 ab. Verwenden Sie einen Foundry IQ-Dienst, bei dem Ihre Identität über die in den Voraussetzungen aufgeführten Rollen verfügt.
Installieren Sie das neueste Vorschaupaket azure-search-documents und das azure-identity Paket:
pip install --pre azure-search-documents
pip install azure-identity
Legen Sie die AZURE_SEARCH_ENDPOINT Umgebungsvariable auf Ihren Foundry IQ-Dienstendpunkt fest, und führen Sie dann den folgenden Code aus:
import os

from azure.identity import DefaultAzureCredential
from azure.search.documents import SearchClient
from azure.search.documents.indexes import SearchIndexClient
from azure.search.documents.indexes.models import (
    RandomScoringFunction,
    RandomScoringParameters,
    ScoringProfile,
    SearchableField,
    SearchFieldDataType,
    SearchIndex,
    SimpleField,
)

endpoint = os.environ["AZURE_SEARCH_ENDPOINT"]
index_name = "random-scoring-demo"
credential = DefaultAzureCredential()

index_client = SearchIndexClient(
    endpoint=endpoint,
    credential=credential,
)

index = SearchIndex(
    name=index_name,
    fields=[
        SimpleField(
            name="id",
            type=SearchFieldDataType.STRING,
            key=True,
            filterable=True,
            sortable=True,
        ),
        SearchableField(
            name="content",
            type=SearchFieldDataType.STRING,
        ),
        SimpleField(
            name="category",
            type=SearchFieldDataType.STRING,
            filterable=True,
        ),
    ],
    scoring_profiles=[
        ScoringProfile(
            name="randomSeeded",
            functions=[
                RandomScoringFunction(
                    parameters=RandomScoringParameters(
                        seed_parameter="seed"
                    )
                )
            ],
        ),
        ScoringProfile(
            name="randomUnseeded",
            functions=[RandomScoringFunction()],
        ),
    ],
)

index_client.create_or_update_index(index)

search_client = SearchClient(
    endpoint=endpoint,
    index_name=index_name,
    credential=credential,
)

documents = [
    {
        "id": "1",
        "content": "Astronomy uses telescopes to observe distant stars.",
        "category": "random-fixture",
    },
    {
        "id": "2",
        "content": "Botanical gardens cultivate orchids and roses.",
        "category": "random-fixture",
    },
    {
        "id": "3",
        "content": "Sailing navigation uses charts and compasses.",
        "category": "random-fixture",
    },
    {
        "id": "4",
        "content": "Cooking vegetables requires controlled heat.",
        "category": "random-fixture",
    },
]

search_client.upload_documents(documents=documents)

results = list(
    search_client.search(
        search_text="*",
        select=["id", "content"],
        top=4,
        include_total_count=True,
        scoring_profile="randomSeeded",
        scoring_parameters=["seed-42"],
    )
)
Referenz: SearchIndexClient | SearchClient
Festlegen von Interpolationen
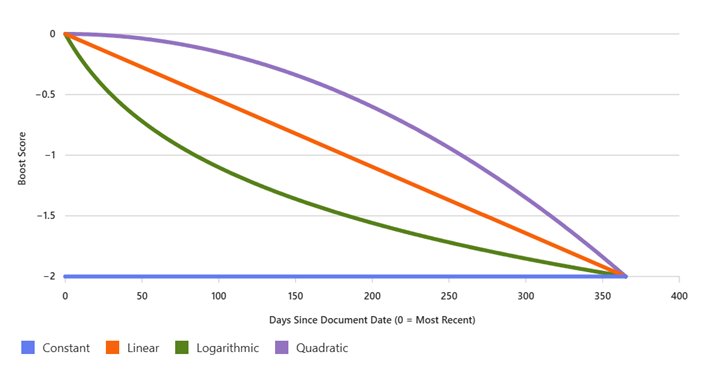
Interpolationen legen die Form des Gradienten fest, der zur Steigerung der Frische und der Distanz verwendet wird. Da die Bewertung von hoch bis niedrig verläuft, nimmt die Steigung immer ab. Die Interpolation bestimmt die Kurve der Abwärtsneigung und wie aggressiv sich der Boost-Score ändert, wenn Dokumentdatumsangaben älter werden. Interpolation für zufällige Bewertung auslassen; nur der Standardwert linear wird akzeptiert.
| Interpolation | Description |
|---|---|
linear |
Bei Elementen, die sich innerhalb des maximalen und minimalen Bereichs befinden, wird die Verstärkung in einer ständig abnehmenden Menge angewendet. Empfohlen, wenn Sie einen graduellen Verfall in der Relevanz wünschen. "Linear" ist die Standardinterpolation für ein Bewertungsprofil. |
constant |
Für Elemente, die sich innerhalb des Anfangs- und Endbereichs befinden, wird eine konstante Verstärkung auf die Rangfolgeergebnisse angewendet. Verwenden Sie dies, wenn Sie unabhängig vom Alter eine Pauschalstrafe wünschen. |
quadratic |
„quadratisch“ nimmt zunächst langsamer und dann beim Annähern an den Endbereich schneller in viel größeren Intervallen ab. Verwenden Sie diese Interpolation, wenn Sie die neuesten Dokumente stark favorisieren und ältere stark tiefer stufen möchten. Diese Interpolationsoption ist in der Kategoriebewertungsfunktion nicht zulässig. |
logarithmic |
„logarithmisch“ nimmt zunächst schneller und dann beim Annähern an den Endbereich in viel kleineren Intervallen ab. Empfohlen, wenn Sie eine starke Vorliebe für sehr aktuelle Inhalte haben, aber weniger Empfindlichkeit, wenn Dokumente älter werden. Diese Interpolationsoption ist in der Kategoriebewertungsfunktion nicht zulässig. |
Festlegen von „boostDuration“ für die Aktualitätsfunktion
boostingDuration ist ein Attribut der freshness Funktion. Sie verwenden es, um einen Ablaufzeitraum festzulegen, danach wird die Promotion für ein bestimmtes Dokument beendet. Um beispielsweise eine Produktlinie oder Marke für einen zehntägigen Werbezeitraum zu verstärken, können Sie den zehntägigen Zeitraum für diese Dokumente z. B. als "P10D" angeben.
boostingDuration muss als XSD-Wert "dayTimeDuration" formatiert werden (eine eingeschränkte Teilmenge eines ISO 8601-Dauerwerts). Das Muster hierfür lautet: „P[nD][T[nH][nM][nS]]“.
Die folgende Tabelle enthält einige Beispiele.
| Duration | boostingDuration |
|---|---|
| 1 Tag | "P1D" |
| 2 Tage und 12 Stunden | "P2DT12H" |
| 15 Minuten | "PT15M" |
| 30 Tage, 5 Stunden, 10 Minuten und 6,334 Sekunden | "P30DT5H10M6.334S" |
| 1 Jahr | "365D" |
Weitere Beispiele finden Sie unter XML-Schema: Datentypen (W3.org-Website).
Beispiel: Verstärkung durch Frische oder Entfernung
Die Form der Verstärkungskurve (konstant, linear, logarithmisch, quadratisch) beeinflusst, wie stark sich die Werte im gesamten Bereich ändern.
Wenn Sie die Funktion „freshness“ verwenden, damit die Verstärkung einen erheblich stärkeren Einfluss auf jüngere Daten hat, wählen Sie eine quadratische Interpolation aus. Die quadratische Interpolation verstärkt den Effekt von nahegelegenen Daten und nähergelegenen Standorten und schwächt am Ende des Bereichs langsamer ab. Im Gegensatz dazu wendet sich eine logarithmische Kurve am Ende deutlicher.
Hier sehen Sie ein Beispiel für ein Scoring-Profil, das veranschaulicht, wie Sie durch Aktualität einen Boost erhalten können.
{
    "name": "docs-index",
    "fields": [
      { "name": "id", "type": "Edm.String", "key": true, "filterable": true },
      { "name": "title", "type": "Edm.String", "searchable": true },
      { "name": "content", "type": "Edm.String", "searchable": true },
      { "name": "lastUpdated", "type": "Edm.DateTimeOffset", "filterable": true, "sortable": true }
    ],
    "scoringProfiles": [
      {
        "name": "freshnessBoost",
        "text": {
          "weights": {
            "content": 1.0
          }
        },
        "functions": [
          {
            "type": "freshness",
            "fieldName": "lastUpdated",
            "boost": 2.0,
            "interpolation": "quadratic",
            "parameters": {
              "boostingDuration": "P365D"
            }
          }
        ]
    }
  ]
}
- Die
freshnessFunktion berechnet eine Größe von "jetzt" auflastUpdated. - Eine positive Verstärkung mit quadratischer Interpolation erhöht die Steigung für aktuelle Datumsangaben und nimmt für ältere Datumsangaben schnell ab.
-
"boostingDuration": "P365D"definiert das Zeitfenster, über das die Aktualität ausgewertet wird, z. B. Dokumente höher zu gewichten, die aus dem letzten Jahr sind. -
"interpolation": "quadratic"bedeutet, dass der Boost-Effekt für Dokumente, die näher am aktuellen Datum sind, stärker ist und für ältere Dokumente stärker abnimmt.
Im nächsten Beispiel bietet eine lineare Interpolation im 30-Tage-Fenster eine gleichbleibende Präferenz für die jüngsten Inhalte. Erhöhen Sie die Verstärkung, wenn das Signal gegen andere Relevanzfaktoren gewinnen muss.
{
  "name": "freshness30_linear",
  "functions": [
    {
      "type": "freshness",
      "fieldName": "lastUpdated",
      "boost": 3.0,
      "interpolation": "linear",
      "parameters": { "boostingDuration": "P30D" }
    }
  ]
}
Referenz: Freshness Function | boostingDuration
Beispiel: Verstärken durch gewichteten Text und Funktionen
Tip
In diesem Blogbeitrag und in diesem Notizbuch finden Sie eine Demonstration der Verwendung von Bewertungsprofilen und Dokumentsteigerungen in Vektor- und generativen KI-Szenarien.
Im folgenden Beispiel wird das Schema eines Indexes mit zwei Bewertungsprofilen (boostGenre, newAndHighlyRated) gezeigt. Jede Abfrage für diesen Index, die eines der beiden Profile als Abfrageparameter enthält, verwendet das Profil, um das Ergebnis-Set zu bewerten.
Das Profil boostGenre verwendet gewichtete Textfelder und fördert Übereinstimmungen, die in den Feldern „albumTitle“, „genre“ und „interpretName“ gefunden werden. Die Felder werden jeweils um den Faktor 1,5, 5 und 2 höher gewichtet. Warum wird "genre" so viel stärker als die anderen Felder erhöht? Wenn die Suche über Daten durchgeführt wird, die etwas homogen sind (wie bei "genre" im musicstoreindex), benötigen Sie möglicherweise eine größere Varianz in den relativen Gewichtungen. In musicstoreindex ist „rock“ z. B. sowohl als „genre“ als auch in identisch formulierten Genrebeschreibungen aufgeführt. Wenn das Genre die Genrebeschreibung überwiegen soll, muss das Genrefeld ein viel höheres relatives Gewicht haben.
{
  "name": "musicstoreindex",
  "fields": [
    { "name": "key", "type": "Edm.String", "key": true },
    { "name": "albumTitle", "type": "Edm.String" },
    { "name": "albumUrl", "type": "Edm.String", "filterable": false },
    { "name": "genre", "type": "Edm.String" },
    { "name": "genreDescription", "type": "Edm.String", "filterable": false },
    { "name": "artistName", "type": "Edm.String" },
    { "name": "orderableOnline", "type": "Edm.Boolean" },
    { "name": "rating", "type": "Edm.Int32" },
    { "name": "tags", "type": "Collection(Edm.String)" },
    { "name": "price", "type": "Edm.Double", "filterable": false },
    { "name": "margin", "type": "Edm.Int32", "retrievable": false },
    { "name": "inventory", "type": "Edm.Int32" },
    { "name": "lastUpdated", "type": "Edm.DateTimeOffset" }
  ],
  "scoringProfiles": [
    {
      "name": "boostGenre",
      "text": {
        "weights": {
          "albumTitle": 1.5,
          "genre": 5,
          "artistName": 2
        }
      }
    },
    {
      "name": "newAndHighlyRated",
      "functions": [
        {
          "type": "freshness",
          "fieldName": "lastUpdated",
          "boost": -10,
          "interpolation": "quadratic",
          "freshness": {
            "boostingDuration": "P365D"
          }
        },
        {
          "type": "magnitude",
          "fieldName": "rating",
          "boost": 10,
          "interpolation": "linear",
          "magnitude": {
            "boostingRangeStart": 1,
            "boostingRangeEnd": 5,
            "constantBoostBeyondRange": false
          }
        }
      ]
    }
  ]
}
Beispiel: Funktionsaggregation
Note
Diese Funktion befindet sich derzeit in der Vorschau, die über die REST-API latest preview und in Azure SDK Vorschaupaketen verfügbar ist, die das Feature bereitstellen.
Innerhalb eines einzelnen Bewertungsprofils können Sie mehrere Bewertungsfunktionen angeben und dann festlegen "functionAggregation": "product". Dokumente, die in allen Funktionen hoch bewertet werden, werden priorisiert, während diejenigen, die in einem oder mehreren Feldern schwach bewertet werden, unterdrückt werden.
Erstellen Sie in diesem Beispiel ein Bewertungsprofil, das zwei Verstärkungsfunktionen enthält, die nach rating und baseRate verstärken, und setzen Sie dann functionAggregation auf product.
### Create a new index
PUT {{url}}/indexes/hotels-scoring?api-version=2026-11-01-preview
Content-Type: application/json
api-key: {{key}}

{
    "name": "hotels-scoring",
    "fields": [
        {"name": "HotelId", "type": "Edm.String", "key": true, "filterable": true, "facetable": true},
        {"name": "HotelName", "type": "Edm.String", "searchable": true, "filterable": false, "sortable": true, "facetable": true},
        {"name": "Description", "type": "Edm.String", "searchable": true, "filterable": false, "sortable": false, "facetable": true, "analyzer": "en.lucene"},
        {"name": "Category", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true},
        {"name": "Tags", "type": "Collection(Edm.String)", "searchable": true, "filterable": true, "sortable": false, "facetable": true},
        {"name": "ParkingIncluded", "type": "Edm.Boolean", "filterable": true, "sortable": true, "facetable": true},
        {"name": "LastRenovationDate", "type": "Edm.DateTimeOffset", "filterable": true, "sortable": true, "facetable": true},
        {"name": "Rating", "type": "Edm.Double", "filterable": true, "sortable": true, "facetable": true},
        {"name": "BaseRate", "type": "Edm.Double", "filterable": true, "sortable": true, "facetable": true },
        {"name": "Address", "type": "Edm.ComplexType",
            "fields": [
            {"name": "StreetAddress", "type": "Edm.String", "filterable": false, "sortable": false, "facetable": true, "searchable": true},
            {"name": "City", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true},
            {"name": "StateProvince", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true},
            {"name": "PostalCode", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "facetable": true}
            ]
        }
    ],
    "scoringProfiles": [
        {
            "name": "productAggregationProfile",
            "functions": [
                {
                    "type": "magnitude",
                    "fieldName": "Rating",
                    "boost": 2.0,
                    "interpolation": "linear",
                    "magnitude": {
                        "boostingRangeStart": 1.0,
                        "boostingRangeEnd": 5.0,
                        "constantBoostBeyondRange": false
                    }
                },
                {
                    "type": "magnitude",
                    "fieldName": "BaseRate",
                    "boost": 1.5,
                    "interpolation": "linear",
                    "magnitude": {
                        "boostingRangeStart": 50.0,
                        "boostingRangeEnd": 400.0,
                        "constantBoostBeyondRange": false
                    }
                }
            ],
            "functionAggregation": "product"
        }
    ],
    "defaultScoringProfile": "productAggregationProfile"
}
Diese nächste Anforderung lädt den Index mit durchsuchbarem Inhalt, der das Profil testet.
### Upload documents to the index
POST {{url}}/indexes/hotels-scoring/docs/index?api-version=2026-11-01-preview
Content-Type: application/json
api-key: {{key}}

  {
        "value": [
        {
        "@search.action": "upload",
        "HotelId": "1",
        "HotelName": "Stay-Kay City Hotel",
        "Description": "This classic hotel is fully-refurbished and ideally located on the main commercial artery of the city in the heart of New York. A few minutes away is Times Square and the historic centre of the city, as well as other places of interest that make New York one of America's most attractive and cosmopolitan cities.",
        "Category": "Boutique",
        "Tags": [ "view", "air conditioning", "concierge" ],
        "ParkingIncluded": false,
        "LastRenovationDate": "2022-01-18T00:00:00Z",
        "Rating": 3.60,
        "BaseRate": 200.0,
        "Address":
            {
            "StreetAddress": "677 5th Ave",
            "City": "New York",
            "StateProvince": "NY",
            "PostalCode": "10022"
            }
        },
        {
        "@search.action": "upload",
        "HotelId": "2",
        "HotelName": "Old Century Hotel",
        "Description": "The hotel is situated in a nineteenth century plaza, which has been expanded and renovated to the highest architectural standards to create a modern, functional and first-class hotel in which art and unique historical elements coexist with the most modern comforts. The hotel also regularly hosts events like wine tastings, beer dinners, and live music.",
         "Category": "Boutique",
        "Tags": [ "pool", "free wifi", "concierge" ],
        "ParkingIncluded": false,
        "LastRenovationDate": "2019-02-18T00:00:00Z",
        "Rating": 3.60,
        "BaseRate": 150.0,
        "Address":
            {
            "StreetAddress": "140 University Town Center Dr",
            "City": "Sarasota",
            "StateProvince": "FL",
            "PostalCode": "34243"
            }
        },
        {
        "@search.action": "upload",
        "HotelId": "3",
        "HotelName": "Gastronomic Landscape Hotel",
        "Description": "The Gastronomic Landscape Hotel stands out for its culinary excellence under the management of William Dough, who advises on and oversees all of the Hotel’s restaurant services.",
        "Category": "Suite",
        "Tags": [ "restaurant", "bar", "continental breakfast" ],
        "ParkingIncluded": true,
        "LastRenovationDate": "2015-09-20T00:00:00Z",
        "Rating": 4.80,
        "BaseRate": 350.0,
        "Address":
            {
            "StreetAddress": "3393 Peachtree Rd",
            "City": "Atlanta",
            "StateProvince": "GA",
            "PostalCode": "30326"
            }
        },
        {
        "@search.action": "upload",
        "HotelId": "4",
        "HotelName": "Sublime Palace Hotel",
        "Description": "Sublime Palace Hotel is located in the heart of the historic center of Sublime in an extremely vibrant and lively area within short walking distance to the sites and landmarks of the city and is surrounded by the extraordinary beauty of churches, buildings, shops and monuments. Sublime Cliff is part of a lovingly restored 19th century resort, updated for every modern convenience.",
        "Tags": [ "concierge", "view", "air conditioning" ],
        "ParkingIncluded": true,
        "LastRenovationDate": "2020-02-06T00:00:00Z",
        "Rating": 4.60,
        "BaseRate": 275.0,
        "Address":
            {
            "StreetAddress": "7400 San Pedro Ave",
            "City": "San Antonio",
            "StateProvince": "TX",
            "PostalCode": "78216"
            }
        }
    ]
}
Führen Sie eine Abfrage aus, die die Kriterien im Bewertungsprofil verwendet, um Ergebnisse basierend auf einer hohen Bewertung und einer hohen Basisrate zu erhöhen. Die Verstärkungsergebnisse werden aggregiert, um Ergebnisse weiter zu fördern, die in beiden Funktionen hoch bewertet werden.
### Search with boost
POST {{url}}/indexes/hotels-scoring/docs/search?api-version=2026-11-01-preview
Content-Type: application/json
api-key: {{key}}

{
    "search": "expensive and good hotels",
    "count": true,
    "select": "HotelId, HotelName, Description, Rating, BaseRate",
    "scoringProfile": "productAggregationProfile"
}
Die beste Antwort für diese Abfrage ist "Gastronomisches Landschaftshotel" mit einer Suchergebnisbewertung, die fast doppelt so hoch ist wie die nächste Übereinstimmung. Dieses spezielle Hotel hat sowohl die höchste Bewertung als auch der höchste Basistarif, so dass die Verbindung beider Funktionen diese Übereinstimmung an die Spitze fördert.
{
  "@odata.count": 4,
  "value": [
    {
      "@search.score": 1.0541908,
      "HotelId": "3",
      "HotelName": "Gastronomic Landscape Hotel",
      "Description": "The Gastronomic Hotel stands out for its culinary excellence under the management of William Dough, who advises on and oversees all of the Hotel\u2019s restaurant services.",
      "Rating": 4.8,
      "BaseRate": 350.0
    },
    {
      "@search.score": 0.53451097,
      "HotelId": "2",
      "HotelName": "Old Century Hotel",
      "Description": "The hotel is situated in a nineteenth century plaza, which has been expanded and renovated to the highest architectural standards to create a modern, functional and first-class hotel in which art and unique historical elements coexist with the most modern comforts. The hotel also regularly hosts events like wine tastings, beer dinners, and live music.",
      "Rating": 3.6,
      "BaseRate": 150.0
    },
    {
      "@search.score": 0.53185254,
      "HotelId": "1",
      "HotelName": "Stay-Kay City Hotel",
      "Description": "This classic hotel is fully-refurbished and ideally located on the main commercial artery of the city in the heart of New York. A few minutes away is Times Square and the historic centre of the city, as well as other places of interest that make New York one of America's most attractive and cosmopolitan cities.",
      "Rating": 3.6,
      "BaseRate": 200.0
    },
    {
      "@search.score": 0.44853577,
      "HotelId": "4",
      "HotelName": "Sublime Palace Hotel",
      "Description": "Sublime Palace Hotel is located in the heart of the historic center of Sublime in an extremely vibrant and lively area within short walking distance to the sites and landmarks of the city and is surrounded by the extraordinary beauty of churches, buildings, shops and monuments. Sublime Cliff is part of a lovingly restored 19th century resort, updated for every modern convenience.",
      "Rating": 4.6,
      "BaseRate": 275.0
    }
  ]
}
Optimierungstipps
Beginnen Sie konservativ: Verstärkung im Bereich von 1,25 bis 2,0; nur erhöhen, wenn die Aktualität wirklich entscheidend ist.
Fenstergröße: Verwenden Sie P30D für aktuelle Inhalte, P90D/P180D für Inhalte mittlerer Aktualität und P365D für Long-Tail-Inhalte.
Interpolationsauswahl:
- „quadratisch“, wenn Sie einen starken Schub in Richtung jüngster Vergangenheit wünschen.
- linear, wenn Sie einen stabilen Farbverlauf wünschen.
- logarithmisch, wenn Sie eine sanfte Präferenz wünschen.
Aggregation: Wenn mehrere Funktionen kombiniert werden, ist die Summe am einfachsten; zu "max" wechseln, wenn ein einzelnes Signal dominiert werden soll
Fehlerbehebung für Bewertungsprofile
Verwenden Sie die folgende Tabelle, um häufige Probleme mit Bewertungsprofilen zu diagnostizieren.
| Thema | Mögliche Ursache | Beschluss |
|---|---|---|
| Bewertungsprofil nicht angewendet | Der Profilname wurde in der Abfrage nicht angegeben. | Fügen Sie den Parameter scoringProfile Ihrer Suchanfrage mit dem genauen Profilnamen hinzu. |
| Kein Verstärkungseffekt beobachtet | Das Feld ist nicht als filterable markiert |
Funktionen können nur auf Felder angewendet werden, die als filterable gekennzeichnet sind. Aktualisieren Sie Ihr Indexschema. |
| Unerwartete Bewertungsergebnisse | Boostwert zu niedrig oder zu hoch | Beginnen Sie mit Boost-Werten im Bereich von 1,25 bis 2,0, und passen Sie sie basierend auf den Tests an. |
| Aktualität erhöht nicht die Aktualität der Dokumente |
boostingDuration zu kurz oder falsches Format |
Überprüfen Sie das Dauerformat (z. B. "P30D" für 30 Tage), und erweitern Sie das Fenster bei Bedarf. |
| Abstandsfunktion funktioniert nicht | Feld ist nicht Edm.GeographyPoint |
Die Entfernungsfunktion funktioniert nur mit Edm.GeographyPoint Feldern. |
| Tag-Funktion gibt keinen Boost zurück. | Tags stimmen nicht mit Abfragewerten überein | Überprüfen Sie, ob die Werte von tagsParameter mit denen in der Suchanfrage scoringParameters übereinstimmen. |
| Das Profil ist vorhanden, die Abfrage schlägt jedoch fehl. | Ungültiger Feldname im Profil | Stellen Sie sicher, dass alle Feldnamen im Bewertungsprofil im Indexschema vorhanden sind. |
Verwandte Inhalte
- Relevanz und Bewertung in Foundry IQ
- Bewertungsprofil-REST-API-Referenz
- Search Documents (Azure Search Service REST API) (Suchen nach Dokumenten (Azure Search Service-REST-API))
- Semantisches Ranking
- ScoringProfile-Klasse (.NET)
- ScoringProfile-Klasse (Python)