Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka:
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Víceklientová aplikace je aplikace, která poskytuje stejné služby a možnosti libovolnému počtu tenantů, kteří nevidí nebo sdílejí data žádného jiného tenanta. Tento článek popisuje strategie izolace tenanta pro víceklientské aplikace vytvořené pomocí služby Azure AI Vyhledávač.
Koncepty služby Azure AI Vyhledávač
Azure AI Vyhledávač jako řešení typu vyhledávání jako služba umožňuje vývojářům přidávat do aplikací bohaté možnosti vyhledávání, aniž by museli spravovat infrastrukturu nebo se stát odborníkem na načítání informací. Data se nahrají do služby a pak se uloží do cloudu. Pomocí jednoduchých požadavků na rozhraní API služby Azure AI Vyhledávač je pak možné data upravit a prohledávat.
Vyhledávací služby, indexy, pole a dokumenty
Než začnete diskutovat o vzorech návrhu, je důležité pochopit několik základních konceptů.
Při použití služby Azure AI Vyhledávač se jedna přihlásí k odběru vyhledávací služby. Když se data nahrají do služby Azure AI Vyhledávač, ukládají se do indexu ve vyhledávací službě. V rámci jedné služby může existovat několik indexů. Aby bylo možné používat známé koncepty databází, může se vyhledávací služba přirovnat k databázi, zatímco indexy v rámci služby se dají přirovnat k tabulkám v databázi.
Každý index v rámci vyhledávací služby má vlastní schéma, které je definováno několika přizpůsobitelnými poli. Data se přidají do indexu Azure AI Vyhledávač ve formě jednotlivých dokumentů. Každý dokument musí být nahrán do určitého indexu a musí odpovídat schématu tohoto indexu. Při vyhledávání dat pomocí služby Azure AI Vyhledávač se na konkrétní index vydávají fulltextové vyhledávací dotazy. Pokud srovnáme tyto koncepty s databázovými strukturami, pak pole lze přirovnat ke sloupcům v tabulce a dokumenty k řádkům.
Škálovatelnost
Jakákoli služba Azure AI Vyhledávač v cenové úrovni Standard se může škálovat ve dvou dimenzích: úložiště a dostupnost.
- Oddíly je možné přidat, aby se zvýšilo úložiště vyhledávací služby.
- Repliky je možné do služby přidat, aby se zvýšila propustnost požadavků, které může vyhledávací služba zpracovat.
Umožnění přidávání a odebírání oddílů a replik podle potřeby bude umožňovat, aby se kapacita vyhledávací služby zvětšovala s objemem dat a provozem aplikace. Aby vyhledávací služba dosáhla úrovně SLA pro čtení, vyžaduje dvě repliky. Aby služba dosáhla SLA pro čtení i zápis, vyžaduje tři repliky.
Omezení služby a indexu ve službě Azure AI Vyhledávač
Ve službě Azure AI Vyhledávač existuje několik různých cenových úrovní, každá z těchto úrovní má různá omezení a kvóty. Některá z těchto omezení jsou na úrovni služby, některá jsou na úrovni indexu a některá jsou na úrovni oddílu.
S3 s vysokou hustotou
V cenové úrovni Služby Azure AI Vyhledávač je k dispozici možnost pro režim s vysokou hustotou (HD), který je určený speciálně pro scénáře s více tenanty. V mnoha případech je nutné podporovat velký počet menších tenantů v rámci jedné služby, aby bylo možné dosáhnout výhod jednoduchosti a nákladové efektivity.
S3 HD umožňuje sjednotit mnoho malých indexů pod správu jedné vyhledávací služby výměnou schopnosti škálovat indexy pomocí oddílů za možnost hostovat více indexů v rámci jedné služby.
Služba S3 je navržená k hostování pevného počtu indexů (maximálně 200) a umožňuje horizontálnímu škálování jednotlivých indexů při přidání nových oddílů do služby. Přidání oddílů do služeb S3 HD zvyšuje maximální počet indexů, které může služba hostovat. Ideální maximální velikost pro jednotlivé indexy S3HD je přibližně 50 až 80 GB, i když u každého indexu, který systém ukládá, neexistuje žádný pevný limit velikosti.
Důležité informace o víceklientských aplikacích
Víceklientní aplikace musí efektivně distribuovat prostředky mezi tenanty a současně zachovat určitou úroveň ochrany osobních údajů mezi různými tenanty. Při návrhu architektury pro takovou aplikaci je potřeba vzít v úvahu několik aspektů:
Izolace tenanta: Vývojáři aplikací musí přijmout vhodná opatření, aby se zajistilo, že žádní tenanti nemají neoprávněný nebo nežádoucí přístup k datům jiných tenantů. Kromě hlediska ochrany osobních údajů vyžadují strategie oddělení tenantů efektivní správu sdílených prostředků a ochranu před hlučnými sousedy.
Náklady na cloudové prostředky: Stejně jako u jakékoli jiné aplikace musí softwarová řešení zůstat nákladově konkurenceschopná jako součást víceklientských aplikací.
Snadné operace: Při vývoji víceklientské architektury je důležitým aspektem dopad na provoz a složitost aplikace. Azure AI Vyhledávač má smlouvu SLA o 99,9 %.
Celosvětová působnost: Víceklientské aplikace často musí sloužit tenantům, kteří jsou distribuováni po celém světě.
Škálovatelnost: Vývojáři aplikací musí zvážit, jak dosáhnout souladu mezi zachováním dostatečně nízké úrovně složitosti aplikace a návrhem aplikace tak, aby se škálovala s počtem uživatelů a velikostí dat a úloh uživatelů.
Azure AI Vyhledávač nabízí několik hranic, které je možné použít k izolaci dat a úloh tenantů.
Modelování víceklientské architektury pomocí služby Azure AI Vyhledávač
V případě scénáře s více tenanty vývojář aplikace využívá jednu nebo více vyhledávacích služeb a rozděluje tenanty mezi služby, indexy nebo obojí. Azure AI Vyhledávač má několik běžných vzorů při modelování scénáře s více tenanty:
Jeden index na tenanta: Každý tenant má svůj vlastní index ve vyhledávací službě, která je sdílená s ostatními tenanty.
Jedna služba na tenanta: Každý tenant má vlastní vyhrazenou službu Azure AI Vyhledávač, která nabízí nejvyšší úroveň dat a oddělení úloh.
Kombinace obou: Větší a aktivnější tenanti se přiřazují vyhrazené služby, zatímco menší tenanti mají přiřazené jednotlivé indexy ve sdílených službách.
Model 1: Jeden index na tenanta
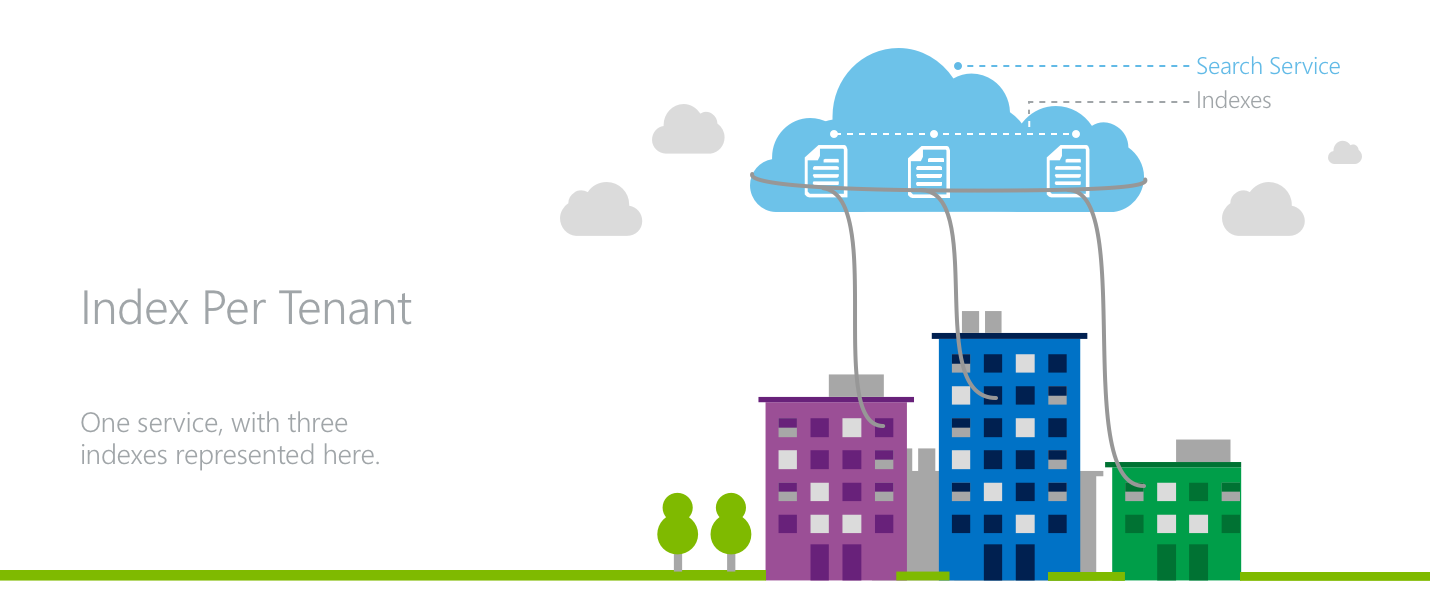
V modelu indexu pro každý tenanta, více tenantů využívá jedinou službu Azure AI Vyhledávač, kde má každý tenant svůj vlastní index.
Tento přístup funguje, protože všechny požadavky na vyhledávání a operace dokumentů se vydávají na úrovni indexu ve službě Azure AI Vyhledávač. V aplikační vrstvě je potřeba mít povědomí o směrování provozu různých tenantů na správné indexy a zároveň spravovat prostředky na úrovni služby napříč všemi tenanty.
Klíčovým atributem modelu index-per-tenant je schopnost vývojáře aplikací přepsat kapacitu vyhledávací služby mezi tenanty aplikace. Pokud mají nájemníci nerovnoměrně rozložené pracovní zatížení, je možné optimální kombinaci nájemníků distribuovat napříč indexy vyhledávací služby, aby vyhovovala řadě vysoce aktivních, intenzivně využívajících zdrojů nájemníků a zároveň obsloužila velký počet méně aktivních nájemníků. Kompromisem je nemožnost modelu zvládnout situace, kdy je každý tenant současně vysoce aktivní.
Model indexu na nájemníka poskytuje základ pro model proměnných nákladů, kde je služba Azure AI Vyhledávač zakoupena předem a poté je naplněna nájemníky. To umožňuje určit nevyužitou kapacitu pro zkušební verze a bezplatné účty.
U aplikací s globálními nároky nemusí být model indexu na tenanta nejúčinnější. Pokud se tenanti aplikace distribuují po celém světě, může být pro každou oblast potřeba samostatná služba, která duplikuje náklady napříč jednotlivými oblastmi.
Azure AI Vyhledávač umožňuje škálovat jak jednotlivé indexy, tak celkový počet indexů, které se mají zvětšit. Pokud zvolíte odpovídající cenovou úroveň, oddíly a repliky se dají přidat do celé vyhledávací služby, když se jednotlivé indexy v rámci služby z hlediska úložiště nebo provozu příliš rozrůstají.
Pokud se celkový počet indexů pro jednu službu příliš rozrůstá, musí být zřízena jiná služba, aby vyhovovala novým tenantům. Pokud je potřeba přesouvat indexy mezi vyhledávacími službami při přidání nových služeb, je nutné data z indexu ručně zkopírovat z jednoho indexu do druhého, protože Azure AI Vyhledávač neumožňuje přesun indexu.
Model 2: Jedna služba na tenanta
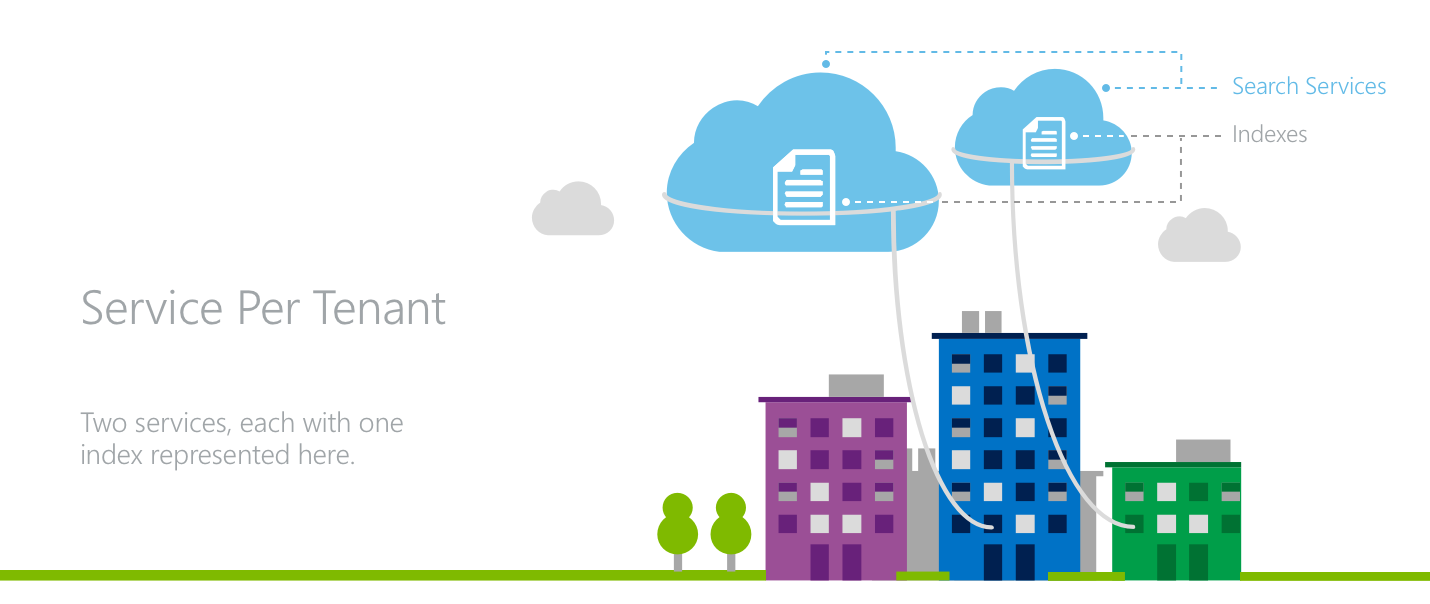
V architektuře služby na tenanta má každý tenant vlastní vyhledávací službu.
V tomto modelu aplikace dosáhne maximální úrovně izolace pro své tenanty. Každá služba má vyhrazené úložiště a propustnost pro zpracování žádostí o vyhledávání. Každý tenant má individuální vlastnictví klíčů rozhraní API.
U aplikací, ve kterých má každý tenant velké nároky nebo má málo proměnlivosti mezi tenanty, je model služby na tenanta efektivní volbou, protože prostředky se nesdílejí napříč různými úlohami tenantů.
Model služby pro jednoho nájemníka také nabízí výhodu předvídatelného modelu s pevnými náklady. Neexistuje žádná počáteční investice do celé vyhledávací služby, dokud není tenant, který by ho vyplnil, ale náklady na tenanta jsou vyšší než model indexu na tenanta.
Model služby na tenanta je efektivní volbou pro aplikace s globálními nároky. U geograficky distribuovaných tenantů je snadné mít službu každého tenanta v příslušné oblasti.
Problémy při škálování tohoto modelu vznikají, když jednotliví nájemníci přerostou svou službu. Azure AI Vyhledávač v současné době nepodporuje upgrade cenové úrovně vyhledávací služby, takže všechna data by se musela ručně zkopírovat do nové služby.
Model 3: Hybridní
Dalším vzorem modelování multitenantní architektury je kombinace strategie indexu na tenanta se strategií služby na tenanta.
Kombinací těchto dvou vzorů mohou největší nájemci aplikace obsadit vyhrazené služby, zatímco dlouhý chvost méně aktivních, menších nájemců může využívat indexy ve sdílené službě. Tento model zajišťuje, že největší tenanti mají konzistentně vysoký výkon ze služby a zároveň pomáhají chránit menší tenanty před všemi hlučné sousedy.
Implementace této strategie spoléhá na schopnost předpovědět, kteří tenanti budou vyžadovat vyhrazenou službu versus index ve sdílené službě. Složitost aplikace se zvyšuje s nutností spravovat oba tyto víceklientské modely.
Dosažení jemnější úrovně detailů
Výše uvedené vzory návrhu pro modelování scénářů s více tenanty ve službě Azure AI Vyhledávač předpokládají jednotný rozsah, ve kterém je každý tenant celou instancí aplikace. Aplikace ale můžou někdy zpracovávat mnoho menších oborů.
Pokud modely service-per-tenant a index-per-tenant nejsou dostatečně malé rozsahy, je možné modelovat index, aby se dosáhlo ještě jemněji členitosti.
Pokud chcete, aby se jeden index pro různé koncové body klienta choval odlišně, může být pole přidáno do indexu, které určuje určitou hodnotu pro každého možného klienta. Pokaždé, když klient zavolá Azure AI Vyhledávač k dotazování nebo úpravě indexu, kód z klientské aplikace určuje odpovídající hodnotu pro toto pole pomocí funkce filtru Azure AI Vyhledávač v době dotazu.
Tuto metodu lze použít k dosažení funkčnosti samostatných uživatelských účtů, samostatných úrovní oprávnění a dokonce i zcela samostatných aplikací.
Poznámka:
Použití výše popsaného přístupu ke konfiguraci jednoho indexu pro obsluhu více tenantů ovlivňuje význam výsledků hledání. Skóre relevance vyhledávání se vypočítávají v oboru na úrovni indexu, ne v oboru na úrovni tenanta, takže všechna data tenantů se začlení do podkladových statistik skóre relevance, jako je frekvence termínů.
Další kroky
Azure AI Vyhledávač je přesvědčivou volbou pro mnoho aplikací. Při vyhodnocování různých vzorů návrhu pro víceklientské aplikace zvažte různé cenové úrovně a příslušné limity služeb, které nejlépe přizpůsobí azure AI Search tak, aby vyhovovaly aplikačním úlohám a architekturám všech velikostí.